O prompt mais caro que enviei na semana passada tinha 41 palavras, e só as primeiras nove é que fizeram trabalho a sério — foi a minha primeira grande lição de prompting no Claude Fable 5 desde que o modelo regressou.
Estava a montar um novo fluxo de captura no meu segundo cérebro — a configuração Obsidian mais Claude Code através da qual passa toda a minha vida — e disparei uma daquelas instruções inchadas, à prova de tudo, que me tinha habituado a escrever na era do Opus 4.7. "Faz isto, mas não faças aquilo, e certifica-te de que também consideras isto, e explica o teu raciocínio a cada passo para eu poder acompanhar, e sê meticuloso." Conheces bem o formato. Aquela instrução em que tentas antecipar todas as maneiras como o modelo pode falhar empilhando regras em cima de regras.
No Opus, esse prompt era apenas ineficiente. No Claude Fable 5 foi um pequeno incêndio. Porque o Fable 5 cobra 10 dólares por milhão de tokens de entrada e 50 dólares por milhão de saída — e aquela linha do "explica o teu raciocínio a cada passo" não se limitou a inchar a resposta; pode ter, silenciosamente, redirecionado o pedido para um modelo completamente diferente. Vou já lá chegar. A versão curta é que um bom prompting de Claude Fable 5 não é uma preferência de estilo neste modelo. É a diferença entre uma ferramenta que justifica o preço e uma que te esvazia a conta enquanto olhas para o lado.
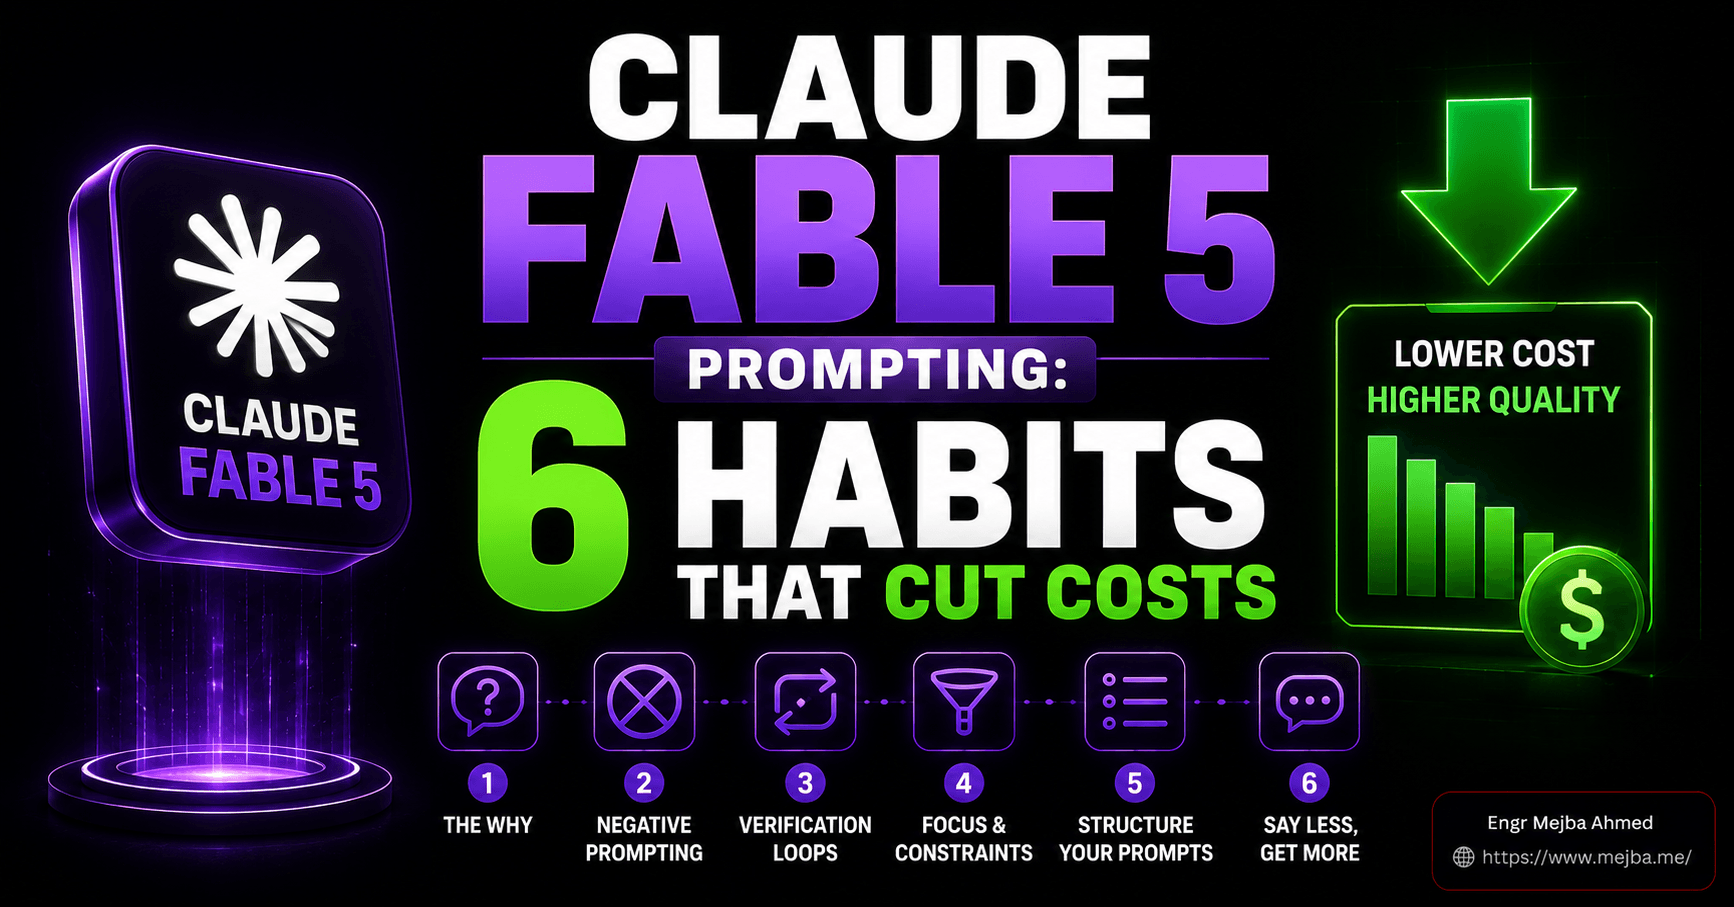
Passei os dias desde o regresso do Fable 5 a reconstruir a forma como falo com ele — no meu sistema operativo de IA construído sobre o Claude Code, nos repositórios diários dos clientes e no segundo cérebro que corro no Obsidian. Seis hábitos fizeram o trabalho pesado. Cada um deles torna o resultado melhor e a fatura mais pequena ao mesmo tempo, o que é mais raro do que parece. Esta é essa lista.
Se queres a peça complementar — no que deves apontar o Fable 5 durante a janela gratuita, que a Anthropic prolongou até 12 de julho depois do corte original a 7 de julho — mapeei separadamente oito fluxos de trabalho de alta alavancagem para a janela gratuita. Esse artigo é a lista de coisas a fazer. Este é o como-dizê-lo. Lê os dois em conjunto e ficas com as duas metades.
Porque é que o Fable 5 castiga um prompt desleixado mais do que qualquer modelo que já usei
Deixa-me pôr números reais na coisa antes dos hábitos, porque os hábitos só fazem sentido depois de sentires a mecânica dos custos na pele.
O Fable 5 é o modelo mais capaz que a Anthropic tem no ar neste momento, e o preço é à altura: 10 dólares por milhão de tokens de entrada, 50 dólares por milhão de tokens de saída (a documentação de preços da Anthropic confirma o valor). É aproximadamente o dobro dos 5 in / 25 out do Opus 4.8. Até aqui, "modelo premium é premium."
Aqui está a parte que muda a forma como deves fazer prompting. O raciocínio que o Fable 5 realiza — o pensamento interno antes de te responder — é faturado como tokens de saída, à mesma taxa de 50 dólares por milhão. Os tokens de pensamento são a classe de tokens mais cara em toda a tabela. E não os vês na resposta. Uma resposta que parece ter 300 palavras no ecrã pode ter queimado dez vezes mais em raciocínio que nunca chegaste a ler.
Agora, sobrepõe os níveis de esforço. A API do Fable 5 expõe o esforço como low, medium, high (o padrão), xhigh e max (a documentação de esforço da Anthropic descreve os patamares; no Claude Code, o topo aparece como a engrenagem ultra/ultracode que analisei na minha review dos níveis de esforço do Opus 4.8). O esforço não altera o custo por token — o Fable 5 fica a 10/50 em qualquer nível. O que o esforço altera é quantos tokens o modelo gasta a pensar antes de responder. Sobe o esforço para o máximo e não tornaste cada token mais caro; disseste ao modelo para comprar muito mais dos tokens mais caros do menu.
Junta estes dois factos e obténs a tese inteira deste post: no Fable 5, o custo de uma tarefa é definido menos pelo que pedes e mais pela forma como o pedes. Um prompt vago faz o modelo raciocinar em círculos a 50 dólares por milhão para descobrir o que querias dizer. Um prompt que convida à exploração em aberto fá-lo explorar — caro. Um prompt com um pedido de exposição de raciocínio pode empurrar-te para um modelo diferente sem te avisar em voz alta.
Isto não é razão para evitar o Fable 5. É razão para lhe fazeres prompting como o especialista que é. Há um hábito aqui — o quinto — que é genuinamente específico do Fable e que a maior parte das pessoas está a fazer mal neste momento, porque o comportamento que ele explora não existia nos modelos mais antigos. Guarda-o no fundo da cabeça; volto lá para fechar o ciclo.
Seis hábitos. Ordenados grosso modo pela quantidade de dinheiro que cada um poupa por prompt.
Hábito 1: Dá-lhe o "porquê", não apenas o "quê"
A mudança de maior retorno que fiz foi também a menos intuitiva, porque implica escrever mais para gastar menos.
Todos os pedidos carregam uma razão por trás — o resultado que estás realmente a perseguir. A maior parte dos prompts deita essa razão fora e entrega ao modelo apenas a instrução mecânica. "Escreve um email sobre o atraso." "Refatora esta classe." "Resume estas notas." O modelo tem depois de reconstruir a tua intenção a partir da tarefa nua, e reconstruir é exatamente o tipo de raciocínio em aberto que dispara o contador no Fable 5.
Dá-lhe o porquê à partida e colapsas essa adivinhação. Compara:
Fraco: "Escreve um email ao cliente sobre o desvio no prazo."
Forte: "Escreve um email a um cliente que é o cliente âncora de um lançamento muito maior no próximo trimestre — a relação importa mais do que este prazo. O prazo vai atrasar duas semanas. Quero que se sintam informados e no controlo, não geridos. Mantém curto e específico sobre as novas datas."
A segunda versão não é mais longa por o ser. Cada cláusula extra remove um ramo que o modelo teria de explorar por conta própria — o tom, o que está em jogo, o tamanho, o objetivo. A compreensão semântica do Fable 5 é afiada o suficiente para que, quando lhe entregas contexto genuíno, ele deixe de se contorcer entre uma dúzia de leituras possíveis e se comprometa com a certa. Resultado mais afiado, menos tokens de raciocínio para lá chegar. Pagaste uns tokens de entrada a 10 dólares por milhão para evitares uma pilha de tokens de saída a 50 dólares por milhão.
Isto compõe fortemente quando o modelo está ligado a um sistema de contexto. No meu segundo cérebro, "o porquê" é muitas vezes um ponteiro: "Isto é para a revisão de parceiros do Q3 — puxa os ficheiros de contexto relevantes e escreve o rascunho com base no que combinámos na última sync." Essa frase única diz ao Fable 5 que notas carregar e como se parece o sucesso, e o resto trata-o o princípio "contexto vence configuração" sobre o qual escrevi. O modelo não está a raciocinar no vácuo. Está a raciocinar contra a tua situação real.
A regra que sigo agora: se me apanho a escrever um imperativo nu, paro e acrescento a cláusula que começa por "porque." Nove vezes em dez, essa cláusula é a coisa mais valiosa no prompt.
Hábito 2: Diz-lhe o que NÃO fazer
O contexto diz ao modelo para onde ir. O prompting negativo diz-lhe onde ficam as ravinas — e o Fable 5 é o primeiro modelo em que vi isto aterrar limpo em vez de ser meio-ignorado.
O modo de falha que o prompting negativo mata é a iniciativa não pedida. Pedes ao modelo para investigar um bug e ele "ajuda-te" a refatorar três ficheiros sem relação. Pedes-lhe para rever um documento e ele reescreve metade. Cada uma dessas ações não convidadas são tokens de saída que estás a pagar e trabalho de limpeza que não pediste — um imposto duplo, dinheiro e tempo.
Por isso, agora enuncio a cerca explicitamente:
"Investiga porque é que este endpoint devolve um 500 e diz-me o que encontrares. Não edites, não apagues nem 'arranjes' nada até eu dizer que sim."
Essa última frase salva-me constantemente. Sem ela, um modelo capaz com comichão para ser útil começa a "melhorar" coisas, e no Fable 5 essas melhorias não são experiências gratuitas — são experiências a preço premium. Com ela, o modelo faz exatamente a tarefa delimitada e para, e sou eu que decido o que vale a pena tratar.
Alguns prompts negativos que mantenho em rotação porque justificam o lugar:
- "Reporta apenas as conclusões. Não alteres ficheiros." — para qualquer passagem de investigação ou auditoria.
- "Não adiciones dependências nem bibliotecas novas a não ser que não haja alternativa razoável, e sinaliza-o primeiro se for o caso." — trava o alargamento de âmbito em tarefas de código.
- "Não reescrevas secções que já funcionam. Toca só no que eu nomeei." — para edições, onde os modelos adoram exceder-se.
Uma nuance que aprendi a duras penas: o prompting negativo funciona com o enquadramento positivo, não em vez dele. "Não partas os testes" é mais fraco do que "mantém todos os testes existentes verdes e, só depois disso, acrescenta cobertura para o novo comportamento." Dá ao modelo um alvo para acertar e a cerca que não pode transpor. Aprofundei este equilíbrio nas minhas regras de prompting que reduzem a adivinhação — o jogo todo é deixar ao modelo o menor espaço possível para inventar, porque a invenção é onde tanto os bugs como as faturas de tokens nascem.
Hábito 3: Deixa-o agir no momento em que tem o suficiente — e adequa o esforço à tarefa
Este é o hábito que mais diretamente toca no contador, por isso abranda aqui.
Os modelos de raciocínio capazes têm tendência para se prepararem demasiado. Faz uma pergunta em aberto e vão pesquisar exaustivamente, pesar seis opções, construir um plano para o plano — às vezes genuinamente útil, muitas vezes apenas um pigarrear caro antes de uma resposta que estava ao alcance três passos atrás. Num modelo em que o pensamento é faturado a 50 dólares o milhão, esse preâmbulo é uma rubrica.
Por isso, agora digo ao Fable 5, em português claro, para agir assim que tiver o suficiente:
"Reúne o que precisas mesmo, e avança. Não pesquises em excesso — assim que tiveres o suficiente para agir com bom senso, age. Se bateres numa bifurcação real que não consegues resolver, faz-me uma pergunta afiada em vez de adivinhar."
Essa única instrução corta a deliberação longa e cara em tarefas que não precisavam dela. O Fable 5 segue direção curta e clara suficientemente bem para que "para de planear e mexe-te" aterre a sério — o seu raciocínio é bom o suficiente para saber quando tem o bastante, se lhe deres permissão para parar.
A outra metade deste hábito é o botão de esforço, e é aí que se esconde a maior parte do dinheiro. Deixa tudo no padrão high e estás a pagar em excesso no trabalho de rotina e, ocasionalmente, a subalimentar o trabalho difícil. O meu mapa de trabalho:
- Low / medium — pesquisas, renomeações, boilerplate, "onde é que X está definido", um rascunho rápido. O trabalho de rotina não tem nada que fazer no esforço high.
- High (padrão) — trabalho real de features, alterações em vários ficheiros, qualquer coisa em que quererias que um colega pensasse a sério.
- Xhigh / max — refatorações verdadeiramente complicadas, decisões de arquitetura, debugging subtil. Chega-lhes deliberadamente, não por hábito.
Aqui vai o reenquadramento que me poupou mais dinheiro: provavelmente nem sequer deverias estar a correr o Fable 5 para a maior parte do teu trabalho. A afirmação da comunidade que circulou no lançamento — de que o Fable 5 em low iguala o Opus 4.8 no seu nível máximo — não consigo verificar de forma limpa, e trataria qualquer equivalência precisa do género "Fable low equivale a Opus max" como marketing até a testares nas tuas próprias tarefas. Mas a forma do conselho está correta seja como for: o Fable 5 é um bisturi, não um carro do dia-a-dia. No meu próprio roteamento, ele faz talvez 5–15% do trabalho — as passagens profundas em que o seu teto genuinamente importa — e o Opus 4.8 ou modelos mais baratos carregam a carga de rotina. Usar o Fable 5 para tudo não é dedicação à qualidade. É como se põe dinheiro a arder. Tracei a matemática mais ampla de roteamento no meu guia de otimização de custos de agentes de IA, e aplica-se a dobrar a estas tarifas.
A disciplina: escolhe o modelo mais barato e o nível de esforço mais baixo que efetivamente façam o trabalho. Não o mais alto que consegues pagar. O mais baixo que funciona.
Hábito 4: Fá-lo provar o trabalho antes de chamar seja o que for de "feito"
Todos os modelos, de vez em quando, declaram uma vitória que não conquistaram — testes "a passar" que nunca correram, uma correção "aplicada" a um ficheiro que interpretaram mal, um resumo a citar confiantemente uma fonte que diz o oposto. Num modelo barato é um chato. No Fable 5 é um chato pelo qual pagaste premium e, pior, é o tipo de erro que te custa uma segunda ida-e-volta cara para apanhar e corrigir.
Por isso, coloco a verificação na própria instrução:
"Antes de me dizeres que isto está feito, verifica. Corre os testes e mostra-me o output. Se não conseguires verificar uma afirmação, di-lo claramente em vez de adivinhar — prefiro ouvir 'não consegui confirmar o caminho de cache' do que uma resposta confiante que se revela errada."
Duas coisas fazem isto funcionar. Primeiro, exigir evidência — output real do comando, a linha específica que alteraste, a citação da fonte — não um resumo da evidência. "Os testes passam" é uma afirmação. O output do test runner colado é prova. Força a prova.
Segundo, e esta é a parte que casa lindamente com a afinação de honestidade do Fable 5: dá explicitamente ao modelo permissão para dizer "não consegui verificar isto." Os modelos Claude mais recentes são visivelmente melhores a sinalizar o limite do seu próprio conhecimento quando os convidas a isso, e um honesto "não tenho a certeza sobre esta parte" poupa-te a descoberta muito mais cara de que inventou algo e tu enviaste. Um modelo que admite dúvida é mais barato do que um modelo que fabrica confiantemente, todas as vezes.
Isto não é específico do Fable — os ciclos de verificação melhoram qualquer modelo, e diria que são o hábito de maior confiança de toda esta lista. Mas é mais valioso no Fable 5 precisamente porque o custo de um erro por verificar é aqui mais alto. Quando os erros são caros, o hábito que apanha os erros cedo vale mais.
Se preferes ter alguém a construir estes ciclos de verificação diretamente nos agentes e skills da tua equipa — para que o passo "prova-o" fique cozido no sistema em vez de ser retecleado a cada prompt — é exatamente o tipo de trabalho de setup que assumo. Podes ver o que já construí em fiverr.com/s/EgxYmWD.
Hábito 5: Deixa de pedir ao Fable 5 para mostrar o raciocínio
Aqui está o ciclo que abri no início — o único hábito genuinamente específico deste modelo e aquele em que vejo mais gente a errar.
Deixa de meter "explica o teu raciocínio passo a passo" e "leva-me pelo teu pensamento" e "mostra a tua cadeia de pensamento" nos teus prompts para o Fable 5. Não porque o conselho seja mau em geral — foi um bom prompt-craft durante anos. Mas porque no Fable 5, após o regresso, os pedidos de exposição de raciocínio podem disparar o classificador de segurança.
Algum contexto sobre o porquê. O Fable 5 voltou a estar online no início de julho sob uma camada de segurança substancialmente mais apertada, depois de toda a saga de controlo de exportações que desmontei na minha análise do regresso do Fable 5. O novo classificador foi construído para travar uma classe específica de jailbreak — e os relatos sobre o regresso indicam que bloqueia a técnica-alvo em mais de 99% dos casos, ao custo de uma taxa de falsos positivos mais alta em pedidos normais (a TechTimes cobriu o comportamento do novo classificador). Tentativas de extrair o funcionamento interno do modelo situam-se desconfortavelmente perto dos padrões de jailbreak para os quais o classificador está afinado.
Quando um pedido dispara esse classificador, o Fable 5 não se limita a recusar. Reencaminha o pedido para o Opus 4.8. Pelo que os relatos indicam, és em geral notificado quando isto acontece e, através da API, o modelo que responde é visível se olhares — mas dentro de uma execução longa de agente ou numa sessão desktop tagarela, é genuinamente fácil não reparar. Pensas que estás a apanhar o teto do Fable 5. Estás a apanhar, discretamente, um modelo diferente.
A economia desse desvio é uma faca de dois gumes que vale a pena entender. Quando és empurrado para o Opus 4.8, pagas a tarifa mais baixa do Opus — por isso uma resposta rebaixada custa-te, na verdade, menos. Isso parece uma vitória até te lembrares por que pegaste no Fable 5: querias o teto dele num problema difícil. Ser silenciosamente entregue a um modelo menos capaz precisamente na tarefa em que pagavas premium para acertar não é um desconto. É uma quebra de qualidade que não escolheste e que talvez nem repares.
Por isso a correção é simples e é gratuita: elimina os pedidos de exposição de raciocínio dos teus prompts de sistema e de utilizador para o Fable 5. Se precisares mesmo de ver o pensamento do modelo, é para isso que serve o output de verificação (Hábito 4) — pede evidência e resultados, não um processo de pensamento exposto. Ficas com a responsabilização sem agitar um pano vermelho ao classificador. Mantenho uma versão do meu prompt de sistema para o Fable 5 com toda a linguagem de "explica o teu raciocínio" limpa, e outra diferente para outros modelos onde ainda está tudo bem. Mudança pequena. É a diferença entre correr o modelo pelo qual estás a pagar e correr um sósia.
Hábito 6: Diz menos, não mais
O último hábito é o que amarra os outros cinco, e é o que combate todos os instintos que a era Opus 4.7 nos treinou.
Durante anos, obter bom output significou mais — mais regras, mais ressalvas, mais tratamento explícito de casos limite, prompts de sistema cada vez mais longos a empilhar instrução sobre instrução para acorrentar o modelo. O Fable 5 quebra esse reflexo. É inteligente o suficiente para que um prompt apertado e bem apontado supere um livro de regras verboso — e o livro de regras verboso custa-te tokens de entrada em cada chamada e convida o modelo a raciocinar sobre toda essa instrução a 50 dólares por milhão de saída.
Compara um antes-e-depois real do meu próprio pipeline de conteúdo. A versão antiga era uma lista de catorze linhas de regras sobre tom, estrutura, o que evitar, como formatar, quando perguntar. A versão nova:
"Começa pelo resultado. Mantém simples e específico. Só pausa para me perguntar algo quando o trabalho realmente precisa de uma decisão que eu ainda não tomei."
Três frases. Produz rascunhos mais limpos do que a versão de catorze linhas produzia, porque o Fable 5 não estava a lutar para obedecer às regras — estava a ser distraído por elas. Inteligência mais concisão bate inteligência mais um muro de restrições.
O senão, e é importante para não contradizer o Hábito 1: menos não é o mesmo que vago. O Hábito 1 dizia para dar contexto. O Hábito 6 diz para não afogar esse contexto em regras. Não estão em tensão — o conteúdo de maior valor (o porquê, o objetivo, a cerca) fica; a cerimónia de baixo valor (instruções óbvias, ressalvas redundantes, sobre-especificação defensiva) sai. Estás a cortar lastro, não sinal.
É também isto que faz com que a integração apertada com skills e ficheiros de contexto funcione mesmo. Quando o teu prompt é enxuto, o modelo tem espaço para se apoiar no teu prompt de sistema, nos teus ficheiros de contexto e nas tuas skills em vez de re-ler uma instrução inchada a cada volta. A concisão ao nível do prompt é o que permite ao sistema fazer o seu trabalho — a mesma mudança que tracei quando a engenharia de prompts deu lugar à engenharia de ciclos. Diz menos no prompt para que a arquitetura à volta possa dizer mais.
Onde os seis hábitos batem nos seus limites
Passei este post inteiro a entregar-te hábitos, por isso deixa-me ser franco sobre o atrito, porque uma lista arrumadinha de seis passos que finge não haver desvantagens é só publicidade.
O desvio é a coisa a vigiar, e é fácil perder-lhe o rasto. O Hábito 5 desarma o gatilho de exposição de raciocínio, mas o classificador está afinado com aperto suficiente para que trabalho legítimo — segurança defensiva em especial — ainda te possa empurrar para o Opus 4.8 sem um sinal alto. Se estás a pagar tarifas de Fable 5 especificamente para uma tarefa difícil, verifica de facto que modelo respondeu. Se não consegues perceber pela tua superfície, é razão para correr trabalho de Fable 5 de alto risco algures onde o modelo que responde seja visível.
A maior parte destes hábitos ajuda qualquer modelo — e é essa a questão, não uma fraqueza. Contexto, prompting negativo, verificação, concisão: nada disso é exclusivo do Fable. O que é específico do Fable é quão caro é saltá-los aqui. O mesmo prompt desleixado que desperdiça cêntimos num modelo barato desperdiça dinheiro a sério no Fable 5. Os hábitos não mudam. O que muda é o que está em jogo.
A maior alavanca não é sequer um hábito de prompting. É não usar o Fable 5. Repito-o porque é a coisa a que as pessoas resistem: a quantidade correta de Fable 5 no teu fluxo de trabalho é pequena. Encaminha os 85–95% de rotina do teu trabalho para o Opus 4.8 e modelos mais baratos, e guarda o Fable 5 para as passagens em que o seu teto muda genuinamente o resultado. O melhor hábito de prompting no Claude Fable 5, no fim de contas, é saber quando não fazer prompting no Fable 5.
Como asso estes seis hábitos no sistema, e não no prompt
Hábitos que tens de te lembrar são hábitos que vais saltar às 11 da noite num prazo apertado. Por isso deixei de me apoiar na memória e empurrei os seis para a camada abaixo do prompt.
Vivem em três sítios agora:
No prompt de sistema. O meu prompt de sistema do Fable 5 tem os invariantes cozidos: avança quando tiveres o suficiente, verifica antes de declarares "feito", di-lo se não consegues confirmar algo, e — o específico do Fable — zero linguagem de exposição de raciocínio em lado nenhum. Não retecleio isto. É o chão do qual todos os prompts começam.
Em skills. Para trabalhos repetíveis — uma passagem de code review, um resumo de investigação, um rascunho de conteúdo — o ciclo de verificação e as cercas de prompting negativo vivem dentro da própria definição da skill. A skill é o hábito, codificado uma vez. Quando a invoco, o contrato "prova o teu trabalho, não toques no que eu não nomeei" vem junto automaticamente. É a mesma arquitetura de segundo-cérebro-com-skills que tenho vindo a construir no meu sistema operativo de IA no Claude Code.
Em predefinições de esforço por tipo de tarefa. Em vez de escolher um nível de esforço à sensação a cada vez, mapeio os tipos de tarefa a níveis uma vez e deixo o roteamento seguir. As skills de rotina têm por defeito low ou medium; as skills de passagem profunda reservam high e acima. A decisão sai do momento e vai para o desenho.
O retorno é que os erros caros — o raciocínio desenfreado, o desvio silencioso, a fabricação confiante, o prompt de catorze linhas — deixam de ser coisas que tenho de apanhar em tempo real. O sistema apanha-os, porque codifiquei a apanha uma vez. É esse o destino real dos seis hábitos: não prompts melhores escritos por um humano disciplinado, mas uma configuração onde a disciplina é estrutural e o humano pode dar-se ao luxo de ser um bocadinho desleixado sem pagar por isso.
O verdadeiro custo de um prompt no Fable 5
Volta ao prompt de 41 palavras do início. O desperdício não eram bem as 41 palavras. Era tudo o que puseram em marcha: o raciocínio em aberto a 50 dólares por milhão, a linha "explica o teu raciocínio" que me pode ter atirado para um modelo diferente, a iniciativa que não delimitei, as regras que empilhei em vez do contexto que deveria ter dado. Um prompt preguiçoso, quatro fugas separadas.
O Fable 5 é o modelo mais capaz em que já pus as mãos, e cobra em conformidade. Essa combinação faz com que o prompting deixe de ser uma soft skill e passe a ser controlo de custos — a mesma instrução, redigida de duas maneiras, pode diferir em uma ordem de grandeza no que queima e até no facto de correr no modelo que pretendias. Os seis hábitos não são sobre espremer uma frase melhor do modelo. São sobre não pagar tarifas premium pela tua própria imprecisão.
Aqui vai a única coisa a fazer hoje: pega no único prompt ou prompt de sistema que envias mais vezes ao Fable 5, e passa-o pelos seis. Acrescenta o porquê. Cerca o que não queres. Diz-lhe para agir e para verificar. Retira todos os "explica o teu raciocínio." Depois corta ao meio. Manda as duas versões contra a mesma tarefa e observa o contador de tokens. A diferença que vires é o imposto que tens vindo a pagar — e agora sabes como parar.
Perguntas Frequentes
Porque é que fazer prompting no Claude Fable 5 é tão caro?
O Claude Fable 5 custa 10 dólares por milhão de tokens de entrada e 50 dólares por milhão de tokens de saída — cerca do dobro do Opus 4.8 — e o seu raciocínio interno é faturado como saída à mesma tarifa de 50 dólares. Um prompt vago ou inchado faz o modelo raciocinar mais antes de responder, por isso o prompting impreciso infla diretamente o custo. Prompts apertados e ricos em contexto gastam menos desses tokens de raciocínio caros.
Os níveis de esforço mudam o quanto o Claude Fable 5 custa?
Os níveis de esforço não mudam a tarifa por token — o Fable 5 fica em 10/50 em qualquer nível. O que mudam é quantos tokens o modelo gasta a pensar antes de responder. Esforço mais alto (xhigh, max) pode usar muitos mais tokens do que a saída visível sugere, por isso adequar o esforço à dificuldade da tarefa é uma alavanca direta de custo. Vê o Hábito 3 acima para o mapa completo.
Porque é que o Claude Fable 5 por vezes passa para o Opus 4.8?
O classificador de segurança apertado do Fable 5 reencaminha pedidos sinalizados — incluindo tentativas de exposição de raciocínio e algum trabalho legítimo de segurança defensiva — para o Opus 4.8. Os relatos dizem que és geralmente notificado e a API mostra o modelo que responde, mas é fácil escapar-te numa sessão longa. Pagas a tarifa mais baixa do Opus quando és rebaixado, mas perdes o teto do Fable 5 pelo qual estavas a pagar.
Devo pedir ao Claude Fable 5 para explicar o raciocínio?
Não — no Fable 5 especificamente, pedidos ao estilo "explica o teu raciocínio" podem disparar o classificador de segurança e mandar-te para o Opus 4.8. Se precisares de responsabilização, pede evidência de verificação (output de testes, a alteração exata, citações da fonte) em vez de um processo de pensamento exposto. Ficas com a mesma responsabilização sem o risco do desvio. Vê o Hábito 5 acima.
Que percentagem do meu trabalho deve mesmo correr no Claude Fable 5?
No meu próprio roteamento, cerca de 5–15% — as passagens profundas em que o seu teto muda genuinamente o resultado. Encaminha os 85–95% de rotina para o Opus 4.8 e modelos mais baratos. Usar o Fable 5 como carro do dia-a-dia, dadas as suas tarifas, é a forma mais rápida de esvaziar um saldo de créditos por qualidade de que não precisavas na maior parte das tarefas.
Queres a disciplina de prompting cozida no sistema?
Estes seis hábitos só compensam se os correres mesmo, e às 11 da noite num prazo apertado ninguém o faz. Se preferes ter os ciclos de verificação, as cercas e a higiene de prompt segura para Fable 5 ligadas nos prompts de sistema e nas skills da tua equipa em vez de as reteclear a cada sessão, é esse o tipo de setup que assumo — vê o que construo aqui.