De duurste prompt die ik vorige week verstuurde was 41 woorden lang, en alleen de eerste negen deden echt werk — mijn eerste echte les in het prompten van Claude Fable 5 sinds het model terug is.
Ik was een nieuwe capture-flow aan het aansluiten op mijn tweede brein — de Obsidian-plus-Claude-Code-setup waar mijn hele leven doorheen loopt — en ik vuurde een van die opgeblazen, met-riem-en-bretels-tegelijk instructies af die ik gewend was geraakt te schrijven tijdens het Opus 4.7-tijdperk. "Doe dit, maar niet dat, en zorg dat je ook hier rekening mee houdt, en leg bij elke stap je redenering uit zodat ik kan volgen, en wees grondig." Je kent de vorm. De instructie waarin je elke manier waarop het model mis kan gaan probeert voor te zijn door regels op regels te stapelen.
Op Opus was die prompt slechts inefficiënt. Op Claude Fable 5 was het een kleine brand. Want Fable 5 rekent $10 per miljoen invoertokens en $50 per miljoen uitvoertokens — en die regel "leg bij elke stap je redenering uit" vulde niet alleen het antwoord op, hij kan het verzoek stilletjes naar een heel ander model hebben doorgesluisd. Ik kom zo op het waarom. De korte versie is dat goed prompten van Claude Fable 5 op dit model geen stijlvoorkeur is. Het is het verschil tussen een tool die zijn prijs verdient en een die je saldo leegzuigt terwijl je niet oplet.
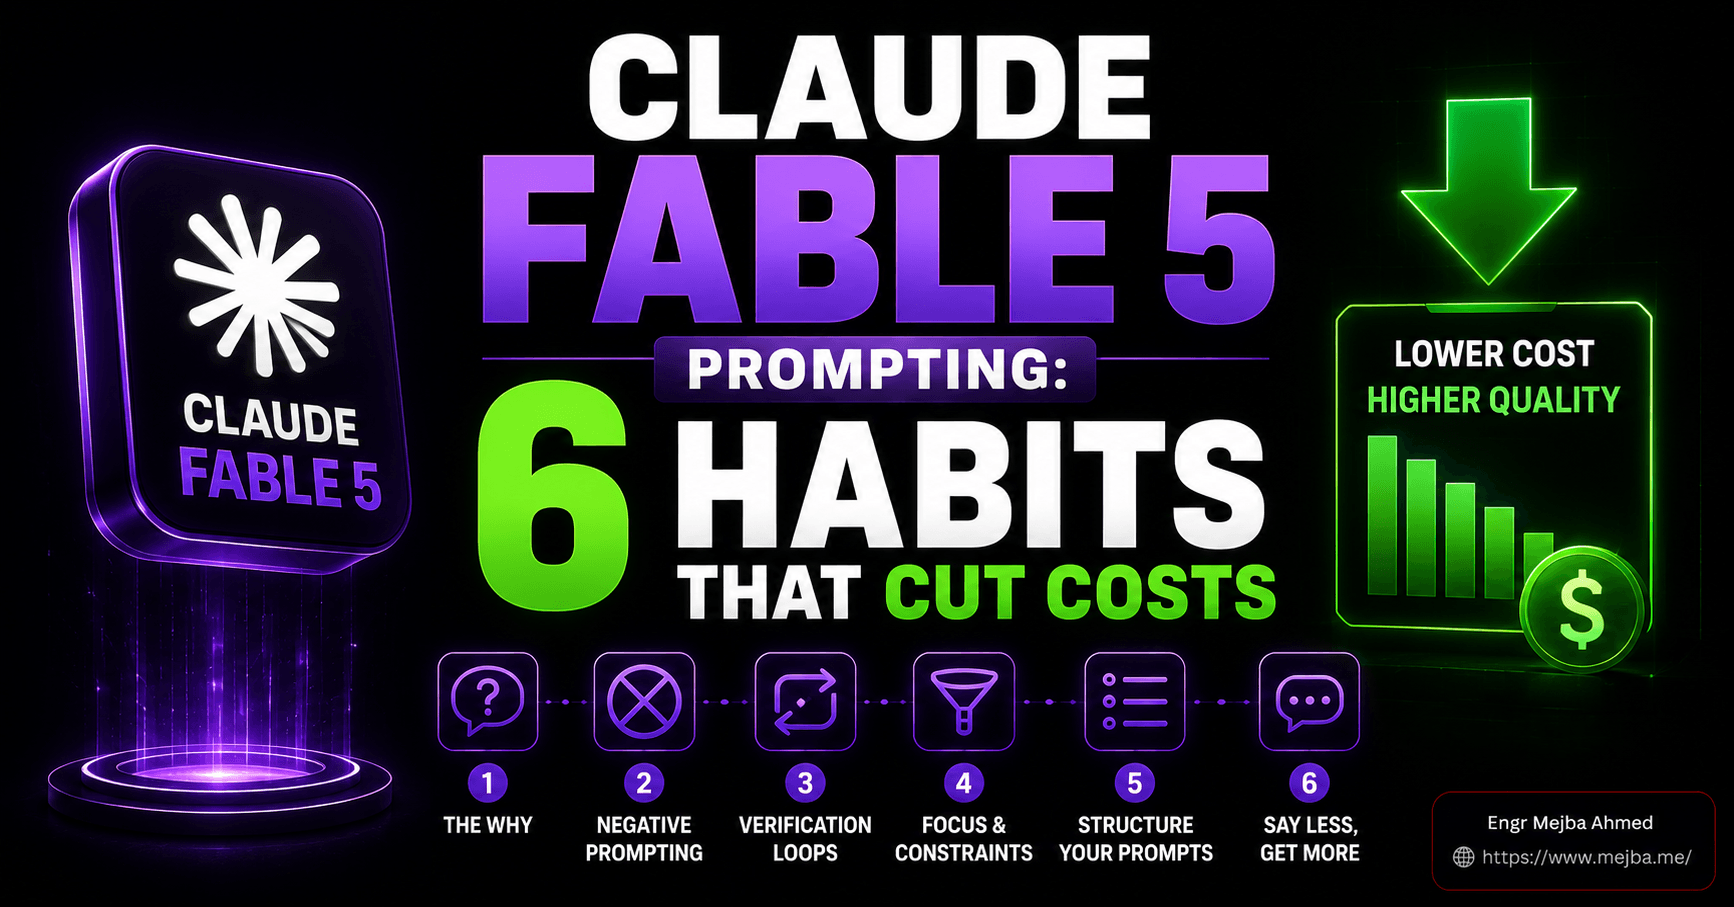
Ik heb de afgelopen dagen sinds Fable 5 terug is besteed aan het herbouwen van hoe ik ermee praat — in mijn AI-besturingssysteem gebouwd op Claude Code, mijn dagelijkse klantrepo's, en het tweede brein dat ik in Obsidian draai. Zes gewoontes deden het zware werk. Elk daarvan maakt de output beter en de rekening kleiner tegelijk, wat zeldzamer is dan het klinkt. Dit is die lijst.
Als je het companion-artikel wilt — wat je Fable 5 daadwerkelijk moet laten doen tijdens het gratis window, dat Anthropic verlengde tot 12 juli na de oorspronkelijke deadline van 7 juli — heb ik acht hoog-hefboom workflows voor het gratis window apart in kaart gebracht. Die post is de to-do-lijst. Deze is de hoe-zeg-je-het. Lees ze samen en je hebt beide helften.
Waarom Fable 5 een slordige prompt harder afstraft dan welk model ik ook heb gebruikt
Laat me eerst echte cijfers op tafel leggen voordat de gewoontes komen, want de gewoontes slaan pas aan als je de kostenmechaniek in je onderbuik voelt.
Fable 5 is het capabelste model dat Anthropic op dit moment uitbrengt, en het is geprijsd als zodanig: $10 per miljoen invoertokens, $50 per miljoen uitvoertokens (Anthropic's prijsdocumentatie bevestigt het tarief). Dat is ruwweg het dubbele van Opus 4.8's $5-in / $25-uit. Tot zover "premium model is premium."
Hier komt het deel dat verandert hoe je zou moeten prompten. De redenering die Fable 5 doet — het interne denken voordat het je antwoord geeft — wordt in rekening gebracht als uitvoertokens, tegen datzelfde tarief van $50 per miljoen. Denk-tokens zijn de duurste tokenklasse op de hele tarievenlijst. En je ziet ze niet terug in het antwoord. Een reactie die er op je scherm uitziet als 300 woorden kan tien keer zoveel verbruikt hebben aan redenering die je nooit las.
Leg daar nu de effort-levels overheen. Fable 5's API stelt effort beschikbaar als low, medium, high (de standaard), xhigh en max (Anthropic's effort-documentatie beschrijft de niveaus; in Claude Code verschijnt de hoogste trede als de ultra/ultracode-versnelling die ik onderzocht in mijn Opus 4.8 effort-levels-review). Effort verandert niet het tarief per token — Fable 5 is $10/$50 op elk niveau. Wat effort verandert is hoeveel tokens het model besteedt aan denken voordat het antwoordt. Zet effort op max en je hebt niet elke token duurder gemaakt; je hebt het model verteld om veel meer van de duurste tokens op het menu te kopen.
Zet die twee feiten bij elkaar en je hebt de hele stelling van deze post: op Fable 5 wordt de kostprijs van een taak minder bepaald door wat je vraagt dan door hoe je het vraagt. Een vage prompt laat het model rondjes redeneren op $50 per miljoen om te achterhalen wat je bedoelde. Een prompt die open verkenning uitnodigt, laat het verkennen — duur. Een prompt met een verzoek om redenering te onthullen kan je zonder waarschuwing op een ander model doen belanden.
Dat is geen reden om Fable 5 te vermijden. Het is een reden om het te prompten als de specialist die het is. Er zit één gewoonte tussen — de vijfde — die echt Fable-specifiek is en die de meeste mensen nu verkeerd doen, omdat het gedrag dat hij uitbuit niet bestond op oudere modellen. Hou hem in je achterhoofd; ik sluit die lus later.
Zes gewoontes. Grofweg gerangschikt naar hoeveel geld elke één per prompt bespaart.
Gewoonte 1: Geef het "waarom", niet alleen het "wat"
De verandering met het hoogste rendement die ik doorvoerde was ook de minst intuïtieve, omdat het betekent dat je meer schrijft om minder uit te geven.
Elk verzoek draagt een reden met zich mee — de uitkomst waar je eigenlijk achteraan zit. De meeste prompts gooien die reden weg en geven het model alleen de mechanische instructie. "Schrijf een e-mail over de vertraging." "Refactor deze klasse." "Vat deze notities samen." Het model moet je bedoeling dan reconstrueren uit de kale taak, en reconstructie is precies het soort open-eind redenering dat de meter laat lopen op Fable 5.
Geef het waarom vooraf en je klapt dat gokken in. Vergelijk:
Zwak: "Schrijf een e-mail aan de klant over de uitloop van de planning."
Sterk: "Schrijf een e-mail aan een klant die de ankerklant is voor een veel grotere uitrol volgend kwartaal — de relatie doet er meer toe dan deze ene deadline. De planning loopt twee weken uit. Ik wil dat ze zich geïnformeerd en in controle voelen, niet gemanaged. Hou het kort en specifiek over de nieuwe data."
De tweede versie is niet langer omwille van de lengte. Elke extra bijzin verwijdert een vertakking die het model anders op eigen kosten had moeten verkennen — de toon, de belangen, de lengte, het doel. Fable 5's semantisch begrip is scherp genoeg dat wanneer je het echte context geeft, het stopt met wikken en wegen over een dozijn mogelijke lezingen en zich vastlegt op de juiste. Scherpere output, minder redeneertokens om er te komen. Je hebt een paar invoertokens à $10 per miljoen betaald om een stapel uitvoertokens à $50 per miljoen te vermijden.
Dit compoundt hard als het model verbonden is met een contextsysteem. In mijn tweede brein is "het waarom" vaak een verwijzing: "Dit is voor de Q3-partnerreview — trek de relevante contextbestanden op en schrijf tegen wat we in de laatste sync afspraken." Die ene zin vertelt Fable 5 welke notities te laden en hoe succes eruitziet, en het context-verslaat-configuratie-principe waar ik over schreef doet de rest. Het model redeneert niet in een vacuüm. Het redeneert tegen je werkelijke situatie.
De regel die ik nu volg: als ik mezelf betrap op een kale gebiedende wijs, stop ik en voeg de bijzin toe die begint met "omdat." Negen van de tien keer is die bijzin het waardevolste in de prompt.
Gewoonte 2: Vertel het wat NIET te doen
Context vertelt het model waar het heen moet. Negatief prompten vertelt het waar de kliffen zitten — en Fable 5 is het eerste model waarop ik dit netjes zag landen in plaats van half genegeerd te worden.
De faalmodus die negatief prompten wegneemt is ongevraagd initiatief. Je vraagt het model een bug te onderzoeken en het "helpt" door drie ongerelateerde bestanden te refactoren. Je vraagt het een document te reviewen en het herschrijft de helft. Elk van die ongevraagde acties is uitvoertokens waar je voor betaalt en opruimwerk waar je niet om vroeg — een dubbele belasting, geld en tijd.
Dus ik stel nu het hek expliciet:
"Onderzoek waarom dit endpoint een 500 teruggeeft en rapporteer wat je vindt. Bewerk, verwijder of 'fix' niets tot ik het zeg."
Die laatste zin redt me constant. Zonder hem zal een capabel model met de kriebel om nuttig te zijn dingen gaan "verbeteren", en op Fable 5 zijn die verbeteringen geen gratis experimenten — het zijn premium-geprijsde. Met hem doet het model precies de begrensde taak en stopt, en beslis ik wat het waard is om op te acteren.
Een paar negatieve prompts die ik in rotatie hou omdat ze hun plek verdienen:
- "Alleen bevindingen rapporteren. Geen bestanden wijzigen." — voor elk onderzoek of audit.
- "Voeg geen dependencies of nieuwe libraries toe tenzij er geen redelijk alternatief is, en meld het eerst als dat zo is." — stopt scope creep in code-taken keihard.
- "Herschrijf geen secties die al werken. Raak alleen aan wat ik noemde." — voor bewerken, waar modellen graag te ver reiken.
Één nuance leerde ik op de harde manier: negatief prompten werkt samen met positieve framing, niet in plaats van. "Breek de tests niet" is zwakker dan "hou elke bestaande test groen, en voeg pas daarna dekking toe voor het nieuwe gedrag." Geef het model een doel om te raken én het hek om niet over te steken. Ik ging dieper in op die balans in mijn prompt-regels die gokwerk verminderen — het hele spel is het model zo min mogelijk ruimte laten om te verzinnen, want verzinnen is waar zowel bugs als tokenrekeningen vandaan komen.
Gewoonte 3: Laat het handelen zodra het genoeg heeft — en stem de effort af op de taak
Dit is de gewoonte die de meter het meest direct raakt, dus vertraag hier.
Capabele redeneermodellen hebben de neiging om zich te veel voor te bereiden. Stel een open vraag en ze onderzoeken uitputtend, wegen zes opties af, bouwen een plan voor het plan — soms echt nuttig, vaak gewoon dure keelgeschraap voordat een antwoord komt dat drie stappen eerder al bereikbaar was. Op een model waar denken $50 per miljoen kost, is die aanloop een aparte kostenpost.
Dus ik vertel Fable 5 nu, in gewone taal, om te handelen zodra het genoeg heeft:
"Verzamel wat je echt nodig hebt en ga dan door. Onderzoek niet te veel — zodra je genoeg hebt om verstandig te handelen, handel. Kom je een echte splitsing tegen die je niet kunt oplossen, stel me dan één scherpe vraag in plaats van te gokken."
Die ene instructie snijdt lange, dure overweging weg op taken die het niet nodig hadden. Fable 5 volgt korte, heldere aansturing goed genoeg dat "stop met plannen en beweeg" echt aankomt — de redenering is goed genoeg om te weten wanneer het genoeg heeft, als je het toestemming geeft om te stoppen.
De andere helft van deze gewoonte is de effort-knop, en daar zit het meeste geld verstopt. Laat alles op de standaard high staan en je betaalt te veel op routinewerk en onder-power soms het lastige spul. Mijn werkkaart:
- Low / medium — opzoekingen, hernoemingen, boilerplate, "waar is X gedefinieerd," een snelle schets. Routinewerk hoort niet op high effort.
- High (standaard) — echt featurewerk, wijzigingen over meerdere bestanden, alles waar je een collega écht wilt laten nadenken.
- Xhigh / max — echt taaie refactors, architectuurkeuzes, subtiele debugging. Grijp hier bewust naar, niet uit gewoonte.
Hier is de herformulering die me het meeste bespaarde: je zou Fable 5 waarschijnlijk voor het meeste van je werk helemaal niet moeten draaien. De community-claim die rond de lancering rondzweeft — dat Fable 5 op low effort gelijkstaat aan Opus 4.8 op zijn hoogste stand — kan ik niet netjes verifiëren, en ik zou elke precieze "Fable low is Opus max"-gelijkstelling als marketing behandelen tot je het op je eigen taken hebt getest. Maar de vorm van het advies klopt sowieso: Fable 5 is een scalpel, geen dagelijkse werkpaard. In mijn eigen routing doet het misschien 5–15% van het werk — de diepe passages waar zijn plafond er echt toe doet — en dragen Opus 4.8 of goedkopere modellen de routinelast. Fable 5 voor alles gebruiken is geen toewijding aan kwaliteit. Het is hoe je geld in de fik zet. Ik zette de bredere routing-wiskunde uiteen in mijn gids voor AI-agent kostenoptimalisatie, en die geldt dubbel bij deze tarieven.
De discipline: kies het goedkoopste model én het laagste effort-niveau dat de klus werkelijk klaart. Niet het hoogste dat je je kunt veroorloven. Het laagste dat werkt.
Gewoonte 4: Laat het zijn werk bewijzen voordat het iets "klaar" noemt
Elk model verklaart af en toe overwinning die het niet verdiende — tests "geslaagd" die nooit draaiden, een fix "toegepast" op een bestand dat het verkeerd las, een samenvatting die zelfverzekerd een bron citeert die het tegenovergestelde zegt. Op een goedkoop model is dat een irritatie. Op Fable 5 is het een irritatie waar je een premium voor betaalde, en erger, het is het soort fout dat je een tweede dure round-trip kost om te vangen en te corrigeren.
Dus ik bak verificatie in de instructie zelf:
"Voordat je zegt dat dit klaar is, verifieer het. Draai de tests en toon me de output. Als je een claim niet kunt verifiëren, zeg dat dan duidelijk in plaats van te gokken — ik hoor liever 'ik kon het caching-pad niet bevestigen' dan een zelfverzekerd antwoord dat verkeerd blijkt."
Twee dingen laten dit werken. Ten eerste, bewijs eisen — echte commando-output, de specifieke regel die je veranderde, het citaat uit de bron — geen samenvatting van bewijs. "De tests slagen" is een claim. De geplakte testrunner-output is bewijs. Forceer het bewijs.
Ten tweede, en dit is het deel dat prachtig past bij Fable 5's eerlijkheid-tuning: geef het model expliciet toestemming om te zeggen "ik kon dit niet verifiëren." De nieuwere Claude-modellen zijn merkbaar beter in het aangeven van de rand van hun eigen kennis als je ze daartoe uitnodigt, en één eerlijk "ik ben niet zeker van dit deel" bespaart je de veel duurdere ontdekking dat het iets verzon en jij het live zette. Een model dat twijfel toegeeft is elke keer goedkoper dan een model dat zelfverzekerd fabriceert.
Dit is niet Fable-specifiek — verificatielussen verbeteren elk model, en ik zou zeggen dat het de meest vertrouwenwekkende gewoonte in deze hele lijst is. Maar hij is waardevoller op Fable 5, juist omdat de kosten van een ongeverifieerde fout hier hoger zijn. Als de fouten duur zijn, is de gewoonte die fouten vroeg vangt het meest waard.
Als je liever hebt dat iemand deze verificatielussen direct in de agents en skills van je team bouwt — zodat de "bewijs het"-stap in het systeem gebakken zit in plaats van elke prompt opnieuw getikt — dan is dat precies het soort setup-werk dat ik op me neem. Je ziet wat ik heb gebouwd op fiverr.com/s/EgxYmWD.
Gewoonte 5: Vraag Fable 5 niet langer om zijn redenering te tonen
Hier is de lus die ik bovenaan opende — de ene gewoonte die echt specifiek is voor dit model, en degene die ik mensen het meest verkeerd zie doen.
Stop met "leg je redenering stap voor stap uit" en "loop me door je denken heen" en "toon je chain of thought" in je Fable 5-prompts te zetten. Niet omdat het advies in het algemeen slecht is — het is al jaren solide prompt-craft. Maar op Fable 5, na zijn terugkeer, kunnen verzoeken om redenering te onthullen de safety-classifier triggeren.
Wat context over waarom. Fable 5 kwam begin juli weer online onder een aanzienlijk aangescherpte veiligheidslaag, na de hele exportcontrole-saga die ik in mijn analyse over Fable 5's terugkeer uiteenzette. De nieuwe classifier is gebouwd om een specifieke jailbreak-klasse af te sluiten — en berichtgeving over de terugkeer meldt dat hij de doeltechniek in meer dan 99% van de gevallen blokkeert, ten koste van een hogere false-positive rate op gewone verzoeken (TechTimes berichtte over het gedrag van de nieuwe classifier). Pogingen om de interne werking van het model te extraheren liggen ongemakkelijk dicht bij de jailbreak-patronen waar de classifier op is afgestemd om te vangen.
Als een verzoek die classifier triggert, weigert Fable 5 niet gewoon. Het stuurt het verzoek door naar Opus 4.8. Volgens de berichtgeving word je hier over het algemeen van op de hoogte gesteld, en via de API is het antwoordende model zichtbaar als je goed kijkt — maar in een lange agent-run, of een gepraat-desktop-sessie, is het echt makkelijk te missen. Je denkt dat je Fable 5's plafond krijgt. Je krijgt stilletjes een ander model.
De economie van die reroute is een tweesnijdend zwaard dat het waard is te begrijpen. Als je naar Opus 4.8 wordt teruggekaatst, betaal je Opus's lagere tarief — dus een afgewaardeerde reactie kost je feitelijk minder. Dat klinkt als winst tot je onthoudt waarom je naar Fable 5 greep: je wilde zijn plafond op een moeilijk probleem. Stilzwijgend een minder capabel model krijgen op precies de taak waar je premium voor betaalde om te raken, is geen korting. Het is een kwaliteitsdaling die je niet koos en misschien niet opmerkt.
Dus de fix is simpel en hij is gratis: strip verzoeken om redenering te onthullen uit je Fable 5 system prompts en user prompts. Als je het denken van het model echt moet zien, is dat waar verificatie-output (Gewoonte 4) voor is — vraag om bewijs en resultaten, geen blootgelegd denkproces. Je krijgt de verantwoording zonder een rode vlag naar de classifier te zwaaien. Ik hou één versie van mijn system prompt voor Fable 5 waar alle "leg je redenering uit"-taal uit geschrapt is, en een andere voor andere modellen waar het nog steeds prima is. Kleine verandering. Het is het verschil tussen het model draaien waar je voor betaalt en een look-alike draaien.
Gewoonte 6: Zeg minder, niet meer
De laatste gewoonte is degene die de andere vijf aan elkaar bindt, en het is degene die tegen elk instinct vecht dat het Opus 4.7-tijdperk in ons drilde.
Jarenlang betekende goede output krijgen meer — meer regels, meer voorbehouden, meer expliciete edge-case-behandeling, langer en langer system prompts die instructie op instructie stapelden om het model in te hekken. Fable 5 doorbreekt die reflex. Het is intelligent genoeg dat een strakke, goed gerichte prompt een verbeus regelboek verslaat — en het verbeuze regelboek kost je invoertokens op elke call én nodigt het model uit om over al die instructie te redeneren tegen $50 per miljoen op output.
Vergelijk een echte voor-en-na uit mijn eigen contentpijplijn. De oude versie was een veertien-regelige lijst met regels over toon, structuur, wat te vermijden, hoe te formatteren, wanneer te vragen. De nieuwe versie:
"Begin met de uitkomst. Hou het simpel en specifiek. Pauzeer alleen om me iets te vragen wanneer het werk echt een beslissing nodig heeft die ik nog niet gemaakt heb."
Drie zinnen. Het produceert schonere concepten dan de veertien-regelige versie deed, omdat Fable 5 niet worstelde om de regels te gehoorzamen — het werd erdoor afgeleid. Intelligentie plus beknoptheid verslaat intelligentie plus een muur van beperkingen.
De valstrik, en dat is belangrijk zodat ik Gewoonte 1 niet tegenspreek: minder is niet hetzelfde als vaag. Gewoonte 1 zei geef het context. Gewoonte 6 zegt verdrink die context niet in regels. Die zijn niet in strijd — de hoogwaardige content (het waarom, het doel, het hek) blijft; het laagwaardige ceremonieel (voor de hand liggende instructies, redundante voorbehouden, defensieve overspecificatie) gaat. Je snijdt ballast, geen signaal.
Dit is ook wat strakke integratie met skills en contextbestanden echt laat werken. Wanneer je prompt slank is, heeft het model ruimte om te leunen op je system prompt, je contextbestanden en je skills in plaats van een opgeblazen instructie elke beurt opnieuw te lezen. Beknoptheid op prompt-niveau is wat het systeem-niveau zijn werk laat doen — dezelfde verschuiving die ik traceerde toen prompt engineering plaats maakte voor loop engineering. Zeg minder in de prompt zodat de architectuur eromheen meer kan zeggen.
Waar de zes gewoontes hun grenzen bereiken
Ik heb deze hele post gewoontes zitten aanreiken, dus laat me eerlijk zijn over de wrijving, want een net zes-stappen-lijstje dat doet alsof er geen nadeel is, is gewoon een advertentie.
De reroute is het ding om in de gaten te houden, en het is makkelijk uit het oog te verliezen. Gewoonte 5 ontmantelt de trigger om redenering te onthullen, maar de classifier is strak genoeg afgesteld dat legitiem werk — vooral defensieve security — je zonder luid signaal alsnog naar Opus 4.8 kan doen stuiteren. Als je Fable 5-tarieven betaalt specifiek voor een moeilijke taak, controleer dan echt welk model antwoordde. Kun je het niet zien vanaf je oppervlak, dan is dat een reden om hoog-inzet Fable 5-werk ergens te draaien waar het antwoordende model zichtbaar is.
De meeste van deze gewoontes helpen elk model — en dat is het punt, geen zwakte. Context, negatief prompten, verificatie, beknoptheid: niets daarvan is Fable-exclusief. Wat Fable-specifiek is, is hoe duur het is om ze hier over te slaan. Dezelfde slordige prompt die centen verspilt op een goedkoop model, verspilt echt geld op Fable 5. De gewoontes veranderen niet. De inzet wel.
De grootste hefboom is helemaal geen prompting-gewoonte. Het is Fable 5 niet gebruiken. Ik zeg het nog eens omdat het degene is waar mensen zich tegen verzetten: de juiste hoeveelheid Fable 5 in je workflow is klein. Route het routinematige 85–95% van je werk naar Opus 4.8 en goedkopere modellen, en bewaar Fable 5 voor de passages waar zijn plafond de uitkomst echt verandert. De beste Claude Fable 5 prompt-gewoonte, uiteindelijk, is weten wanneer je Fable 5 niet moet prompten.
Hoe ik deze zes gewoontes in het systeem bak, niet in de prompt
Gewoontes die je moet onthouden zijn gewoontes die je om 23:00 op een deadline overslaat. Dus ik stopte met vertrouwen op geheugen en duwde alle zes omlaag naar de laag onder de prompt.
Drie plekken waar ze nu wonen:
In de system prompt. Mijn Fable 5 system prompt heeft de invarianten ingebakken: ga door zodra je genoeg hebt, verifieer voordat je iets klaar noemt, zeg het als je iets niet kunt bevestigen, en — de Fable-specifieke — nul taal die redenering onthult ergens in. Ik typ deze niet opnieuw. Ze zijn de vloer waarop elke prompt start.
In skills. Voor herhaalbare klussen — een code-reviewpassage, een onderzoekssamenvatting, een contentconcept — leeft de verificatielus en het negatief-prompten-hek binnen de skill-definitie zelf. De skill is de gewoonte, één keer gecodeerd. Als ik hem aanroep, komt het contract "bewijs je werk, raak niet aan wat ik niet noemde" automatisch mee. Dit is dezelfde tweede-brein-plus-skills-architectuur waar ik naartoe bouw in mijn AI-besturingssysteem op Claude Code.
In effort-defaults per taaktype. In plaats van elk keer een effort-niveau te kiezen op gevoel, map ik taaktypes één keer naar niveaus en laat de routing volgen. Routineskills defaulten naar low of medium; de diepe-pas-skills reserveren high en hoger. De beslissing verhuist uit het moment naar het ontwerp.
De opbrengst is dat de dure fouten — de op hol geslagen redenering, de stille reroute, het zelfverzekerde verzinsel, de veertien-regelige prompt — geen dingen meer zijn die ik in realtime moet vangen. Het systeem vangt ze, omdat ik de vangst één keer heb gecodeerd. Dat is de werkelijke bestemming van alle zes gewoontes: geen betere prompts getypt door een gedisciplineerde mens, maar een setup waar de discipline structureel is en de mens een beetje slordig mag zijn zonder ervoor te betalen.
De echte kosten van een Fable 5 prompt
Terug naar die 41-woorden-prompt van bovenin. De verspilling was niet echt de 41 woorden. Het was alles wat ze in gang zetten: het open-eind redeneren tegen $50 per miljoen, de "leg je redenering uit"-regel die me misschien naar een ander model stuiterde, het initiatief dat ik niet afhekte, de regels die ik stapelde in plaats van de context die ik had moeten geven. Eén luie prompt, vier aparte lekken.
Fable 5 is het capabelste model dat ik in handen heb gehad, en het rekent ook zo. Die combinatie zorgt ervoor dat prompten geen soft skill meer is en een kostencontrole wordt — dezelfde instructie, twee manieren geformuleerd, kan een orde van grootte verschillen in wat het verbrandt en of het überhaupt draait op het model dat je bedoelde. De zes gewoontes gaan er niet over een betere zin uit het model te wringen. Ze gaan erover geen premium-tarieven voor je eigen onnauwkeurigheid te betalen.
Hier is je ene ding om vandaag te doen: pak de ene prompt of system prompt die je Fable 5 het vaakst stuurt en haal hem door de zes. Voeg het waarom toe. Hek af wat je niet wilt. Vertel het te handelen en te verifiëren. Strip elke "leg je redenering uit" eruit. Halveer hem dan. Stuur beide versies tegelijk op dezelfde taak en kijk naar de token-teller. Het verschil dat je ziet is de belasting die je hebt betaald — en nu weet je hoe je moet stoppen.
Veelgestelde vragen
Waarom is Claude Fable 5 zo duur om te prompten?
Claude Fable 5 kost $10 per miljoen invoertokens en $50 per miljoen uitvoertokens — ruwweg het dubbele van Opus 4.8 — en zijn interne redenering wordt als uitvoer gefactureerd tegen datzelfde $50-tarief. Een vage of opgeblazen prompt laat het model meer redeneren voor het antwoordt, dus onnauwkeurig prompten drijft de kosten direct op. Strakke, contextrijke prompts geven minder van die dure redeneertokens uit.
Veranderen effort-niveaus hoeveel Claude Fable 5 kost?
Effort-niveaus veranderen niet het tarief per token — Fable 5 is $10/$50 op elk niveau. Wat ze veranderen is hoeveel tokens het model besteedt aan denken voor het antwoordt. Hoger effort (xhigh, max) kan veel meer tokens gebruiken dan de zichtbare output doet vermoeden, dus effort matchen aan de moeilijkheid van de taak is een directe kostenhefboom. Zie Gewoonte 3 hierboven voor de volledige kaart.
Waarom schakelt Claude Fable 5 soms over naar Opus 4.8?
Fable 5's aangescherpte safety-classifier stuurt gemarkeerde verzoeken — inclusief pogingen om redenering te onthullen en sommige legitieme defensieve-security-werk — door naar Opus 4.8. Berichtgeving zegt dat je over het algemeen bericht krijgt en de API laat het antwoordende model zien, maar het is makkelijk te missen in een lange sessie. Je betaalt Opus's lagere tarief bij downgrade, maar je verliest het Fable 5-plafond waar je voor betaalde.
Zou ik Claude Fable 5 moeten vragen zijn redenering uit te leggen?
Nee — specifiek op Fable 5 kunnen "leg je redenering uit"-achtige verzoeken de safety-classifier triggeren en je doorsluizen naar Opus 4.8. Als je verantwoording nodig hebt, vraag dan om verificatiebewijs (testoutput, de exacte wijziging, broncitaten) in plaats van een blootgelegd denkproces. Je krijgt dezelfde verantwoording zonder het reroute-risico. Zie Gewoonte 5 hierboven.
Welk percentage van mijn werk zou daadwerkelijk op Claude Fable 5 moeten draaien?
In mijn eigen routing, ruwweg 5–15% — de diepe passages waar zijn plafond de uitkomst echt verandert. Route het routinematige 85–95% naar Opus 4.8 en goedkopere modellen. Fable 5 als dagelijkse werkpaard gebruiken, gezien zijn tarieven, is de snelste manier om je saldo leeg te zuigen voor kwaliteit die je op de meeste taken niet nodig had.
Wil je de prompt-discipline ingebouwd hebben?
Deze zes gewoontes lonen alleen als je ze echt draait, en om 23:00 op een deadline doet niemand dat. Als je liever hebt dat de verificatielussen, de hekken en de Fable-5-veilige prompt-hygiëne in de system prompts en skills van je team bedraad worden in plaats van elke sessie opnieuw getypt, dan is dat het soort setup dat ik op me neem — zie wat ik bouw hier.