El prompt más caro que envié la semana pasada tenía 41 palabras, y solo las nueve primeras hicieron algo útil — mi primera lección real sobre el prompting de Claude Fable 5 desde que el modelo volvió.
Estaba conectando un nuevo flujo de captura a mi segundo cerebro — el setup de Obsidian-más-Claude-Code con el que llevo toda mi vida — y disparé una de esas instrucciones infladas, con cinturón y tirantes, que había cogido la costumbre de escribir durante la era Opus 4.7. "Haz esto, pero no hagas aquello, y asegúrate también de considerar esto otro, y explícame tu razonamiento en cada paso para que pueda seguirte, y sé exhaustivo." Ya conoces la forma. Esa instrucción en la que intentas anticiparte a cada manera en que el modelo podría equivocarse apilando reglas sobre reglas.
En Opus ese prompt era simplemente ineficiente. En Claude Fable 5 era un pequeño incendio. Porque Fable 5 factura 10 dólares por millón de tokens de entrada y 50 por millón de salida — y esa línea de "explícame tu razonamiento en cada paso" no solo infló la respuesta, sino que puede haber desviado la petición silenciosamente a un modelo distinto. Ya llegaré a por qué. La versión corta es que un buen prompting de Claude Fable 5 no es una preferencia de estilo en este modelo. Es la diferencia entre una herramienta que se gana su precio y una que te vacía la cuenta mientras miras a otro lado.
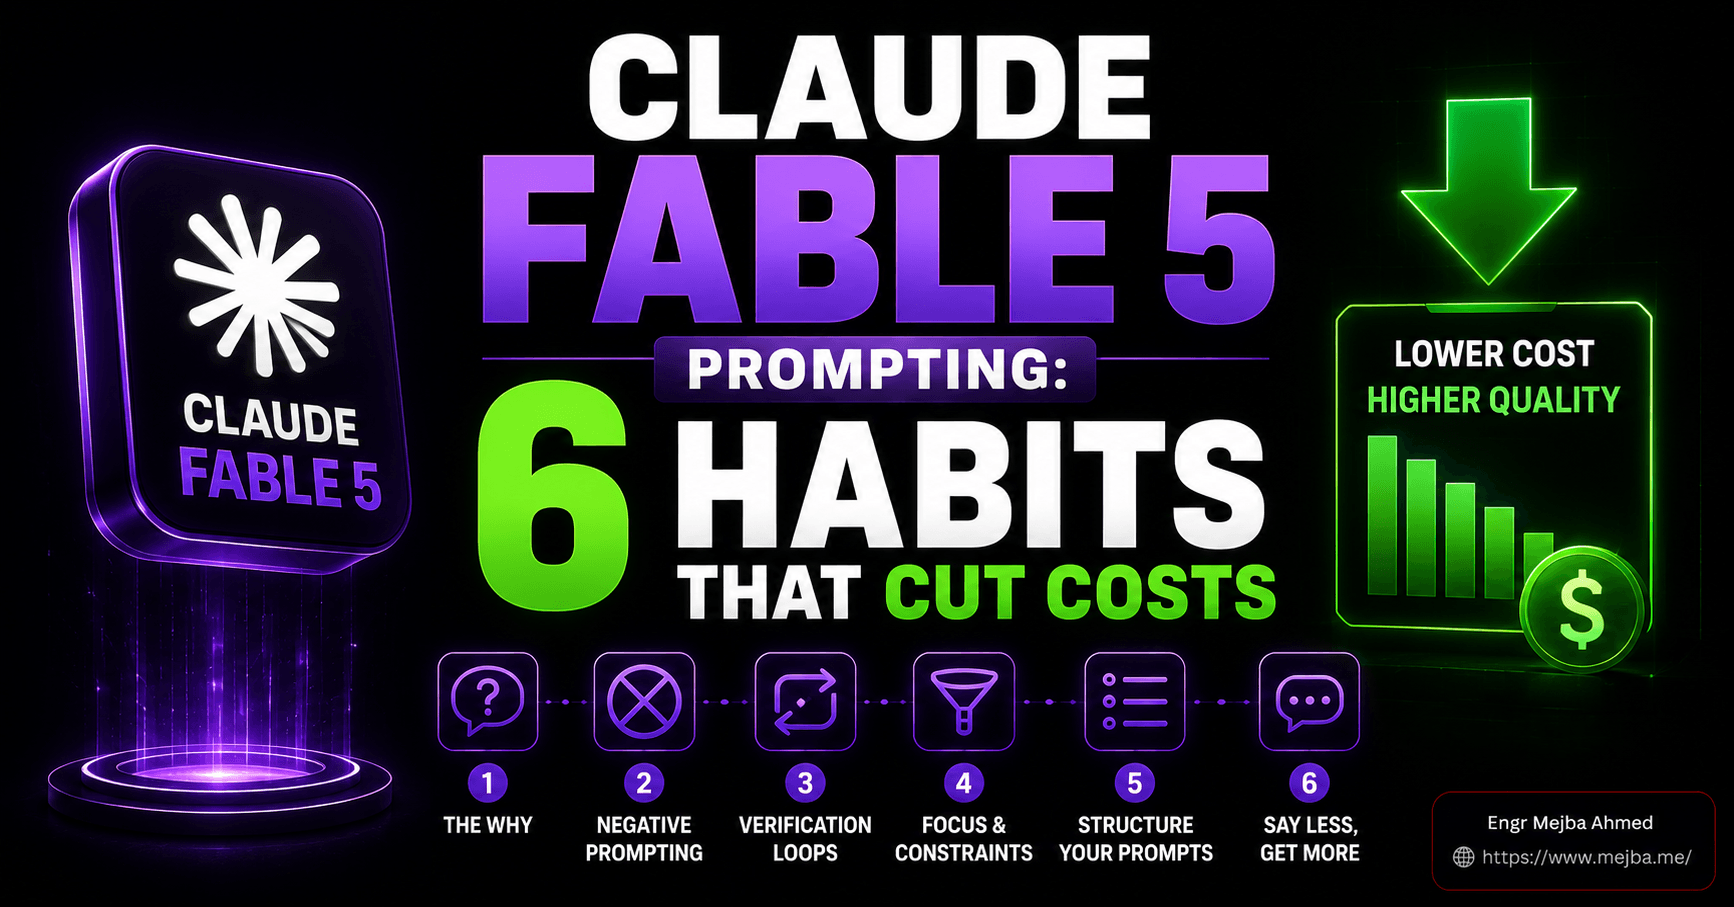
He pasado los días desde que Fable 5 volvió reconstruyendo cómo le hablo — a través de mi sistema operativo de IA construido sobre Claude Code, mis repos diarios de cliente y el segundo cerebro que llevo en Obsidian. Seis hábitos hicieron el trabajo pesado. Cada uno de ellos mejora el resultado y reduce la factura al mismo tiempo, algo más raro de lo que parece. Esta es esa lista.
Si quieres la pieza complementaria — a qué apuntar Fable 5 durante la ventana gratuita, que Anthropic amplió hasta el 12 de julio tras el corte original del 7 de julio — mapeé ocho flujos de alto rendimiento para la ventana gratuita por separado. Ese post es la lista de tareas. Este es el cómo decirlo. Léelos juntos y tienes las dos mitades.
Por qué Fable 5 castiga un prompt descuidado más que cualquier modelo que haya usado
Déjame poner números reales antes de los hábitos, porque los hábitos solo tienen sentido cuando sientes la mecánica de costes en las tripas.
Fable 5 es el modelo más capaz que Anthropic tiene ahora mismo, y tiene precio acorde: 10 dólares por millón de tokens de entrada, 50 dólares por millón de tokens de salida (la documentación de precios de Anthropic confirma la tarifa). Eso es aproximadamente el doble de los 5 de entrada / 25 de salida de Opus 4.8. Hasta ahí, "modelo premium es premium".
Aquí viene la parte que cambia cómo deberías escribir tus prompts. El razonamiento que hace Fable 5 — el pensamiento interno antes de responderte — factura como tokens de salida, a esa misma tarifa de 50 dólares por millón. Los tokens de pensamiento son la clase de token más cara de toda la tarifa. Y no los ves en la respuesta. Una respuesta que en tu pantalla parece de 300 palabras puede haber quemado diez veces eso en razonamiento que nunca leerás.
Ahora añade encima los niveles de esfuerzo. La API de Fable 5 expone el esfuerzo como low, medium, high (el predeterminado), xhigh y max (la documentación de esfuerzo de Anthropic desglosa los niveles; en Claude Code, el peldaño superior aparece como el engranaje ultra/ultracode que examiné en mi reseña de los niveles de esfuerzo de Opus 4.8). El esfuerzo no cambia la tarifa por token — Fable 5 cuesta 10/50 en todos los niveles. Lo que cambia el esfuerzo es cuántos tokens gasta el modelo pensando antes de responder. Si subes el esfuerzo al máximo no has encarecido cada token; le has dicho al modelo que compre muchos más de los tokens más caros del menú.
Junta esos dos hechos y tienes toda la tesis de este post: en Fable 5, el coste de una tarea lo marca menos lo que pides que cómo lo pides. Un prompt vago hace que el modelo razone en círculos a 50 el millón para averiguar qué querías decir. Un prompt que invita a la exploración abierta hace que explore — caro. Un prompt con una petición de exposición del razonamiento puede desviarte a un modelo distinto sin avisarte a gritos.
Eso no es una razón para evitar Fable 5. Es una razón para tratarlo como el especialista que es. Hay un hábito aquí — el quinto — que es genuinamente específico de Fable y que la mayoría de la gente está haciendo mal ahora mismo, porque el comportamiento que explota no existía en modelos anteriores. Tenlo en mente; cerraré ese bucle.
Seis hábitos. Ordenados aproximadamente por cuánto dinero ahorra cada uno por prompt.
Hábito 1: Dale el "por qué", no solo el "qué"
El cambio más rentable que hice también fue el menos intuitivo, porque significa escribir más para gastar menos.
Cada petición lleva una razón detrás — el resultado que realmente persigues. La mayoría de los prompts tiran esa razón y le entregan al modelo solo la instrucción mecánica. "Escribe un email sobre el retraso." "Refactoriza esta clase." "Resume estas notas." El modelo tiene entonces que reconstruir tu intención a partir de la tarea pelada, y la reconstrucción es exactamente ese tipo de razonamiento abierto que hace correr el contador en Fable 5.
Dale el porqué desde el principio y colapsas ese adivinar. Compara:
Débil: "Escribe un email al cliente sobre el retraso del plazo."
Fuerte: "Escribe un email a un cliente que es el ancla para un despliegue mucho mayor el próximo trimestre — la relación importa más que este plazo concreto. El calendario se retrasa dos semanas. Quiero que se sientan informados y con el control, no gestionados. Que sea breve y específico sobre las nuevas fechas."
La segunda versión no es más larga por gusto. Cada cláusula extra elimina una bifurcación que el modelo habría tenido que explorar por su cuenta y a su cargo — el tono, lo que está en juego, la longitud, el objetivo. La comprensión semántica de Fable 5 es lo bastante afilada para que, cuando le das contexto genuino, deje de titubear entre una docena de lecturas posibles y se comprometa con la correcta. Salida más nítida, menos tokens de razonamiento para llegar allí. Pagaste unos pocos tokens de entrada a 10 el millón para evitar una pila de tokens de salida a 50.
Esto se multiplica con fuerza cuando el modelo está conectado a un sistema de contexto. En mi segundo cerebro, "el porqué" suele ser un puntero: "Esto es para la revisión de partners del Q3 — carga los archivos de contexto relevantes y redacta contra lo que acordamos en la última sync." Esa frase le dice a Fable 5 qué notas cargar y cómo se ve el éxito, y el principio de que el contexto vence a la configuración del que he escrito hace el resto. El modelo no razona en el vacío. Razona contra tu situación real.
La regla que sigo ahora: si me pillo escribiendo un imperativo pelado, me paro y añado la cláusula que empieza con "porque". Nueve de cada diez veces esa cláusula es lo más valioso del prompt.
Hábito 2: Dile lo que NO tiene que hacer
El contexto le dice al modelo a dónde ir. El prompting negativo le dice dónde están los precipicios — y Fable 5 es el primer modelo en el que he visto esto aterrizar limpiamente en vez de ser medio ignorado.
El modo de fallo que mata el prompting negativo es la iniciativa no pedida. Le pides que investigue un bug y "amablemente" refactoriza tres archivos no relacionados. Le pides que revise un documento y reescribe la mitad. Cada una de esas acciones no invitadas son tokens de salida que estás pagando y trabajo de limpieza que no pediste — un doble impuesto, en efectivo y en tiempo.
Así que ahora enuncio la valla explícitamente:
"Investiga por qué este endpoint devuelve un 500 e informa de lo que encuentres. No edites, no borres ni 'arregles' nada hasta que yo dé el visto bueno."
Esa última frase me salva constantemente. Sin ella, un modelo capaz con ganas de ser útil empezará a "mejorar" cosas, y en Fable 5 esas mejoras no son experimentos gratis — son de precio premium. Con ella, el modelo hace exactamente la tarea acotada y para, y yo decido qué merece la pena tocar.
Algunos prompts negativos que mantengo en rotación porque se ganan su sitio:
- "Solo informa de los hallazgos. No cambies archivos." — para cualquier investigación o auditoría.
- "No añadas dependencias ni librerías nuevas salvo que no haya alternativa razonable, y si es así avísame primero." — corta en seco el scope creep en tareas de código.
- "No reescribas secciones que ya funcionan. Toca solo lo que te he nombrado." — para edición, donde a los modelos les encanta extralimitarse.
Un matiz que aprendí por las malas: el prompting negativo funciona junto con el encuadre positivo, no en su lugar. "No rompas los tests" es más débil que "mantén verdes todos los tests existentes y solo después añade cobertura para el nuevo comportamiento". Dale al modelo un objetivo que cumplir y la valla que no debe cruzar. Profundicé en ese equilibrio en mis reglas de prompting que reducen las suposiciones — todo el juego es dejarle al modelo el menor margen posible para inventar, porque la invención es donde nacen tanto los bugs como las facturas de tokens.
Hábito 3: Deja que actúe en cuanto tenga suficiente — y ajusta el esfuerzo a la tarea
Este es el hábito que toca el contador más directamente, así que ve despacio aquí.
Los modelos de razonamiento capaces tienden a sobrepreparse. Hazles una pregunta abierta y investigarán exhaustivamente, sopesarán seis opciones, construirán un plan para el plan — a veces genuinamente útil, a menudo solo carraspeo caro antes de una respuesta que estaba a tres pasos de distancia. En un modelo donde el pensamiento se factura a 50 el millón, ese preámbulo es una línea de coste.
Así que ahora le digo a Fable 5, con palabras claras, que actúe en cuanto tenga suficiente:
"Reúne lo que realmente necesites, luego procede. No sobreinvestigues — cuando tengas lo suficiente para actuar con sensatez, actúa. Si te encuentras con una bifurcación real que no puedes resolver, hazme una pregunta afilada en vez de adivinar."
Esa única instrucción recorta deliberaciones largas y costosas en tareas que no las necesitaban. Fable 5 sigue instrucciones cortas y claras lo bastante bien como para que "deja de planificar y muévete" aterrice de verdad — su razonamiento es lo bastante bueno para saber cuándo tiene suficiente, si le das permiso para parar.
La otra mitad de este hábito es el dial del esfuerzo, y ahí se esconde la mayor parte del dinero. Déjalo todo en el default high y estás pagando de más en trabajo rutinario y, a veces, quedándote corto en lo difícil. Mi mapa de trabajo:
- Low / medium — búsquedas, renombrados, boilerplate, "dónde está definido X", un borrador rápido. El trabajo rutinario no tiene por qué estar en high effort.
- High (default) — trabajo real de features, cambios en varios archivos, cualquier cosa donde querrías que un colega pensara de verdad.
- Xhigh / max — refactors realmente peliagudos, decisiones de arquitectura, debugging sutil. Recurre a estos deliberadamente, no por costumbre.
Aquí está el replanteamiento que más me ha ahorrado: probablemente no deberías estar ejecutando Fable 5 para la mayor parte de tu trabajo. La afirmación que circulaba por la comunidad en el lanzamiento — que Fable 5 en low effort iguala a Opus 4.8 en su ajuste más alto — no puedo verificarla limpiamente, y trataría cualquier equivalencia precisa tipo "Fable low equivale a Opus max" como marketing hasta que la hayas probado en tus propias tareas. Pero la forma del consejo es correcta de todos modos: Fable 5 es un bisturí, no un motor diario. En mi propio routing, hace quizá el 5–15% del trabajo — los pases profundos donde su techo importa de verdad — y Opus 4.8 o modelos más baratos llevan la carga rutinaria. Usar Fable 5 para todo no es dedicación a la calidad. Es cómo se prende fuego al dinero. Expuse las matemáticas del routing más amplias en mi guía de optimización de costes para agentes de IA, y se aplica al doble a estas tarifas.
La disciplina: elige el modelo más barato y el nivel de esfuerzo más bajo que hagan el trabajo. No el más alto que puedas permitirte. El más bajo que funcione.
Hábito 4: Hazle demostrar su trabajo antes de dar nada por "hecho"
Todo modelo canta victoria de vez en cuando sin haberla ganado — tests "que pasan" que nunca corrieron, un fix "aplicado" a un archivo que malinterpretó, un resumen citando con seguridad una fuente que dice lo contrario. En un modelo barato eso es una molestia. En Fable 5 es una molestia por la que pagaste premium, y peor aún, es el tipo de error que te cuesta una segunda ida y vuelta cara para pillarlo y corregirlo.
Así que meto la verificación dentro de la propia instrucción:
"Antes de decirme que esto está hecho, verifícalo. Corre los tests y enséñame la salida. Si no puedes verificar una afirmación, dilo claro en vez de adivinar — prefiero oír 'no pude confirmar la ruta de caché' que una respuesta segura que resulta estar mal."
Dos cosas hacen que esto funcione. Primero, exigir evidencia — salida real del comando, la línea específica que cambiaste, la cita textual de la fuente — no un resumen de la evidencia. "Los tests pasan" es una afirmación. La salida pegada del runner de tests es prueba. Fuerza la prueba.
Segundo, y esta es la parte que combina bellamente con la calibración de honestidad de Fable 5: dale explícitamente permiso al modelo para decir "no pude verificar esto". Los modelos Claude más nuevos son notablemente mejores marcando el borde de su propio conocimiento cuando los invitas a ello, y un "no estoy seguro de esta parte" honesto te ahorra el descubrimiento mucho más caro de que inventó algo y tú lo enviaste. Un modelo que admite duda es más barato que uno que fabrica con confianza, siempre.
Esto no es específico de Fable — los bucles de verificación mejoran cada modelo, y diría que son el hábito de mayor confianza en toda esta lista. Pero es más valioso en Fable 5 precisamente porque el coste de un error no verificado es más alto aquí. Cuando los errores son caros, el hábito que los pilla pronto es el que más vale.
Si prefieres que alguien te construya estos bucles de verificación directamente dentro de los agentes y skills de tu equipo — de modo que el paso "demuéstralo" quede horneado en el sistema en vez de reescrito en cada prompt — ese es exactamente el tipo de trabajo de setup que asumo. Puedes ver lo que he construido en fiverr.com/s/EgxYmWD.
Hábito 5: Deja de pedirle a Fable 5 que muestre su razonamiento
Aquí está el bucle que abrí al principio — el único hábito genuinamente específico de este modelo, y el que veo que más gente hace mal.
Deja de meter "explica tu razonamiento paso a paso" y "guíame por tu pensamiento" y "muéstrame tu cadena de razonamiento" en tus prompts de Fable 5. No porque el consejo sea malo en general — ha sido buena artesanía de prompts durante años. Sino porque en Fable 5, tras su vuelta, las peticiones de exposición del razonamiento pueden disparar el clasificador de seguridad.
Un poco de contexto sobre por qué. Fable 5 volvió a estar online a principios de julio bajo una capa de seguridad sustancialmente endurecida, después de toda la saga de control de exportaciones que desgrané en mi análisis del regreso de Fable 5. El nuevo clasificador se construyó para cortar una clase específica de jailbreak — y la cobertura de la vuelta señala que bloquea la técnica objetivo en más del 99% de los casos, a costa de una mayor tasa de falsos positivos en peticiones ordinarias (TechTimes cubrió el comportamiento del nuevo clasificador). Los intentos de extraer el funcionamiento interno del modelo quedan incómodamente cerca de los patrones de jailbreak para los que el clasificador está afinado.
Cuando una petición dispara ese clasificador, Fable 5 no se limita a rechazarla. Redirige la petición a Opus 4.8. Según la cobertura, generalmente se te notifica cuando pasa, y por la API el modelo que responde es visible si lo miras — pero dentro de una ejecución larga de un agente, o una sesión de escritorio charlatana, es genuinamente fácil de perderse. Crees que estás obteniendo el techo de Fable 5. Estás recibiendo en silencio un modelo distinto.
La economía de esa redirección es una cosa de doble filo que vale la pena entender. Cuando te desvían a Opus 4.8, pagas la tarifa más baja de Opus — así que una respuesta degradada de hecho te cuesta menos. Eso suena a victoria hasta que recuerdas por qué recurriste a Fable 5: querías su techo en un problema difícil. Que te entreguen silenciosamente un modelo menos capaz en la tarea exacta por la que pagabas premium para clavarla no es un descuento. Es una caída de calidad que no elegiste y podrías no notar.
Así que el arreglo es simple y gratis: quita las peticiones de exposición de razonamiento de tus system prompts y user prompts de Fable 5. Si de verdad necesitas ver el pensamiento del modelo, para eso está la salida de verificación (Hábito 4) — pide evidencia y resultados, no un proceso de pensamiento expuesto. Consigues la rendición de cuentas sin agitar una bandera roja al clasificador. Mantengo una versión de mi system prompt para Fable 5 con todo el lenguaje de "explica tu razonamiento" borrado, y otra distinta para otros modelos donde sigue estando bien. Cambio pequeño. Es la diferencia entre ejecutar el modelo por el que estás pagando y ejecutar un doble.
Hábito 6: Di menos, no más
El último hábito es el que ata a los otros cinco, y es el que combate cada instinto que la era Opus 4.7 nos entrenó.
Durante años, obtener buenos resultados significaba más — más reglas, más matices, más manejo explícito de casos límite, system prompts cada vez más largos apilando instrucción sobre instrucción para acorralar al modelo. Fable 5 rompe ese reflejo. Es lo bastante inteligente como para que un prompt breve y bien apuntado supere a un reglamento verboso — y el reglamento verboso te cuesta tokens de entrada en cada llamada e invita al modelo a razonar sobre toda esa instrucción a 50 el millón en la salida.
Compara un antes/después real de mi propio pipeline de contenido. La versión antigua era una lista de catorce líneas de reglas sobre tono, estructura, qué evitar, cómo formatear, cuándo preguntar. La versión nueva:
"Empieza por el resultado. Que sea simple y específico. Solo párate a preguntarme algo cuando el trabajo requiera de verdad una decisión que aún no he tomado."
Tres frases. Produce borradores más limpios que la versión de catorce líneas, porque Fable 5 no tenía problemas para obedecer las reglas — se distraía con ellas. Inteligencia más concisión vence a inteligencia más un muro de restricciones.
La trampa, y es importante para no contradecir al Hábito 1: menos no es lo mismo que vago. El Hábito 1 decía dale contexto. El Hábito 6 dice no ahogues ese contexto en reglas. No están en tensión — el contenido de mayor valor (el porqué, el objetivo, la valla) se queda; la ceremonia de bajo valor (instrucciones obvias, matices redundantes, sobreespecificación defensiva) se va. Estás recortando lastre, no señal.
Esto es también lo que hace que la integración estrecha con skills y archivos de contexto funcione de verdad. Cuando tu prompt está esbelto, el modelo tiene margen para apoyarse en tu system prompt, tus archivos de contexto y tus skills en vez de releer una instrucción inflada en cada turno. La concisión en el nivel del prompt es lo que permite al sistema hacer su trabajo — el mismo giro que tracé cuando la ingeniería de prompts cedió paso a la ingeniería de bucles. Di menos en el prompt para que la arquitectura a su alrededor pueda decir más.
Dónde chocan los seis hábitos con sus límites
He pasado todo este post entregándote hábitos, así que déjame ser honesto sobre las fricciones, porque una lista pulida de seis pasos que finge que no hay contrapartidas es solo publicidad.
La redirección es lo que hay que vigilar, y es fácil perderla de vista. El Hábito 5 desactiva el disparador de exposición de razonamiento, pero el clasificador está afinado con la suficiente tirantez como para que trabajo legítimo — seguridad defensiva sobre todo — pueda seguir desviándote a Opus 4.8 sin una señal ruidosa. Si estás pagando tarifas de Fable 5 específicamente por una tarea dura, comprueba realmente qué modelo respondió. Si no puedes saberlo desde tu superficie, esa es una razón para ejecutar el trabajo de Fable 5 de alto riesgo en un sitio donde el modelo que responde sea visible.
La mayoría de estos hábitos ayudan a cualquier modelo — y eso es el argumento, no una debilidad. Contexto, prompting negativo, verificación, concisión: nada de eso es exclusivo de Fable. Lo específico de Fable es lo caro que sale saltárselos aquí. El mismo prompt descuidado que malgasta céntimos en un modelo barato malgasta dinero real en Fable 5. Los hábitos no cambian. Lo que cambia es lo que está en juego.
La palanca más grande no es un hábito de prompting en absoluto. Es no usar Fable 5. Lo diré otra vez porque es el punto al que la gente se resiste: la cantidad correcta de Fable 5 en tu flujo de trabajo es pequeña. Enruta el 85–95% rutinario de tu trabajo a Opus 4.8 y modelos más baratos, y reserva Fable 5 para los pases donde su techo cambia genuinamente el resultado. El mejor hábito de prompting para Claude Fable 5, al final, es saber cuándo no hacer prompt a Fable 5.
Cómo cocino estos seis hábitos en el sistema, no en el prompt
Los hábitos que tienes que recordar son los que te saltarás a las 11 de la noche en un deadline. Así que dejé de depender de la memoria y bajé los seis a la capa por debajo del prompt.
Tres sitios donde ahora viven:
En el system prompt. Mi system prompt de Fable 5 tiene las invariantes cocidas: procede en cuanto tengas suficiente, verifica antes de declarar hecho, dilo si no puedes confirmar algo, y — el específico de Fable — cero lenguaje de exposición de razonamiento en ninguna parte. No los reescribo. Son el suelo desde el que empieza cada prompt.
En skills. Para trabajos repetibles — una pasada de revisión de código, un resumen de investigación, un borrador de contenido — el bucle de verificación y las vallas de prompting negativo viven dentro de la propia definición de la skill. La skill es el hábito, codificado una sola vez. Cuando la invoco, el contrato de "demuestra tu trabajo, no toques lo que no te nombré" viene incluido. Esta es la misma arquitectura de segundo cerebro más skills a la que he estado apuntando en mi sistema operativo de IA sobre Claude Code.
En defaults de esfuerzo por tipo de tarea. En vez de elegir el nivel de esfuerzo a ojo cada vez, mapeo tipos de tarea a niveles una vez y dejo que el routing siga. Las skills rutinarias tiran por defecto de low o medium; las skills de pasada profunda se reservan high y superiores. La decisión se mueve del momento al diseño.
El pago es que los errores caros — el razonamiento desbocado, la redirección silenciosa, la fabricación con confianza, el prompt de catorce líneas — dejan de ser cosas que tengo que pillar en tiempo real. El sistema los pilla, porque codifiqué la captura una vez. Ese es el destino real de los seis hábitos: no mejores prompts tecleados por un humano disciplinado, sino un setup donde la disciplina es estructural y el humano puede ser un poco descuidado sin pagarlo.
El coste real de un prompt de Fable 5
Vuelve al prompt de 41 palabras del principio. El desperdicio no fueron realmente las 41 palabras. Fue todo lo que pusieron en marcha: el razonamiento abierto a 50 el millón, la línea de "explica tu razonamiento" que puede haberme desviado a un modelo distinto, la iniciativa que no acoté, las reglas que apilé en vez del contexto que debería haber dado. Un prompt perezoso, cuatro fugas distintas.
Fable 5 es el modelo más capaz al que le he puesto las manos, y cobra en consecuencia. Esa combinación hace que el prompting deje de ser una soft skill y empiece a ser control de costes — la misma instrucción, redactada de dos maneras, puede diferir en un orden de magnitud en lo que quema y en si siquiera corre en el modelo que querías. Los seis hábitos no van de sacar del modelo una frase mejor. Van de no pagar tarifas premium por tu propia imprecisión.
Aquí tienes tu única cosa que hacer hoy: coge el único prompt o system prompt que le envías a Fable 5 con más frecuencia, y pásalo por los seis. Añade el porqué. Acota lo que no quieres. Dile que actúe y que verifique. Quita todo "explica tu razonamiento". Después córtalo por la mitad. Envía ambas versiones a la misma tarea y observa el contador de tokens. La diferencia que veas es el impuesto que has estado pagando — y ahora sabes cómo dejar de hacerlo.
Preguntas frecuentes
¿Por qué es Claude Fable 5 tan caro para hacerle prompts?
Claude Fable 5 cuesta 10 dólares por millón de tokens de entrada y 50 por millón de tokens de salida — aproximadamente el doble que Opus 4.8 — y su razonamiento interno factura como salida a esa tarifa de 50. Un prompt vago o inflado hace que el modelo razone más antes de responder, así que un prompting impreciso infla directamente el coste. Los prompts breves y ricos en contexto gastan menos de esos tokens de razonamiento caros.
¿Los niveles de esfuerzo cambian cuánto cuesta Claude Fable 5?
Los niveles de esfuerzo no cambian la tarifa por token — Fable 5 son 10/50 en cualquier nivel. Lo que cambian es cuántos tokens gasta el modelo pensando antes de responder. Un esfuerzo mayor (xhigh, max) puede usar muchos más tokens de los que sugiere la salida visible, así que ajustar el esfuerzo a la dificultad de la tarea es una palanca directa de coste. Mira el Hábito 3 arriba para el mapa completo.
¿Por qué Claude Fable 5 a veces cambia a Opus 4.8?
El clasificador de seguridad endurecido de Fable 5 redirige las peticiones marcadas — incluidos intentos de exposición de razonamiento y algún trabajo legítimo de seguridad defensiva — a Opus 4.8. La cobertura dice que generalmente se te notifica y la API muestra el modelo que responde, pero es fácil pasarlo por alto en una sesión larga. Pagas la tarifa más baja de Opus cuando te degradan, pero pierdes el techo de Fable 5 por el que estabas pagando.
¿Debería pedirle a Claude Fable 5 que explique su razonamiento?
No — en Fable 5 específicamente, las peticiones tipo "explica tu razonamiento" pueden disparar el clasificador de seguridad y hacer que te redirijan a Opus 4.8. Si necesitas rendición de cuentas, pide evidencia de verificación (salida de tests, el cambio exacto, citas de fuentes) en lugar de un proceso de pensamiento expuesto. Consigues la misma rendición de cuentas sin el riesgo de redirección. Mira el Hábito 5 arriba.
¿Qué porcentaje de mi trabajo debería correr realmente en Claude Fable 5?
En mi propio routing, aproximadamente el 5–15% — los pases profundos donde su techo cambia genuinamente el resultado. Enruta el 85–95% rutinario a Opus 4.8 y modelos más baratos. Usar Fable 5 como motor diario, dadas sus tarifas, es la forma más rápida de vaciar el saldo por una calidad que no necesitabas en la mayoría de las tareas.
¿Quieres la disciplina de prompting integrada?
Estos seis hábitos solo compensan si los ejecutas de verdad, y a las 11 de la noche con un deadline nadie lo hace. Si prefieres tener los bucles de verificación, las vallas y la higiene de prompt segura para Fable 5 conectada dentro de los system prompts y skills de tu equipo en vez de reescritos en cada sesión, ese es el tipo de trabajo de setup que asumo — ve lo que construyo aquí.