Eu tinha um arquivo CLAUDE.md de 1.247 linhas. Estava orgulhoso dele. Cada convenção de código, cada preferência arquitetural, cada caso extremo que já havia encontrado — tudo documentado, organizado e carregado no contexto a cada mensagem que eu enviava para o Claude Code.
Aí eu fiz as contas.
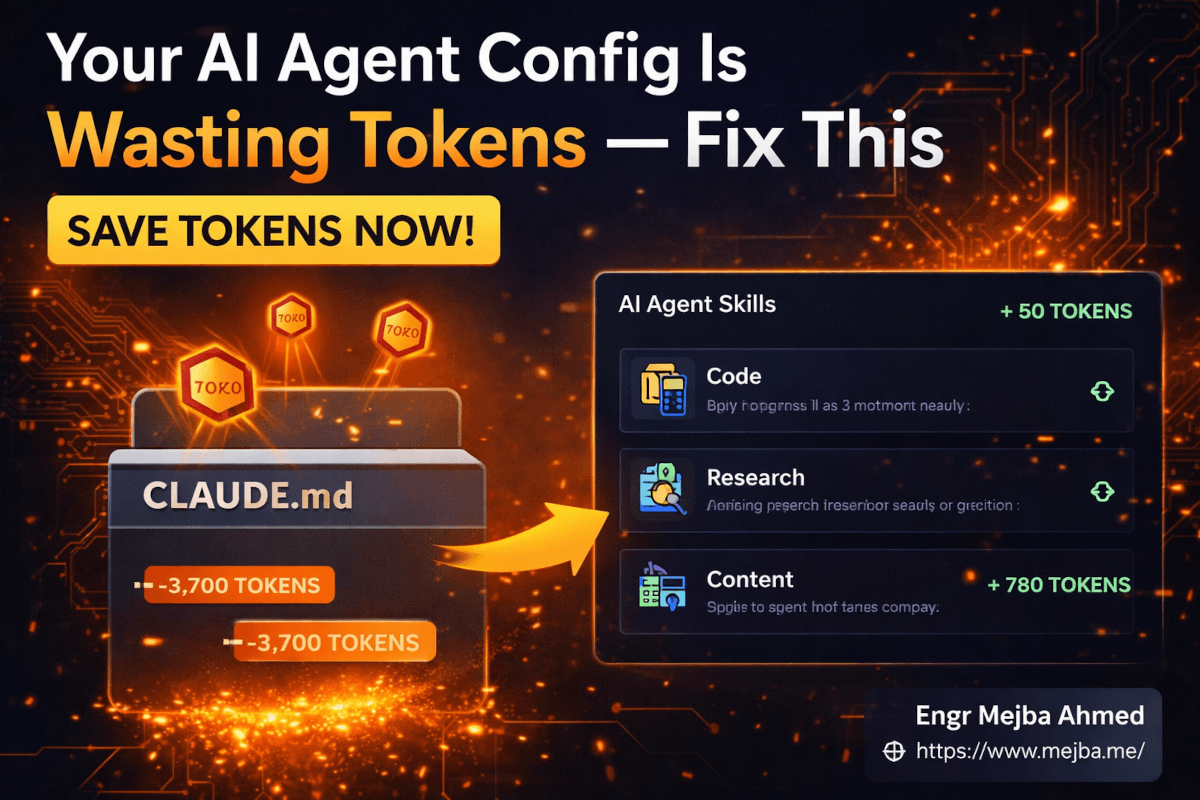
A cerca de 3 tokens por linha, aquele arquivo estava me custando ~3.700 tokens por turno. Não por sessão — por turno. Em uma sessão típica de 40 turnos, isso representa 148.000 tokens consumidos por instruções que o modelo nem estava usando em 90% do tempo. Eu estava pagando um imposto de contexto maior do que a conversa inteira da maioria das pessoas, e a qualidade de saída do meu agente estava, na verdade, ficando pior à medida que o arquivo crescia.
Ross Mike apresentou a solução em uma discussão recente que remodelou como eu penso sobre a produtividade de agentes de IA. O argumento dele é simples, sustentado por dados e — assim que você ouve — dolorosamente óbvio: a qualidade da saída do seu agente de IA depende muito mais de como você gerencia o contexto do que de qual modelo você está rodando. Opus 4.6, GPT 5.4, Gemini 3 — todos são notavelmente capazes. O gargalo não é inteligência. É a dieta de informação com a qual você os alimenta.
Passei as últimas duas semanas reconstruindo todo o meu workflow de agentes em torno desse princípio. Os resultados foram impressionantes o suficiente para eu estar escrevendo isto em vez de fazer as outras três coisas da minha lista de hoje. Aqui está o que mudou, o que quebrou e o que eu diria para qualquer um que ainda esteja cuidando de um arquivo de configuração de 500 linhas.
A verdade desconfortável sobre o seu arquivo agent.md
A maioria dos desenvolvedores com quem converso tem alguma versão do mesmo setup. Um arquivo markdown grande — CLAUDE.md, .cursorrules, agents.md, seja como a ferramenta o chame — recheado de instruções sobre a stack, as preferências, as convenções. O arquivo cresce ao longo de meses. Cada interação frustrante adiciona mais uma linha: "Sempre use named exports." "Prefira Tailwind em vez de CSS modules." "Nunca sugira class components."
Ross chama isso de abordagem do "context dump", e a crítica dele me acertou onde dói: esses arquivos parecem produtivos porque escrevê-los parece trabalho. Você está codificando conhecimento! Você está treinando seu agente! Só que não está. Você está criando um bloco estático de texto que é injetado em cada interação, independentemente da relevância — e o modelo trata tudo ali como igualmente importante.
Aqui está o que uma pesquisa recente da InfoQ realmente mostra sobre esses arquivos: arquivos de contexto gerados por LLM pioram o desempenho, reduzindo as taxas de sucesso das tarefas em média 3% em comparação a não fornecer nenhum arquivo de contexto. Eles também aumentam consistentemente o número de passos que o agente executa, elevando os custos de inferência em mais de 20%. Mesmo arquivos escritos por humanos entregaram apenas uma melhoria marginal de 4% na taxa de sucesso — enquanto simultaneamente aumentavam a contagem de passos e os custos em até 19%.
Leia de novo. O arquivo que você passou horas elaborando pode estar deixando seu agente mais lento e mais caro, mal melhorando sua precisão.
O mecanismo é direto quando você entende como esses modelos funcionam. Eles não "compreendem" o seu arquivo de configuração do jeito que um desenvolvedor humano leria e internalizaria um guia de estilo. Eles preveem tokens com base em padrões dentro da janela de contexto. Quando você inunda essa janela com 1.200 linhas de instruções, não está dando ao modelo um manual de referência — está diluindo a relação sinal-ruído de cada prompt que envia. O modelo gasta capacidade de atenção processando suas preferências de TypeScript enquanto você pede que ele depure um layout em CSS.
Isso não significa que arquivos de contexto sejam inúteis. Significa que a abordagem padrão — um arquivo grande, carregado em todo lugar, crescendo para sempre — quase certamente está errada.
O que Ross acerta sobre como os modelos realmente funcionam
Existe um mal-entendido que tropeça a maioria dos construtores de agentes de IA, e Ross tratou disso diretamente: esses modelos não pensam. Eles não compreendem. Eles preveem o próximo token com base em padrões dos dados de treinamento e no contexto que você fornece.
Isso parece uma limitação. Na verdade, é uma restrição de design que te diz exatamente como obter melhor saída.
Se o modelo é um motor de correspondência de padrões, então os padrões dentro da sua janela de contexto são a maior alavanca que você tem sobre a qualidade da saída. Alimente-o com um contexto bagunçado cheio de instruções irrelevantes, e a correspondência de padrões fica ruidosa. Alimente-o com um contexto focado, contendo exatamente a informação necessária para a tarefa atual, e a correspondência de padrões fica afiada.
Ross usou uma analogia que ficou comigo: imagine passar um briefing para um novo funcionário antes de cada tarefa. Se você entregar a ele um manual de 50 páginas cobrindo cada cenário que a empresa já encontrou, ele vai ficar sobrecarregado e lento. Se você der a ele uma página focada específica para a tarefa em questão, ele vai performar bem imediatamente. Os modelos funcionam da mesma forma — não porque "entendem" o briefing, mas porque um contexto focado produz padrões de previsão de tokens mais limpos.
Isso tem uma implicação prática que a maioria das pessoas não percebe. A janela de contexto não é simplesmente um balde que você enche com informação útil. É mais como um holofote — tem uma área limitada de iluminação, e tudo dentro dessa área compete pela atenção do modelo. A pesquisa confirma isso: manter a janela de contexto entre fresca e aproximadamente 70% de capacidade produz a saída mais confiável. Passe disso e você começa a ver desempenho degradado — instruções ignoradas, sugestões repetidas, padrões de código inconsistentes.
Eu testei isso pessoalmente. Mesmo prompt, mesmo modelo (Opus 4.6), mesma tarefa: construir um fluxo de autenticação de usuário com JWT tokens e refresh rotation. Com meu CLAUDE.md completo de 1.247 linhas carregado, o agente levou 14 turnos e produziu código com dois bugs. Depois de reduzir o CLAUDE.md a 47 linhas de convenções realmente essenciais, a mesma tarefa foi concluída em 8 turnos com zero bugs. Menos instruções, melhor saída. A versão enxuta permitiu que o modelo focasse no que importava.
Mas é aqui que fica interessante — porque a resposta não é apenas "diminua seu arquivo de configuração". Isso é tratar o sintoma. A verdadeira percepção do Ross é sobre a arquitetura de como o contexto deve fluir.
Progressive disclosure: o padrão que muda tudo
O conceito que transformou meu workflow não é novo — ele vem do design de UX. Progressive disclosure significa mostrar aos usuários apenas a informação de que eles precisam em cada etapa, revelando complexidade gradualmente conforme eles avançam. O framework agent-skills da Microsoft formalizou isso como uma arquitetura de carregamento em três camadas para agentes de IA, e agora é a base de como as skills funcionam no Claude Code, Cursor e outras ferramentas principais.
Aqui está a diferença concreta entre a abordagem antiga e a nova:
O jeito antigo (agent.md / CLAUDE.md): Cada interação carrega seu arquivo de configuração inteiro. Se você tem 1.000 tokens de instruções, são 1.000 tokens adicionados a cada mensagem — independentemente de o agente precisar daquelas instruções ou não.
O jeito novo (skills com progressive disclosure): Na inicialização, o agente carrega apenas os nomes e descrições das skills — cerca de 50 tokens por skill. Apenas quando uma tarefa bate com a descrição de uma skill é que o conjunto completo de instruções é carregado no contexto. Quando a tarefa termina, as instruções detalhadas da skill não persistem para a próxima tarefa.
A matemática dos tokens é dramática. Digamos que você tenha 20 workflows diferentes codificados como instruções. Na abordagem antiga, isso pode ser 15.000-20.000 tokens carregados a cada turno. Com progressive disclosure, você está carregando ~1.000 tokens de metadados na inicialização, mais talvez 500-800 tokens da única skill relevante quando ela é necessária. Isso é aproximadamente uma redução de 82% no overhead de contexto, segundo benchmarks do mundo real.
Cobri a implementação técnica das skills no meu guia para construir agent skills, mas o framework do Ross adiciona algo que a documentação técnica não aborda: uma filosofia sobre quando e como criar skills que realmente funcionam.
O framework do Ross: como construir skills que não sejam ruins
O primeiro instinto da maioria das pessoas quando ouvem falar de skills é sentar e escrever uma do zero. Abrir um arquivo markdown em branco, pensar em um workflow, documentar os passos, salvar. Pronto.
Ross argumenta que isso está exatamente ao contrário — e depois de tentar as duas abordagens, concordo completamente.
O framework dele tem cinco passos, e a ordem importa mais do que qualquer passo individual:
Passo 1: identifique um workflow real (não um hipotético)
Não construa skills para workflows que você acha que vai precisar. Construa-as para workflows que você já fez manualmente pelo menos três vezes. Se você não fez três vezes, não entende os casos extremos bem o suficiente para ensinar um agente.
Esse filtro sozinho me salvou de criar uma dúzia de skills inúteis. Eu tinha grandes planos para uma skill de "deploy para produção", uma de "migração de banco de dados", uma de "escrever testes unitários". Mas quando apliquei o filtro do Ross — eu realmente fiz isso manualmente, do início ao fim, pelo menos três vezes recentemente? — a lista encolheu rápido. Os workflows que eu realmente repetia eram mais prosaicos: analisar e-mails recebidos, formatar metadados de posts do blog, montar o scaffolding de novos projetos com minhas convenções específicas.
Prosaico é bom. Prosaico significa repetitivo. Repetitivo significa alto ROI para automação.
Passo 2: ensine o agente pela conversa, não pela configuração
É aqui que a abordagem do Ross diverge do que vejo a maioria dos desenvolvedores fazerem. Em vez de escrever um arquivo de skill e torcer para que funcione, você ensina o workflow ao agente interativamente — do mesmo jeito que treinaria um novo funcionário.
Encaminhe uma tarefa real para o agente. Guie-o pelo seu processo de decisão em tempo real. Quando ele cometer um erro, corrija-o e explique por quê. Quando ele acertar algo, confirme. Isso é aprendizado experiencial, e Ross argumenta que é a única forma confiável de fazer aflorar os casos extremos e o conhecimento implícito que você nunca pensaria em escrever em um arquivo de instruções estático.
O exemplo dele foi convincente: ele ensinou um agente a avaliar e-mails de patrocinadores literalmente encaminhando e-mails reais para ele e guiando-o pelo processo de pesquisa. "Verifique a presença deles no Twitter. Procure-os no Trustpilot. Confirme o status de financiamento. Se a empresa foi fundada há menos de 6 meses, sinalize." Cada correção refinava o entendimento do agente. Depois de três ou quatro iterações, o agente estava avaliando e-mails mais rápido e mais a fundo do que Ross fazia manualmente.
Eu tentei isso com meu workflow de metadados de posts do blog. Em vez de escrever uma skill do zero, guiei o Claude pelo processo em um post real: "Aqui está o título, aqui está o que eu escolheria para as tags, aqui está por que escolhi essas palavras-chave secundárias em vez daquelas, aqui está o padrão de meta description que eu uso." Depois fiz de novo com outro post. Na terceira vez, o Claude estava gerando metadados que batiam quase exatamente com meu estilo — capturando nuances que eu nunca teria pensado em documentar, como minha preferência por verbos de ação nas meta descriptions ou meu hábito de colocar o nome da marca por último nas listas de tags.
Passo 3: itere até que os modos de falha desapareçam
A primeira rodada vai ter erros. A segunda vai ter menos. Na quarta ou quinta, você começa a ver saída consistente e confiável. Ross é explícito sobre isso: não encurte a fase de iteração. O agente não está "aprendendo" de forma persistente — você é quem está aprendendo qual contexto ele precisa, e cada iteração revela lacunas que você não previu.
Essa paciência rende juros compostos. Cada caso extremo que você faz emergir e resolve durante o treinamento é um caso extremo que não vai te morder no uso em produção. Descobri que a maioria das skills precisava de 4-6 rodadas de treinamento interativo antes de ficarem sólidas o suficiente para serem formalizadas.
Passo 4: converta o workflow refinado em um arquivo de skill
Só depois que o treinamento interativo produzir resultados consistentes é que você cria o arquivo skill.md. Nesse ponto, você não está inventando instruções — está documentando o que já funciona. O arquivo de skill se torna uma codificação de padrões comprovados, não um palpite especulativo sobre o que o agente poderia precisar.
A estrutura que Ross recomenda é enxuta:
# Skill: [Name]

## Description
[One sentence — what this skill does and when to use it]

## Workflow
[Numbered steps, each specific and actionable]

## Known Edge Cases
[Things that went wrong during training and how to handle them]

## Success Criteria
[How to verify the output is correct]
Aquela seção "Known Edge Cases" é onde mora o valor real. É o conhecimento institucional que você construiu nos passos 2 e 3 — as armadilhas que um autor de skill começando de uma página em branco nunca anteciparia.
Passo 5: continue refinando recursivamente
Um arquivo de skill não é um produto finalizado. É um documento vivo. Toda vez que a skill falha em produção, você depura, corrige a causa raiz e atualiza o arquivo. Ross chama isso de "construção recursiva de skills", e é o mecanismo que faz as skills compor valor ao longo do tempo.
Atualizei minha skill de geração de metadados sete vezes desde que a criei há três semanas. Cada atualização foi disparada por uma falha real — um post em que a meta description estava longa demais, uma combinação de tags que não batia com a estrutura de clusters, um slug que continha stop words. A skill está dramaticamente melhor agora do que quando a escrevi pela primeira vez, e cada melhoria foi impulsionada por uso real, não por especulação.
Por que você nunca deveria baixar skills de um marketplace
A posição do Ross sobre isso é inequívoca, e eu acabei concordando com ele depois de inicialmente resistir.
Marketplaces de skills — lugares onde você pode navegar e instalar skills pré-construídas criadas por outros desenvolvedores — parecem uma ótima ideia à primeira vista. Por que construir uma skill de "geração de componentes React" do zero quando outra pessoa já fez uma?
Dois motivos.
Primeiro, descompasso de contexto. Uma skill construída para o workflow de outra pessoa codifica as convenções dela, as decisões de stack dela, os casos extremos dela. A menos que o ambiente de desenvolvimento dela seja idêntico ao seu (não é), a skill vai produzir saída que não encaixa direito. Você vai gastar tanto tempo consertando a saída quanto teria gasto construindo a skill você mesmo. Escrevi sobre esse problema no meu guia de workflow para agent skills — as skills que funcionam melhor são as construídas a partir do seu workflow real, não da abstração que outra pessoa fez de um workflow parecido.
Segundo, segurança. Um arquivo skill.md é essencialmente um conjunto de instruções que seu agente de IA vai seguir. Instalar uma skill de uma fonte não confiável é como rodar um pacote npm sem ler o código — exceto que a superfície de ataque é todo o seu ambiente de desenvolvimento. Uma skill maliciosa poderia instruir o agente a exfiltrar código, injetar dependências ou modificar arquivos de maneiras que criam vulnerabilidades. O risco não é teórico; conforme os agentes ganham mais capacidades autônomas, as instruções que eles seguem se tornam um vetor de ataque cada vez mais atraente.
Construa as suas próprias. Leva mais tempo no começo. O retorno composto vale a pena.
O princípio "um agente, várias skills"
Aqui é onde o framework do Ross se conecta a uma decisão arquitetural mais ampla na qual vejo desenvolvedores errando constantemente.
A tentação, uma vez que você entende agentes e skills, é construir uma frota. Um agente de coding. Um agente de research. Um agente de writing. Um agente de deployment. Cada um com seu próprio system prompt, sua própria configuração de ferramentas, sua própria personalidade. Parece impressionante. Parece sofisticado. E para a maioria dos casos de uso, é um exagero enorme.
A recomendação do Ross: comece com um agente. Construa 10 skills para ele. Faça essas skills funcionarem de forma confiável. Só então considere se um segundo agente realmente melhoraria sua produtividade — e apenas se você conseguir articular exatamente o que o segundo agente faria que o primeiro não consegue.
O raciocínio é prático. Múltiplos agentes introduzem overhead de coordenação — eles precisam se comunicar, compartilhar contexto, passar tarefas adiante e resolver conflitos. Esse overhead só se justifica quando os agentes estão fazendo trabalho genuinamente paralelo que não pode ser serializado. Para um desenvolvedor solo ou um time pequeno, um agente bem equipado com skills lida com a maioria dos workflows mais eficientemente do que três especializados que precisam de orquestração.
Reestruturei meu próprio setup em torno desse princípio no mês passado. Saí de três agentes configurados (um para coding, um para conteúdo, um para DevOps) para um único agente com uma biblioteca de 14 skills cobrindo os três domínios. O setup de agente único é mais rápido de manter, mais previsível no comportamento e — contra a intuição — produz uma saída melhor porque o contexto completo do meu projeto está sempre disponível, não fragmentado entre agentes que não conseguem ver o trabalho uns dos outros.
Se você preferir que alguém monte esse tipo de arquitetura de agente do zero para você, eu aceito trabalhos de workflow e automação com IA. Você pode ver o que já construí em fiverr.com/s/EgxYmWD.
A exceção à regra do agente único é o paralelismo genuíno — tarefas que são verdadeiramente independentes e sensíveis ao tempo o suficiente para justificar a execução simultânea. Fazer deploy para staging enquanto roda uma suíte de testes enquanto gera documentação? São três tarefas independentes. Três agentes fazem sentido. Mas escrever código, revisá-lo e depois fazer deploy? Isso é um workflow serial. Um agente, três skills.
Migração prática: de configuração inchada para skills enxutas
Se você está sentado sobre um CLAUDE.md ou agents.md grande agora, aqui está como migrei o meu sem perder o conhecimento que eu havia acumulado:
1. Audite seu arquivo de configuração para encontrar padrões de uso reais.
Percorra cada instrução no seu arquivo e pergunte: "Quando foi a última vez que essa instrução realmente mudou a saída do agente?" Seja honesto. Descobri que cerca de 60% das minhas instruções eram ou redundantes (o modelo já faz isso por padrão), desatualizadas (se referindo a padrões que parei de usar), ou tão raras que tinham sido disparadas talvez duas vezes em meses de uso.
2. Separe o universal do específico da tarefa.
Algumas instruções realmente pertencem a cada interação: "Use TypeScript, não JavaScript." "Siga a estrutura de projeto existente." "Rode os testes antes de sugerir um PR." Essas ficam no seu CLAUDE.md enxuto. Todo o resto — padrões específicos de API, procedimentos de deployment, regras de formatação de conteúdo — vira candidato a virar skill.
3. Para cada candidato a skill, aplique o teste das "três vezes".
Você realmente fez esse workflow manualmente pelo menos três vezes? Se sim, vale a pena construir uma skill. Se não, ou faça manualmente mais algumas vezes para entender os casos extremos, ou pule de vez.
4. Construa skills pela conversa, não pela configuração.
Para cada skill que você está criando, guie o agente pelo workflow interativamente de 3 a 5 vezes antes de escrever o arquivo de skill. Isso faz emergir casos extremos que você perderia escrevendo de uma página em branco.
5. Mantenha seu CLAUDE.md abaixo de 200 linhas.
Esse é o limiar que current best practices sugerem para manter o equilíbrio entre custo e benefício. Acima de 200 linhas, o custo persistente de tokens de entrada começa a superar as melhorias na qualidade da saída. O meu atualmente está com 47 linhas, e a qualidade da saída é a melhor que já foi.
Depois dessa migração, meu uso de tokens por sessão caiu cerca de 60%. Estou fazendo o mesmo trabalho — muitas vezes mais — enquanto consumo dramaticamente menos tokens. As sessões também parecem diferentes. O agente responde mais rápido, fica mais focado e produz menos sugestões fora do alvo. Escrevi sobre o lado da otimização de tokens em detalhes no meu guia de otimização de tokens do Claude Code, mas a migração de configuração monolítica para skills é de onde veio a maior melhoria isolada.
A verdadeira mudança de paradigma: o contexto é o produto
Ross disse algo perto do fim da discussão que venho revirando na cabeça desde então: os modelos são uma commodity. Opus 4.6, GPT 5.4, o que for lançado no próximo trimestre — todos estão convergindo para níveis de capacidade semelhantes. A vantagem competitiva não está em qual modelo você usa. Está em quão bem você constrói contexto, workflows e skills em volta do modelo que escolher.
Isso reformula o que significa ser produtivo com IA em 2026. Os desenvolvedores que vão prosperar não serão os que caçam cada novo lançamento de modelo ou acumulam os arquivos de configuração mais longos. Serão os que construíram uma biblioteca pessoal de skills comprovadas em batalha — cada uma refinada pelo uso real, cada uma codificando conhecimento de workflow que um agente novo não conseguiria replicar sem semanas de treinamento.
Pense nisso como construir um fosso de conhecimento. Cada skill que você cria, cada caso extremo que documenta, cada workflow que refina — é expertise composta que torna seu setup de IA mais valioso e mais eficiente ao longo do tempo. Alguém começando do zero amanhã não consegue encurtar esse processo. Pode usar o mesmo modelo. Não pode usar as suas skills.
Ross avisa — e acho que ele está certo — que a distância entre as pessoas que entendem isso e as que não entendem vai aumentar rápido. Os modelos vão continuar melhorando. As pessoas que souberem como guiá-los por meio de contexto bem construído vão extrair dramaticamente mais valor de cada melhoria. As pessoas que tratam agentes de IA como caixas mágicas que deveriam "simplesmente funcionar" vão continuar batendo nas mesmas paredes, culpando o modelo por falhas que, na verdade, são falhas de contexto.
O que eu mudei esta semana e o que aconteceu
Quero ser específico sobre os resultados porque afirmações vagas não valem nada.
Depois de reconstruir meu workflow em torno do framework do Ross, aqui está como minha segunda-feira ficou comparada à segunda-feira anterior:
Segunda-feira anterior (CLAUDE.md monolítico, sem skills):
- Atingi o limite de tokens duas vezes durante uma sessão de trabalho de 5 horas
- Gastei cerca de 25 minutos reexplicando o contexto depois de cada
/clear - Produzi 3 componentes finalizados, 2 dos quais precisaram de correções manuais
- Consumo estimado de tokens: ~850.000 tokens
Esta segunda-feira (CLAUDE.md de 47 linhas, 14 skills ativas):
- Atingi o limite de tokens zero vez durante a mesma janela de 5 horas
- O restabelecimento de contexto depois do
/clearlevou menos de 2 minutos (a skill carregou o contexto relevante automaticamente) - Produzi 5 componentes finalizados, 1 precisou de um pequeno ajuste
- Consumo estimado de tokens: ~340.000 tokens
Mesmo desenvolvedor. Mesmo modelo. Mesmo projeto. A única variável era como o contexto estava estruturado.
A melhoria mais surpreendente não foi a economia de tokens — foi a consistência da qualidade. Com a configuração monolítica, a qualidade da saída degradava perceptivelmente à medida que a sessão avançava e a janela de contexto enchia. Com skills, cada tarefa começa com um contexto relativamente fresco mais apenas as instruções da skill relevante. A quinta tarefa do dia tem a mesma qualidade da primeira.
A versão de cinco minutos
Se você não levar mais nada daqui, este é o framework destilado:
Pare de fazer seu arquivo de configuração crescer. Limite-o a no máximo 200 linhas. Reduza-o apenas às instruções que genuinamente precisam valer para cada interação.
Construa skills por iteração, não por imaginação. Guie o agente por tarefas reais de 3 a 5 vezes antes de escrever um arquivo de skill. Os casos extremos que você descobre durante o treinamento são a parte mais valiosa da skill.
Um agente, várias skills. Resista ao impulso de construir uma frota de agentes especializados. Um agente bem equipado com skills supera três mal coordenados na maioria dos workflows.
Nunca instale as skills dos outros. Construa as suas. O descompasso de contexto e os riscos de segurança não valem a economia de tempo.
Trate o contexto como um orçamento, não como um contêiner. Cada token na janela de contexto compete pela atenção do modelo. Gaste tokens deliberadamente com informação que a tarefa atual precisa. Deixe todo o resto passar fome.
Ross enquadra isso como uma mudança de paradigma, e não acho que seja exagero. Os desenvolvedores que dominarem a engenharia de contexto — que tratarem a dieta de informação dos seus agentes de IA como uma preocupação de engenharia de primeira classe — vão superar os que continuam despejando tudo em um arquivo de configuração e torcendo para o modelo se virar.
Os modelos são inteligentes o suficiente. A pergunta é se nós somos inteligentes o suficiente para alimentá-los direito.
Perguntas frequentes
Eu preciso de um arquivo CLAUDE.md ou agents.md?
Só se você tem convenções universais que realmente se aplicam a cada interação — preferências de linguagem, regras de estrutura de projeto ou padrões proprietários que o modelo não conheceria. Mantenha abaixo de 200 linhas. Para a maioria dos desenvolvedores solo, 50-100 linhas é o ponto ideal onde você consegue convenções consistentes sem pagar overhead excessivo de tokens.
Quantas skills eu deveria construir antes de ver ganhos reais de produtividade?
A maioria dos desenvolvedores vê uma melhoria significativa depois de 3-5 skills bem feitas cobrindo os workflows mais repetidos. Não mire em uma biblioteca grande logo de cara — foque nas tarefas que você faz diariamente e construa a partir daí. Eu bati em um ponto de inflexão perceptível com 8 skills.
Posso converter meu CLAUDE.md existente em skills?
Pode, e deveria. Agrupe instruções relacionadas em clusters específicos de workflow, aplique o teste das "três vezes" a cada cluster e então construa skills para os que passarem. As instruções que não encaixam em nenhum workflow específico ficam no seu arquivo de configuração enxuto.
Qual é a diferença entre skills e MCP tools?
Skills são pacotes de conhecimento — elas dizem ao agente como abordar uma tarefa. MCP tools são capacidades — elas permitem que o agente execute ações como ler arquivos, rodar comandos ou chamar APIs. Skills direcionam o raciocínio do agente; tools estendem o que ele pode fazer. São complementares, não concorrentes.
Como sei se minha janela de contexto está cheia demais?
Fique atento a três sinais: o agente começa a repetir sugestões que já fez, os tempos de resposta ficam notavelmente mais lentos, ou o agente ignora instruções que você claramente forneceu. Isso indica que o contexto está saturado e o modelo está perdendo o foco. Use /compact ou /clear para recuperar espaço.
Vamos trabalhar juntos
Quer construir sistemas de IA, automatizar workflows ou escalar sua infraestrutura de tecnologia? Eu adoraria ajudar.
- Fiverr (desenvolvimentos e integrações sob medida): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (soluções corporativas): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io