Der teuerste Prompt, den ich letzte Woche verschickt habe, war 41 Wörter lang, und nur die ersten neun davon haben tatsächlich Arbeit geleistet — meine erste echte Lektion im Claude Fable 5 Prompting, seit das Modell zurück ist.
Ich baute gerade einen neuen Capture-Flow in mein zweites Gehirn ein — das Obsidian-plus-Claude-Code-Setup, über das ich mein ganzes Leben laufen lasse — und feuerte eine dieser aufgeblähten Gürtel-und-Hosenträger-Anweisungen ab, die ich mir während der Opus-4.7-Ära angewöhnt hatte. „Mach das, aber nicht das, und denk auch daran, dies zu berücksichtigen, und erkläre deine Überlegungen bei jedem Schritt, damit ich mitgehen kann, und sei gründlich." Du kennst die Form. Die Anweisung, bei der du jede Möglichkeit, wie das Modell danebenliegen könnte, dadurch abfängst, dass du Regeln auf Regeln stapelst.
Bei Opus war dieser Prompt lediglich ineffizient. Bei Claude Fable 5 war er ein kleines Feuer. Denn Fable 5 kostet 10 $ pro Million Input-Tokens und 50 $ pro Million Output — und die Zeile „erkläre deine Überlegungen bei jedem Schritt" hat nicht nur die Antwort aufgebläht, sie könnte die Anfrage stillschweigend an ein völlig anderes Modell weitergereicht haben. Warum, dazu komme ich noch. Die Kurzfassung ist: Gutes Claude Fable 5 Prompting ist bei diesem Modell keine Stilfrage. Es ist der Unterschied zwischen einem Werkzeug, das seinen Preis wert ist, und einem, das dein Konto leerzieht, während du wegschaust.
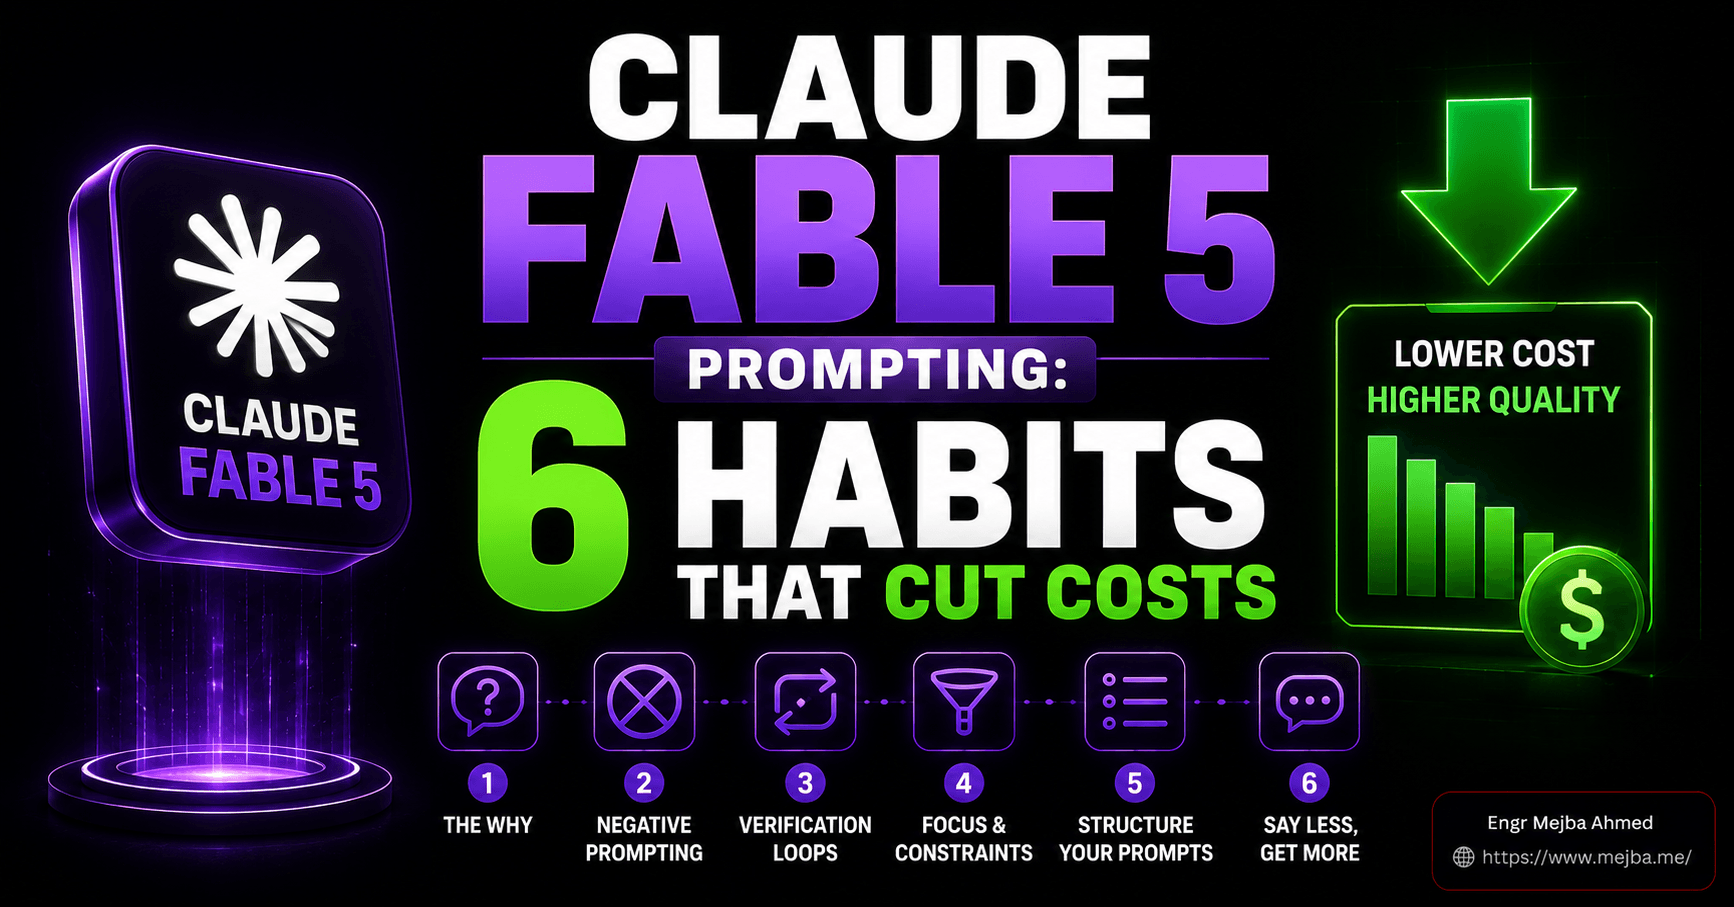
Ich habe die Tage seit Fable 5s Rückkehr damit verbracht, meine Art, mit ihm zu sprechen, neu aufzubauen — über mein KI-Betriebssystem auf Basis von Claude Code, meine täglichen Kunden-Repos und das zweite Gehirn, das ich in Obsidian betreibe. Sechs Habits haben die Hauptarbeit geleistet. Jeder einzelne macht den Output besser und die Rechnung kleiner zugleich, was seltener ist, als es klingt. Das hier ist diese Liste.
Wenn du das Begleitstück willst — worauf du Fable 5 während des kostenlosen Fensters tatsächlich ansetzen solltest, das Anthropic nach dem ursprünglichen Cutoff am 7. Juli bis zum 12. Juli verlängert hat — dann habe ich acht Workflows mit hoher Hebelwirkung für das Free-Window separat kartiert. Dieser Post ist die To-do-Liste. Der hier ist das Wie-sagt-man's. Lies beide zusammen und du hast beide Hälften.
Warum Fable 5 einen schlampigen Prompt härter bestraft als jedes Modell, das ich je genutzt habe
Bevor es an die Habits geht, lass mich echte Zahlen auf den Tisch legen, denn die Habits ergeben erst dann Sinn, wenn du die Kostenmechanik im Bauch spürst.
Fable 5 ist das leistungsfähigste Modell, das Anthropic derzeit ausliefert, und es ist entsprechend bepreist: 10 $ pro Million Input-Tokens, 50 $ pro Million Output-Tokens (Anthropics Pricing-Docs bestätigen die Rate). Das ist ungefähr das Doppelte der 5-in / 25-out bei Opus 4.8. Bis hierhin: „Premium-Modell ist eben Premium."
Jetzt kommt der Teil, der ändern sollte, wie du prompten solltest. Das Reasoning, das Fable 5 betreibt — das interne Denken, bevor es dir antwortet — wird als Output-Tokens abgerechnet, zu denselben 50 $ pro Million. Thinking-Tokens sind die teuerste Token-Klasse auf der gesamten Preisliste. Und du siehst sie in der Antwort nicht. Eine Antwort, die auf deinem Bildschirm wie 300 Wörter aussieht, kann leicht das Zehnfache davon in Reasoning verbrannt haben, das du nie zu sehen bekommst.
Jetzt leg die Effort-Level obendrauf. Fable 5s API stellt Effort als low, medium, high (Standard), xhigh und max bereit (Anthropics Effort-Docs beschreiben die Stufen; in Claude Code taucht die oberste Stufe als das ultra/ultracode-Zahnrad auf, das ich in meinem Opus 4.8 Effort-Levels-Review aufgedröselt habe). Effort verändert nicht die Rate pro Token — Fable 5 kostet auf jeder Stufe 10 $/50 $. Was Effort verändert, ist wie viele Tokens das Modell mit Denken verbringt, bevor es antwortet. Dreh Effort auf max, und du hast nicht jedes Token teurer gemacht; du hast dem Modell gesagt, es solle sehr viel mehr von den teuersten Tokens auf der Karte kaufen.
Setz diese beiden Fakten zusammen und du hast die ganze These dieses Posts: Bei Fable 5 wird der Preis einer Aufgabe weniger dadurch bestimmt, was du fragst, als wie du fragst. Ein vager Prompt lässt das Modell zu 50 $ pro Million im Kreis grübeln, um herauszufinden, was du gemeint hast. Ein Prompt, der zu offener Erkundung einlädt, führt zu Erkundung — teurer Erkundung. Ein Prompt mit einer Reasoning-Exposure-Anfrage darin kann dich auf ein anderes Modell schubsen, ohne dass du es laut mitbekommst.
Das ist kein Grund, Fable 5 zu meiden. Es ist ein Grund, es wie den Spezialisten zu prompten, der es ist. Es gibt hier drin einen Habit — den fünften — der wirklich Fable-spezifisch ist und den die meisten Leute derzeit falsch machen, weil das Verhalten, das er ausnutzt, in älteren Modellen nicht existierte. Halt ihn im Hinterkopf; ich schließe die Schleife am Ende.
Sechs Habits. Grob geordnet danach, wie viel Geld jeder pro Prompt spart.
Habit 1: Gib ihm das „Warum", nicht nur das „Was"
Die einzelne Änderung mit dem höchsten Return war zugleich die am wenigsten intuitive, weil sie bedeutet, mehr zu schreiben, um weniger auszugeben.
Jede Anfrage trägt einen Grund hinter sich her — das Ergebnis, das du eigentlich verfolgst. Die meisten Prompts werfen diesen Grund weg und übergeben dem Modell nur die mechanische Anweisung. „Schreib eine E-Mail über die Verzögerung." „Refaktoriere diese Klasse." „Fasse diese Notizen zusammen." Das Modell muss dann deine Absicht aus der nackten Aufgabe rekonstruieren, und Rekonstruktion ist genau die Art offenes Reasoning, die bei Fable 5 die Uhr zum Ticken bringt.
Gib ihm das Warum von vornherein mit und du kollabierst das Raten. Vergleiche:
Schwach: „Schreib eine E-Mail an den Kunden über die Verzögerung im Zeitplan."
Stark: „Schreib eine E-Mail an einen Kunden, der der Anker-Kunde für einen viel größeren Rollout im nächsten Quartal ist — die Beziehung wiegt mehr als diese eine Deadline. Der Zeitplan verschiebt sich um zwei Wochen. Ich möchte, dass er sich informiert und in Kontrolle fühlt, nicht gemanagt. Halt es kurz und konkret zu den neuen Terminen."
Die zweite Version ist nicht länger um des Längerseins willen. Jede zusätzliche Klausel entfernt einen Ast, den das Modell sonst auf eigene Rechnung hätte erkunden müssen — den Ton, die Einsätze, die Länge, das Ziel. Fable 5s semantisches Verständnis ist scharf genug, dass es, wenn du ihm echten Kontext lieferst, aufhört, quer über ein Dutzend möglicher Lesarten abzuwägen, und sich auf die richtige festlegt. Schärferer Output, weniger Reasoning-Tokens dorthin. Du hast ein paar Input-Tokens zu 10 $ pro Million bezahlt, um einen Haufen Output-Tokens zu 50 $ pro Million zu sparen.
Das potenziert sich hart, wenn das Modell in ein Kontextsystem eingeklinkt ist. In meinem zweiten Gehirn ist „das Warum" oft ein Zeiger: „Das ist für den Q3-Partner-Review — zieh die relevanten Kontextdateien heran und entwirf gegen das, was wir im letzten Sync beschlossen haben." Dieser eine Satz sagt Fable 5, welche Notizen zu laden sind und wie Erfolg aussieht, und das Kontext-schlägt-Konfiguration-Prinzip, über das ich geschrieben habe, erledigt den Rest. Das Modell räsoniert nicht im luftleeren Raum. Es räsoniert gegen deine tatsächliche Situation.
Die Regel, der ich jetzt folge: Ertappe ich mich beim Schreiben eines nackten Imperativs, halte ich inne und ergänze die Klausel, die mit „weil" beginnt. Neun von zehn Mal ist diese Klausel das Wertvollste im ganzen Prompt.
Habit 2: Sag ihm, was es NICHT tun soll
Kontext sagt dem Modell, wohin es gehen soll. Negativ-Prompting sagt ihm, wo die Klippen sind — und Fable 5 ist das erste Modell, bei dem ich das sauber landen sehe, statt halb ignoriert zu werden.
Der Failure-Mode, den Negativ-Prompting killt, ist ungefragte Initiative. Du bittest das Modell, einen Bug zu untersuchen, und es refaktoriert „hilfsbereit" drei unbeteiligte Dateien. Du bittest es, ein Dokument zu prüfen, und es schreibt die Hälfte davon um. Jede dieser ungebetenen Handlungen ist Output-Tokens, für die du zahlst, und Aufräumarbeit, um die du nicht gebeten hast — eine doppelte Steuer, in Bar und in Zeit.
Deshalb ziehe ich jetzt den Zaun explizit:
„Untersuche, warum dieser Endpoint einen 500 zurückgibt, und berichte, was du findest. Bearbeite, lösche oder ‚fixe' nichts, bis ich Grün gebe."
Dieser letzte Satz rettet mich am laufenden Band. Ohne ihn wird ein fähiges Modell, das den Drang hat, nützlich zu sein, anfangen, Dinge zu „verbessern", und bei Fable 5 sind diese Verbesserungen keine kostenlosen Experimente — sie sind Premium-bepreist. Mit ihm erledigt das Modell genau die eingegrenzte Aufgabe und stoppt, und ich entscheide, was einen Eingriff wert ist.
Ein paar Negativ-Prompts, die ich im Wechsel nutze, weil sie ihren Platz verdienen:
- „Nur Befunde melden. Keine Dateien ändern." — für jede Untersuchung oder jeden Audit-Durchlauf.
- „Keine Abhängigkeiten oder neuen Libraries hinzufügen, es sei denn, es gibt keine vernünftige Alternative — und dann erst melden." — stoppt Scope-Creep bei Code-Aufgaben eiskalt.
- „Schreib keine Abschnitte um, die schon funktionieren. Fass nur an, was ich genannt habe." — fürs Editieren, wo Modelle gerne überziehen.
Eine Feinheit, die ich auf die harte Tour gelernt habe: Negativ-Prompting funktioniert mit positivem Framing, nicht statt seiner. „Brich die Tests nicht" ist schwächer als „Halt jeden bestehenden Test grün, und erst danach ergänze Abdeckung für das neue Verhalten." Gib dem Modell ein Ziel und einen Zaun. Ich habe diese Balance in meinen Prompting-Regeln, die Raten reduzieren, tiefer ausgegraben — das ganze Spiel besteht darin, dem Modell so wenig Raum zum Erfinden wie möglich zu lassen, denn Erfinden ist, woher sowohl Bugs als auch Tokenrechnungen kommen.
Habit 3: Lass es handeln, sobald es genug hat — und passe den Effort der Aufgabe an
Das ist der Habit, der die Uhr am direktesten berührt, also entschleunige hier.
Fähige Reasoning-Modelle neigen zum Überbereiten. Stell eine offene Frage und sie recherchieren erschöpfend, wägen sechs Optionen ab, bauen einen Plan für den Plan — manchmal wirklich nützlich, oft aber nur teures Räuspern vor einer Antwort, die drei Schritte früher erreichbar gewesen wäre. Bei einem Modell, bei dem Denken zu 50 $ pro Million abgerechnet wird, ist diese Präambel eine Position auf der Rechnung.
Deshalb sage ich Fable 5 jetzt mit klaren Worten, dass es handeln soll, sobald es genug hat:
„Hol dir, was du tatsächlich brauchst, und leg dann los. Nicht überrecherchieren — sobald du genug hast, um sinnvoll zu handeln, handle. Wenn du auf eine echte Weggabelung stößt, die du nicht auflösen kannst, stell mir eine scharfe Frage, statt zu raten."
Diese einzelne Anweisung schneidet lange, kostspielige Grübeleien bei Aufgaben ab, die das nicht brauchten. Fable 5 folgt kurzen, klaren Anweisungen gut genug, dass „hör auf zu planen und rühr dich" wirklich ankommt — sein Reasoning ist gut genug, um zu wissen, wann es genug hat, wenn du ihm erlaubst, aufzuhören.
Die andere Hälfte dieses Habits ist der Effort-Regler, und hier versteckt sich das meiste Geld. Lass alles auf dem Standard „high" und du zahlst bei Routinearbeit drauf und schwächst dir gelegentlich das Schwere ab. Meine Arbeitskarte:
- Low / medium — Nachschlagen, Umbenennen, Boilerplate, „Wo ist X definiert", ein schneller Entwurf. Routinekram hat auf high nichts verloren.
- High (Standard) — echte Feature-Arbeit, Änderungen über mehrere Dateien, alles, wobei du wollen würdest, dass ein Kollege wirklich mitdenkt.
- Xhigh / max — wirklich knifflige Refaktorierungen, Architekturentscheidungen, subtiles Debugging. Diese Stufen wählst du bewusst, nicht aus Gewohnheit.
Hier ist die Umformulierung, die mir am meisten gespart hat: Du solltest Fable 5 für den Großteil deiner Arbeit vermutlich gar nicht laufen lassen. Die Community-Behauptung, die zum Launch kursierte — dass Fable 5 auf low Opus 4.8 in seiner höchsten Einstellung ebenbürtig sei — kann ich nicht sauber verifizieren, und ich würde jede präzise „Fable low = Opus max"-Gleichsetzung als Marketing behandeln, bis du sie an deinen eigenen Aufgaben getestet hast. Aber die Form des Ratschlags stimmt unabhängig davon: Fable 5 ist ein Skalpell, kein Alltagsauto. In meinem eigenen Routing macht es vielleicht 5–15 % der Arbeit — die tiefen Durchläufe, bei denen seine Obergrenze wirklich zählt — und Opus 4.8 oder billigere Modelle tragen die Routinelast. Fable 5 für alles zu benutzen ist keine Hingabe an Qualität. So zündest du Geld an. Ich habe die weitere Routing-Mathematik in meinem KI-Agenten-Kostenoptimierungs-Guide ausgeführt, und sie gilt bei diesen Raten doppelt.
Die Disziplin: Wähl das billigste Modell und das niedrigste Effort-Level, das den Job tatsächlich erledigt. Nicht das höchste, das du dir leisten kannst. Das niedrigste, das funktioniert.
Habit 4: Lass es seine Arbeit belegen, bevor es irgendetwas „fertig" nennt
Jedes Modell erklärt gelegentlich einen Sieg, den es nicht verdient hat — Tests, die „bestanden" haben, obwohl sie nie liefen, ein Fix, der auf eine Datei „angewendet" wurde, die es falsch gelesen hat, eine Zusammenfassung, die selbstbewusst eine Quelle zitiert, die das Gegenteil sagt. Bei einem billigen Modell ist das ein Ärgernis. Bei Fable 5 ist es ein Ärgernis, für das du Premiumpreis gezahlt hast, und schlimmer: Es ist die Art Fehler, die dich eine zweite teure Runde kostet, um ihn zu fangen und zu korrigieren.
Also verankere ich Verifikation direkt in der Anweisung:
„Bevor du mir sagst, das ist fertig, verifiziere es. Führ die Tests aus und zeig mir den Output. Wenn du eine Behauptung nicht verifizieren kannst, sag das offen, statt zu raten — ich höre lieber ‚Ich konnte den Caching-Pfad nicht bestätigen' als eine selbstbewusste Antwort, die sich als falsch herausstellt."
Zwei Dinge machen das wirksam. Erstens: Beweise verlangen — echten Kommando-Output, die konkret geänderte Zeile, das Zitat aus der Quelle — keine Zusammenfassung von Beweisen. „Die Tests bestehen" ist eine Behauptung. Der eingefügte Testrunner-Output ist der Beweis. Erzwing den Beweis.
Zweitens, und dieser Teil passt schön zu Fable 5s Ehrlichkeits-Tuning: Erlaube dem Modell explizit zu sagen „Ich konnte das nicht verifizieren." Die neueren Claude-Modelle sind spürbar besser darin, die Kante ihres eigenen Wissens zu markieren, wenn du sie dazu einlädst, und ein ehrliches „Bei diesem Teil bin ich mir nicht sicher" spart dir die weit teurere Entdeckung, dass es etwas erfunden hat und du es ausgeliefert hast. Ein Modell, das Zweifel zugibt, ist billiger als ein Modell, das selbstsicher fabriziert, jedes einzelne Mal.
Das ist nicht Fable-spezifisch — Verifikationsschleifen verbessern jedes Modell, und ich würde behaupten, sie sind der vertrauensstärkste Habit auf dieser Liste. Aber sie sind bei Fable 5 wertvoller, gerade weil die Kosten eines unverifizierten Fehlers hier höher sind. Wenn Fehler teuer sind, ist der Habit, der Fehler früh fängt, am meisten wert.
Wenn du lieber jemanden hättest, der diese Verifikationsschleifen direkt in die Agents und Skills deines Teams einbaut — sodass der „Beleg's"-Schritt im System steckt statt bei jedem Prompt neu getippt zu werden — dann ist das genau die Art Setup-Arbeit, die ich übernehme. Was ich gebaut habe, siehst du unter fiverr.com/s/EgxYmWD.
Habit 5: Hör auf, Fable 5 zu bitten, sein Reasoning zu zeigen
Hier schließe ich die Schleife von oben — der eine Habit, der wirklich modell-spezifisch ist, und den ich am häufigsten falsch gemacht sehe.
Hör auf, „erkläre deine Überlegungen Schritt für Schritt" und „führ mich durch dein Denken" und „zeig deine Chain-of-Thought" in deine Fable-5-Prompts zu packen. Nicht weil der Ratschlag allgemein schlecht wäre — er ist seit Jahren solides Prompt-Handwerk. Sondern weil bei Fable 5, nach seiner Rückkehr, Reasoning-Exposure-Anfragen den Safety-Classifier auslösen können.
Etwas Kontext dazu, warum. Fable 5 kam Anfang Juli unter einer deutlich verschärften Safety-Schicht zurück, nach der ganzen Export-Kontroll-Saga, die ich in meiner Breakdown zur Rückkehr von Fable 5 auseinandergenommen habe. Der neue Classifier wurde gebaut, um eine bestimmte Jailbreak-Klasse abzuwürgen — und Berichte zur Rückkehr merken an, dass er die Zieltechnik in über 99 % der Fälle blockiert, um den Preis einer höheren Falsch-Positiv-Rate bei gewöhnlichen Anfragen (TechTimes hat das Verhalten des neuen Classifiers dokumentiert). Versuche, die interne Funktionsweise des Modells zu extrahieren, liegen unangenehm nah an den Jailbreak-Mustern, auf die der Classifier trainiert ist.
Wenn eine Anfrage diesen Classifier auslöst, verweigert Fable 5 nicht einfach. Es leitet die Anfrage an Opus 4.8 um. Berichten zufolge wirst du in der Regel benachrichtigt, wenn das passiert, und über die API ist das antwortende Modell sichtbar, wenn du hinschaust — aber innerhalb eines langen Agent-Runs oder einer geschwätzigen Desktop-Session ist das ehrlich leicht zu übersehen. Du denkst, du kriegst Fable 5s Obergrenze. Du kriegst still ein anderes Modell.
Die Ökonomie dieser Umleitung ist eine zweischneidige Sache, die es zu verstehen lohnt. Wirst du auf Opus 4.8 umgeleitet, zahlst du Opus' niedrigere Rate — eine heruntergestufte Antwort kostet dich also tatsächlich weniger. Klingt nach einem Gewinn, bis du dich erinnerst, warum du zu Fable 5 gegriffen hast: Du wolltest seine Obergrenze für ein schweres Problem. Bei genau der Aufgabe, für die du Premium zahlst, stillschweigend ein weniger fähiges Modell in die Hand gedrückt zu bekommen, ist kein Rabatt. Es ist ein Qualitätsabfall, den du nicht gewählt hast und vielleicht nicht bemerkst.
Der Fix ist einfach und er ist gratis: Streich Reasoning-Exposure-Anfragen aus deinen Fable-5-System-Prompts und User-Prompts. Wenn du wirklich das Denken des Modells sehen musst, ist dafür der Verifikations-Output (Habit 4) da — verlang Beweise und Ergebnisse, keinen offengelegten Denkprozess. Du kriegst die Rechenschaft ohne das rote Tuch für den Classifier. Ich pflege eine Version meines System-Prompts für Fable 5, aus der jede „erkläre deine Überlegungen"-Sprache getilgt ist, und eine andere für andere Modelle, wo das nach wie vor okay ist. Kleine Änderung. Sie ist der Unterschied zwischen dem Modell, für das du zahlst, und einem Doppelgänger.
Habit 6: Sag weniger, nicht mehr
Der letzte Habit ist der, der die anderen fünf zusammenbindet, und er ist der, der gegen jeden Instinkt anläuft, den uns die Opus-4.7-Ära antrainiert hat.
Jahrelang bedeutete guter Output mehr — mehr Regeln, mehr Vorbehalte, mehr explizite Edge-Case-Behandlung, immer längere System-Prompts, die Anweisung auf Anweisung stapelten, um das Modell einzuzäunen. Fable 5 bricht diesen Reflex. Es ist intelligent genug, dass ein knapper, gut zielender Prompt ein wortreiches Regelbuch schlägt — und das wortreiche Regelbuch kostet dich Input-Tokens bei jedem einzelnen Call und lädt das Modell ein, quer über all diese Anweisungen zu räsonieren, zu 50 $ pro Million im Output.
Vergleiche ein echtes Vorher-Nachher aus meiner eigenen Content-Pipeline. Die alte Version war eine vierzehnzeilige Regelliste über Ton, Struktur, was zu vermeiden ist, wie zu formatieren, wann zu fragen. Die neue Version:
„Führ mit dem Ergebnis. Halt es einfach und konkret. Halt nur inne, um mich etwas zu fragen, wenn die Arbeit wirklich eine Entscheidung braucht, die ich noch nicht getroffen habe."
Drei Sätze. Sie produziert sauberere Entwürfe als die vierzehnzeilige Version, weil Fable 5 nicht mit dem Regelbefolgen kämpfte — es war von den Regeln abgelenkt. Intelligenz plus Prägnanz schlägt Intelligenz plus eine Wand aus Constraints.
Der Haken, und der ist wichtig, damit ich Habit 1 nicht widerspreche: Weniger ist nicht dasselbe wie vage. Habit 1 sagte: Gib ihm Kontext. Habit 6 sagt: Ertränk diesen Kontext nicht in Regeln. Das steht nicht im Widerspruch — der höchstwertige Inhalt (das Warum, das Ziel, der Zaun) bleibt; das niederwertige Zeremoniell (offensichtliche Anweisungen, redundante Vorbehalte, defensive Überspezifikation) fliegt raus. Du wirfst Ballast ab, nicht Signal.
Genau das lässt eine enge Integration mit Skills und Kontextdateien auch tatsächlich funktionieren. Wenn dein Prompt schlank ist, hat das Modell Luft, sich auf deinen System-Prompt, deine Kontextdateien und deine Skills zu stützen, statt in jeder Runde eine aufgeblähte Anweisung erneut zu lesen. Prägnanz auf Prompt-Ebene ist, was der System-Ebene erlaubt, ihren Job zu tun — dieselbe Verschiebung, die ich nachgezeichnet habe, als Prompt Engineering dem Loop Engineering wich. Sag weniger im Prompt, damit die Architektur drumherum mehr sagen kann.
Wo die sechs Habits an ihre Grenzen stoßen
Ich habe dir diesen ganzen Post hindurch Habits in die Hand gedrückt, also lass mich ehrlich über die Reibung sein, denn eine adrette Sechs-Punkte-Liste, die so tut, als gäbe es keinen Nachteil, ist nur eine Werbeanzeige.
Die Umleitung ist das, worauf du achten musst, und sie ist leicht aus den Augen zu verlieren. Habit 5 entschärft den Reasoning-Exposure-Trigger, aber der Classifier ist eng genug abgestimmt, dass legitime Arbeit — defensive Security besonders — dich immer noch ohne lautes Signal auf Opus 4.8 schubsen kann. Wenn du gerade für eine harte Aufgabe Fable-5-Raten zahlst, prüf tatsächlich, welches Modell geantwortet hat. Wenn du das von deiner Oberfläche aus nicht erkennen kannst, ist das ein Grund, hochkritische Fable-5-Arbeit dort laufen zu lassen, wo das antwortende Modell sichtbar ist.
Die meisten dieser Habits helfen jedem Modell — und das ist der Punkt, nicht die Schwäche. Kontext, Negativ-Prompting, Verifikation, Prägnanz: nichts davon ist Fable-exklusiv. Fable-spezifisch ist, wie teuer es hier ist, sie auszulassen. Derselbe schlampige Prompt, der bei einem billigen Modell Pfennige verschwendet, verschwendet bei Fable 5 echtes Geld. Die Habits ändern sich nicht. Die Einsätze schon.
Der größte Hebel ist gar kein Prompting-Habit. Es ist, Fable 5 nicht zu benutzen. Ich sag's noch mal, weil das der Punkt ist, den Leute abwehren: Die richtige Menge Fable 5 in deinem Workflow ist klein. Route die routinemäßigen 85–95 % deiner Arbeit an Opus 4.8 und billigere Modelle, und heb Fable 5 für die Durchläufe auf, bei denen seine Obergrenze das Ergebnis wirklich verändert. Der beste Claude-Fable-5-Prompting-Habit ist am Ende zu wissen, wann man Fable 5 nicht prompten sollte.
Wie ich diese sechs Habits ins System einbacke, nicht in den Prompt
Habits, an die du dich erinnern musst, sind Habits, die du um 23 Uhr am Deadline-Tag überspringst. Also habe ich aufgehört, mich auf mein Gedächtnis zu verlassen, und alle sechs unter die Prompt-Ebene gedrückt.
Drei Orte, an denen sie jetzt leben:
Im System-Prompt. Mein Fable-5-System-Prompt hat die Invarianten fest eingebaut: leg los, sobald du genug hast; verifiziere, bevor du „fertig" sagst; sag Bescheid, wenn du etwas nicht bestätigen kannst; und — die Fable-spezifische — null Reasoning-Exposure-Sprache irgendwo darin. Ich tippe die nicht neu. Sie sind der Boden, von dem jeder Prompt startet.
In Skills. Für wiederkehrende Jobs — ein Code-Review-Durchlauf, eine Recherche-Zusammenfassung, ein Content-Entwurf — leben die Verifikationsschleife und die Negativ-Prompting-Zäune innerhalb der Skill-Definition selbst. Der Skill ist der Habit, einmal codiert. Rufe ich ihn auf, kommt der „Beleg deine Arbeit, fass nicht an, was ich nicht genannt habe"-Vertrag automatisch mit. Das ist dieselbe Zweites-Gehirn-plus-Skills-Architektur, auf die ich in meinem KI-Betriebssystem auf Claude Code hingearbeitet habe.
In Effort-Defaults pro Aufgabentyp. Statt jedes Mal nach Bauchgefühl ein Effort-Level zu wählen, mappe ich Aufgabentypen einmalig auf Level und lasse das Routing folgen. Routine-Skills fahren per Default auf low oder medium; die Deep-Pass-Skills reservieren high und darüber. Die Entscheidung wandert aus dem Moment ins Design.
Der Payoff ist, dass die teuren Fehler — das entgleiste Reasoning, die stille Umleitung, die selbstsichere Fabrikation, der vierzehnzeilige Prompt — aufhören, Dinge zu sein, die ich in Echtzeit fangen muss. Das System fängt sie, weil ich den Fang einmalig codiert habe. Das ist das eigentliche Ziel aller sechs Habits: nicht bessere Prompts, getippt von einem disziplinierten Menschen, sondern ein Setup, in dem die Disziplin strukturell ist und der Mensch ein bisschen schlampig sein darf, ohne dafür zu zahlen.
Der wahre Preis eines Fable-5-Prompts
Zurück zu diesem 41-Wörter-Prompt vom Anfang. Die Verschwendung waren nicht wirklich die 41 Wörter. Es war alles, was sie in Gang setzten: das offene Reasoning zu 50 $ pro Million, die „erkläre deine Überlegungen"-Zeile, die mich womöglich auf ein anderes Modell geschubst hat, die Initiative, die ich nicht eingezäunt habe, die Regeln, die ich statt des Kontextes gestapelt habe, den ich hätte geben sollen. Ein fauler Prompt, vier separate Lecks.
Fable 5 ist das fähigste Modell, das ich je in die Hände bekommen habe, und es lässt sich entsprechend bezahlen. Diese Kombination lässt Prompting aufhören, eine Soft Skill zu sein, und anfangen, Kostensteuerung zu sein — dieselbe Anweisung, in zwei Formulierungen, kann sich in dem, was sie verbrennt und ob sie überhaupt auf dem gemeinten Modell läuft, um eine Größenordnung unterscheiden. Die sechs Habits geht es nicht darum, einen besseren Satz aus dem Modell zu quetschen. Es geht darum, für die eigene Unschärfe keine Premium-Preise zu zahlen.
Hier ist die eine Sache, die du heute tun kannst: Nimm den einen Prompt oder System-Prompt, den du am häufigsten an Fable 5 schickst, und lass ihn durch die sechs laufen. Ergänze das Warum. Zäune ab, was du nicht willst. Sag ihm, es soll handeln und verifizieren. Streich jedes „erkläre deine Überlegungen". Und dann kürz ihn um die Hälfte. Schick beide Versionen auf dieselbe Aufgabe und beobachte den Token-Zähler. Die Lücke, die du siehst, ist die Steuer, die du bisher gezahlt hast — und jetzt weißt du, wie du damit aufhörst.
Häufig gestellte Fragen
Warum ist das Prompten von Claude Fable 5 so teuer?
Claude Fable 5 kostet 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens — ungefähr das Doppelte von Opus 4.8 — und sein internes Reasoning wird als Output zu ebenjenen 50 $ abgerechnet. Ein vager oder aufgeblähter Prompt lässt das Modell mehr räsonieren, bevor es antwortet, sodass ungenaues Prompting die Kosten direkt aufbläst. Knappe, kontextreiche Prompts verbrauchen weniger dieser teuren Reasoning-Tokens.
Verändern Effort-Level, wie viel Claude Fable 5 kostet?
Effort-Level verändern die Rate pro Token nicht — Fable 5 kostet auf jeder Stufe 10 $/50 $. Was sie verändern, ist, wie viele Tokens das Modell mit Denken verbringt, bevor es antwortet. Höherer Effort (xhigh, max) kann weit mehr Tokens verbrauchen, als der sichtbare Output vermuten lässt, weshalb das Angleichen des Efforts an die Aufgabenschwere ein direkter Kostenhebel ist. Siehe Habit 3 oben für die vollständige Karte.
Warum wechselt Claude Fable 5 manchmal zu Opus 4.8?
Fable 5s verschärfter Safety-Classifier leitet markierte Anfragen — inklusive Reasoning-Exposure-Versuchen und mancher legitimer defensiver Security-Arbeit — an Opus 4.8 um. Berichte sagen, du wirst in der Regel benachrichtigt und die API zeigt das antwortende Modell an, aber in einer langen Session ist das leicht zu übersehen. Bei einer Herabstufung zahlst du Opus' niedrigere Rate, verlierst aber die Fable-5-Obergrenze, für die du gezahlt hast.
Soll ich Claude Fable 5 bitten, sein Reasoning zu erklären?
Nein — bei Fable 5 im Speziellen können Anfragen im Stil „erkläre deine Überlegungen" den Safety-Classifier auslösen und dich auf Opus 4.8 umleiten. Wenn du Rechenschaft brauchst, verlange stattdessen Verifikationsbelege (Test-Output, die konkrete Änderung, Quellenzitate) statt eines offengelegten Denkprozesses. Du bekommst dieselbe Rechenschaft ohne das Umleitungsrisiko. Siehe Habit 5 oben.
Welcher Anteil meiner Arbeit sollte tatsächlich auf Claude Fable 5 laufen?
In meinem eigenen Routing rund 5–15 % — die tiefen Durchläufe, bei denen die Obergrenze das Ergebnis wirklich verändert. Route die routinemäßigen 85–95 % an Opus 4.8 und billigere Modelle. Fable 5 bei diesen Raten als Alltagswerkzeug zu nutzen ist der schnellste Weg, Guthaben für Qualität zu verbrennen, die du für die meisten Aufgaben gar nicht brauchtest.
Willst du die Prompting-Disziplin fest verdrahtet?
Diese sechs Habits zahlen sich nur aus, wenn du sie auch wirklich laufen lässt, und um 23 Uhr am Deadline-Tag tut das niemand. Wenn du lieber die Verifikationsschleifen, die Zäune und die Fable-5-sichere Prompt-Hygiene in die System-Prompts und Skills deines Teams eingebaut hättest, statt sie in jeder Session neu zu tippen, dann ist das die Art Setup, die ich übernehme — sieh dir hier an, was ich baue.