Le prompt le plus coûteux que j'ai envoyé la semaine dernière faisait 41 mots, et seuls les neuf premiers avaient une vraie utilité — ma première vraie leçon sur le prompting Claude Fable 5 depuis le retour du modèle.
J'étais en train de brancher un nouveau flux de capture dans mon second cerveau — la configuration Obsidian-plus-Claude-Code à travers laquelle je fais passer toute ma vie — et j'ai balancé une de ces instructions boursouflées, ceinture-et-bretelles, que j'avais pris l'habitude d'écrire à l'époque d'Opus 4.7. « Fais ceci, mais ne fais pas cela, et pense aussi à considérer ceci, et explique ton raisonnement à chaque étape pour que je puisse suivre, et sois exhaustif. » Vous voyez le genre. L'instruction où vous essayez d'anticiper chaque manière dont le modèle pourrait dérailler en empilant règle sur règle.
Sur Opus, ce prompt était simplement inefficace. Sur Claude Fable 5, c'était un petit incendie. Parce que Fable 5 facture 10 $ par million de tokens d'entrée et 50 $ par million en sortie — et cette ligne « explique ton raisonnement à chaque étape » n'a pas seulement gonflé la réponse, elle a peut-être discrètement fait basculer la requête vers un tout autre modèle. J'y viens. La version courte, c'est qu'un bon prompting Claude Fable 5 n'est pas une préférence stylistique sur ce modèle. C'est la différence entre un outil qui mérite son prix et un outil qui vide votre compte pendant que vous regardez ailleurs.
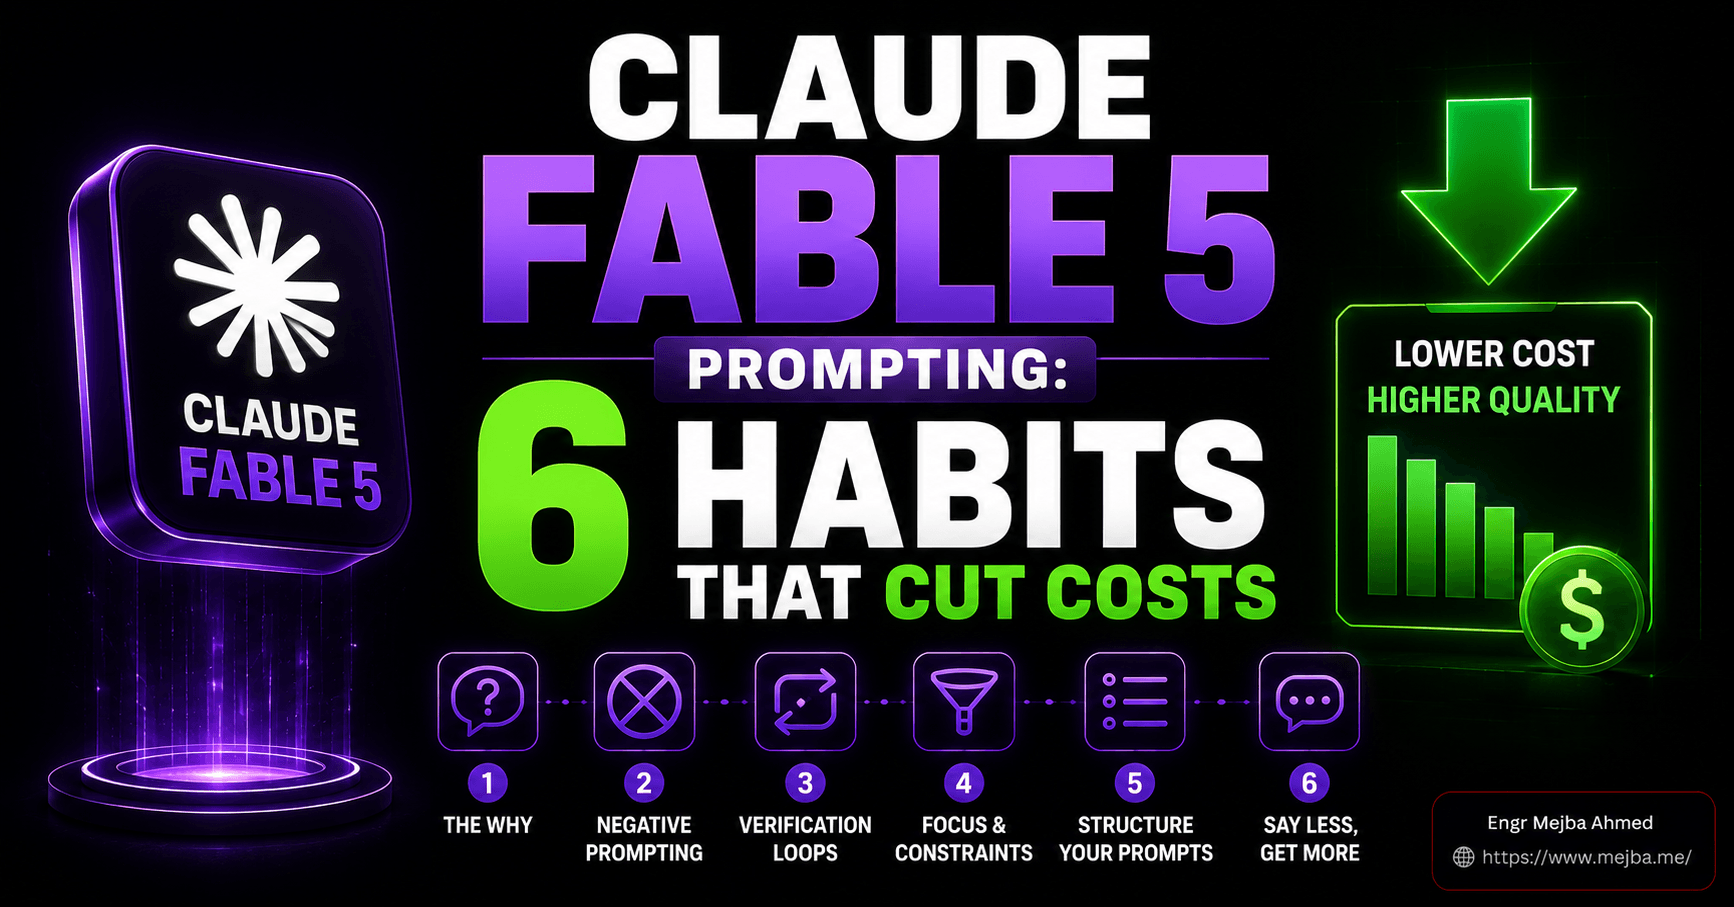
J'ai passé les jours qui ont suivi le retour de Fable 5 à repenser la manière dont je lui parle — sur mon système d'exploitation IA construit sur Claude Code, sur mes dépôts clients quotidiens, et dans le second cerveau que je fais tourner dans Obsidian. Six habitudes ont fait le gros du travail. Chacune rend la sortie meilleure et la facture plus légère en même temps, ce qui est plus rare que ça n'en a l'air. Voici cette liste.
Si vous voulez le pendant — sur quoi pointer concrètement Fable 5 pendant la fenêtre gratuite, qu'Anthropic a prolongée jusqu'au 12 juillet après l'échéance initiale du 7 juillet — j'ai cartographié huit workflows à fort levier pour la fenêtre gratuite séparément. Cet article-là, c'est la to-do list. Celui-ci, c'est le comment-le-dire. Lisez-les ensemble et vous avez les deux moitiés.
Pourquoi Fable 5 punit un prompt bâclé plus durement qu'aucun modèle que j'aie utilisé
Posons des chiffres réels avant les habitudes, parce que les habitudes ne prennent leur sens qu'une fois que vous ressentez la mécanique du coût dans vos tripes.
Fable 5 est le modèle le plus capable qu'Anthropic livre en ce moment, et il est tarifé en conséquence : 10 $ par million de tokens d'entrée, 50 $ par million de tokens de sortie (la doc tarifaire d'Anthropic confirme le taux). C'est à peu près le double des 5 $-in / 25 $-out d'Opus 4.8. Jusque-là, banal : « le modèle premium est premium ».
Voici la partie qui change la façon dont vous devriez prompter. Le raisonnement que fait Fable 5 — la réflexion interne avant qu'il ne vous réponde — est facturé comme des tokens de sortie, à ce même tarif de 50 $ par million. Les tokens de raisonnement sont la classe de tokens la plus chère de toute la grille. Et vous ne les voyez pas dans la réponse. Une réponse qui ressemble à 300 mots à l'écran peut avoir brûlé dix fois ça en raisonnement que vous n'aurez jamais lu.
Ajoutez maintenant les niveaux d'effort par-dessus. L'API de Fable 5 expose l'effort en low, medium, high (par défaut), xhigh, et max (la doc effort d'Anthropic détaille les paliers ; dans Claude Code, l'échelon supérieur apparaît comme l'engrenage ultra/ultracode que j'ai creusé dans mon test des niveaux d'effort d'Opus 4.8). L'effort ne modifie pas le tarif au token — Fable 5 est à 10 $/50 $ à chaque niveau. Ce que l'effort change, c'est combien de tokens le modèle dépense à réfléchir avant de répondre. Poussez l'effort au max et vous n'avez pas rendu chaque token plus cher ; vous avez dit au modèle d'acheter beaucoup plus des tokens les plus chers de la carte.
Mettez ces deux faits ensemble et vous avez toute la thèse de cet article : sur Fable 5, le coût d'une tâche est moins déterminé par ce que vous demandez que par la manière dont vous le demandez. Un prompt vague fait tourner le modèle en rond à 50 $ le million pour deviner ce que vous vouliez dire. Un prompt qui invite à l'exploration ouverte le fait explorer — cher. Un prompt qui contient une demande d'exposition du raisonnement peut vous faire basculer sur un autre modèle sans vous le signaler à voix haute.
Ce n'est pas une raison d'éviter Fable 5. C'est une raison de le prompter comme le spécialiste qu'il est. Il y a une habitude ici — la cinquième — qui est réellement spécifique à Fable et que la plupart des gens se plantent en ce moment, parce que le comportement qu'elle exploite n'existait pas sur les modèles précédents. Gardez-la en tête ; je bouclerai la boucle.
Six habitudes. Rangées grossièrement selon l'argent que chacune fait économiser par prompt.
Habitude 1 : donnez-lui le « pourquoi », pas seulement le « quoi »
Le changement au rendement le plus élevé que j'ai fait était aussi le moins intuitif, parce qu'il consiste à écrire plus pour dépenser moins.
Chaque requête porte une raison — le résultat que vous poursuivez réellement. La plupart des prompts jettent cette raison et ne donnent au modèle que l'instruction mécanique. « Écris un email sur le retard. » « Refactorise cette classe. » « Résume ces notes. » Le modèle doit alors reconstruire votre intention à partir de la tâche brute, et la reconstruction est exactement ce genre de raisonnement ouvert qui fait tourner le compteur sur Fable 5.
Donnez-lui le pourquoi d'entrée de jeu et vous supprimez cette devinette. Comparez :
Faible : « Écris un email au client pour lui dire que le calendrier glisse. »
Fort : « Écris un email à un client qui est le client d'ancrage d'un déploiement bien plus large le trimestre prochain — la relation compte davantage que cette échéance-ci. Le calendrier glisse de deux semaines. Je veux qu'il se sente informé et aux commandes, pas géré. Reste court et précis sur les nouvelles dates. »
La seconde version n'est pas plus longue pour rien. Chaque proposition supplémentaire supprime une branche que le modèle aurait dû explorer à ses frais — le ton, les enjeux, la longueur, l'objectif. La compréhension sémantique de Fable 5 est assez fine pour que, quand vous lui donnez un vrai contexte, il cesse de louvoyer entre une douzaine de lectures possibles et s'engage sur la bonne. Sortie plus nette, moins de tokens de raisonnement pour y arriver. Vous avez payé quelques tokens d'entrée à 10 $ le million pour éviter un tas de tokens de sortie à 50 $ le million.
Ça se compose fort quand le modèle est câblé dans un système de contexte. Dans mon second cerveau, « le pourquoi » est souvent un pointeur : « C'est pour la revue partenaire du Q3 — récupère les fichiers de contexte pertinents et rédige à partir de ce dont on est convenus au dernier sync. » Cette seule phrase dit à Fable 5 quelles notes charger et à quoi ressemble le succès, et le principe contexte-l'emporte-sur-configuration dont j'ai parlé fait le reste. Le modèle ne raisonne pas dans le vide. Il raisonne face à votre situation réelle.
La règle que je suis maintenant : si je me surprends à écrire un impératif nu, je m'arrête et j'ajoute la proposition qui commence par « parce que ». Neuf fois sur dix, cette proposition est ce qu'il y a de plus précieux dans le prompt.
Habitude 2 : dites-lui ce qu'il ne doit PAS faire
Le contexte dit au modèle où aller. Le prompting négatif lui dit où sont les falaises — et Fable 5 est le premier modèle sur lequel je vois ça atterrir proprement au lieu d'être à moitié ignoré.
Le mode d'échec que tue le prompting négatif, c'est l'initiative non demandée. Vous demandez au modèle d'enquêter sur un bug et il « aide gentiment » en refactorisant trois fichiers sans rapport. Vous lui demandez de relire un document et il en réécrit la moitié. Chacune de ces actions non sollicitées, ce sont des tokens de sortie que vous payez et du nettoyage que vous n'avez pas demandé — double taxe, en argent et en temps.
Alors je pose maintenant la barrière explicitement :
« Enquête sur pourquoi cet endpoint renvoie un 500 et rapporte-moi ce que tu trouves. N'édite pas, ne supprime pas, ne "corrige" rien tant que je n'ai pas dit "vas-y". »
Cette dernière phrase me sauve constamment. Sans elle, un modèle capable avec la démangeaison d'être utile va commencer à « améliorer » des choses, et sur Fable 5, ces améliorations ne sont pas des expériences gratuites — ce sont des expériences facturées au tarif premium. Avec elle, le modèle fait exactement la tâche bornée puis s'arrête, et je décide de ce qui vaut la peine d'être actionné.
Quelques prompts négatifs que je garde en rotation parce qu'ils gagnent leur place :
- « Rapporte les constats uniquement. Ne modifie pas les fichiers. » — pour toute passe d'enquête ou d'audit.
- « N'ajoute pas de dépendances ou de nouvelles bibliothèques à moins qu'il n'y ait pas d'alternative raisonnable, et signale-le d'abord dans ce cas. » — coupe net la dérive de périmètre sur les tâches de code.
- « Ne réécris pas les sections qui fonctionnent déjà. Ne touche qu'à ce que j'ai nommé. » — pour l'édition, où les modèles adorent en faire trop.
Une nuance que j'ai apprise à la dure : le prompting négatif fonctionne avec le cadrage positif, pas à sa place. « Ne casse pas les tests » est plus faible que « garde chaque test existant au vert, et seulement ensuite ajoute une couverture pour le nouveau comportement ». Donnez au modèle une cible à atteindre et une barrière à ne pas franchir. J'ai creusé cet équilibre dans mes règles de prompting qui réduisent les devinettes — tout le jeu, c'est de laisser au modèle le moins d'espace possible pour inventer, parce que l'invention est là où naissent à la fois les bugs et les factures en tokens.
Habitude 3 : laissez-le agir dès qu'il en sait assez — et ajustez l'effort à la tâche
C'est l'habitude qui touche le plus directement le compteur, alors ralentissez ici.
Les modèles de raisonnement capables ont tendance à sur-préparer. Posez une question ouverte et ils vont chercher exhaustivement, peser six options, faire un plan pour le plan — parfois vraiment utile, souvent juste un raclement de gorge coûteux avant une réponse qui était atteignable trois étapes plus tôt. Sur un modèle où la réflexion est facturée à 50 $ le million, ce préambule est un poste de dépense.
Alors je dis maintenant à Fable 5, en clair, d'agir dès qu'il en sait assez :
« Récupère ce dont tu as vraiment besoin, puis avance. Ne sur-recherche pas — dès que tu en sais assez pour agir sensément, agis. Si tu tombes sur une vraie bifurcation que tu ne peux pas résoudre, pose-moi une question précise plutôt que de deviner. »
Cette seule instruction coupe les délibérations longues et coûteuses sur des tâches qui n'en avaient pas besoin. Fable 5 suit assez bien une direction courte et claire pour que « arrête de planifier et bouge » atterrisse vraiment — son raisonnement est assez bon pour savoir quand il en sait assez, si vous lui donnez la permission de s'arrêter.
L'autre moitié de cette habitude, c'est le curseur d'effort, et c'est là que se cache la plupart de l'argent. Laissez tout sur le high par défaut et vous surpayez le travail routinier et, parfois, vous sous-alimentez le difficile. Ma carte de travail :
- Low / medium — recherches, renommages, boilerplate, « où est défini X », un brouillon rapide. Le travail routinier n'a rien à faire en effort high.
- High (par défaut) — vrai travail de feature, changements multi-fichiers, tout ce pour quoi vous voudriez qu'un collègue réfléchisse vraiment.
- Xhigh / max — refactos réellement épineux, décisions d'architecture, débogage subtil. Attrapez-les délibérément, pas par habitude.
Voici le recadrage qui m'a fait économiser le plus : vous ne devriez probablement pas faire tourner Fable 5 sur la majorité de votre travail. L'affirmation communautaire qui circulait au lancement — que Fable 5 en effort low égale Opus 4.8 à son réglage le plus élevé — je ne peux pas la vérifier proprement, et je traiterais toute équivalence précise « Fable low égale Opus max » comme du marketing tant que vous ne l'avez pas testée sur vos propres tâches. Mais la forme du conseil est juste, quoi qu'il en soit : Fable 5 est un scalpel, pas un cheval de labour quotidien. Dans mon propre routage, il fait peut-être 5 à 15 % du travail — les passes profondes où son plafond compte vraiment — et Opus 4.8 ou des modèles moins chers portent la charge routinière. Utiliser Fable 5 pour tout, ce n'est pas de la dévotion à la qualité. C'est la manière dont on met de l'argent au feu. J'ai posé la maths de routage plus large dans mon guide d'optimisation des coûts d'agent IA, et elle s'applique en double à ces tarifs.
La discipline : choisir le modèle le moins cher et le niveau d'effort le plus bas qui fera réellement le travail. Pas le plus élevé que vous pouvez vous offrir. Le plus bas qui fonctionne.
Habitude 4 : obligez-le à prouver son travail avant qu'il ne déclare quoi que ce soit « terminé »
Chaque modèle déclare parfois victoire sans l'avoir méritée — des tests « passés » qui n'ont jamais tourné, un correctif « appliqué » à un fichier qu'il avait mal lu, un résumé qui cite avec assurance une source qui dit l'inverse. Sur un modèle bon marché, c'est un désagrément. Sur Fable 5, c'est un désagrément que vous avez payé au prix fort, et pire, c'est le genre d'erreur qui vous coûte un second aller-retour cher pour l'attraper et la corriger.
Alors je moule la vérification dans l'instruction elle-même :
« Avant de me dire que c'est fait, vérifie. Lance les tests et montre-moi la sortie. Si tu ne peux pas vérifier une affirmation, dis-le clairement plutôt que de deviner — je préfère entendre "je n'ai pas pu confirmer le chemin de cache" qu'une réponse confiante qui se révèle fausse. »
Deux choses font que ça marche. D'abord, exiger des preuves — la sortie réelle d'une commande, la ligne précise que tu as changée, la citation de la source — pas un résumé de preuves. « Les tests passent » est une affirmation. La sortie collée du test runner est une preuve. Forcez la preuve.
Ensuite, et c'est la partie qui s'accorde magnifiquement avec le calibrage d'honnêteté de Fable 5 : donnez explicitement au modèle la permission de dire « je n'ai pas pu vérifier ça. » Les modèles Claude plus récents sont nettement meilleurs pour signaler la lisière de leur propre savoir quand vous les y invitez, et un honnête « je ne suis pas sûr de cette partie » vous épargne la découverte bien plus chère qu'il a inventé quelque chose et que vous l'avez livré. Un modèle qui admet le doute est moins cher qu'un modèle qui fabrique avec assurance, à chaque fois, sans exception.
Ce n'est pas spécifique à Fable — les boucles de vérification améliorent tous les modèles, et je dirais que c'est l'habitude la plus solide de toute cette liste. Mais elle a plus de valeur sur Fable 5 précisément parce que le coût d'une erreur non vérifiée y est plus élevé. Quand les erreurs sont chères, l'habitude qui attrape les erreurs tôt vaut le plus.
Si vous préférez que quelqu'un intègre ces boucles de vérification directement dans les agents et compétences de votre équipe — pour que l'étape « prouve-le » soit cuite dans le système au lieu d'être retapée à chaque prompt — c'est exactement le genre de mise en place que je prends en charge. Vous pouvez voir ce que j'ai construit sur fiverr.com/s/EgxYmWD.
Habitude 5 : arrêtez de demander à Fable 5 de montrer son raisonnement
Voici la boucle que j'ai ouverte en haut — l'unique habitude qui est réellement spécifique à ce modèle, et celle que je vois le plus souvent mal appliquée.
Arrêtez de mettre « explique ton raisonnement pas à pas », « détaille-moi ta réflexion » et « montre ta chaîne de pensée » dans vos prompts Fable 5. Pas parce que le conseil est mauvais en général — c'est un principe de prompt-craft solide depuis des années. Mais parce que sur Fable 5, après son retour, les demandes d'exposition du raisonnement peuvent déclencher le classifieur de sécurité.
Un peu de contexte sur le pourquoi. Fable 5 est revenu en ligne début juillet sous une couche de sécurité substantiellement resserrée, après toute la saga de contrôle à l'exportation que j'ai dépliée dans mon analyse du retour de Fable 5. Le nouveau classifieur a été construit pour couper une classe de jailbreak spécifique — et les articles sur le retour notent qu'il bloque la technique cible dans plus de 99 % des cas, au prix d'un taux de faux positifs plus élevé sur les requêtes ordinaires (TechTimes a couvert le comportement du nouveau classifieur). Les tentatives d'extraire les rouages internes du modèle se situent inconfortablement près des motifs de jailbreak sur lesquels le classifieur est calibré.
Quand une requête déclenche ce classifieur, Fable 5 ne refuse pas seulement. Il redirige la requête vers Opus 4.8. D'après les articles, vous êtes en général notifié quand ça arrive, et via l'API le modèle qui répond est visible si vous regardez — mais à l'intérieur d'une longue run d'agent, ou d'une session desktop bavarde, il est vraiment facile de louper la chose. Vous croyez obtenir le plafond de Fable 5. Vous obtenez discrètement un modèle différent.
L'économie de ce reroutage est une lame à double tranchant qu'il vaut la peine de comprendre. Quand vous êtes rebasculé vers Opus 4.8, vous payez le tarif plus bas d'Opus — donc une réponse dégradée vous coûte en fait moins. Ça ressemble à une victoire jusqu'à ce que vous vous rappeliez pourquoi vous avez tendu la main vers Fable 5 : vous vouliez son plafond sur un problème dur. Se faire refiler en silence un modèle moins capable sur la tâche exacte que vous payiez en premium pour clouer, ce n'est pas un rabais. C'est une chute de qualité que vous n'avez pas choisie et que vous risquez de ne pas voir.
La correction est simple et gratuite : retirez les demandes d'exposition du raisonnement de vos system prompts et user prompts Fable 5. Si vous avez vraiment besoin de voir la réflexion du modèle, c'est à ça que sert la sortie de vérification (Habitude 4) — demandez des preuves et des résultats, pas un processus de pensée exposé. Vous obtenez la même redevabilité sans agiter un chiffon rouge devant le classifieur. Je garde une version de mon system prompt pour Fable 5 avec tout le vocabulaire « explique ton raisonnement » nettoyé, et une autre pour les autres modèles où c'est encore très bien. Petit changement. C'est la différence entre faire tourner le modèle pour lequel vous payez et faire tourner un sosie.
Habitude 6 : dites moins, pas plus
La dernière habitude est celle qui relie les cinq autres, et c'est celle qui combat chaque instinct que l'ère Opus 4.7 avait ancré en nous.
Pendant des années, obtenir de la bonne sortie voulait dire plus — plus de règles, plus de garde-fous, plus de gestion explicite des cas limites, des system prompts de plus en plus longs empilant instruction sur instruction pour cerner le modèle. Fable 5 casse ce réflexe. Il est assez intelligent pour qu'un prompt serré et bien visé surperforme un règlement verbeux — et le règlement verbeux vous coûte des tokens d'entrée à chaque appel et invite le modèle à raisonner à travers toute cette instruction à 50 $ le million en sortie.
Comparez un avant-après réel tiré de mon propre pipeline de contenu. L'ancienne version, c'était une liste de quatorze lignes de règles sur le ton, la structure, ce qu'il faut éviter, comment formater, quand demander. La nouvelle version :
« Commence par le résultat. Reste simple et précis. Ne fais une pause pour me demander quelque chose que si le travail exige vraiment une décision que je n'ai pas prise. »
Trois phrases. Elle produit des brouillons plus nets que la version en quatorze lignes, parce que Fable 5 ne peinait pas à obéir aux règles — il était distrait par elles. Intelligence plus concision bat intelligence plus mur de contraintes.
Le piège, et c'est important pour ne pas contredire l'Habitude 1 : moins n'est pas la même chose que vague. L'Habitude 1 disait donnez-lui du contexte. L'Habitude 6 dit ne noyez pas ce contexte dans les règles. Ce n'est pas en tension — le contenu à haute valeur (le pourquoi, l'objectif, la barrière) reste ; le cérémonial à faible valeur (instructions évidentes, garde-fous redondants, sur-spécification défensive) s'en va. Vous coupez du lest, pas du signal.
C'est aussi ce qui fait que l'intégration serrée avec les skills et les fichiers de contexte fonctionne vraiment. Quand votre prompt est mince, le modèle a de la place pour s'appuyer sur votre system prompt, vos fichiers de contexte et vos skills au lieu de re-lire une instruction boursouflée à chaque tour. La concision au niveau du prompt est ce qui permet au niveau système de faire son travail — le même basculement que j'ai retracé quand le prompt engineering a cédé la place au loop engineering. Dites-en moins dans le prompt pour que l'architecture autour puisse en dire plus.
Là où les six habitudes atteignent leurs limites
J'ai passé tout cet article à vous tendre des habitudes, alors soyons droit sur les frictions, parce qu'une jolie liste en six étapes qui prétend n'avoir aucun inconvénient n'est qu'une pub.
Le reroutage est la chose à surveiller, et il est facile d'en perdre la trace. L'Habitude 5 désamorce le déclencheur d'exposition du raisonnement, mais le classifieur est calibré assez serré pour que du travail légitime — la sécurité défensive en particulier — puisse encore vous rebasculer vers Opus 4.8 sans signal éclatant. Si vous payez le tarif Fable 5 spécifiquement pour une tâche difficile, vérifiez réellement quel modèle a répondu. Si vous ne pouvez pas le savoir depuis votre surface, c'est une raison de faire tourner le travail Fable 5 à fort enjeu là où le modèle qui répond est visible.
La plupart de ces habitudes aident tous les modèles — et c'est le but, pas une faiblesse. Contexte, prompting négatif, vérification, concision : rien de tout ça n'est exclusif à Fable. Ce qui est spécifique à Fable, c'est combien c'est cher de les sauter ici. Le même prompt bâclé qui gaspille des centimes sur un modèle bon marché gaspille de l'argent réel sur Fable 5. Les habitudes ne changent pas. Les enjeux, si.
Le plus gros levier n'est pas une habitude de prompting du tout. C'est de ne pas utiliser Fable 5. Je le redis parce que c'est celui auquel les gens résistent : la juste quantité de Fable 5 dans votre workflow est petite. Routez les 85 à 95 % routiniers de votre travail vers Opus 4.8 et des modèles moins chers, et gardez Fable 5 pour les passes où son plafond change vraiment le résultat. La meilleure habitude de prompting Claude Fable 5, à la fin, c'est de savoir quand ne pas prompter Fable 5.
Comment j'incorpore ces six habitudes dans le système, pas dans le prompt
Les habitudes qu'on doit se rappeler sont des habitudes qu'on saute à 23 h un soir de deadline. Alors j'ai arrêté de compter sur ma mémoire et j'ai poussé les six vers la couche en dessous du prompt.
Trois endroits où elles vivent maintenant :
Dans le system prompt. Mon system prompt Fable 5 a les invariants cuits dedans : avance dès que tu en sais assez, vérifie avant de déclarer terminé, dis-le si tu ne peux pas confirmer quelque chose, et — le spécifique à Fable — zéro vocabulaire d'exposition du raisonnement où que ce soit. Je ne retape pas ça. C'est le plancher à partir duquel chaque prompt démarre.
Dans les skills. Pour les jobs répétables — une passe de code review, un résumé de recherche, un brouillon de contenu — la boucle de vérification et les barrières de prompting négatif vivent à l'intérieur de la définition du skill elle-même. Le skill est l'habitude, encodée une fois. Quand je l'invoque, le contrat « prouve ton travail, ne touche pas à ce que je n'ai pas nommé » vient avec, automatiquement. C'est la même architecture second-cerveau-plus-skills vers laquelle je bâtis dans mon système d'exploitation IA sur Claude Code.
Dans les valeurs par défaut d'effort par type de tâche. Plutôt que de choisir un niveau d'effort au feeling à chaque fois, je mappe les types de tâche aux niveaux une fois pour toutes et je laisse le routage suivre. Les skills routiniers défaillent en low ou medium ; les skills de passe profonde réservent high et au-dessus. La décision quitte l'instant et entre dans la conception.
Le gain, c'est que les erreurs coûteuses — le raisonnement qui s'emballe, le reroutage silencieux, la fabrication assurée, le prompt de quatorze lignes — cessent d'être des choses que je dois attraper en temps réel. Le système les attrape, parce que j'ai encodé l'attrapage une fois. C'est la vraie destination des six habitudes : pas de meilleurs prompts tapés par un humain discipliné, mais une configuration où la discipline est structurelle et où l'humain a le droit d'être un peu bâclé sans payer pour ça.
Le vrai coût d'un prompt Fable 5
Revenons à ce prompt de 41 mots du début. Le gaspillage n'était pas vraiment dans les 41 mots. C'était dans tout ce qu'ils avaient mis en mouvement : le raisonnement ouvert à 50 $ le million, la ligne « explique ton raisonnement » qui m'a peut-être fait basculer sur un autre modèle, l'initiative que je n'avais pas bornée, les règles que j'ai empilées à la place du contexte que j'aurais dû donner. Un prompt paresseux, quatre fuites distinctes.
Fable 5 est le modèle le plus capable que j'aie eu entre les mains, et il facture en conséquence. Cette combinaison fait que le prompting cesse d'être une soft skill et devient du contrôle de coût — la même instruction, formulée de deux manières, peut différer d'un ordre de grandeur dans ce qu'elle brûle et jusque dans le fait de tourner ou non sur le modèle que vous visiez. Les six habitudes ne consistent pas à extraire une meilleure phrase du modèle. Elles consistent à ne pas payer des tarifs premium pour votre propre imprécision.
Voici votre unique chose à faire aujourd'hui : prenez le prompt ou le system prompt que vous envoyez le plus souvent à Fable 5, et passez-le à travers les six. Ajoutez le pourquoi. Bornez ce que vous ne voulez pas. Dites-lui d'agir et de vérifier. Retirez chaque « explique ton raisonnement ». Puis coupez-le en deux. Envoyez les deux versions sur la même tâche et regardez le compteur de tokens. L'écart que vous verrez, c'est la taxe que vous payiez — et vous savez maintenant comment l'arrêter.
Foire aux questions
Pourquoi Claude Fable 5 est-il si cher à prompter ?
Claude Fable 5 coûte 10 $ par million de tokens d'entrée et 50 $ par million de tokens de sortie — à peu près le double d'Opus 4.8 — et son raisonnement interne est facturé comme de la sortie à ce même tarif de 50 $. Un prompt vague ou boursouflé fait raisonner le modèle davantage avant de répondre, donc un prompting imprécis gonfle directement le coût. Des prompts serrés et riches en contexte dépensent moins de ces tokens de raisonnement coûteux.
Les niveaux d'effort changent-ils le coût de Claude Fable 5 ?
Les niveaux d'effort ne changent pas le tarif au token — Fable 5 est à 10 $/50 $ à chaque niveau. Ce qu'ils changent, c'est combien de tokens le modèle dépense à réfléchir avant de répondre. Un effort plus élevé (xhigh, max) peut consommer bien plus de tokens que la sortie visible ne le laisse deviner, donc ajuster l'effort à la difficulté de la tâche est un levier de coût direct. Voir l'Habitude 3 ci-dessus pour la carte complète.
Pourquoi Claude Fable 5 bascule-t-il parfois sur Opus 4.8 ?
Le classifieur de sécurité resserré de Fable 5 redirige les requêtes signalées — y compris les tentatives d'exposition du raisonnement et certains travaux légitimes de sécurité défensive — vers Opus 4.8. Les articles disent que vous êtes en général notifié et que l'API montre le modèle qui répond, mais c'est facile à louper dans une longue session. Vous payez le tarif plus bas d'Opus quand vous êtes rétrogradé, mais vous perdez le plafond Fable 5 que vous payiez.
Devrais-je demander à Claude Fable 5 d'expliquer son raisonnement ?
Non — sur Fable 5 en particulier, les demandes du style « explique ton raisonnement » peuvent déclencher le classifieur de sécurité et vous faire rediriger vers Opus 4.8. Si vous voulez de la redevabilité, demandez des preuves de vérification (sortie de tests, changement exact, citations de sources) au lieu d'un processus de pensée exposé. Vous obtenez la même redevabilité sans le risque de reroutage. Voir l'Habitude 5 ci-dessus.
Quel pourcentage de mon travail devrait réellement tourner sur Claude Fable 5 ?
Dans mon propre routage, à peu près 5 à 15 % — les passes profondes où son plafond change vraiment le résultat. Routez les 85 à 95 % routiniers vers Opus 4.8 et des modèles moins chers. Utiliser Fable 5 comme cheval de labour quotidien, vu ses tarifs, est le moyen le plus rapide de vider un crédit pour une qualité dont vous n'aviez pas besoin sur la plupart des tâches.
Vous voulez la discipline de prompting intégrée d'usine ?
Ces six habitudes ne rapportent que si vous les faites réellement tourner, et à 23 h un soir de deadline personne ne le fait. Si vous préférez avoir les boucles de vérification, les barrières et l'hygiène de prompt sûre-pour-Fable-5 câblées dans les system prompts et les skills de votre équipe au lieu d'être retapées à chaque session, c'est le genre de mise en place que je prends en charge — voyez ce que je construis ici.