Was mich von Claude Opus 4.8 überzeugt hat, war nicht das Benchmark-Diagramm. Es war ein Refactoring, vor dem ich mich gedrückt hatte.
Ich hatte eine Laravel-Service-Klasse, die in vier Monaten Feature Creep zu einem 600-Zeilen-Monster herangewachsen war — die Sorte Datei, bei der man eine Methode ändert und drei unzusammenhängende Tests rot werden. Mit Opus 4.7 hatte ich zweimal versucht, das Modell den Knoten entwirren zu lassen. Beide Male gab es auf halber Strecke auf, erklärte die Aufgabe für "weitgehend abgeschlossen" und ließ mich mit einem halb extrahierten Trait und einer kaputten Test-Suite zurück. Typisch 4.7. Selbstbewusst, dann leise faul.
Am Morgen des 28. Mai, dem Tag an dem Claude Opus 4.8 erschien, richtete ich es auf dieselbe Datei. Gleicher Prompt. Gleiches Repo. Ich stellte das Effort Level auf max, drückte Enter und ging Kaffee kochen.
Als ich zurückkam, hatte es drei zusammenhängende Klassen extrahiert, die Bindings im Service Provider umgeschrieben, jeden Test aktualisiert, die Suite durchlaufen lassen, zwei echte Edge Cases gefunden die es eingebaut hatte, und sie behoben — ohne nachzufragen. Dann sagte es nüchtern: "Ich bin ziemlich sicher bei der Extraktion, aber ich habe die Caching-Schicht nicht angefasst, weil das ursprüngliche Verhalten dort mehrdeutig war und ich nicht raten wollte." Dieser letzte Satz ist die ganze Geschichte dieses Releases. Nicht nur, dass es die Aufgabe erledigt hat. Sondern dass es mir genau gesagt hat, wo es nicht Hand angelegt hat.
Ich fahre Opus 4.8 jetzt seit über einer Woche als meinen täglichen Begleiter — Kundenprojekte, die Content-Pipeline dieses Blogs, ein halb fertiges SaaS-Nebenprojekt. Dies ist das echte Urteil jenseits von Anthropics Diagramm, und die eine Einstellung, die entscheidet, ob man dieses Modell liebt oder verflucht.
Was Anthropic am 28. Mai tatsächlich veröffentlicht hat
Claude Opus 4.8 ging am 28. Mai 2026 live und baut direkt auf Opus 4.7 auf. Anthropics eigene Darstellung in der offiziellen Ankündigung ist ungewöhnlich zurückhaltend: Es baut auf 4.7 auf mit "schärferem Urteilsvermögen, mehr Ehrlichkeit über den eigenen Fortschritt und der Fähigkeit, länger eigenständig zu arbeiten als seine Vorgänger."
Zwei praktische Dinge sind wichtig, bevor wir uns dem Modell selbst widmen.
Erstens: Der Preis hat sich nicht verändert. Opus 4.8 wurde am selben Tag zum selben Token-Preis wie 4.7 veröffentlicht — 5 $ pro Million Input-Tokens und 25 $ pro Million Output-Tokens bei Standardgeschwindigkeit. Das klingt langweilig, bis man genug Modell-Launches erlebt hat, um das übliche Muster zu kennen: "Schlaueres Modell, dickere Rechnung." Diesmal nicht. Anthropic hat auch den schnellen Modus günstiger gemacht. Und es gibt einen stilleren Effizienzgewinn in der Dokumentation: High Effort auf 4.8 verbraucht ungefähr so viele Tokens bei einer Programmieraufgabe wie die alte xhigh-Einstellung auf 4.7 — bei höherer Punktzahl. Man bekommt mehr Denkleistung pro Token, nicht nur mehr Denkleistung pro Dollar.
Zweitens: Die Claude Code Rate Limits wurden erhöht. Anthropic hat die Limits speziell angehoben, um den höheren Token-Verbrauch bei den neuen Effort Levels aufzufangen — ein deutliches Signal dafür, wie dieses Modell gesteuert werden soll. Sie erwarten, dass man mehr Tokens für schwierige Aufgaben ausgibt. Sie haben den Spielraum eingebaut. Wer verfolgt hat, wie Anthropic die Claude Code Rate Limits Anfang des Jahres verdoppelte, sieht hier dieselbe Richtung: mehr Rechenleistung für die Leute, die tatsächlich damit bauen.
Die Überschrift lautet also nicht "Opus 4.8 ist ein bisschen schlauer." Sie lautet "Opus 4.8 ist schlauer, kostet dasselbe und gibt dir einen neuen Regler, um zu bestimmen, wie hart es denkt." Dieser Regler ist das ganze Spiel. Dazu kommen wir gleich. Zuerst das Diagramm, denn du hast es schon gesehen und hast Fragen.
Die Benchmark-Zahlen — einschließlich der einen, die es verliert
Hier ist der Vergleich, den Anthropic veröffentlicht hat, direkt aus der Ankündigung. Ich gebe die exakten Zahlen wieder, weil die Abstände mehr verraten als die Überschrift.
| Benchmark | Opus 4.8 | Opus 4.7 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| Agentisches Programmieren (SWE-Bench Pro) | 69,2 % | 64,3 % | 58,6 % | 54,2 % |
| Agentisches Terminal-Programmieren (Terminal-Bench 2.1) | 74,6 % | 66,1 % | 78,2 % | 70,3 % |
| Multidisziplinäres Reasoning (Humanity's Last Exam, ohne Tools) | 49,8 % | 46,9 % | 41,4 % | 44,4 % |
| Multidisziplinäres Reasoning (mit Tools) | 57,9 % | 54,7 % | 52,2 % | 51,4 % |
| Agentische Computernutzung (OSWorld-Verified) | 83,4 % | 82,8 % | 78,7 % | 76,2 % |
| Wissensarbeit (GDPval-AA) | 1890 | 1753 | 1769 | 1314 |
| Agentische Finanzanalyse (Finance Agent v2) | 53,9 % | 51,5 % | 51,8 % | 43,0 % |
Schau dir den SWE-Bench Pro-Sprung an: 64,3 % auf 69,2 %. Fast fünf Punkte agentischer Programmiergewinn in einem Punkt-Release, während GPT-5.5 bei 58,6 % verharrt und Gemini 3.1 Pro mit 54,2 % hinterherhinkt. Das ist kein Rundungsfehler. Das ist der Unterschied zwischen einem Modell, das eine Mehrfach-Datei-Änderung abschließt, und einem, das stecken bleibt.
Die Reasoning-Zahlen bewegen sich in dieselbe Richtung. Humanity's Last Exam ohne Tools klettert von 46,9 % auf 49,8 %, und mit Tools auf 57,9 % — beides klare Führungspositionen. Wissensarbeit auf GDPval-AA springt von 1753 auf 1890, was auf dieser Skala ein bedeutsamer Vorsprung gegenüber GPT-5.5s 1769 ist und meilenweit vor Geminis 1314 liegt.
Jetzt der ehrliche Teil. Opus 4.8 gewinnt nicht überall.
Beim agentischen Terminal-Programmieren — Terminal-Bench 2.1 — gewinnt GPT-5.5 immer noch, 78,2 % gegenüber 74,6 %. Das ist ein echter Verlust, keine Schwankungsbreite, und ich würde lügen, wenn ich es anders darstellen würde. Wenn dein Workflow stark terminal-lastig ist — lange Ketten von Shell-Befehlen, CI-Orchestrierung, rohe Bash-agentische Schleifen — haben GPT-5.5 und Codex dort immer noch einen Vorsprung. Ich habe beide ein paar Tage parallel auf demselben Repo laufen lassen, und der Unterschied ist sichtbar: Codex ist einfach etwas trittsicherer, wenn die gesamte Aufgabe im Terminal lebt. Ich habe bereits über das parallele Arbeiten mit Claude Code und Codex im selben Repo geschrieben, und 4.8 verkleinert diese Terminal-Lücke gegenüber 4.7 (66,1 %) — schließt sie aber nicht.
Wenn du also hierher gekommen bist für "Opus 4.8 zerstört alles" — das ist nicht die Wahrheit. Die Wahrheit: Es führt in sechs von sieben Kategorien, oft mit großem Abstand, und verliert eine — Terminal-Programmierung — an GPT-5.5. Behalte dieses Sternchen im Kopf. Es wird wichtig, wenn wir darüber sprechen, zu welchem Modell man wann greift.
Aber hier ist das, was das Diagramm dir nicht zeigen kann. Keine dieser Zahlen bedeutet etwas, bis du den Hebel verstehst, der sie steuert.
Effort Levels: Die Einstellung, die alles entscheidet
Das Aushängeschild von Opus 4.8 ist kein Benchmark. Es ist ein Schieberegler.
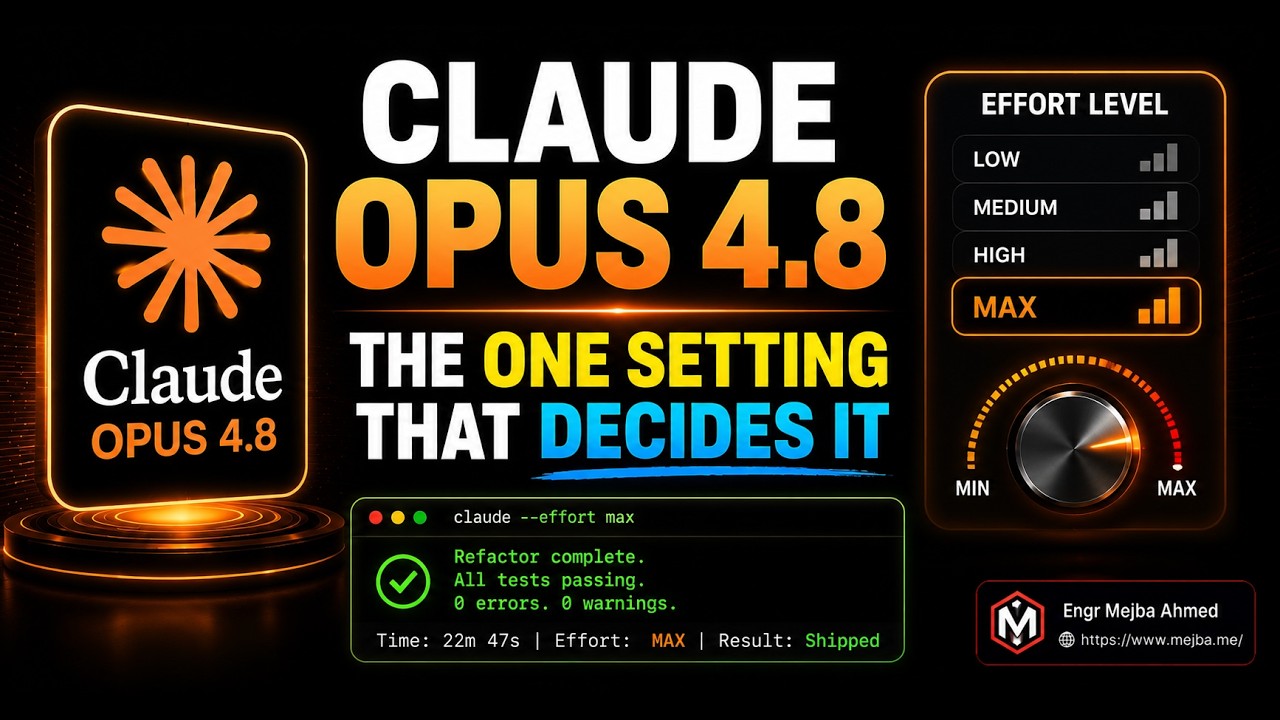
In Claude Code kann man jetzt das Effort Level des Modells über fünf Stufen einstellen: low → medium → high (Standard) → max → ultra. Das ist das Allerwichtigste, was man über dieses Release verstehen muss, denn es ist der Unterschied zwischen dem Modell, das mein Refactoring bravourös gemeistert hat, und dem Modell, das es verpatzt hätte.
So verhalten sich die Stufen in der Praxis:
| Effort | Was es tut | Token-Kosten | Geschwindigkeit |
|---|---|---|---|
| Low | Schnelle, leichtgewichtige Antworten | Niedrig | Schnell |
| Medium | Ausgewogen, mittlere Komplexität | Moderat | Moderat |
| High (Standard) | Balance Qualität/Ressourcen | Hoch | Moderat–langsam |
| Max | Für wirklich komplexe Aufgaben gebaut | Sehr hoch | Langsamer |
| Ultra | Max Effort plus dynamische Workflows für Arbeit im großen Maßstab | Am höchsten | Am langsamsten |
Das mentale Modell, das bei mir geklickt hat: Effort Level ist ein Denkbudget. Dreh es hoch und das Modell denkt intensiver, hält mehr Kontext im Arbeitsgedächtnis und kämpft sich durch Aufgaben, die es sonst aufgeben würde. Dreh es runter und du bekommst schnelle, günstige Antworten, die für eine Abfrage völlig ausreichen, aber bei einem echten Refactoring zusammenbrechen.
Ein Hinweis zur Namensgebung, weil es mich verwirrt hat und es wird dich auch verwirren. Anthropics eigene Dokumentation beschreibt die zugrunde liegenden Reasoning-Stufen als low, high (Standard) und eine oberste "extra"/xhigh-Einstellung — und in Claude Code wird die oberste Stufe als ultracode angezeigt, das xhigh-Reasoning mit automatischer Workflow-Orchestrierung kombiniert. Das Fünf-Stufen-Schieberegler-Modell (low / medium / high / max / ultra) ist das sauberere mentale Modell für den täglichen Einsatz, und so bespreche ich es hier, aber wenn du in der offiziellen Ankündigung gräbst und "xhigh" und "ultracode" findest, ist das derselbe Spitzengang unter einem anderen Etikett. Lass dich vom Vokabular nicht verwirren — es ist alles derselbe Regler.
Die oberste Stufe verdient ihren eigenen Absatz. Ultra (auch bekannt als ultracode in Claude Code) ist Max Effort plus dynamische Workflows, bei denen das Modell die Arbeit plant und dann parallele Sub-Agenten hochfährt, um großangelegte Probleme eigenständig abzuarbeiten. Das ist der Teil, der mich wirklich überrascht hat: Dynamische Workflows können bis zu 1.000 parallele Sub-Agenten in einer einzigen Sitzung orchestrieren (das ist die harte Obergrenze, die Anthropic gesetzt hat), und auf 4.8 laufen diese Agenten länger, bevor sie aufgeben. Stell dir vor: "Schreibe dieses Modul um, migriere die Tests, aktualisiere die Dokumentation und verifiziere den Build" als eine einzelne Anweisung, wobei das Modell seinen eigenen Orchestrierungsplan schreibt und die Teilaufgaben sequenziert, anstatt darauf zu warten, dass du jede einzelne vorkaust. Es verifiziert dann seine eigenen Outputs, bevor es zurückmeldet. Es ist der geistige Nachfolger der zielorientierten Arbeit, die ich beschrieben habe, als die /for- und /goal-Befehle meinen Claude Code-Workflow verändert haben — nur dass die Orchestrierung jetzt die Aufgabe des Modells ist, kein Befehl, den man draufschraubt. Wissenswert: Dynamische Workflows sind als Research Preview erschienen, also erwarte gelegentlich raue Kanten auf dieser Stufe.
Hier ist die Falle, und ich bin am ersten Tag hineingetappt. Der Standard ist high, und der Standard ist falsch für die Hälfte deiner Aufgaben. Zu niedrig, und das Modell bricht vorzeitig ab oder denkt oberflächlich — genau die 4.7-Faulheit, über die alle klagten, nur dass es jetzt eine Einstellung ist, die du gewählt hast, kein Defekt, den du geerbt hast. Zu hoch, und das Modell überdenkt eine einzeilige Config-Abfrage, verbrennt 8.000 Tokens und braucht 40 Sekunden, um dir etwas zu sagen, das ein grep im Handumdrehen beantwortet hätte.
Die Kunst ist nicht, die höchste Stufe zu wählen. Die Kunst ist, Effort an Aufgabenkomplexität anzupassen. Das ist das ganze Spiel. Gleich werden wir taktisch.
Wie sich Opus 4.8 anders verhält — jenseits des Schiebereglers
Die Effort Levels bekommen die Schlagzeilen, aber das zugrunde liegende Verhalten des Modells hat sich auf Weisen verändert, die im täglichen Einsatz genauso wichtig sind. Nach einer Woche fallen vier Verschiebungen auf.
Es denkt nach, bevor es nach Tools greift. Das ist die große Sache. Opus 4.7 hatte einen lockeren Abzugsfinger — es feuerte einen Tool-Aufruf ab oder startete einen Sub-Agenten, bevor es überhaupt darüber nachgedacht hatte, ob das nötig war. 4.8 versucht das Problem zuerst intern zu lösen und ruft nur Tools oder Sub-Agenten auf, wenn Denken allein nicht reicht. In der Praxis bedeutet das weniger sinnlose Tool-Aufrufe, weniger halbgare Sub-Agenten-Starts und ein Modell, das sich anfühlt, als würde es denken statt um sich schlagen.
Es kalibriert die Antwortlänge auf die Aufgabe. Stell 4.8 eine schnelle Faktenfrage und du bekommst eine kurze Antwort. Bitte es, eine Architekturentscheidung zu analysieren, und du bekommst die Tiefe, die die Frage verdient. 4.7 hatte einen Lautstärkeregler, festgestellt auf "geschwätzig." 4.8 liest den Raum.
Es ist ehrlicher über den eigenen Fortschritt. Anthropic hat ausdrücklich darauf hingetrimmt, und die Zahlen bestätigen es — sie dokumentierten eine etwa vierfache Reduktion nicht gemeldeter Code-Fehler, was bedeutet, dass 4.8 weit weniger dazu neigt, leise einen Bug auszuliefern und die Aufgabe als erledigt zu betrachten. Weniger falsche "Fertig!"-Meldungen. Weniger Phantom-Fertigstellungen, bei denen das Modell schwört, die Tests bestehen, obwohl sie es nicht tun. Die Refactoring-Geschichte vom Anfang dieses Beitrags ist das Paradebeispiel — es hat mir gesagt, was es nicht angefasst hat und warum. Das ist das größte Vertrauens-Upgrade in diesem Release, und es ist die Art von Sache, die keine Benchmark-Überschrift einfängt.
Der Tonfall ist wärmer geworden. Opus 4.7 hatte einen Hauch von dem, was die Community wohlwollend "Sass" nannte — eine leicht starre, gelegentlich widerspenstige Kante, plus übertriebene Sicherheitsvorkehrungen, die es bei völlig vernünftigen Anfragen ablehnen oder ausweichen ließen. 4.8 ist kooperativer. Wärmer. Es widerspricht, wenn es sollte, aber es hält keine Vorträge. Wenn du wegen der Attitüde von 4.7 abgesprungen bist, könnte allein das reichen, um dich zurückzuholen.
Es gibt eine stillere Verschiebung unter allen vieren, und es ist die, auf die Anthropic am stärksten gesetzt hat: Zielorientierung ist jetzt eine Kerneigenschaft, kein Pflaster. Bei 4.7 erforderte es bewusstes Prompting und die richtigen Befehle, um das Modell dazu zu bringen, auf ein Ergebnis hinzuarbeiten — anstatt nur den wörtlichen Text der letzten Nachricht zu befriedigen. 4.8 hält das Ziel über eine lange Aufgabe hinweg und steuert darauf hin. Wenn es an einer mehrdeutigen Weggabelung ankommt, stellt es eine schärfere Frage, anstatt zu raten oder zu stocken. Bei einem 40-minütigen autonomen Lauf ist das der Unterschied zwischen der Rückkehr zu fertigem Werk und der Rückkehr zu einer höflichen Ausrede. Es bewirkt auch, dass 4.8 weniger Fragen stellt als 4.7 — aber die Fragen, die es stellt, sind die, die die Arbeit tatsächlich entblockieren.
Stapele diese vier mit dem Effort-Schieberegler übereinander und du bekommst ein Modell, das nicht nur höher punktet — es fühlt sich grundlegend mehr wie ein Teamkollege an und weniger wie ein Werkzeug, mit dem man ringen muss. Was uns zu dem Teil bringt, für den du eigentlich gekommen bist: Wie man es fährt.
Wie ich Opus 4.8 tatsächlich konfiguriere (Schritt für Schritt)
Benchmarks sind Theorie. Hier ist die praktische Konfiguration, auf die ich nach einer Woche Trial and Error gekommen bin. Übernimm sie und passe sie dann an deine eigene Arbeit an.
Schritt 1: Hör auf, das Standard-Effort-Level zu akzeptieren
Das Erste, was ich falsch gemacht habe, war alles auf high zu lassen und mich zu wundern, warum einfache Aufgaben sich träge und teuer anfühlten. Tu das nicht. Stell dir vor jeder Aufgabe eine Frage: Wie schwierig ist das wirklich?
- Etwas nachschlagen, eine Variable umbenennen, ein schnelles "Wo ist X definiert?" → low. Es antwortet in Sekunden für einen Bruchteil der Tokens.
- Eine fokussierte Funktion schreiben, eine Einzeldatei-Änderung, ein normaler Bugfix → medium.
- Echte Feature-Arbeit, Änderungen über mehrere Dateien, alles, wo man möchte, dass ein Kollege wirklich mitdenkt → high (der Standard verdient hier seinen Platz).
- Knifflige Refactorings, Architekturentscheidungen, Debugging von etwas wirklich Subtilelem → max.
- "Migriere dieses ganze Modul und verifiziere es" — Arbeit im großen Maßstab, wo das Modell Teilaufgaben planen und sequenzieren soll → ultra mit dynamischen Workflows.
Profi-Tipp: Ich habe eine Haftnotiz an meinem Bildschirm kleben, auf der nur steht: "Passe den Regler an die Schwierigkeit an." Es ist dumm, und es hat mir mehr Tokens gespart als jeder clevere Prompt.
Schritt 2: Sag dem Modell, was es TUN soll, nicht was es NICHT tun soll
Das ist kein neuer Rat, aber er ist mit 4.8 wichtiger, weil das Modell so viel besser darin ist, positive Anweisungen zu befolgen. Statt "Mach die bestehenden Tests nicht kaputt" schreib "Halte jeden bestehenden Test grün und füge neue hinzu für jedes Verhalten, das du änderst." Positives Framing gibt dem Modell ein Ziel zum Anvisieren statt ein Minenfeld zum Durchnavigieren. Der Unterschied in der Output-Qualität ist real und konsistent.
Schritt 3: Gib ihm das Warum hinter deinen Anweisungen
Die einzige Prompting-Änderung mit dem größten Hebel, die ich für 4.8 gemacht habe: Erkläre die Begründung. Sag nicht nur "Verwende hier das Repository Pattern." Sag "Verwende hier das Repository Pattern, weil wir nächsten Sprint die Datenquelle von MySQL auf eine externe API umstellen werden und ich möchte, dass der aufrufende Code dabei unverändert bleibt."
Wenn 4.8 das Warum versteht, springen sowohl die Befolgung als auch das Urteilsvermögen nach oben. Es trifft bessere Entscheidungen in den Lücken, die deine Anweisungen nicht abdeckten, weil es auf dein tatsächliches Ziel hin reasoning statt deine wörtlichen Worte per Pattern Matching abzuarbeiten. Das passt perfekt zum Verhaltens-Shift "denkt nach, bevor es handelt" — gib ihm gutes Denkmaterial und es denkt gut.
Schritt 4: Behalte deine Tokens im Auge, besonders auf max und ultra
Höherer Effort bedeutet mehr Tokens. So ist der Deal. Die erhöhten Rate Limits geben dir Spielraum, aber Spielraum ist nicht unendlich. Lass einen Token-Tracker laufen, damit du siehst, was max und ultra dich bei echten Aufgaben tatsächlich kosten. Das erste Mal, als ich eine volle Ultra-Dynamik-Workflow-Migration laufen ließ, beobachtete ich den Zähler und kalibrierte sofort nach — ein Teil der Arbeit brauchte kein ultra, sondern max mit einem strafferen Prompt. Wenn es dir mit den Kosten ernst ist, gelten meine vollständigen Claude Code Token Management Hacks weiterhin, und sie gelten stärker, jetzt wo du einen Regler hast, der leise dein Budget verbrennen kann.
Schritt 5: Teste, statt davon auszugehen, dass das Upgrade hilft
Hier ist die unbequeme Wahrheit, die niemand in Launch-Day-Posts schreibt: Ein neueres Modell garantiert keine besseren Ergebnisse für deinen Anwendungsfall. Opus 4.8 ist insgesamt ein klarer Schritt nach vorne. Aber ich habe eine spezifische Content-Formatierungsaufgabe, bei der die 4.7-Ausgabe für meine Pipeline tatsächlich sauberer war, und ich habe diesen einen Prompt auf die alte Weise getunt gelassen, bis ich ihn ordentlich nachgetestet hatte.
Lass deine echten Workflows laufen. Vergleiche. Passe an. Das Modell ist ein Ausgangspunkt, keine fertige Antwort.
Wenn du lieber jemanden hättest, der diesen ganzen Effort-Level-Workflow für den Stack deines Teams einrichtet und abstimmt, anstatt es auf die harte Tour zu lernen — das ist genau die Art von Arbeit, die ich übernehme. Du kannst sehen, was ich gebaut habe, auf fiverr.com/s/EgxYmWD.
Das ehrliche Fazit: Die meisten "Modellfehler" sind deine Schuld
Lass mich das sagen, was manche Leute ärgern wird. Nach einer Woche mit Opus 4.8 und Jahren täglicher Arbeit mit diesen Modellen bin ich überzeugt, dass die Mehrzahl der "das Modell ist dumm / faul / hat meinen Code kaputt gemacht"-Beschwerden keine Modellfehler sind. Es sind Prompting- und Konfigurationsfehler auf Benutzerseite.
Ich habe es in Echtzeit erlebt während der 4.7-Ära. Leute ließen das Modell auf aggressiven Standardeinstellungen, gaben ihm vage Einzeiler ohne Begründung, ohne Kontext, ohne klares Ziel und posteten dann Screenshots mit Beschwerden, das Modell habe "aufgegeben." Das Modell hat nicht aufgegeben. Es hat genau das getan, was eine unterspezifizierte Anweisung auf dem falschen Effort Level produziert.
Opus 4.8 macht das noch deutlicher, weil das Effort Level jetzt in deinen Händen liegt. Wenn du ein schwieriges Refactoring auf Low Effort laufen lässt, wird das Modell vorzeitig abbrechen — und das ist keine Faulheit, das bist du, der ihm sagt, es solle oberflächlich denken. Wenn du eine triviale Abfrage auf Ultra laufen lässt, wird es überdenken und Tokens verbrennen — und das ist kein Aufblähen, das bist du, der den Regler über das hinausdreht, was die Aufgabe braucht.
Ich nehme Anthropic nicht komplett aus der Verantwortung. Der frühe Rollout hatte Bugs — ein paar Leute hatten in den ersten 48 Stunden instabiles Verhalten, und ich habe selbst eine seltsame Sub-Agenten-Schleife erwischt, bevor es sich stabilisierte. Die Stimmung in der Community ist gemischt-aber-positiv, was ehrlich ist: Die Leute lieben das Programmieren und den wärmeren Kollaborationsstil, manche sind auf raue Kanten beim Rollout gestoßen. Anthropic iteriert auf Basis von Nutzer-Feedback und Logs, also glätten sich die rauen Stellen typischerweise innerhalb von Tagen. Das war das Muster durch 4.6 und 4.7 hindurch.
Aber die dauerhafte Lektion bleibt: Das Modell ist leistungsfähiger, als deine Standardeinstellungen es sein lassen. Repariere die Standardeinstellungen, bevor du dem Modell die Schuld gibst. Diese eine Denkweise-Verschiebung wird mehr für deine Ergebnisse tun als auf 4.9 zu warten.
Was ich im täglichen Einsatz tatsächlich sehe
Ich werde keine genauen Zahlen erfinden, die ich nicht belegen kann — das ist ein sicherer Weg, dein Vertrauen zu verlieren. Aber ich kann dir die konsistenten Muster aus einer Woche echter Arbeit über Kunden-Repos, meine Content-Pipeline und ein Nebenprojekt hinweg nennen.
Bei agentischen Programmieraufgaben ist der Unterschied zwischen 4.7 und 4.8 am deutlichsten bei langen Aufgaben. Die Art von Mehrfach-Datei-Refactoring, das 4.7 zu zwei Dritteln aufgegeben hätte, bringt 4.8 zu Ende — und das deckt sich genau mit dem SWE-Bench Pro-Sprung von 64,3 % auf 69,2 %. Die anhaltende Autonomie ist in der Praxis die Hauptnummer. Es macht einfach weiter, wo 4.7 aufgehört hat.
Token-Effizienz ist der Punkt, den ich am genauesten beobachte. Anthropic behauptet Verbesserung, und das "denkt nach, bevor es zu Tools greift"-Verhalten sollte weniger sinnlose Tool-Aufrufe bedeuten. In meiner Nutzung stimmt das im Großen und Ganzen — weniger Müll-Tool-Aufrufe auf Medium und High Effort. Aber Max und Ultra sind wirklich teuer, und das ist keine Regression, das ist das Design. Effizienzgewinne am unteren bis mittleren Ende, bewusste Ausgaben am oberen Ende. Überprüfe es an deinen eigenen Workloads, bevor du irgendeiner pauschalen "es ist günstiger"-Behauptung vertraust, einschließlich meiner.
Die Ehrlichkeitsverbesserung ist die, die leise verändert hat, wie ich arbeite. Weil 4.8 zuverlässiger markiert, was es nicht fertiggestellt hat oder wobei es sich nicht sicher war, verbringe ich weniger Zeit mit dem Doppelprüfen von Phantom-Fertigstellungen. Das ist eine echte Zeitersparnis, die auf keinem Diagramm auftaucht — und über eine Woche täglicher Nutzung summiert sie sich zu einem Modell, das sich auf eine Weise vertrauenswürdig anfühlt, die 4.7 nie ganz geschafft hat. Für das größere Bild, wie sich die Standards über diese Releases verschoben haben, setzt meine frühere Claude Opus 4.7 Analyse immer noch die Basislinie, auf der 4.8 aufbaut.
Die Erwartung, die du setzen solltest: Das ist ein echter Schritt nach vorne, aber das Upgrade, das du spürst, ist proportional dazu, wie gut du es fährst. Lass es auf Autopilot und du bekommst ein etwas-besseres-4.7. Stimme die Effort Levels auf deine Aufgaben ab und du bekommst ein Modell, das Arbeit erledigt, die das alte nicht konnte.
Solltest du wechseln? Meine klare Antwort
Wenn du bereits auf Opus 4.7 in Claude Code bist: Ja, wechsle jetzt. Gleicher Preis, echte Verbesserungen, und der Effort-Schieberegler allein ist den Umstieg wert. Es gibt keinen Grund, auf 4.7 zu bleiben außer Trägheit.
Wenn du im Terminal lebst — schwere Bash-Ketten, CI-Orchestrierung, rohe Shell-agentische Schleifen: Sei dir bewusst, dass GPT-5.5 beim Terminal-Programmieren mit 78,2 % gegenüber 74,6 % immer noch gewinnt. Für diese spezifische Arbeit behalte Codex in deiner Werkzeugkiste. Für alles andere ist Opus 4.8 mit weitem Abstand die stärkere Wahl. Beide zu nutzen ist kein Absichern — es ist einfach das richtige Werkzeug für die richtige Aufgabe zu verwenden, dieselbe Schlussfolgerung, die ich gezogen habe, als ich GPT-5.5 und Opus 4.7 an identischem Code verglichen habe.
Wenn du neu in all dem bist: Fang mit Opus 4.8 an, lass es auf high und fang erst an, am Effort-Schieberegler zu drehen, wenn du gespürt hast, wo high über- und unterschießt. Der Regler ist mächtig, aber du musst ein Gefühl dafür entwickeln.
Häufig gestellte Fragen
Was sind Effort Levels in Claude Opus 4.8?
Effort Levels sind ein steuerbares Denkbudget in Claude Code mit fünf Einstellungen: low, medium, high (der Standard), max und ultra. Höherer Effort bedeutet tieferes Reasoning, mehr Tokens und langsamere Antworten; niedrigerer Effort bedeutet schnellere, günstigere, oberflächlichere Ausgabe. Passe das Level an die Komplexität deiner Aufgabe an. Siehe "Effort Levels: Die Einstellung, die alles entscheidet" oben für die vollständige Aufschlüsselung.
Ist Claude Opus 4.8 besser als GPT-5.5?
Opus 4.8 führt in sechs von sieben veröffentlichten Benchmarks, einschließlich agentischem Programmieren (69,2 % vs. 58,6 % auf SWE-Bench Pro) und Reasoning. GPT-5.5 gewinnt immer noch beim agentischen Terminal-Programmieren, 78,2 % gegenüber 74,6 %. Für die meisten Programmier- und Reasoning-Aufgaben ist Opus 4.8 stärker; für terminal-intensive Workflows behält GPT-5.5 einen Vorsprung.
Kostet Claude Opus 4.8 mehr als Opus 4.7?
Nein. Opus 4.8 wurde am 28. Mai 2026 zum selben Token-Preis wie Opus 4.7 veröffentlicht. Anthropic hat auch die Claude Code Rate Limits erhöht, um den höheren Token-Verbrauch bei den neuen Effort Levels aufzufangen. Beachte, dass Max- und Ultra-Effort-Levels deutlich mehr Tokens pro Aufgabe verbrauchen.
Was sind dynamische Workflows in Claude Code?
Dynamische Workflows sind eine Claude Code-Funktion, die auf der Ultra-Effort-Stufe aktiviert wird und bei der Opus 4.8 mehrere Schritte und Teilaufgaben plant und orchestriert, um großangelegte Probleme autonom zu lösen. Statt dass du jeden Schritt sequenziell steuerst, zerlegt das Modell die Aufgabe und arbeitet sie eigenständig ab.
Sollte ich immer die höchste Effort-Stufe verwenden?
Nein — das ist der häufigste Fehler. Max und ultra überdenken einfache Aufgaben und verbrennen unnötig Tokens, während Low Effort bei schwieriger Arbeit vorzeitigen Abbruch verursacht. Die Kunst ist, Effort an Aufgabenschwierigkeit anzupassen: low für Abfragen, high für echte Feature-Arbeit, max für knifflige Refactorings, ultra für großangelegte autonome Aufgaben.
Das Refactoring, das mich überzeugt hat
Erinnerst du dich an das 600-Zeilen-Laravel-Monster vom Anfang dieses Beitrags? Es läuft jetzt seit sechs Tagen in Produktion. Drei saubere Klassen, volle Testabdeckung, und die Caching-Schicht, die Opus 4.8 bewusst nicht angefasst hat — weil es mir sagte, es sei sich nicht sicher — stellte sich als eine Feinheit heraus, die ich selbst vergessen hatte. Hätte das Modell sie "selbstbewusst" umgeschrieben, wie 4.7 es getan hätte, hätte es einen Bug ausgeliefert.
Das ist das echte Upgrade. Nicht die fünf Punkte auf SWE-Bench Pro. Nicht der wärmere Ton. Es ist ein Modell, das die Grenze seiner eigenen Kompetenz kennt und dir sagt, wo sie liegt. Koppele diese Ehrlichkeit mit einem Effort-Schieberegler, den du tatsächlich zu bedienen weißt, und du hast das erste Claude, das sich weniger wie ein Werkzeug anfühlt, das du beaufsichtigen musst, und mehr wie ein Kollege, dem du vertraust.
Also hier ist dein eines To-do für die nächsten 24 Stunden: Öffne Claude Code, nimm dir die schwierigste Aufgabe auf deinem Tisch heute vor, stelle das Effort Level auf max und gib ihm das Warum hinter dem, was du fragst. Dann beobachte, was passiert, wenn du aufhörst, gegen die Standardeinstellungen zu kämpfen, und anfängst, das Modell mit Absicht zu fahren.
Lass uns zusammenarbeiten
Du willst KI-Systeme aufbauen, Workflows automatisieren oder deine Tech-Infrastruktur skalieren? Ich helfe gern.
- Fiverr (Individuallösungen & Integrationen): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (Enterprise-Lösungen): ramlit.com
- ColorPark (Design & Branding): colorpark.io
- xCyberSecurity (Sicherheitsdienstleistungen): xcybersecurity.io