De prompt was twaalf woorden lang. "Bouw een compleet pitchdeck voor investeerders voor een AI-merkmonitor SaaS."
Ik drukte op binnen via een zwart terminalvenster, liep naar de keuken, zette koffie en kwam terug. Vijftien minuten later zat er een volledig ontworpen PDF in mijn uitvoermap. Afdekschuif. Probleemstelling. Marktomvang met een echt TAM/SAM/SOM-diagram dat werkelijke cijfers uit een concurrentieanalyse haalde. Een productoverzicht met mockups. Een go-to-market-dia. Prijsniveaus. Een oprichterssectie. Een afsluitende vraag. Achttien dia's, ontworpen - niet "hier is een lijst met opsommingstekens, u kunt deze zelf in Google Presentaties plakken." Een afgerond ding.
De eerste keer dat ik zes maanden geleden dezelfde prompt uitvoerde op een enkele Claude Code-agent, kreeg ik een prijsverlagingsoverzicht terug. Een goede schets. Maar een schets. De mentale kloof tussen "Ik zal je de inhoud van het kaartspel schrijven" en "hier is een kaartspel" is de kloof waar ik al twee jaar op wachtte tot iemand deze zou dichten in de open-sourcewereld.
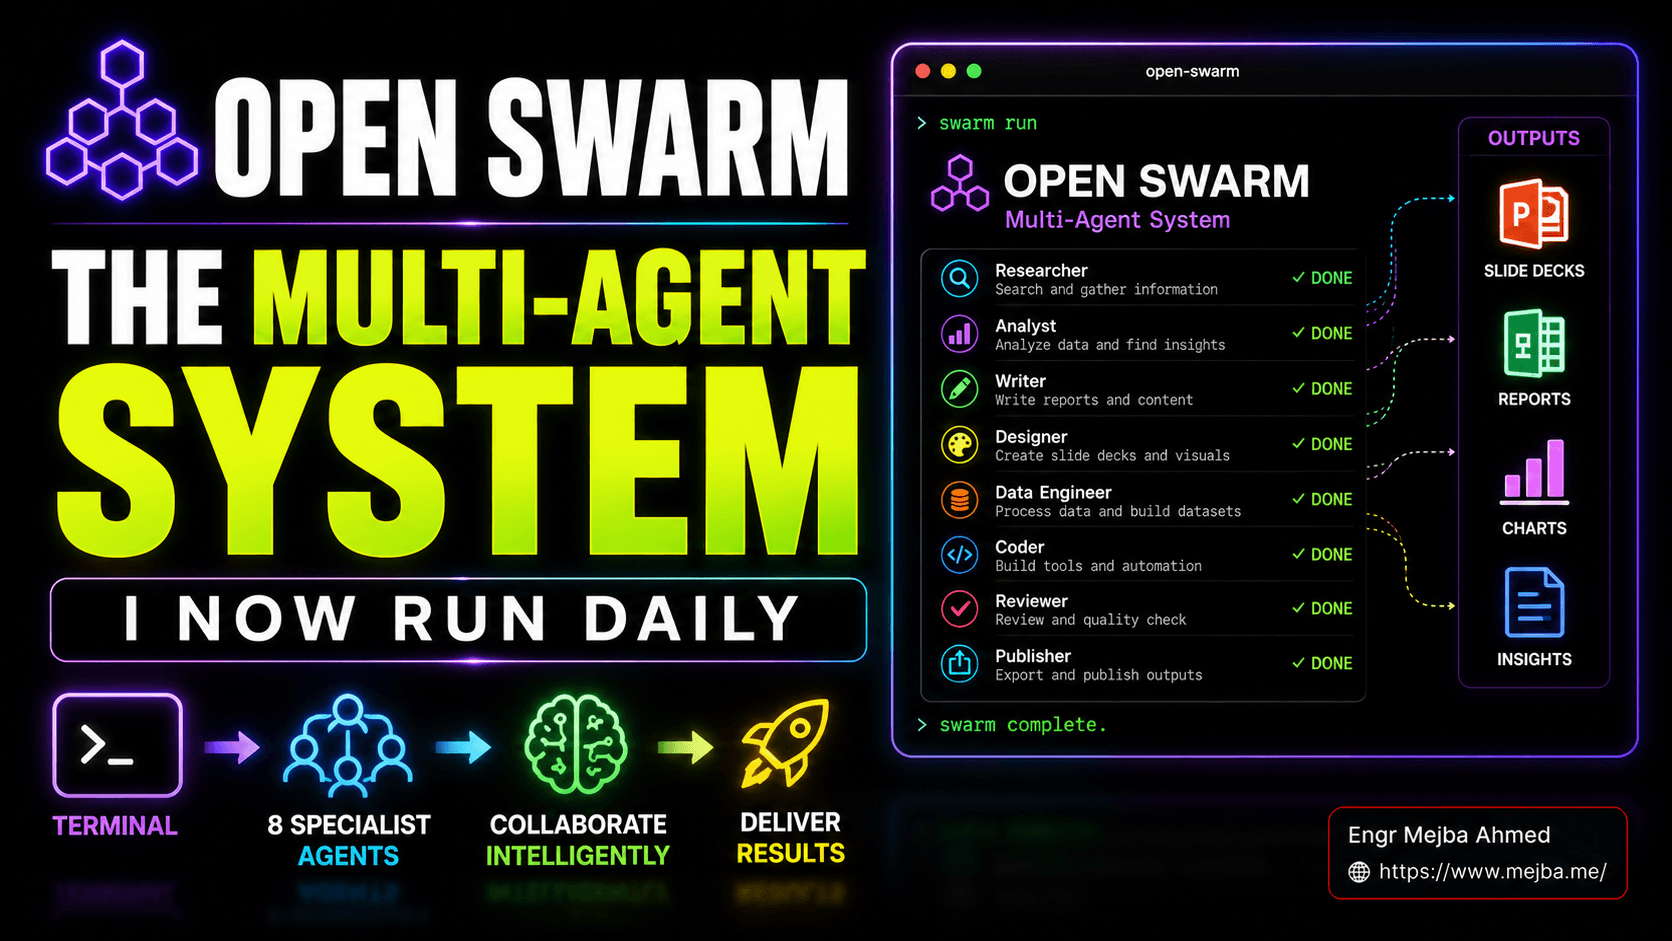
Het ding dat het voor mij sloot, heet Open Swarm. Het is een open-source multi-agentsysteem van VRSEN – hetzelfde team achter Agency Swarm – dat in uw terminal woont, acht gespecialiseerde agenten onder één orkestrator beheert en echte resultaten (diadecks, onderzoeksrapporten, grafieken, documenten, afbeeldingen, video) produceert vanuit één enkele prompt. De slogan van de repository luidt: "Claude Code voor alles behalve codering." Dat is nauwkeurig. Het ondermijnt ook enigszins wat hier feitelijk gebeurt.
Ik gebruik het nu al bijna twee weken in mijn dagelijkse contentpijplijn. Laat me je vertellen wat werkt en wat niet, en waarom ik denk dat dit het meest interessante is wat er momenteel gebeurt in de open source-agentwereld.
Wat Open Swarm eigenlijk is
Haal de marketingtaal weg en Open Swarm bestaat uit drie dingen die op elkaar zijn gestapeld.
Onderaan staat OpenCode – de open-source terminal AI-coderingsagent met ongeveer 150.000 GitHub-sterren, meer dan 850 bijdragers en een geïnstalleerde basis van miljoenen ontwikkelaars. OpenCode zelf is een TUI geschreven bovenop Bubble Tea, multi-provider, model-agnostisch. Als je Claude Code hebt gebruikt, ziet en voelt OpenCode eruit als zijn broer of zus. Dezelfde toetsenbord-eerst-sfeer, dezelfde aanhoudende sessie, dezelfde filosofie van "uw project leeft in de huidige map".
In het midden bevindt zich Agency Swarm, ook van VRSEN – een multi-agent orkestratieframework dat de OpenAI Agents SDK uitbreidt om u betrouwbare communicatiestromen, gestructureerde overdrachten tussen specialisten en provider-flexibele uitvoering te bieden (Anthropic, OpenAI, Gemini, Grok, alles wat LiteLLM-routeerbaar is). Agentschap Swarm is al een tijdje in productie bij de klanten van VRSEN; het is de motor die ervoor zorgt dat de agenten niet langs elkaar heen praten.
Bovenop deze twee zit Open Swarm zelf: een samengestelde set van acht gespecialiseerde agenten, eigenzinnige promptbestanden en een eerste installatiewizard die je in minder dan een minuut van git clone naar een werkende zwerm op een schone machine brengt. De acht specialisten, zoals out-of-the-box geconfigureerd:
- Orchestrator — de baas. Ontvangt uw prompt, ontleedt deze in subtaken, wijst werk toe aan specialisten, probeert opnieuw bij fouten en geeft de verzamelde uitvoer aan u terug. 2. Algemeen agent — de allesomvattende probleemoplosser voor taken die niet geschikt zijn voor een specialist. Webtoegang, lichtgewicht redeneren, lijmwerk. 3. Slides-agent — ontwerpt en rendert presentatiedecks. De kopfunctie. Grafieken, lay-outs, merkconsistentie, export naar PDF. 4. Deep research agent — de lezer met een lange context. Haalt concurrentieanalyses, marktrapporten en syntheses uit meerdere bronnen op. Geeft echte tokens uit aan het achtervolgen van primaire bronnen. 5. Gegevensanalyse-agent — het spreadsheetbrein. Neemt ruwe cijfers of onderzoeksresultaten, produceert grafieken, tabellen en samenvattingen. 6. Documentenagent — schrijft gestructureerde documenten. Rapporten, briefings, one-pagers, contracten, interne memo's.
Markdown- en PDF-bewust. 7. Video-agent — genereert korte video-uitvoer. Nog vroeg, maar functioneel voor productmockups en pitch-animaties. 8. Beeldagent — genereert afbeeldingen voor dia's, mockups en merkitems. Sluit aan bij leveranciers van beeldgenen.
Dat is de standaardverdeling. Niets ervan is hardgecodeerd. Elke specialist is slechts een promptbestand plus een gereedschapslijst plus een modeltoewijzing, en je kunt ze allemaal bewerken, forken of vervangen - dat is het deel waar ik het later in dit bericht goed over wil hebben, omdat Open Swarm daar minder op een product en meer op een platform begint te lijken.
De repository bevindt zich op github.com/VRSEN/OpenSwarm. De installatiewizard handelt de authenticatie, afhankelijkheden en configuratie af. Kloon, voer de wizard uit, voer uw API-sleutels in en u bent klaar.
Waarom specialisatie één grote agent verslaat
Ik heb twee jaar lang gekeken hoe mensen probeerden één enkele generalistische agent alles te laten doen. Ik heb daar zelf versies van gebouwd. Het patroon mislukt elke keer op dezelfde manier, en het mislukt om redenen die structureel zijn en niet met een slimmere prompt kunnen worden opgelost.
Eén enkele agent die onderzoek doet, analyseert, schrijft, ontwerpt en rendert, verzamelt de context voor alle vijf taken in één venster. Tegen de tijd dat dia drie wordt geschreven, wordt de onbewerkte HTML uit de onderzoeksstap meegenomen, de mislukte diagrampogingen uit de gegevensstap en de half bewerkte Markdown uit de stap Documenten. Contextvensters zijn eindig. Zelfs met 1M-token Opus wil je eigenlijk niet dat er een miljoen tokens aan verouderde rommel in het bereik zitten als je het model vraagt om een strakke visuele beslissing te nemen over een grafiekas. Hallucinaties stijgen met contextgeluid. De uitvoerkwaliteit neemt af.
Specialisten lossen dit op door de reikwijdte af te dwingen. De onderzoeksagent krijgt een schoon venster dat alleen de onderzoekstaak bevat. Wanneer het klaar is, overhandigt het een schone samenvatting aan de orkestrator en sterft. De data-analist krijgt een schoon venster dat alleen de samenvatting plus zijn eigen tools bevat. Tegen de tijd dat de dia-agent het resultaat oppikt, werkt deze met een strakke, samengestelde context - en niet met een soepje van zeven eerdere taken.
Dat is waar de agent swarm architecture post die ik in maart schreef op doelde, en het is precies het patroon dat Anthropic's eigen gevorkte subagenten in Claude Code op platformniveau implementeerde. Open Swarm is hetzelfde idee, gegeneraliseerd naar niet-codeerwerk.
Er is een tweede voordeel dat belangrijker is dan mensen zich realiseren: elke specialist heeft zijn eigen toolset. De onderzoeksagent beschikt over zoeken op internet, surfen op het web, RSS-lezers en documentophaalprogramma's. De data-analist beschikt over code-uitvoering en grafiekbibliotheken. De dia-agent beschikt over weergavetools. Eén enkele generalist moet alle tools in één prompt combineren – wat meer beslissingen betekent over welke tool hij moet gebruiken, wat meer fouten bij het selecteren van tools betekent, wat langzamere uitvoeringen en slechtere resultaten betekent. Specialisten maken de gereedschapskeuze tot een architectonische beslissing, en niet tot een runtimebeslissing.
Het derde voordeel is dom maar reëel: je kunt ze parallel gebruiken. Onderzoek en beeldgeneratie zijn niet van elkaar afhankelijk, dus de orkestrator kan ze gelijktijdig afvuren. Bij een taak die meerdere resultaten oplevert, verkort parallellisme de tijd van de wandklok met een betekenisvol deel.
De onderlinge confrontatie: Open Swarm versus Claude Code versus Open Claw
Ik gaf dezelfde prompt aan drie verschillende opstellingen en keek naar wat er terugkwam. De opdracht: "Bouw een compleet pitchdeck voor investeerders voor een AI-merkmonitor voor SaaS-targetingbureaus. Neem marktomvang, concurrentieanalyse, productoverzicht, prijsniveaus, GTM en een routekaart voor 12 maanden op." Waar mogelijk dezelfde modelselectie (Sonnet 4.6 over de hele linie voor de worker-agents, Opus 4.7 voor elke orkestratiestap die dit ondersteunde).
Claude Code, single-agent. Uitvoer: een afgeprijsd document van 4.400 woorden. Uitstekende inhoud – de modellen van Anthropic zijn onverslaanbaar op het gebied van gestructureerd schrijven in lange vorm – maar het is een document, geen kaartspel. Secties met de titel 'Dia 1: Omslag', 'Dia 2: Probleem', enz. Om dit om te zetten in iets dat ik daadwerkelijk aan een investeerder zou laten zien, zou ik meer dan 90 minuten in Figma of Slides moeten besteden aan het verplaatsen van inhoud, het ontwerpen van lay-outs en het bouwen van grafieken. Tijdsbesparing ten opzichte van helemaal opnieuw schrijven: misschien 60-70%. Tijd tot een afgerond, presentabel eindproduct: nog ruim twee uur.
Open Claw (het agentautomatiseringsplatform dat ik heb besproken in mijn Open Claw versus Claude Code-vergelijking). Uitvoer: een Google Presentaties-deck via browserautomatisering. Echte dia's, echte lay-outs, maar de ontwerpkwaliteit was het soort generieke blauw-witte sjabloon dat je zou herkennen van elke "AI heeft dit voor mij gegenereerd"-demo. Grafieken waren tijdelijke staven. De inhoud was ongeveer 80% zo goed als die van Claude Code, omdat de workflow meer agentensprongen en meer kansen op contextafwijking met zich meebracht. Tijd tot een voltooid kaartspel: ongeveer 40 minuten, grotendeels geautomatiseerd.
Open Swarm. Uitvoer: een PDF met 18 dia's, ontworpen met echte grafieken gevuld met echte onderzoeksgegevens, merkconsistente typografie, met de hand afgestemde lay-outs per dia. Plus – en dit verraste mij – een afzonderlijk samenvattingsdocument van één pagina, gegenereerd door de docs-agent parallel aan het deck, plus mockup-afbeeldingen van de beeldagent die de dia's-agent had ingesloten in de productoverzichtsdia. Verstreken tijd: 17 minuten. Tokenkosten: ongeveer $ 4,20 aan Sonnet/Opus-oproepen via alle acht agenten. Kwaliteit van het eindproduct: het dichtst bij "Ik zou dit aan een investeerder laten zien zonder het opnieuw aan te raken" dat ik heb gezien bij een open agentsysteem.
Het interessante is niet dat Open Swarm heeft gewonnen. Het interessante is hoe het heeft gewonnen. Het won niet omdat het onderliggende model slimmer was: dezelfde modellen. Het won omdat de architectuur elke modeloproep in een context plaatste waarin het zijn beste werk kon doen, en vervolgens de stukken assembleerde. Dat is een technisch resultaat, geen modelresultaat. En de technische resultaten zijn samengesteld.
Een echte run, stap voor stap
Ik zal u uitleggen wat er feitelijk gebeurt als u een prompt activeert op Open Swarm. Ik gebruik het pitch-deck van de investeerder van bovenaf als voorbeeld, omdat de trace het meest illustratief is.
T+0s: prompt arriveert bij de Orchestrator. De Orchestrator-agent leest de prompt en ontleedt deze. Intern genereert het een taakgrafiek: onderzoek de markt voor merkmonitoring AI, identificeer 4-6 concurrenten, bouw een TAM/SAM/SOM-model, stel productpositionering op, ontwerp 18 dia's met consistente branding, produceer een samenvatting van één pagina, genereer één productmockup-afbeelding. De taakgrafiek wordt in het werkgeheugen van de orkestrator bewaard en niet naar schijf geschreven, hoewel u een vlag kunt omdraaien om deze te dumpen voor foutopsporing.
T+30s — onderzoeksagent ontslaat. Diepgaande onderzoeksagent krijgt de subtaak concurrentieanalyse. Het voert zoekopdrachten uit in meerdere stappen op internet en haalt pagina's op van G2, Crunchbase, ProductHunt, de eigen marketingsites van de concurrentie. Het schrijft een gestructureerd concurrentieraster op in prijsverlagingen: naam, positionering, prijsstelling, doelsegment, zwakke punten. Ongeveer 90 seconden wandklok, ongeveer 200.000 tokens modeltijd. De uitvoer wordt als een schone samenvatting teruggestuurd naar de orkestrator; de orkestrator verwijdert de onbewerkte HTML voordat hij iets stroomafwaarts doorgeeft.
T+2m — onderzoeks- en beeldagenten lopen parallel. De orkestrator stuurt de diepgaande onderzoeksagent opnieuw op een aparte taak (TAM/SAM/SOM marktgrootte) op hetzelfde moment als de beeldagent (productmockup van een dashboard). Parallellisme is hier de goedkope maar reële tijdsbesparing: deze twee taken delen geen context.
T+4m — Data-analyse-agent pikt de onderzoeksresultaten op. Het onderzoek naar de marktomvang komt terug in de vorm van ruwe sectorcijfers en methodologische aantekeningen. De data-agent neemt het op, voert Python uit in een code-interpreter in een sandbox, genereert een TAM/SAM/SOM-diagram met de juiste assen en labels, plus een prijsvergelijkingsdiagram van de concurrentie. De diagrammen worden opgeslagen in een tijdelijke map waaruit de dia-agent zal lezen.
T+7m — agent voor dia's start de ontwerpfase. Dit is de agent die het zwaarste werk doet. Het leest de onderzoekssamenvattingen, de grafieken, de merkvereisten (het vraagt de orkestrator of er iets dubbelzinnigs nodig is). Het genereert een deckspecificatie: 18 dia's, elk met een lay-outtype, inhoud, afbeeldingsreferenties en diagramreferenties. Dan wordt het weergegeven. Aan de andere kant: een echte pdf.
T+12m — docs-agent schrijft de one-pager parallel met de weergave van de dia's. Haalt hetzelfde onderzoek op, condenseert tot een samenvatting van 600 woorden en exporteert naar PDF. Onafhankelijk van de slides-agent omdat de invoergegevens hetzelfde zijn en de uitvoer niet hoeft te coördineren.
T+17m — Orchestrator assembleert, valideert, retourneert. Laatste controle: bestaan alle deliverables, zijn de bestandsgroottes redelijk, heeft een agent een kritieke fout geregistreerd, is de run voltooid binnen het budget voor nieuwe pogingen. Vervolgens keert de besturing terug naar de terminal en ziet u de bestandspaden in uw uitvoermap.
Wat u tijdens deze uitvoering niet ziet, is de herhalingslus van de Orchestrator. De eerste poging tot concurrentieanalyse mislukte: een van de concurrerende sites retourneerde een Cloudflare-uitdaging die de schraper kapot maakte. De orkestrator merkte de mislukking op, probeerde het opnieuw met een andere schrapstrategie en viel de mens (ik) er nooit mee lastig. Dat is een klein ding dat er veel toe doet. Een installatie met één agent mislukt voor uw ogen of verbergt de fout volledig. Een zwerm met een echte orkestrator behandelt mislukking als een routeringsprobleem.
Je eigen Swarm aanpassen
Dit is het deel van Open Swarm waarvan ik denk dat het ondergewaardeerd is in de meeste berichtgeving die ik heb gezien. De standaardverdeling met acht agenten is een startpunt, geen plafond. Iedere specialist beschikt over een promptbestand, een gereedschapslijst en een modelopdracht. U kunt de repository splitsen en alles wijzigen.
Concreet ziet de structuur er als volgt uit. Elke agent leeft als een map met een prompt.md (systeemprompt), een tools.yaml (de lijst met tools met machtigingen) en een configuratieblok in agents.md (modelselectie, temperatuur, beleid voor opnieuw proberen, binding van de bovenliggende Orchestrator). Het toevoegen van een nieuwe agent is echt een kopieer-plak-bewerktaak, en geen "eerst het raamwerk leren"-taak. Als je ooit een Claude Code-subagentdefinitie hebt geschreven, is dit hetzelfde mentale model met een andere bestandsnaam.
Hier is degene die ik heb gebouwd en die volgens mij de beste behuizing is. Ik heb Open Swarm gesplitst en er een SEO-zwerm van gemaakt: een andere specialistische mix die is geoptimaliseerd voor het soort werk dat ik elke week doe. De standaard acht werd:
- Orchestrator — onveranderd, nog steeds de baas. - Zoekwoordplanner — vervangen door 'algemeen agent'. Haalt Search Console-query's op, voert intentieclassificatie uit en bouwt trefwoordclusters. Gereedschapslijst: GSC API-client, een kleine aangepaste Python-tool voor clusterscores. - Korte schrijver — vervangen door "dia'sagent." Neemt een doelgroepzoekwoordcluster en produceert een gestructureerde inhoudsopgave: SERP-analyse, kaart van de concurrentiehoek, aanbevolen overzicht, aantal doelwoorden, suggesties voor interne links. - Deep research agent — behouden, maar met een kleinere toolset en een strakkere opdracht gericht op industrieel onderzoek boven algemeen onderzoek. - Gegevensagent — vervangen door een GA4/GSC analysespecialist. Haalt prestatiegegevens op, bouwt dashboards, markeert verouderde pagina's. - Documentenagent — bewaard.
Schrijft nu de eigenlijke blogpost zodra de opdracht is goedgekeurd. - Crawler-agent — "video-agent" vervangen. Voert een lichtgewicht technische SEO-crawl uit op een doeldomein - Schema-opmaakcontroles, interne linkintegriteit, statuscode-opruiming. - Afbeeldingsagent — bewaard, gebruikt voor afbeeldingen van bloghelden.
Het vorkproces duurde een middag. De grootste productiviteitssprong op één dag die mijn pijplijn in maanden heeft gehad. De kop die je uit die anekdote moet halen, is niet dat ik een SEO-zwerm heb gebouwd. Het is dat het aanpassingsoppervlak ondiep genoeg is dat "bouw een zwerm voor mijn exacte baan" een zaterdagproject is, en geen kwart technisch werk. Iedereen wiens werk meerdere afzonderlijke deeltaken omvat die een generalist fout heeft, kan dit doen.
Het andere stuk dat het vermelden waard is: VRSEN heeft gezinspeeld op een "agent builder agent" - een agent die een beschrijving in natuurlijke taal van een workflow neemt ("Ik wil een zwerm die de concurrentie monitort voor SaaS-startups") en de specialistische mix voor je op gang brengt. Op het moment dat ik dit schrijf, is dat nog in ontwikkeling. Wanneer het landt, daalt de aanpassingsbarrière van 'Zaterdagproject' naar 'vijf minuten'. Dat verandert de wiskunde over wie dit kan gebruiken.
Waar het past in mijn workflow naast Claude Code
Ik wil eerlijk zijn over dit deel, omdat de 'X doodt Y'-framing lui is en meestal verkeerd. Open Swarm heeft Claude Code in mijn stapel niet vervangen. Het loopt ernaast.
Claude Code is nog steeds de plek waar mijn codeerwerk plaatsvindt. Refactoring, agents bouwen, debuggen, infrastructuurwerkzaamheden: het is het juiste hulpmiddel voor 'het resultaat is een codewijziging'. De modellen van Anthropic hebben een voorsprong op het redeneren van lange codes die nog niets in het open ecosysteem heeft geëvenaard. De [gevorkte subagenten] van Claude Code (https://www.mejba.me/forked-subagents-claude-code-anthropic) en de recente verdubbeling van snelheidslimieten na de SpaceX-rekenovereenkomst maken het nuttiger dan ooit voor productietechnisch werk.
Open Swarm is de juiste tool voor "het resultaat is iets anders dan code." Dekken. Rapporten. Mock-ups. Grafieken. Slips. Het soort werk dat vroeger een keten was van "Claude schreef me een schets, daarna ontwierp ik het in Figma, daarna maakte ik grafieken in Numbers, daarna exporteerde ik naar PDF" en valt nu samen in één prompt en één terminalsessie.
De rest van de stapel: ik gebruik nog steeds Open Claw voor visuele workflows waar het patroon van menselijke supervisie ertoe doet: een bord in kanban-stijl, menselijke goedkeuringspoorten tussen fasen, zichtbaarheid van belanghebbenden. Dat past niet bij een heads-down leverbare run; het is de juiste keuze voor een meerdaags, crossfunctioneel project. En Codex zit in de hoek voor de paar specifieke taken waarbij de redeneerstijl van GPT beter is dan die van Claude.
Drie terminal-first-tools, één mentaal model, drie weloverwogen keuzes over welke men voor welke baan ontslaat. De gedeelde draad is dat ze alle drie lokale bestanden zijn, eerst in de terminal, en tolerant zijn voor autonome runs van meerdere uren. Geen van hen zijn SaaS-dashboards waar ik op moet passen. Die terminal-first-oriëntatie is waar ik steeds op terugkom als het onderschatte ding. Als je onlangs een UI-gestuurd agentplatform hebt gebruikt, weet je wat ik bedoel: er is een slepende wrijving in de constante contextwisseling tussen je editor en de webinterface van de agent. Open Swarm en zijn collega's elimineren dat. De agent runt waar ik al woon.
Wat komt er
Een paar dingen op de Open Swarm-routekaart zijn de moeite waard om te markeren, omdat ze veranderen wat u ermee kunt doen voordat het jaar om is.
** Nauwere integraties met aangrenzende terminalagents. ** Er wordt over Open Swarm + Codex + Claude Code gesproken als een gecoördineerd trio in de gemeenschapskanalen van VRSEN - het idee is dat Open Swarm niet-codeerwerk orkestreert, codeertaken overdraagt aan Codex of Claude Code, en de uitvoer opnieuw samenstelt. Dat is het ontbrekende stukje voor "Ik wil een enkele prompt om een kleine SaaS-functie te ontwerpen en te verzenden." Tegenwoordig doe je dat als twee prompts in twee terminals. Morgen kan het er één zijn.
Open Claw-integratie. "Al uw agenten op één plek" is de taal die VRSEN heeft gebruikt. In de praktijk zou dit betekenen dat de terminal-native architectuur van Open Swarm is aangesloten op de visuele goedkeuringsworkflow van Open Claw - terminalsnelheid voor de zware uitvoering, visueel toezicht voor de human-gate-momenten. De juiste mix als het daadwerkelijk wordt verzonden.
De agent builder-agent. Ik heb het hierboven genoemd. De grootste versneller voor adoptie, als het goed terechtkomt. De lat ligt hoog: de meeste 'bouw mij een agent uit natuurlijke taal'-demo's die ik heb gezien, produceren agenten die technisch correct en praktisch nutteloos zijn. Als VRSEN er een kan leveren die werkende zwermen produceert, stort de aanpassingsbarrière in.
Betere video- en beeldspecialisten. Dit is het deel van de standaarddistributie dat duidelijk het jongste is. Dia's, documenten, onderzoek, gegevens: deze middelen zijn volwassen. De videoagent werkt, maar produceert uitvoer die lijkt op een generatieve videotool uit 2024, en niet op die uit 2026. De beeldagent is prima, maar niet Higgsfield-goed. Ik verwacht dat beide de komende twee kwartalen agressief zullen rijpen, omdat VRSEN betere toolintegraties levert.
Geheugen en leren tijdens runs. Op dit moment is elke run grotendeels nieuw. De infrastructuur bestaat in Agency Swarm voor op inbeddingen gebaseerd langetermijngeheugen, en er zijn signalen dat deze naar Open Swarm komt. De versie hiervan waarin mijn SEO-zwerm onthoudt welke trefwoordclusters hebben gepresteerd en toekomstige instructies dienovereenkomstig aanpast, is de versie waarvoor ik echt geld zou betalen.
Eerlijke beperkingen
Ik ga dit deel doen zoals ik zou willen dat iemand het voor mij doet: eerlijk, zonder enige beperking.
'Geen codering vereist' is niet helemaal waar. De belofte is dat u geen code schrijft om Open Swarm uit te voeren. Dat is nauwkeurig. De belofte is niet dat je nooit een bestand aanraakt. Om de zwerm zinvol aan te passen, bewerkt u promptbestanden. Om een tool toe te voegen, bewerkt u een YAML-bestand. Om een specialist die zich misdraagt op te sporen, leest u de prompt en zoekt u uit waar de instructies verkeerd zijn. Als de uitdrukking "een YAML-configuratie bewerken" je zorgen baart, zal de aanpassingslaag van Open Swarm aanvoelen als coderen, ook al is dat niet het geval.
Uitvoerkwaliteitsschalen met modelkeuze. Dit klinkt voor de hand liggend. Het doet er meer toe dan het klinkt. Voer Open Swarm uit op goedkope modellen en u krijgt goedkope uitvoer. Voer het uit op Sonnet 4.6 op de worker-agents en Opus 4.7 op de Orchestrator en je krijgt de resultaten die ik hierboven heb beschreven. De zwermarchitectuur versterkt de kwaliteit die de onderliggende modellen u bieden – ten goede of ten kwade. Verwacht geen uitvoer van $ 0,30 per run van modellen van $ 0,30 per run.
Autonome runs van meerdere uren kosten echte tokens. De pitch-run voor investeerders die ik beschreef, kostte ongeveer $ 4,20. Dat is prima voor eenmalige resultaten. Als je er twintig per dag in de wachtrij zet, is dat $84/day, $2500 per maand, alleen voor de agentruns. Dat is nog steeds goedkoper dan het inhuren van een ontwerper of analist, maar het is niet gratis en het kan je besluipen. Stel vanaf dag één een kostenplafond per run in de configuratie in. De zwerm respecteert het.
De slides-agent is de kop. Beeld en video zijn nog vroeg. Ik kom hier steeds op terug omdat het belangrijk is voor het scheppen van verwachtingen. Als je op Open Swarm wordt verkocht vanwege de deck-output, krijg je precies waarvoor je je hebt aangemeld. Als je er vanwege de video-uitvoer aan verkocht bent, temper dan de verwachting een beetje. De videoagent werkt (ik heb hem gebruikt voor productmockup-animaties), maar het is het deel van de standaarddistributie dat het meeste werk vergt. Over zes maanden zou ik hierover een ander rapport verwachten.
Provider lock-in is een risico waar u rekening mee moet houden. Open Swarm draait bovenop LiteLLM, wat betekent dat providerflexibiliteit technisch beschikbaar is. In de praktijk zijn de promptbestanden afgestemd op de specifieke eigenaardigheden van Sonnet/Opus, en het overschakelen naar een andere provider verslechtert de uitvoerkwaliteit. Als u zich zorgen maakt over "wat als Anthropic de prijzen verhoogt of functies weghaalt", beschermt Open Swarm u daar niet volledig van. Het geeft u migratie-optioneelheid, geen migratiepariteit.
Lange runs kunnen problemen verbergen. Wanneer een specialist in stap drie van een run van vijftien minuten een stille fout maakt, begrijpt de orkestrator deze meestal niet. Je ziet de uiteindelijke output, het ziet er plausibel uit, je verzendt het. Een week later realiseer je je dat de concurrentieanalyse een concurrent vermeldde die niet bestaat, omdat de onderzoeksagent hallucineerde en niets stroomafwaarts hem opmerkte. Dit geldt voor alle multi-agentsystemen en Open Swarm is niet slechter dan zijn soortgenoten, maar de wandklokafstand tussen "Ik begon de run" en "Ik zie de uitvoer" maakt de verificatie trager dan zou moeten. Maak er een gewoonte van om citaten te controleren in elk resultaat dat u naar een echt mens stuurt.
Wie moet dit weekend proberen
Als je een oprichter bent die met de hand investeerdersdecks schrijft en je hebt $ 50 aan API-tegoed liggen, installeer dan vanavond Open Swarm. Voer de pitch-prompt voor investeerders uit tegen uw eigen bedrijf. Het eerste kaartspel dat je terugkrijgt, zal niet je laatste kaartspel zijn, maar de tweede versie, nadat je je echte cijfers hebt ingevoerd en de positionering hebt aangescherpt, zal negentig procent van de weg ernaartoe zijn in een fractie van de tijd die het zou kosten om het met de hand te doen.
Als u een onderzoeker bent die rapporten voor klanten samenstelt, is de combinatie van diepgaand onderzoek en documenten het gebruiksscenario waarvoor de zwerm is gebouwd. Een goede regel: elk resultaat dat je momenteel een volledige dag kost van 'onderzoek, dan in kaart brengen, dan schrijven, dan formatteren' is een kandidaat voor een zaterdagmiddagexperiment.
Als je een marketeer of SEO-operator bent zoals ik, is de juiste zet om de standaarddistributie te splitsen en je eigen zwerm te bouwen. De acht standaardspecialisten zijn gericht op algemeen zakelijk werk. Specialiseer ze voor uw werk en de productiviteitssprong is van het soort dat verandert wat u klanten in rekening kunt brengen.
Als je een ontwikkelaar bent die vertrouwd is met de agentteams van Claude Code en hetzelfde model wil uitbreiden naar niet-codeerwerk, dan is dit precies dat. Het mentale model is identiek. De wrijving is laag.
En als je iemand bent die gefrustreerd is door plafonds voor één agent (runs die contextlimieten bereiken, hallucineren bij lengte drie, de draad kwijtraakt bij taken die uit meerdere stappen bestaan) – dan is dit de architectuur waarop je hebt gewacht totdat iemand deze als een schone open source-primitief zou verzenden. Het patroon van orkestrator-plus-specialisten is als concept niet nieuw. Het patroon dat wordt geleverd als iets dat je in 60 seconden kunt klonen en uitvoeren, is nieuw.
De installatie in één regel is een git clone van github.com/VRSEN/OpenSwarm gevolgd door de installatiewizard. Van een schone machine tot een werkende zwerm: minder dan vijf minuten. De kosten om het te proberen: laag. Het voordeel als het blijft hangen: een permanente verandering in hoeveel van uw werk u aan een machine kunt overdragen.
Ik zat twee weken lang op de verdubbeling van de Claude Code-tarieflimiet voordat ik erover schreef, omdat ik wilde weten of het daadwerkelijk iets veranderde. Ik schrijf over Open Swarm drie weken na de eerste installatie omdat het antwoord eerder kwam. Het is het eerste stuk open-source agentinfrastructuur dat ik in 2026 heb geïnstalleerd en dat een permanent plekje in mijn workflow heeft verdiend zonder dat ik mezelf ervan hoef te overtuigen dat het er een verdient. De resultaten die het produceert zijn reëel. De architectuur klopt. Het aanpassingsverhaal is zo oppervlakkig dat je er in een weekend je eigen verhaal van kunt maken.
De terminal heeft de AI agent UX-oorlog al gewonnen. Open Swarm is het meest interessante dat in die terminal gebeurt en dat niet gaat over het schrijven van code.
Veelgestelde vragen
Is Open Swarm gratis te gebruiken?
Open Swarm zelf is gratis en open-source onder VRSEN's repository op github.com/VRSEN/OpenSwarm. U brengt uw eigen API-sleutels mee - Anthropic, OpenAI, Gemini of een andere LiteLLM-compatibele provider - en betaalt deze providers rechtstreeks voor tokengebruik. Een typische, volledig leverbare run kost een paar dollar aan modeloproepen.
Wat is het verschil tussen Open Swarm en Agentschap Swarm?
Agency Swarm is het onderliggende multi-agent orkestratieframework: de motor. Open Swarm is een samengestelde, kant-en-klare distributie die er bovenop is gebouwd: acht vooraf geconfigureerde gespecialiseerde agenten, een installatiewizard, eigenzinnige aanwijzingen, terminal-first UX. Als Agency Swarm het raamwerk is, is Open Swarm het startpakket met batterijen.
Moet ik weten hoe ik moet coderen om Open Swarm uit te voeren?
U hoeft geen code te schrijven om de standaardzwerm uit te voeren: klonen, installatiewizard, prompt, klaar. Om specialisten aan te passen of uw eigen zwerm samen te stellen, bewerkt u promptbestanden (markdown) en toolconfiguratie (YAML). Dat is tekstbewerking, geen codering, maar als "een YAML-bestand bewerken" voor jou als coderen voelt, verwacht dan een kleine leercurve op de aanpassingslaag.
Hoe verhoudt Open Swarm zich tot Claude Code-subagenten?
De subagenten van Claude Code zijn hetzelfde architecturale patroon (orkestrator plus specialisten met afzonderlijke contextvensters) toegepast op codeerwerk. Open Swarm past het op alles toe, behalve op coderen: diapresentaties, onderzoeksrapporten, grafieken, documenten, afbeeldingen. Het zijn complementaire tools die u redelijkerwijs naast elkaar zou kunnen gebruiken in plaats van met concurrenten.
Welke modellen werken het beste met Open Swarm?
Tijdens mijn tests produceerden Sonnet 4.6 op de worker-agents en Opus 4.7 op de Orchestrator uitvoer van de hoogste kwaliteit. Het raamwerk is provider-onafhankelijk via LiteLLM, maar de standaard promptbestanden zijn afgestemd op de modellen van Anthropic, dus het wisselen van provider heeft de neiging de kwaliteit te verslechteren, tenzij u ook de prompts afstemt.
Laten we samenwerken
Wilt u AI-systemen bouwen, workflows automatiseren of uw technische infrastructuur schalen? Ik help je graag.
- Fiverr (aangepaste builds en integraties): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (ondernemingsoplossingen): ramlit.com
- ColorPark (ontwerp en branding): colorpark.io
- xCyberSecurity (beveiligingsdiensten): xcybersecurity.io