A solicitação tinha doze palavras. "Crie para mim uma apresentação completa ao investidor para um SaaS de monitor da marca AI."
Apertei enter dentro de uma janela preta do terminal, fui até a cozinha, fiz café e voltei. Quinze minutos depois, havia um PDF totalmente projetado na minha pasta de saída. Deslize da capa. Declaração do problema. Tamanho do mercado com um gráfico TAM/SAM/SOM real que extraiu números reais de uma análise do concorrente. Uma visão geral do produto com maquetes. Um slide de entrada no mercado. Níveis de preços. Uma seção fundadora. Uma pergunta final. Dezoito slides, projetados - não "aqui está uma lista com marcadores, você mesmo pode colá-la no Apresentações Google". Uma coisa acabada.
A primeira vez que executei o mesmo prompt em um único agente Claude Code, seis meses atrás, o que recebi foi um esboço de redução. Um bom esboço. Mas um esboço. A lacuna mental entre “Vou escrever o conteúdo da apresentação para você” e “aqui está uma apresentação” é a lacuna que eu esperava que alguém preenchesse no mundo do código aberto há dois anos.
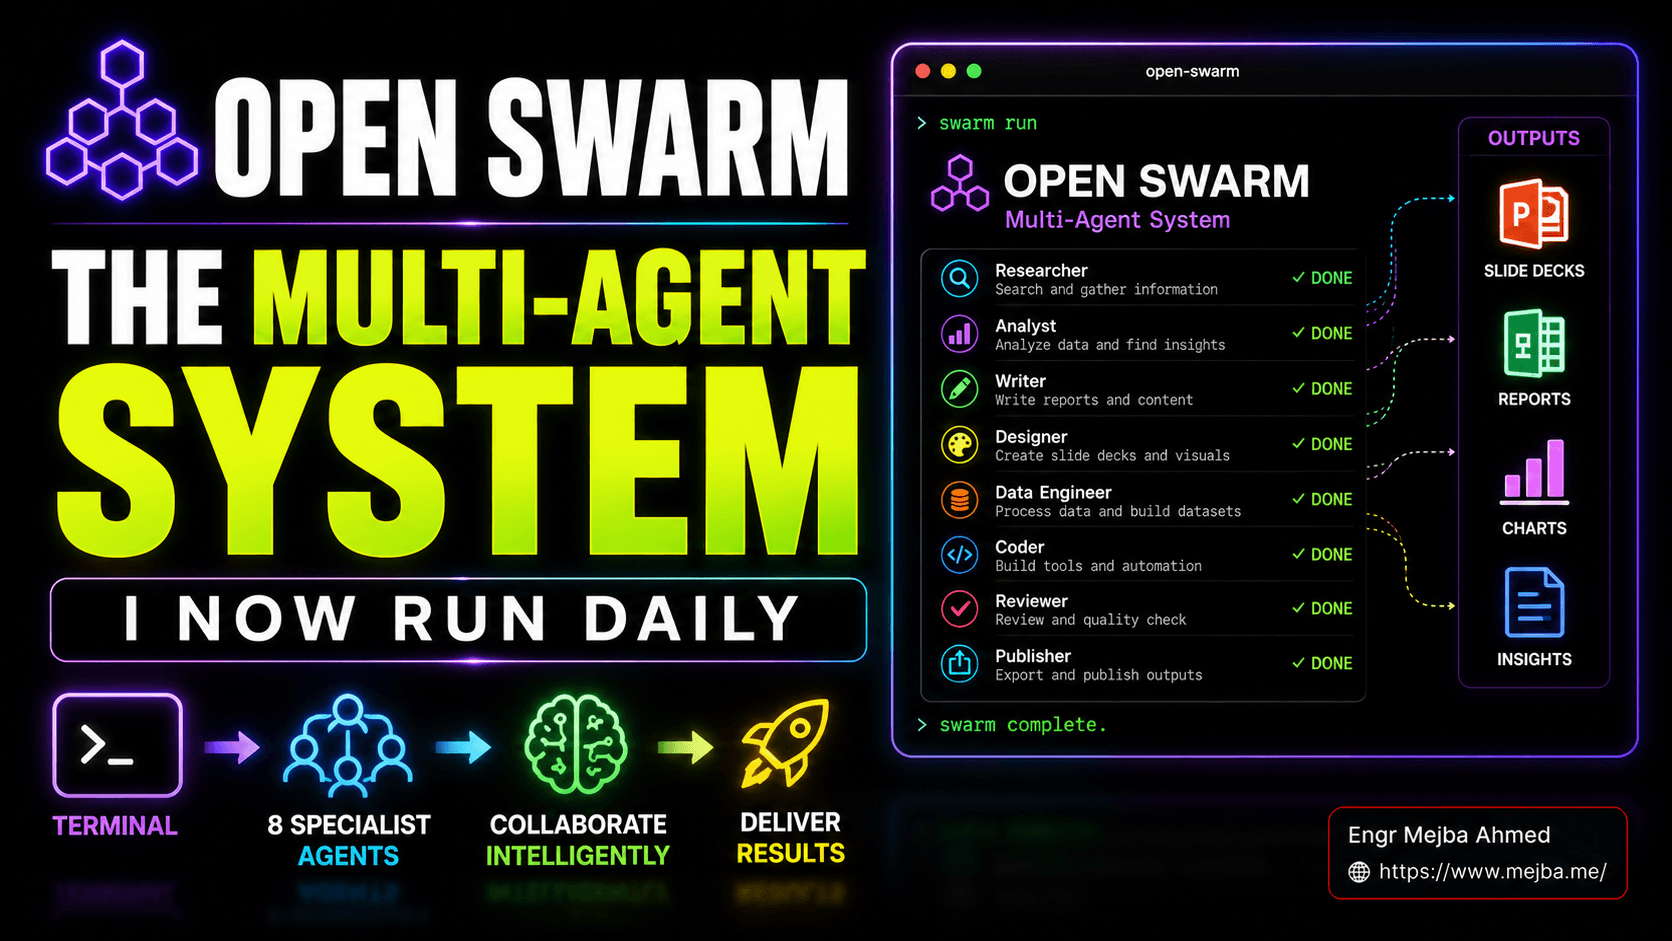
O que fechou para mim se chama Open Swarm. É um sistema multiagente de código aberto da VRSEN – a mesma equipe por trás da Agência Swarm – que fica em seu terminal, executa oito agentes especializados sob um orquestrador e produz resultados reais (apresentações de slides, relatórios de pesquisa, gráficos, documentos, imagens, vídeo) a partir de um único prompt. O slogan do repositório diz “Claude Code para tudo, exceto codificação”. Isso é exato. Também está subestimando um pouco o que realmente está acontecendo aqui.
Já o estou executando em meu pipeline de conteúdo diário há quase duas semanas. Deixe-me dizer o que funciona, o que não funciona e por que acho que isso é a coisa mais interessante que está acontecendo no espaço dos agentes de código aberto no momento.
O que Open Swarm realmente é
Retire a linguagem de marketing e Open Swarm são três coisas empilhadas umas sobre as outras.
Na parte inferior está o OpenCode – o agente de codificação do terminal de código aberto AI que tem cerca de 150.000 estrelas do GitHub, mais de 850 colaboradores e uma base instalada de milhões de desenvolvedores. O próprio OpenCode é uma TUI escrita em cima do Bubble Tea, multiprovedor e independente de modelo. Se você usou Claude Code, o OpenCode se parece com seu irmão. A mesma vibração do teclado, a mesma sessão persistente, a mesma filosofia "seu projeto reside no diretório atual".
No meio está a Agência Swarm, também da VRSEN - uma estrutura de orquestração multiagente que estende o SDK de agentes OpenAI para fornecer fluxos de comunicação confiáveis, transferências estruturadas entre especialistas e execução flexível do provedor (Anthropic, OpenAI, Gemini, Grok, qualquer coisa LiteLLM roteável). A agência Swarm está em produção com clientes da VRSEN há algum tempo; é o mecanismo que evita que os agentes falem uns com os outros.
Além desses dois, está o próprio Open Swarm: um conjunto selecionado de oito agentes especializados, arquivos de prompt opinativos e um assistente de configuração de primeira execução que leva você do git clone a um enxame funcional em menos de um minuto em uma máquina limpa. Os oito especialistas, conforme configurados imediatamente:
- Orquestrador — o chefe. Recebe seu prompt, decompõe-o em subtarefas, atribui trabalho a especialistas, tenta novamente em caso de falhas e devolve a você o resultado montado. 2. Agente geral — o solucionador de problemas abrangente para tarefas que não cabem a um especialista. Acesso à Web, raciocínio leve, trabalho colado. 3. Agente do Apresentações — cria e renderiza apresentações. O recurso de título. Gráficos, layouts, consistência de marca, exportações para PDF. 4. Agente de pesquisa profunda — o leitor de longo contexto. Extrai análises competitivas, relatórios de mercado e sínteses de várias fontes. Gasta tokens reais perseguindo fontes primárias. 5. Agente de análise de dados — o cérebro da planilha. Pega números brutos ou resultados de pesquisas, produz gráficos, tabelas, resumos. 6. Agente de documentos — escreve documentos estruturados. Relatórios, resumos, páginas únicas, contratos, memorandos internos.
Compatível com Markdown e PDF. 7. Agente de vídeo — gera saída de vídeo em formato curto. Ainda inicial, mas funcional para modelos de produtos e animações de pitch. 8. Agente de imagem — gera imagens para slides, maquetes, ativos de marca. Conecta-se a provedores de geração de imagens.
Essa é a distribuição padrão. Nada disso é codificado. Cada especialista é apenas um arquivo de prompt mais uma lista de ferramentas mais uma atribuição de modelo, e você pode editar, bifurcar ou substituir qualquer um deles - que é a parte sobre a qual quero falar mais adiante neste post, porque é onde Open Swarm começa a se parecer menos com um produto e mais com uma plataforma.
O repositório está em github.com/VRSEN/OpenSwarm. O assistente de configuração lida com autenticação, dependências e configuração. Clone, execute o assistente, insira suas chaves API e pronto.
Por que a especialização supera um grande agente
Passei dois anos observando pessoas tentando obrigar um único agente generalista a fazer tudo. Eu mesmo construí versões disso. O padrão falha sempre da mesma maneira e falha por motivos estruturais, que não podem ser corrigidos com um prompt mais inteligente.
Um único agente realizando pesquisa, análise, redação, design e renderização acumula contexto em todas as cinco tarefas em uma janela. No momento em que está escrevendo o slide três, ele carrega o HTML bruto raspado da etapa de pesquisa, as tentativas de gráfico fracassadas da etapa de dados, o Markdown parcialmente editado da etapa de documentos. As janelas de contexto são finitas. Mesmo com o Opus de 1 milhão de tokens, você não quer realmente um milhão de tokens de lixo obsoleto no escopo quando pede ao modelo para tomar uma decisão visual rigorosa sobre um eixo do gráfico. As alucinações aumentam com o ruído do contexto. A qualidade da saída diminui.
Os especialistas corrigem isso reforçando o escopo. O agente de pesquisa obtém uma janela limpa que contém apenas a tarefa de pesquisa. Quando termina, entrega um resumo limpo ao orquestrador e morre. O analista de dados obtém uma janela limpa que contém apenas o resumo e suas próprias ferramentas. No momento em que o agente de slides obtém o resultado, ele está trabalhando com um contexto restrito e selecionado – e não uma sopa de sete tarefas anteriores.
Isso é o que a postagem sobre arquitetura de enxame de agentes que escrevi em março estava abordando, e é o padrão exato que os próprios subagentes bifurcados em Claude Code do próprio Anthropic implementaram no nível da plataforma. Open Swarm é a mesma ideia generalizada para trabalhos sem codificação.
Há um segundo benefício que é mais importante do que as pessoas imaginam: cada especialista tem seu próprio conjunto de ferramentas. O agente de pesquisa possui pesquisa na web, navegação na web, leitores de RSS, buscadores de documentos. O analista de dados possui execução de código e bibliotecas de gráficos. O agente de slides possui ferramentas de renderização. Um único generalista precisa conciliar todas as ferramentas em um único prompt – o que significa mais decisões sobre qual ferramenta usar, o que significa mais erros na seleção de ferramentas, o que significa execuções mais lentas e resultados piores. Os especialistas consideram a escolha da ferramenta uma decisão arquitetônica, não de tempo de execução.
O terceiro benefício é idiota, mas real: você pode executá-los em paralelo. A pesquisa e a geração de imagens não dependem uma da outra, portanto o orquestrador pode dispará-las simultaneamente. Em uma tarefa com múltiplas entregas, o paralelismo reduz o tempo do relógio em uma parte significativa.
O confronto direto: Open Swarm vs Claude Code vs Open Claw
Dei o mesmo prompt para três configurações diferentes e olhei o que retornou. O prompt: "Construa para mim uma apresentação completa do argumento de venda do investidor para agências de segmentação SaaS com monitor de marca AI. Inclua tamanho de mercado, análise da concorrência, visão geral do produto, níveis de preços, GTM e um roteiro de 12 meses." A mesma seleção de modelo sempre que possível (Soneto 4.6 em todos os níveis para os agentes trabalhadores, Opus 4.7 para qualquer etapa de orquestração que o suporte).
Claude Code, agente único. Saída: um documento de redução de 4.400 palavras. Excelente conteúdo — os modelos do Anthropic são imbatíveis em escrita estruturada de formato longo — mas é um documento, não um baralho. Seções denominadas "Slide 1: Capa", "Slide 2: Problema" etc. Para transformar isso em algo que eu realmente mostraria a um investidor, precisaria gastar mais de 90 minutos no Figma ou no Slides movendo conteúdo, projetando layouts, construindo gráficos. Tempo economizado versus escrever do zero: talvez 60-70%. Tempo para uma entrega finalizada e apresentável: ainda mais de duas horas.
Open Claw (a plataforma de automação de agente que abordei em minha comparação Open Claw vs Claude Code). Resultado: uma apresentação do Apresentações Google por meio da automação do navegador. Slides reais, layouts reais, mas a qualidade do design era o tipo de modelo genérico em azul e branco que você reconheceria em qualquer demonstração "AI gerou isso para mim". Os gráficos eram barras de espaço reservado. O conteúdo era cerca de 80% tão bom quanto o de Claude Code porque o fluxo de trabalho envolvia mais saltos de agente e mais chances de desvio de contexto. Tempo para terminar o deck: cerca de 40 minutos, a maior parte automatizado.
Open Swarm. Saída: um PDF de 18 slides, projetado com gráficos reais preenchidos a partir de dados de pesquisa reais, tipografia consistente com a marca, layouts ajustados manualmente por slide. Além disso - e isso me surpreendeu - um documento de resumo executivo de uma página separado gerado pelo agente de documentos em paralelo com a apresentação, além de imagens de modelo do agente de imagem que o agente de slides incorporou no slide de visão geral do produto. Tempo decorrido: 17 minutos. Custo do token: aproximadamente US$ 4,20 em chamadas Sonnet/Opus em todos os oito agentes. Qualidade do resultado final: o mais próximo de "Eu mostraria isso a um investidor sem retocá-lo" que já vi em qualquer sistema de agente aberto.
A parte interessante não é que Open Swarm ganhou. A parte interessante é como venceu. Não venceu porque o modelo subjacente era mais inteligente – os mesmos modelos. Ganhou porque a arquitetura colocou cada chamada de modelo em um contexto onde poderia fazer seu melhor trabalho e depois montou as peças. Esse é um resultado de engenharia, não um resultado de modelo. E os resultados da engenharia aumentam.
Uma verdadeira corrida, passo a passo
Deixe-me explicar o que realmente acontece quando você dispara um prompt em Open Swarm. Estou usando a apresentação do argumento de venda do investidor acima como exemplo porque o traço é o mais ilustrativo.
T+0s — o prompt chega ao orquestrador. O agente orquestrador lê o prompt e o decompõe. Internamente, ele gera um gráfico de tarefas: pesquisar o mercado de monitoramento da marca AI, identificar de 4 a 6 concorrentes, construir um modelo TAM/SAM/SOM, rascunhar o posicionamento do produto, projetar 18 slides com marca consistente, produzir um resumo executivo de uma página, gerar uma imagem de maquete do produto. O gráfico da tarefa é mantido na memória de trabalho do orquestrador, e não gravado no disco — embora você possa inverter um sinalizador para despejá-lo para depuração.
T+30s — agente de pesquisa é demitido. O agente de pesquisa profunda recebe a subtarefa de análise competitiva. Ele executa pesquisas na web em várias etapas, extrai páginas do G2, Crunchbase, ProductHunt, os próprios sites de marketing dos concorrentes. Ele escreve uma grade competitiva estruturada em descontos – nome, posicionamento, preço, segmento-alvo, pontos fracos. Cerca de 90 segundos de relógio de parede, aproximadamente 200 mil tokens de tempo de modelo. A saída é devolvida ao orquestrador como um resumo limpo; o orquestrador remove o HTML bruto raspado antes de passar qualquer coisa downstream.
T+2m — agentes de pesquisa e imagem são executados em paralelo. O orquestrador aciona o agente de pesquisa profunda novamente em uma tarefa separada (dimensionamento de mercado TAM/SAM/SOM) ao mesmo tempo que o agente de imagem (maquete de produto de um painel). O paralelismo economiza tempo barato, mas real aqui - essas duas tarefas não compartilham contexto.
T+4m — o agente de análise de dados coleta o resultado da pesquisa. A pesquisa de dimensionamento do mercado retorna como números brutos do setor e notas metodológicas. O agente de dados o ingere, executa Python em um interpretador de código em área restrita, gera um gráfico TAM/SAM/SOM com eixos e rótulos adequados, além de um gráfico de comparação de preços do concorrente. Os gráficos são salvos em um diretório temporário onde o agente de slides irá ler.
T+7m — o agente de slides inicia a passagem de design. Este é o agente que realiza a parte mais pesada do trabalho. Lê os resumos das pesquisas, os gráficos, os requisitos da marca (pergunta ao orquestrador se precisa de algo ambíguo). Ele gera uma especificação de deck – 18 slides, cada um com tipo de layout, conteúdo, referências de imagem, referências de gráfico. Então ele renderiza. Do outro lado: um PDF real.
T+12m — o agente de documentos escreve a página única em paralelo com a renderização dos slides. Extrai a mesma pesquisa, condensa em um resumo executivo de 600 palavras e exporta para PDF. Independente do agente de slides porque os dados de entrada são os mesmos e as saídas não precisam ser coordenadas.
T+17m — o orquestrador monta, valida e retorna. Verificação final: todas as entregas existem, os tamanhos dos arquivos são razoáveis, algum agente registrou um erro crítico, a execução foi concluída dentro de seu orçamento de novas tentativas. Em seguida, o controle retorna ao terminal e você vê os caminhos dos arquivos na sua pasta de saída.
O que você não vê durante esta execução é o loop de novas tentativas do orquestrador. A primeira tentativa de análise competitiva falhou – um dos sites concorrentes retornou um desafio da Cloudflare que quebrou o scraper. O orquestrador detectou a falha, tentou novamente com uma estratégia de raspagem diferente e nunca incomodou o humano (eu) com isso. Isso é uma coisa pequena que importa muito. Uma configuração de agente único falha na sua frente ou oculta totalmente a falha. Um enxame com um orquestrador real trata a falha como um problema de roteamento.
Personalizando seu próprio Swarm
Esta é a parte do Open Swarm que considero subvendida na maioria das coberturas que vi. A distribuição padrão de oito agentes é um ponto de partida, não um teto. Cada especialista é um arquivo de prompt, uma lista de ferramentas e uma atribuição de modelo. Você pode bifurcar o repositório e alterar tudo.
Concretamente, a estrutura fica assim. Cada agente reside como um diretório com um prompt.md (prompt do sistema), um tools.yaml (a lista de ferramentas com permissões) e um bloco de configuração em agents.md (seleção de modelo, temperatura, política de nova tentativa, ligação do orquestrador pai). Adicionar um novo agente é genuinamente um trabalho de copiar, colar e editar, não um trabalho do tipo "aprenda a estrutura primeiro". Se você já escreveu uma definição de subagente Claude Code, este é o mesmo modelo mental com um nome de arquivo diferente.
Aqui está o que eu construí e que acho que é o melhor caso. Eu bifurquei o Open Swarm e o transformei em um enxame de SEO - um mix especializado diferente, otimizado para o tipo de trabalho que faço todas as semanas. O oito padrão tornou-se:
- Orquestrador — inalterado, ainda o chefe. - Planejador de palavras-chave — substituído por "agente geral". Extrai consultas do Search Console, executa classificação de intenções e cria clusters de palavras-chave. Lista de ferramentas: cliente GSC API, uma pequena ferramenta Python personalizada para pontuação de cluster. - Escritor de resumos — substituído por "agente de slides". Pega um grupo de palavras-chave alvo e produz um resumo de conteúdo estruturado: análise SERP, mapa de ângulo do concorrente, esboço recomendado, contagem de palavras alvo, sugestões de links internos. - Agente de pesquisa profunda — mantido, mas com um conjunto de ferramentas menor e um prompt mais restrito focado na pesquisa do setor em vez da pesquisa geral. - Agente de dados — substituído por um especialista em análise GA4/GSC. Extrai dados de desempenho, cria painéis, sinaliza páginas decadentes. - Agente de documentos — mantido.
Agora escreve a postagem real no blog assim que o briefing for aprovado. - Agente rastreador — substituído por "agente de vídeo". Executa um rastreamento técnico leve de SEO em um domínio de destino – verificações de marcação de esquema, integridade de link interno, varredura de código de status. - Agente de imagem — mantido, usado para imagens principais do blog.
O processo de bifurcação durou uma tarde. O maior salto de produtividade em um único dia que meu pipeline teve em meses. O título que você deve tirar dessa anedota não é que eu construí um enxame de SEO. É que a superfície de personalização é rasa o suficiente para que “construir um enxame para o meu trabalho exato” seja um projeto de sábado, e não um quarto do trabalho de engenharia. Qualquer pessoa cujo trabalho envolva múltiplas subtarefas discretas que um generalista erra pode fazer isso.
A outra parte que vale a pena sinalizar: VRSEN sugeriu um “agente construtor de agentes” – um agente que pega uma descrição em linguagem natural de um fluxo de trabalho (“Eu quero um enxame que monitore concorrentes para startups de SaaS”) e aumenta o mix de especialistas para você. Isso ainda está em desenvolvimento no momento em que escrevo isto. Quando chega, a barreira de personalização cai de “projeto de sábado” para “cinco minutos”. Isso muda a matemática sobre quem pode usar isso.
Onde ele se encaixa no meu fluxo de trabalho junto com Claude Code
Quero ser honesto sobre essa parte porque o enquadramento “X mata Y” é preguiçoso e geralmente errado. Open Swarm não substituiu Claude Code em minha pilha. Ele corre próximo a ele.
Claude Code ainda é onde meu trabalho de codificação acontece. Refatoração, construção de agentes, depuração, trabalho de infraestrutura — é a ferramenta certa para “a entrega é uma mudança de código”. Os modelos do Anthropic têm uma vantagem no raciocínio de código de formato longo que nada no ecossistema aberto correspondeu ainda. Os subagentes bifurcados de Claude Code e a recente duplicação de limites de taxa após o acordo de computação da SpaceX o tornam mais útil do que nunca para o trabalho de engenharia de produção.
Open Swarm é a ferramenta certa para "a entrega é algo diferente de código". Convés. Relatórios. Maquetes. Gráficos. Cuecas. O tipo de trabalho que costumava ser uma cadeia de "Claude me escreveu um esboço, depois projetei no Figma, depois fiz gráficos no Numbers, depois exportei para PDF" e agora se resume em um prompt e uma sessão de terminal.
O resto da pilha: eu ainda uso Open Claw para fluxos de trabalho visuais onde o padrão de supervisão humana é importante – quadro estilo kanban, portas de aprovação humana entre os estágios, visibilidade das partes interessadas. Esse é o ajuste errado para uma execução de entrega direta; é a opção certa para um projeto multifuncional de vários dias. E o Codex fica no canto para as poucas tarefas específicas em que o estilo de raciocínio do GPT supera o do Claude.
Três ferramentas que priorizam o terminal, um modelo mental, três escolhas deliberadas sobre qual deles demite para qual trabalho. O thread compartilhado é que todos os três são arquivos locais, primeiro o terminal e tolerantes a execuções autônomas de várias horas. Nenhum deles são painéis SaaS dos quais preciso cuidar. Essa orientação que prioriza o terminal é o que sempre considero subestimada. Se você usou recentemente uma plataforma de agente baseada em UI, você sabe o que quero dizer - há um atrito arrastado na constante alternância de contexto entre seu editor e a interface web do agente. Open Swarm e seus pares eliminam isso. O agente corre onde eu já moro.
O que está por vir
Vale a pena sinalizar algumas coisas no roteiro Open Swarm porque mudam o que você pode fazer com ele antes do final do ano.
Integrações mais estreitas com agentes de terminal adjacentes. Open Swarm + Codex + Claude Code como um trio coordenado está sendo discutido nos canais da comunidade VRSEN - a ideia é que Open Swarm orquestra o trabalho de não codificação, entrega as tarefas de codificação para Codex ou Claude Code e remonta a saída. Essa é a peça que falta para “Quero um único prompt para projetar e enviar um pequeno recurso SaaS”. Hoje você faz isso como dois prompts em dois terminais. Amanhã pode ser um.
Integração Open Claw. "Todos os seus agentes em um só lugar" é a linguagem usada pela VRSEN. Na prática, isso significaria a arquitetura nativa do terminal do Open Swarm conectada ao fluxo de trabalho de aprovação visual do Open Claw – velocidade do terminal para a execução pesada, supervisão visual para os momentos de entrada humana. A mistura certa se realmente for enviada.
O agente construtor de agentes. Mencionei isso acima. O maior acelerador para a adoção, se der certo. O padrão é alto - a maioria das demonstrações do tipo "crie para mim um agente a partir de linguagem natural" que vi produzem agentes que são tecnicamente corretos e praticamente inúteis. Se o VRSEN puder enviar um que produza enxames funcionais, a barreira da personalização entrará em colapso.
Melhores especialistas em vídeo e imagem. Esta é a parte da distribuição padrão que é claramente a mais nova. Slides, documentos, pesquisas, dados – esses agentes são maduros. O agente de vídeo funciona, mas produz resultados que parecem uma ferramenta de vídeo generativa de 2024, não de 2026. O agente de imagem está bem, mas não está bem com Higgsfield. Espero que ambos amadureçam agressivamente nos próximos dois trimestres, à medida que o VRSEN fornece melhores integrações de ferramentas.
Memória e aprendizado entre corridas. No momento, cada corrida é praticamente nova. A infraestrutura existe na Agência Swarm para memória de longo prazo baseada em embeddings, e há sinais de que ela está chegando ao Open Swarm. A versão em que meu enxame de SEO lembra quais grupos de palavras-chave tiveram desempenho e ajusta os resumos futuros de acordo é a versão pela qual eu pagaria com dinheiro real.
Limitações honestas
Vou fazer esta parte do jeito que gostaria que alguém fizesse por mim: direto, sem rodeios.
"Nenhuma codificação necessária" não é estritamente verdade. A promessa é que você não escreva código para executar Open Swarm. Isso é exato. A promessa não é que você nunca toque em um arquivo. Para personalizar o enxame de forma significativa, edite os arquivos de prompt. Para adicionar uma ferramenta, você edita um arquivo YAML. Para depurar um especialista que se comporta mal, você lê seu prompt e descobre onde as instruções estão erradas. Se a frase "editar uma configuração YAML" lhe causa ansiedade, a camada de personalização do Open Swarm parecerá uma codificação, embora não seja.
A qualidade da saída varia de acordo com a escolha do modelo. Isso parece óbvio. É mais importante do que parece. Execute Open Swarm em modelos baratos e você obterá resultados baratos. Execute-o no Sonnet 4.6 nos agentes de trabalho e no Opus 4.7 no orquestrador e você obterá os resultados que descrevi acima. A arquitetura swarm amplifica qualquer qualidade que os modelos subjacentes oferecem – para melhor ou para pior. Não espere uma produção de US$ 0,30 por execução de modelos de US$ 0,30 por execução.
As corridas autônomas de várias horas custam tokens reais. A corrida ao investidor que descrevi custou cerca de US$ 4,20. Isso é bom para entregas únicas. Se você colocar vinte deles na fila por dia, isso equivale a US$ 84/day, cerca de US$ 2.500 por mês, apenas para as execuções do agente. Isso ainda é mais barato do que contratar um designer ou analista, mas não é gratuito e pode surpreender você. Defina um teto de custo por execução na configuração desde o primeiro dia. O enxame respeita isso.
O agente dos slides é o título. Imagem e vídeo ainda são iniciais. Sempre volto a isso porque é importante para definir expectativas. Se você for vendido no Open Swarm por causa da saída do deck, você obterá exatamente o que se inscreveu. Se você está convencido disso por causa da saída de vídeo, reduza um pouco a expectativa. O agente de vídeo funciona – usei-o para animações de maquetes de produtos – mas é a parte da distribuição padrão que precisa de mais trabalho. Daqui a seis meses eu esperaria um relatório diferente sobre isso.
O aprisionamento do provedor é um risco que você deve considerar. Open Swarm é executado em cima do LiteLLM, o que significa que a flexibilidade do provedor está tecnicamente disponível. Na prática, os arquivos de prompt são ajustados para as peculiaridades específicas do Sonnet/Opus, e a mudança para um provedor diferente degrada a qualidade da saída. Se a sua preocupação for "e se o Anthropic aumentar os preços ou retirar recursos", o Open Swarm não o isola totalmente disso. Oferece opção de migração, não paridade de migração.
Corridas longas podem esconder problemas. Quando um especialista comete um erro silencioso no terceiro passo de uma corrida de quinze minutos, o orquestrador geralmente não percebe. Você vê o resultado final, parece plausível e você o envia. Uma semana depois você percebe que a análise competitiva listou um concorrente que não existe porque o agente de pesquisa teve uma alucinação e nada posterior o detectou. Isso é verdade para todos os sistemas multiagentes e o Open Swarm não é pior do que seus pares, mas a distância do relógio entre "comecei a execução" e "vejo a saída" torna a verificação mais lenta do que deveria. Crie o hábito de verificar citações em qualquer produto que você enviará a um ser humano real.
Quem deveria experimentar neste fim de semana
Se você é um fundador que escreve apresentações para investidores à mão e tem $ 50 de crédito API disponíveis, instale Open Swarm hoje à noite. Execute o argumento de venda do investidor contra sua própria empresa. O primeiro baralho que você receber não será o seu baralho final - mas o segundo rascunho, depois de você alimentá-lo com seus números reais e definir o posicionamento, estará noventa por cento do caminho até lá em uma fração do tempo que levaria para fazê-lo à mão.
Se você é um pesquisador que cria relatórios para clientes, a combinação de pesquisa profunda e documentos é o caso de uso para o qual o enxame foi criado. Uma boa regra: qualquer entrega que atualmente leve um dia inteiro de “pesquisa, depois traçar, depois escrever e depois formatar” é candidata a um experimento no sábado à tarde.
Se você é um profissional de marketing ou operador de SEO como eu, a atitude certa é bifurcar a distribuição padrão e construir seu próprio enxame. Os oito especialistas padrão destinam-se a trabalhos comerciais de uso geral. Especialize-os para o seu trabalho e o salto de produtividade é do tipo que muda o que você pode cobrar dos clientes.
Se você é um desenvolvedor que se sente confortável com as equipes de agentes de Claude Code e deseja estender o mesmo modelo para trabalhos sem codificação, é exatamente isso. O modelo mental é idêntico. O atrito é baixo.
E se você está frustrado com limites de agente único - execuções que atingem os limites de contexto, alucinam no comprimento três, perdem o fio da meada em tarefas de várias etapas - esta é a arquitetura que você estava esperando que alguém lançasse como um primitivo de código aberto limpo. O padrão orquestrador mais especialistas não é um conceito novo. O padrão enviado como algo que você pode clonar e executar em 60 segundos é novo.
A instalação de uma linha é um git clone de github.com/VRSEN/OpenSwarm seguido pelo assistente de configuração. Uma máquina limpa para um enxame de trabalho: menos de cinco minutos. O custo de tentar: baixo. A vantagem se persistir: uma mudança permanente na quantidade de seu trabalho que você pode entregar a uma máquina.
Fiquei sentado no limite de taxa Claude Code dobrando por duas semanas antes de escrever sobre isso, porque queria saber se isso realmente mudou alguma coisa. Estou escrevendo sobre Open Swarm três semanas após a primeira instalação porque a resposta chegou antes. É a primeira infraestrutura de agente de código aberto que instalei em 2026 e que ganhou um espaço permanente em meu fluxo de trabalho sem que eu tenha que me convencer de que merece. Os resultados que produz são reais. A arquitetura está certa. A história da personalização é superficial o suficiente para que você possa torná-la sua durante um fim de semana.
O terminal já venceu a guerra UX do agente AI. Open Swarm é a coisa mais interessante que acontece dentro daquele terminal que não se trata de escrever código.
Perguntas frequentes
O uso do Open Swarm é gratuito?
O próprio Open Swarm é gratuito e de código aberto no repositório VRSEN em github.com/VRSEN/OpenSwarm. Você traz seu próprio modelo de chaves API - Anthropic, OpenAI, Gemini ou qualquer provedor compatível com LiteLLM - e paga esses provedores diretamente para uso de token. Uma execução típica de entrega completa custa alguns dólares em chamadas de modelo.
Qual é a diferença entre Open Swarm e Agência Swarm?
A agência Swarm é a estrutura de orquestração multiagente subjacente – o mecanismo. Open Swarm é uma distribuição curada e pronta para execução construída sobre ela: oito agentes especializados pré-configurados, um assistente de configuração, prompts opinativos, UX que prioriza o terminal. Se a Agência Swarm for a estrutura, Open Swarm é o kit inicial com baterias incluídas.
Preciso saber como codificar para executar o Open Swarm?
Você não precisa escrever código para executar o enxame padrão — clonar, assistente de configuração, solicitar, pronto. Para personalizar especialistas ou criar seu próprio enxame, você editará os arquivos de prompt (markdown) e a configuração da ferramenta (YAML). Isso é edição de texto, não codificação, mas se "editar um arquivo YAML" parece codificar para você, espere uma pequena curva de aprendizado na camada de personalização.
Como o Open Swarm se compara aos subagentes Claude Code?
Os subagentes do Claude Code são o mesmo padrão de arquitetura (orquestrador mais especialistas com janelas de contexto separadas) aplicado ao trabalho de codificação. Open Swarm aplica-o a tudo, exceto codificação – apresentações de slides, relatórios de pesquisa, gráficos, documentos, imagens. São ferramentas complementares que você razoavelmente usaria lado a lado, em vez de concorrentes.
Quais modelos funcionam melhor com Open Swarm?
Em meus testes, o Sonnet 4.6 nos agentes trabalhadores e o Opus 4.7 no orquestrador produziram resultados da mais alta qualidade. A estrutura é independente de provedor por meio do LiteLLM, mas os arquivos de prompt padrão são ajustados em relação aos modelos do Anthropic, portanto, a troca de provedor tende a degradar a qualidade, a menos que você também ajuste os prompts.
Vamos trabalhar juntos
Procurando construir sistemas AI, automatizar fluxos de trabalho ou dimensionar sua infraestrutura tecnológica? Eu adoraria ajudar.
- Fiverr (compilações e integrações personalizadas): fiverr.com/s/EgxYmWD
- Portfólio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e marca): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io