Ce qui m'a convaincu de Claude Opus 4.8, ce n'est pas le graphique de benchmarks. C'est une refactorisation que je repoussais depuis des semaines.
J'avais une classe de service Laravel qui, en quatre mois d'accumulation de fonctionnalités, était devenue un monstre de 600 lignes — le genre de fichier où l'on modifie une méthode et trois tests sans rapport passent au rouge. Avec Opus 4.7, j'avais tenté deux fois de faire démêler le code par le modèle. Les deux fois, il s'est arrêté à mi-chemin, a déclaré le travail "substantiellement terminé" et m'a laissé avec un trait à moitié extrait et une suite de tests cassée. Du 4.7 tout craché. Confiant, puis discrètement paresseux.
Le matin du 28 mai, jour de sortie de Claude Opus 4.8, je l'ai pointé vers le même fichier. Même prompt. Même dépôt. J'ai mis le niveau d'effort sur max, appuyé sur Entrée et suis allé me faire un café.
À mon retour, il avait extrait trois classes cohérentes, réécrit les bindings dans le service provider, mis à jour chaque test, exécuté la suite, trouvé deux véritables cas limites qu'il avait introduits et les avait corrigés — sans rien demander. Puis il m'a dit, posément : "Je suis raisonnablement confiant dans l'extraction, mais je n'ai pas touché à la couche de cache car le comportement original y était ambigu et je ne voulais pas deviner." Cette dernière phrase résume tout ce lancement. Non seulement il a terminé le travail. Mais il m'a dit exactement ce qu'il n'avait pas touché.
J'utilise Opus 4.8 comme outil quotidien depuis plus d'une semaine maintenant — projets clients, le pipeline de contenu de ce blog, un projet SaaS secondaire à moitié terminé. Voici le vrai verdict au-delà du graphique d'Anthropic, et le seul réglage qui détermine si vous finissez par adorer ce modèle ou le maudire.
Ce qu'Anthropic a réellement lancé le 28 mai
Claude Opus 4.8 est sorti le 28 mai 2026, s'appuyant directement sur Opus 4.7. La propre présentation d'Anthropic dans l'annonce officielle est inhabituellement sobre : il s'appuie sur 4.7 avec "un jugement plus affûté, plus d'honnêteté sur sa propre progression et la capacité de travailler en autonomie plus longtemps que ses prédécesseurs."
Deux points pratiques comptent avant d'entrer dans le modèle lui-même.
Premièrement : le prix n'a pas bougé. Opus 4.8 est sorti le même jour au même coût par token que 4.7 — 5 $ par million de tokens d'entrée et 25 $ par million de tokens de sortie à vitesse standard. Ça semble anodin jusqu'à ce qu'on ait vécu assez de lancements de modèles pour connaître le schéma habituel : "modèle plus intelligent, facture plus lourde." Pas cette fois. Anthropic a aussi rendu le mode rapide moins cher. Et il y a un gain d'efficacité plus discret enfoui dans la documentation : high effort sur 4.8 consomme à peu près autant de tokens sur une tâche de programmation que l'ancien réglage xhigh sur 4.7 — avec un score supérieur. Vous obtenez plus de réflexion par token, pas seulement plus de réflexion par dollar.
Deuxièmement : les rate limits de Claude Code ont augmenté. Anthropic a relevé les limites spécifiquement pour accommoder la consommation accrue de tokens aux nouveaux niveaux d'effort — un signal fort sur la façon dont ce modèle est conçu pour être piloté. Ils s'attendent à ce que vous dépensiez plus de tokens sur les tâches difficiles. Ils ont intégré la marge. Si vous avez suivi comment Anthropic a doublé les rate limits de Claude Code plus tôt cette année, c'est la même trajectoire : plus de puissance de calcul dirigée vers ceux qui construisent vraiment avec.
Le titre n'est donc pas "Opus 4.8 est un peu plus intelligent." C'est "Opus 4.8 est plus intelligent, coûte pareil et vous donne un nouveau cadran pour contrôler l'intensité de sa réflexion." Ce cadran, c'est tout le jeu. On y reviendra. D'abord le graphique, car vous l'avez déjà vu et vous avez des questions.
Les chiffres de benchmark — y compris celui qu'il perd
Voici la comparaison publiée par Anthropic, directement tirée de l'annonce. Je reproduis les chiffres exacts car les écarts en disent plus que le titre.
| Benchmark | Opus 4.8 | Opus 4.7 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| Programmation agentique (SWE-Bench Pro) | 69,2 % | 64,3 % | 58,6 % | 54,2 % |
| Programmation agentique en terminal (Terminal-Bench 2.1) | 74,6 % | 66,1 % | 78,2 % | 70,3 % |
| Raisonnement multidisciplinaire (Humanity's Last Exam, sans outils) | 49,8 % | 46,9 % | 41,4 % | 44,4 % |
| Raisonnement multidisciplinaire (avec outils) | 57,9 % | 54,7 % | 52,2 % | 51,4 % |
| Utilisation agentique d'ordinateur (OSWorld-Verified) | 83,4 % | 82,8 % | 78,7 % | 76,2 % |
| Travail de connaissance (GDPval-AA) | 1890 | 1753 | 1769 | 1314 |
| Analyse financière agentique (Finance Agent v2) | 53,9 % | 51,5 % | 51,8 % | 43,0 % |
Regardez le bond de SWE-Bench Pro : de 64,3 % à 69,2 %. Près de cinq points de gain en programmation agentique dans un point release, alors que GPT-5.5 stagne à 58,6 % et Gemini 3.1 Pro traîne à 54,2 %. Ce n'est pas une erreur d'arrondi. C'est la différence entre un modèle qui termine une modification multi-fichiers et un qui cale.
Les chiffres de raisonnement évoluent dans la même direction. Humanity's Last Exam sans outils grimpe de 46,9 % à 49,8 %, et avec outils à 57,9 % — les deux en tête nette. Le travail de connaissance sur GDPval-AA bondit de 1753 à 1890, ce qui à cette échelle représente une marge significative au-dessus des 1769 de GPT-5.5 et des kilomètres devant les 1314 de Gemini.
Passons à la partie honnête. Opus 4.8 ne gagne pas partout.
En programmation agentique en terminal — Terminal-Bench 2.1 — GPT-5.5 gagne encore, 78,2 % contre 74,6 %. C'est une vraie défaite, pas une marge d'erreur, et je mentirais si je prétendais le contraire. Si votre workflow repose fortement sur le terminal — longues chaînes de commandes shell, orchestration CI, boucles agentiques bash brutes — GPT-5.5 et Codex gardent un avantage. J'ai fait tourner les deux en parallèle sur le même dépôt pendant quelques jours, et l'écart est visible : Codex est tout simplement un peu plus sûr quand la totalité de la tâche se passe dans le terminal. J'ai déjà écrit sur le fait de faire tourner Claude Code et Codex côte à côte dans le même repo, et 4.8 réduit cet écart terminal par rapport à 4.7 (66,1 %) — mais ne le comble pas.
Si vous êtes venu ici pour entendre "Opus 4.8 écrase tout" — ce n'est pas la réalité. La réalité : il mène dans six catégories sur sept, souvent largement, et en perd une — la programmation en terminal — face à GPT-5.5. Gardez cet astérisque en tête. Il comptera quand nous parlerons de quel modèle choisir selon la situation.
Mais voici ce que le graphique ne peut pas vous montrer. Aucun de ces chiffres ne signifie quoi que ce soit tant que vous ne comprenez pas le levier qui les contrôle.
Niveaux d'effort : Le réglage qui décide de tout
La fonctionnalité phare d'Opus 4.8 n'est pas un benchmark. C'est un curseur.
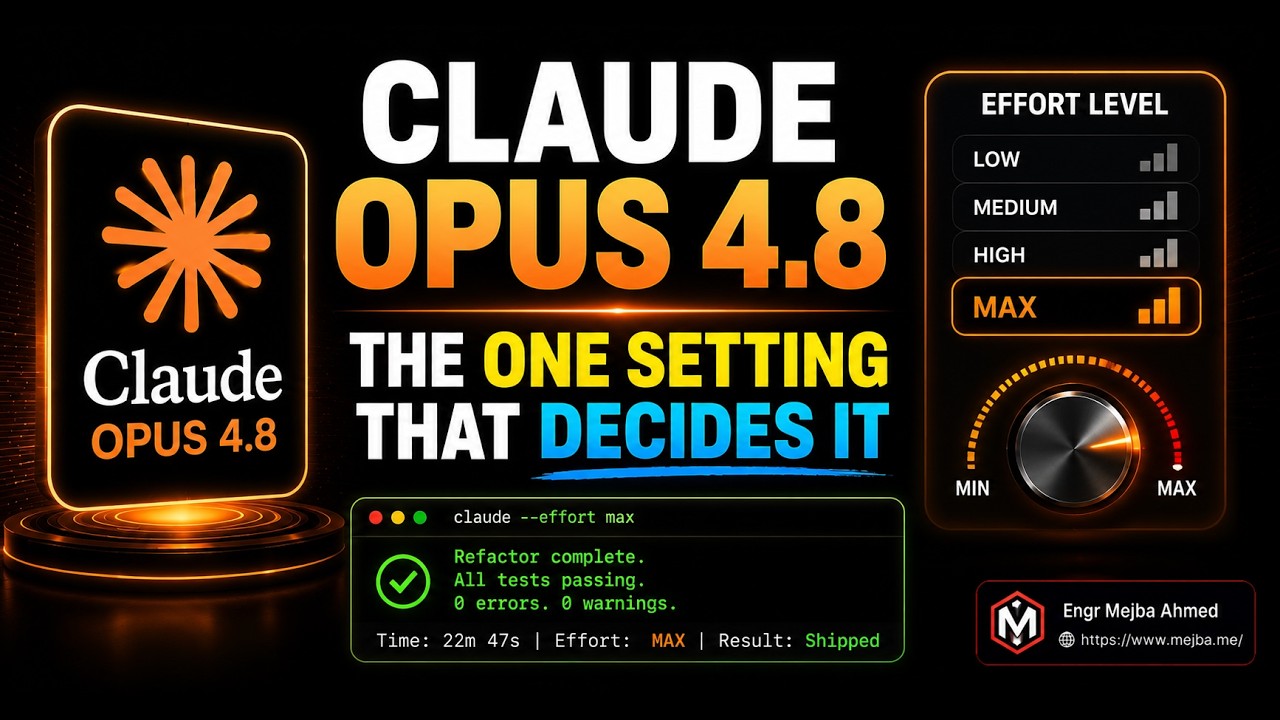
Dans Claude Code, vous pouvez désormais régler le niveau d'effort du modèle sur cinq crans : low → medium → high (par défaut) → max → ultra. C'est la chose la plus importante à comprendre de ce lancement, car c'est la différence entre le modèle qui a brillamment résolu ma refactorisation et celui qui l'aurait ratée.
Voici comment les niveaux se comportent en pratique :
| Effort | Ce qu'il fait | Coût en tokens | Vitesse |
|---|---|---|---|
| Low | Réponses rapides et légères | Faible | Rapide |
| Medium | Équilibré, complexité modérée | Modéré | Modéré |
| High (par défaut) | Équilibre qualité/ressources | Élevé | Modéré–lent |
| Max | Conçu pour les tâches véritablement complexes | Très élevé | Plus lent |
| Ultra | Effort max plus workflows dynamiques pour le travail à grande échelle | Le plus élevé | Le plus lent |
Le modèle mental qui a fait tilt chez moi : le niveau d'effort est un budget de réflexion. Montez-le et le modèle raisonne plus intensément, garde plus de contexte en mémoire de travail et persévère sur des tâches qu'il abandonnerait autrement. Baissez-le et vous obtenez des réponses rapides et bon marché, parfaites pour une recherche mais qui s'effondrent face à une vraie refactorisation.
Une note sur la nomenclature, car elle m'a embrouillé et elle vous embrouillera aussi. La propre documentation d'Anthropic décrit les niveaux de raisonnement sous-jacents comme low, high (par défaut) et un niveau supérieur "extra"/xhigh — et dans Claude Code, le niveau le plus élevé s'affiche comme ultracode, qui combine le raisonnement xhigh avec une orchestration automatique de workflows. Le modèle à cinq crans (low / medium / high / max / ultra) est le modèle mental le plus propre pour l'usage quotidien, et c'est ainsi que j'en parlerai ici, mais si vous fouillez dans l'annonce officielle et trouvez "xhigh" et "ultracode", c'est le même rapport supérieur sous une étiquette différente. Ne laissez pas le vocabulaire vous perdre — c'est le même cadran.
Ce niveau supérieur mérite son propre paragraphe. Ultra (alias ultracode dans Claude Code) est l'effort max plus des workflows dynamiques, où le modèle planifie le travail puis lance des sous-agents parallèles pour traiter des problèmes à grande échelle en autonomie. C'est la partie qui m'a véritablement surpris : les workflows dynamiques peuvent orchestrer jusqu'à 1 000 sous-agents parallèles en une seule session (c'est le plafond dur fixé par Anthropic), et sur 4.8 ces agents tiennent plus longtemps avant de s'épuiser. Imaginez "réécris ce module, migre les tests, mets à jour la documentation et vérifie le build" comme une seule instruction, le modèle écrivant son propre plan d'orchestration et séquençant les sous-tâches au lieu d'attendre que vous les lui serviez une par une. Il vérifie ensuite ses propres résultats avant de rendre compte. C'est le successeur spirituel du travail orienté objectif que j'ai couvert quand les commandes /for et /goal ont changé mon workflow Claude Code — sauf que l'orchestration est maintenant la tâche du modèle, pas une commande qu'on greffe dessus. À savoir : les workflows dynamiques sont sortis en research preview, attendez-vous donc à quelques aspérités à ce niveau.
Voici le piège, et j'y suis tombé dès le premier jour. Le réglage par défaut est high, et il est inadapté pour la moitié de vos tâches. Trop bas, et le modèle s'arrête prématurément ou raisonne faiblement — exactement la paresse du 4.7 dont tout le monde se plaignait, sauf que c'est maintenant un réglage que vous avez choisi, pas un défaut dont vous avez hérité. Trop haut, et le modèle suranalyse une recherche de configuration d'une ligne, brûle 8 000 tokens et met 40 secondes à vous dire quelque chose qu'un grep aurait résolu en un instant.
L'habileté n'est pas de choisir le niveau le plus élevé. L'habileté est d'ajuster l'effort à la complexité de la tâche. C'est tout le jeu. On passe aux tactiques dans un instant.
Comment Opus 4.8 se comporte différemment — au-delà du curseur
Les niveaux d'effort font les gros titres, mais le comportement sous-jacent du modèle a changé de façons tout aussi importantes au quotidien. Après une semaine, quatre évolutions se détachent.
Il raisonne avant de recourir aux outils. C'est le changement majeur. Opus 4.7 avait la gâchette facile — il lançait un appel d'outil ou démarrait un sous-agent avant même d'avoir réfléchi à la nécessité de le faire. 4.8 essaie d'abord de résoudre le problème en interne et n'invoque outils ou sous-agents que quand le raisonnement seul ne suffit pas. En pratique, cela signifie moins d'appels d'outils inutiles, moins de lancements de sous-agents bâclés et un modèle qui donne l'impression de réfléchir plutôt que de s'agiter dans tous les sens.
Il calibre la longueur de réponse selon la tâche. Posez à 4.8 une question factuelle rapide et vous obtenez une réponse courte. Demandez-lui d'analyser une décision d'architecture et vous obtenez la profondeur que la question mérite. 4.7 avait un seul bouton de volume, bloqué sur "verbeux." 4.8 sait lire la pièce.
Il est plus honnête sur sa propre progression. Anthropic a explicitement optimisé pour cela, et les chiffres le confirment — ils ont documenté une réduction d'environ quatre fois des défauts de code non signalés, ce qui signifie que 4.8 est beaucoup moins susceptible de livrer discrètement un bug et de déclarer le travail terminé. Moins de faux messages "terminé !". Moins de complétions fantômes où le modèle jure que les tests passent alors que ce n'est pas le cas. L'histoire de refactorisation du début de cet article est l'exemple canonique — il m'a dit ce qu'il n'avait pas touché et pourquoi. C'est la plus grande amélioration de confiance de ce lancement, et c'est le genre de chose qu'aucun titre de benchmark ne capture.
Le ton s'est réchauffé. Opus 4.7 avait une touche de ce que la communauté appelait charitablement du "sass" — un côté légèrement rigide, parfois contrariant, plus un excès de prudence sécuritaire qui le faisait refuser ou hésiter sur des demandes parfaitement raisonnables. 4.8 est plus collaboratif. Plus chaleureux. Il pousse en retour quand il le faut mais ne fait pas la leçon. Si vous aviez décroché à cause de l'attitude de 4.7, cela seul pourrait suffire à vous faire revenir.
Il y a un changement plus discret sous les quatre, et c'est celui sur lequel Anthropic a le plus appuyé : l'orientation vers les objectifs est désormais un trait central, pas un pansement. Avec 4.7, amener le modèle à travailler vers un résultat — plutôt que de simplement satisfaire le texte littéral de votre dernier message — exigeait un prompting délibéré et les bonnes commandes. 4.8 garde l'objectif en tête tout au long d'une tâche longue et se dirige vers lui. Quand il arrive à un embranchement ambigu, il pose une question plus ciblée au lieu de deviner ou de se bloquer. Sur une exécution autonome de 40 minutes, c'est la différence entre revenir à du travail terminé et revenir à une excuse polie. Cela fait aussi que 4.8 pose moins de questions que 4.7 — mais celles qu'il pose sont celles qui débloquent réellement le travail.
Empilez ces quatre avec le curseur d'effort et vous obtenez un modèle qui ne se contente pas de scorer plus haut — il donne fondamentalement plus l'impression d'un coéquipier et moins d'un outil avec lequel il faut batailler. Ce qui nous amène à la partie pour laquelle vous êtes vraiment venu : comment le piloter.
Comment je configure réellement Opus 4.8 (étape par étape)
Les benchmarks, c'est la théorie. Voici la configuration pratique sur laquelle j'ai atterri après une semaine d'essais et erreurs. Reprenez-la, puis adaptez-la à votre propre travail.
Étape 1 : Arrêtez d'accepter le niveau d'effort par défaut
La première erreur que j'ai faite a été de tout laisser sur high et de me demander pourquoi les tâches simples semblaient lentes et coûteuses. Ne faites pas ça. Avant de commencer une tâche, posez-vous une question : à quel point c'est vraiment difficile ?
- Chercher quelque chose, renommer une variable, un rapide "où est défini X ?" → low. Il répondra en secondes pour une fraction des tokens.
- Écrire une fonction ciblée, une modification dans un seul fichier, un bugfix standard → medium.
- La plupart du vrai travail de fonctionnalité, des modifications multi-fichiers, tout ce pour quoi vous voudriez qu'un collègue réfléchisse vraiment → high (le réglage par défaut gagne sa place ici).
- Refactorisations épineuses, décisions d'architecture, débogage de quelque chose de vraiment subtil → max.
- "Migre tout ce module et vérifie" — du travail à l'échelle où vous voulez que le modèle planifie et séquence des sous-tâches → ultra avec workflows dynamiques.
Astuce pro : J'ai un post-it sur mon écran qui dit juste : "adapte le cadran à la difficulté." C'est bête, et ça m'a économisé plus de tokens que n'importe quel prompt astucieux.
Étape 2 : Dites au modèle quoi FAIRE, pas quoi NE PAS faire
Ce n'est pas un conseil nouveau, mais il compte davantage avec 4.8 car le modèle est bien meilleur pour suivre des instructions positives. Au lieu de "ne casse pas les tests existants," écrivez "garde chaque test existant vert et ajoute de nouveaux tests pour tout comportement que tu modifies." Le cadrage positif donne au modèle une cible à viser plutôt qu'un champ de mines à traverser. La différence de qualité en sortie est réelle et constante.
Étape 3 : Donnez-lui le pourquoi derrière vos instructions
Le changement de prompting le plus efficace que j'ai fait pour 4.8 : expliquer le raisonnement. Ne dites pas simplement "utilise le pattern repository ici." Dites "utilise le pattern repository ici parce que nous allons changer la source de données de MySQL vers une API externe au prochain sprint, et je veux que le code appelant ne soit pas touché quand on le fera."
Quand 4.8 comprend le pourquoi, sa conformité et son jugement font un bond. Il prend de meilleures décisions dans les zones que vos instructions n'ont pas couvertes, parce qu'il raisonne vers votre objectif réel au lieu de faire du pattern matching sur vos mots littéraux. Cela s'aligne parfaitement avec le changement de comportement "raisonne avant d'agir" — donnez-lui du bon matériau de réflexion et il raisonne bien.
Étape 4 : Surveillez vos tokens, surtout en max et ultra
Plus d'effort signifie plus de tokens. C'est le deal. Les rate limits relevés vous donnent de la marge, mais la marge n'est pas infinie. Gardez un tracker de tokens actif pour voir ce que max et ultra vous coûtent réellement sur des tâches concrètes. La première fois que j'ai lancé une migration complète en workflow dynamique ultra, j'ai observé le compteur et recalibré immédiatement — une partie de ce travail n'avait pas besoin d'ultra, elle avait besoin de max avec un prompt plus serré. Si les coûts comptent pour vous, mes astuces de gestion de tokens Claude Code restent d'actualité, et elles s'appliquent plus fort maintenant que vous avez un cadran qui peut discrètement cramer votre budget.
Étape 5 : Testez, ne supposez pas que la mise à jour aide
Voici la vérité inconfortable que personne ne met dans les posts de jour de lancement : un modèle plus récent ne garantit pas de meilleurs résultats pour votre cas d'usage. Opus 4.8 est clairement un pas en avant dans l'ensemble. Mais j'ai une tâche spécifique de mise en forme de contenu où la sortie de 4.7 était en fait plus propre pour mon pipeline, et j'ai gardé ce prompt réglé à l'ancienne jusqu'à ce que je l'aie correctement retesté.
Faites tourner vos workflows réels. Comparez. Ajustez. Le modèle est un point de départ, pas une réponse définitive.
Si vous préférez que quelqu'un mette en place et ajuste tout ce workflow de niveaux d'effort pour le stack de votre équipe plutôt que de l'apprendre à la dure, c'est exactement le type de mission que j'accepte — vous pouvez voir ce que j'ai construit sur fiverr.com/s/EgxYmWD.
L'honnête vérité : la plupart des "échecs du modèle" sont de votre faute
Laissez-moi dire ce qui va agacer certains. Après une semaine avec Opus 4.8 et des années d'utilisation quotidienne de ces modèles, je suis convaincu que la majorité des plaintes "le modèle est bête / paresseux / a cassé mon code" ne sont pas des défaillances du modèle. Ce sont des erreurs de prompting et de configuration côté utilisateur.
Je l'ai vu se produire en temps réel pendant l'ère 4.7. Les gens laissaient le modèle sur des réglages par défaut agressifs, lui donnaient des instructions vagues d'une ligne sans justification, sans contexte, sans objectif clair, puis publiaient des captures d'écran en se plaignant que le modèle "avait abandonné." Le modèle n'a pas abandonné. Il a fait exactement ce que produit une instruction sous-spécifiée au mauvais niveau d'effort.
Opus 4.8 rend cela encore plus évident, parce que le niveau d'effort est maintenant entre vos mains. Si vous lancez une refactorisation difficile en effort bas, le modèle s'arrêtera prématurément — et ce n'est pas de la paresse, c'est vous qui lui dites de réfléchir superficiellement. Si vous lancez une recherche triviale en ultra, il suranalysera et brûlera des tokens — et ce n'est pas de la surcharge, c'est vous qui poussez le cadran au-delà de ce que la tâche nécessite.
Je ne dédouane pas complètement Anthropic. Le déploiement initial avait des bugs — quelques personnes ont rencontré un comportement instable dans les premières 48 heures, et j'ai moi-même attrapé une boucle étrange de sous-agents avant que ça se stabilise. Le sentiment de la communauté est mitigé-mais-positif, ce qui est honnête : les gens adorent la programmation et le style de collaboration plus chaleureux, certains ont buté sur des aspérités lors du déploiement. Anthropic itère à partir des retours et des logs utilisateurs, donc les points rugueux tendent à se lisser en quelques jours. C'est le schéma qu'on a vu avec 4.6 et 4.7.
Mais la leçon durable tient : le modèle est plus capable que vos réglages par défaut ne le laissent être. Corrigez les réglages par défaut avant d'accuser le modèle. Ce seul changement de mentalité fera plus pour vos résultats qu'attendre la version 4.9.
Ce que j'observe réellement au quotidien
Je ne vais pas inventer des chiffres précis que je ne peux pas étayer — c'est le meilleur moyen de perdre votre confiance. Mais je peux vous donner les tendances constantes d'une semaine de travail réel sur des dépôts clients, mon pipeline de contenu et un projet secondaire.
Sur les tâches de programmation agentique, la différence entre 4.7 et 4.8 est la plus nette sur les travaux longs. Le genre de refactorisation multi-fichiers que 4.7 aurait abandonné aux deux tiers, 4.8 la mène à terme — et cela correspond exactement au bond de SWE-Bench Pro de 64,3 % à 69,2 %. L'autonomie prolongée est la fonctionnalité phare en pratique. Il continue tout simplement là où 4.7 s'arrêtait.
L'efficacité des tokens est ce que je surveille le plus attentivement. Anthropic revendique une amélioration, et le comportement "raisonne avant de recourir aux outils" devrait signifier moins d'appels d'outils inutiles. Dans mon utilisation, ça se vérifie globalement — moins d'appels parasites en effort moyen et haut. Mais max et ultra sont véritablement coûteux, et ce n'est pas une régression, c'est le design. Des gains d'efficacité en bas-milieu de gamme, des dépenses délibérées en haut de gamme. Vérifiez sur vos propres charges de travail avant de faire confiance à toute affirmation générale de "c'est moins cher", y compris la mienne.
L'amélioration de l'honnêteté est celle qui a discrètement changé ma façon de travailler. Parce que 4.8 est plus fiable pour signaler ce qu'il n'a pas terminé ou ce dont il n'était pas sûr, je passe moins de temps à vérifier les complétions fantômes. C'est un vrai gain de temps qui n'apparaîtra sur aucun graphique — et sur une semaine d'utilisation quotidienne, ça s'additionne jusqu'à un modèle qui inspire confiance d'une manière que 4.7 n'a jamais vraiment atteint. Pour la vue d'ensemble sur l'évolution des réglages par défaut à travers ces versions, mon analyse précédente de Claude Opus 4.7 pose toujours la ligne de base sur laquelle 4.8 s'appuie.
L'attente à fixer : c'est une vraie avancée, mais l'amélioration que vous ressentez est proportionnelle à la qualité de votre pilotage. Laissez-le en pilote automatique et vous obtiendrez un 4.7 légèrement amélioré. Ajustez les niveaux d'effort à vos tâches et vous obtiendrez un modèle qui achève des travaux que l'ancien ne pouvait pas.
Faut-il passer à 4.8 ? Ma réponse franche
Si vous êtes déjà sur Opus 4.7 dans Claude Code : oui, passez maintenant. Même prix, vrais gains, et le curseur d'effort à lui seul vaut la migration. Il n'y a aucune raison de rester sur 4.7 à part l'inertie.
Si vous vivez dans le terminal — longues chaînes bash, orchestration CI, boucles agentiques shell brutes : sachez que GPT-5.5 gagne encore en programmation terminal avec 78,2 % contre 74,6 %. Pour ce travail spécifique, gardez Codex dans votre boîte à outils. Pour tout le reste, Opus 4.8 est le choix le plus fort de loin. Utiliser les deux n'est pas de la couverture — c'est simplement utiliser le bon outil pour le bon travail, la même conclusion que j'ai tirée quand j'ai comparé GPT-5.5 et Opus 4.7 sur du code identique.
Si vous débutez dans tout ça : commencez sur Opus 4.8, laissez-le sur high, et ne commencez à toucher au curseur d'effort que quand vous aurez senti où high en fait trop et où il n'en fait pas assez. Le cadran est puissant, mais il faut développer le feeling.
Questions fréquentes
Que sont les niveaux d'effort dans Claude Opus 4.8 ?
Les niveaux d'effort sont un budget de réflexion contrôlable dans Claude Code avec cinq réglages : low, medium, high (par défaut), max et ultra. Un effort plus élevé signifie un raisonnement plus profond, plus de tokens et des réponses plus lentes ; un effort plus faible signifie une sortie plus rapide, moins chère et plus superficielle. Ajustez le niveau à la complexité de votre tâche. Consultez "Niveaux d'effort : Le réglage qui décide de tout" ci-dessus pour le détail complet.
Claude Opus 4.8 est-il meilleur que GPT-5.5 ?
Opus 4.8 mène dans six des sept benchmarks publiés, dont la programmation agentique (69,2 % vs 58,6 % sur SWE-Bench Pro) et le raisonnement. GPT-5.5 gagne encore en programmation agentique en terminal, 78,2 % contre 74,6 %. Pour la plupart du travail de programmation et de raisonnement, Opus 4.8 est plus fort ; pour les workflows intensifs en terminal, GPT-5.5 conserve un avantage.
Claude Opus 4.8 coûte-t-il plus cher qu'Opus 4.7 ?
Non. Opus 4.8 a été lancé le 28 mai 2026 au même prix par token qu'Opus 4.7. Anthropic a aussi relevé les rate limits de Claude Code pour accommoder l'utilisation accrue de tokens aux nouveaux niveaux d'effort. Notez que les niveaux max et ultra consomment significativement plus de tokens par tâche.
Que sont les workflows dynamiques dans Claude Code ?
Les workflows dynamiques sont une fonctionnalité de Claude Code, activée au niveau d'effort ultra, où Opus 4.8 planifie et orchestre plusieurs étapes et sous-tâches pour résoudre des problèmes à grande échelle en autonomie. Au lieu que vous séquenciez chaque étape, le modèle décompose le travail et le résout par lui-même.
Dois-je toujours utiliser le niveau d'effort le plus élevé ?
Non — c'est l'erreur la plus courante. Max et ultra suranalysent les tâches simples et brûlent des tokens inutilement, tandis qu'un effort bas provoque un arrêt prématuré sur les travaux difficiles. L'habileté consiste à ajuster l'effort à la difficulté de la tâche : low pour les recherches, high pour le vrai travail de fonctionnalité, max pour les refactorisations épineuses, ultra pour les travaux autonomes à grande échelle.
La refactorisation qui m'a convaincu
Vous vous souvenez du monstre Laravel de 600 lignes du début de cet article ? Il tourne en production depuis six jours. Trois classes propres, couverture de tests complète, et la couche de cache qu'Opus 4.8 a délibérément refusé de toucher — parce qu'il m'a dit qu'il n'était pas sûr — s'est avérée contenir une subtilité que j'avais moi-même oubliée. Si le modèle l'avait réécrite "avec assurance" comme 4.7 l'aurait fait, il aurait déployé un bug.
C'est ça, la vraie mise à niveau. Pas les cinq points sur SWE-Bench Pro. Pas le ton plus chaleureux. C'est un modèle qui connaît la limite de sa propre compétence et vous dit où elle se trouve. Associez cette honnêteté à un curseur d'effort que vous savez réellement manier, et vous avez le premier Claude qui ressemble moins à un outil à superviser et plus à un collègue en qui on a confiance.
Alors voici votre mission pour les prochaines 24 heures : ouvrez Claude Code, prenez la tâche la plus difficile de votre journée, réglez le niveau d'effort sur max et donnez-lui le pourquoi derrière votre demande. Puis observez ce qui se passe quand vous arrêtez de vous battre contre les réglages par défaut et commencez à piloter le modèle avec intention.
Travaillons ensemble
Vous cherchez à construire des systèmes d'IA, automatiser des workflows ou faire monter en charge votre infrastructure technique ? Je serais ravi de vous aider.
- Fiverr (développements sur mesure et intégrations) : fiverr.com/s/EgxYmWD
- Portfolio : mejba.me
- Ramlit Limited (solutions entreprise) : ramlit.com
- ColorPark (design et branding) : colorpark.io
- xCyberSecurity (services de sécurité) : xcybersecurity.io