Die GPT-5.6-Serie und die abgeriegelte KI-Grenze: Eine Einordnung aus Entwicklersicht
Ich kam nach zwei Wochen Reise zurück und rechnete damit, einen ruhigen Nachrichtenzyklus aufzuholen. Stattdessen öffnete ich meinen Feed und stellte fest, dass OpenAI still und leise eine komplette GPT-5.6-Serie vorgestellt hatte – Sol, Terra, Luna – zwei Tage bevor irgendjemand darauf vorbereitet war, und die lauteste Reaktion drehte sich nicht um Benchmarks. Sie drehte sich darum, wer das Ding überhaupt anfassen darf.
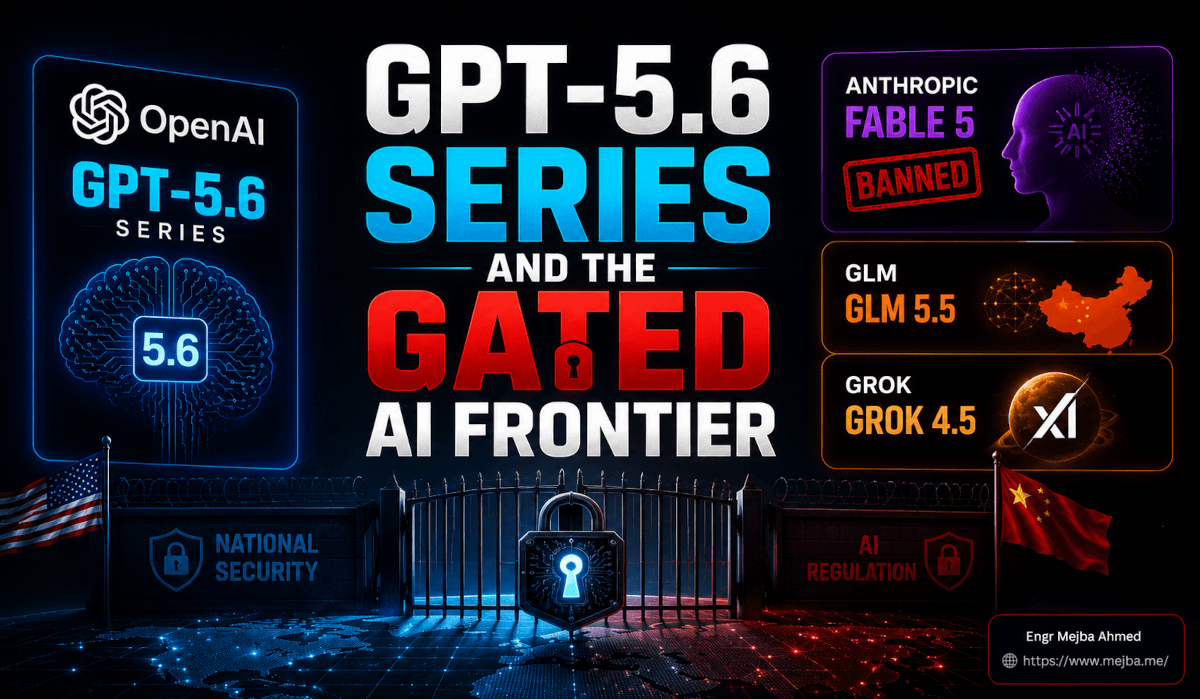
Und jetzt kommt der Teil, der meine Sicht auf diesen ganzen Moment neu geordnet hat. Drei Jahre lang hieß eine Frontier-Veröffentlichung genau eines: ein Blogpost, ein Benchmark-Diagramm und ein API-Key, den man am selben Nachmittag ins Terminal einfügen konnte. Die GPT-5.6-Serie hat mit diesem Ritual gebrochen. Das Flaggschiff sitzt hinter einer Freigabe durch die US-Regierung. Anthropics leistungsfähigstes Modell wurde für zwei Wochen komplett verboten. Und Chinas nächstes Coding-Modell soll bei der Schwachstellensuche mit dem besten westlichen Cyber-Modell mithalten. Die Frontier ist diesen Monat nicht nur klüger geworden. Sie wurde abgeriegelt.
Ich will vorab ehrlich mit dir sein, denn die Hälfte der Posts, die du dazu lesen wirst, tut so, als wäre es anders. Als diese Vorschau zum ersten Mal auftauchte, hatte ich GPT-5.6 Sol noch nicht ausprobiert – ich war außerhalb der USA, als es kam, und selbst innerhalb des Landes war es einer kurzen Liste vorher freigegebener Partner vorbehalten. (Diese Schranke fiel am 9. Juli 2026, als OpenAI Sol nach einer breiten behördlichen Freigabe für die Öffentlichkeit öffnete.) Auch die Person, die die Vorschau ans Licht brachte, konnte nicht vollständig darauf zugreifen. Das hier ist also kein Hands-on-Test. Es ist etwas, das ich gerade jetzt für nützlicher halte: ein Entwickler, der jede Behauptung der Vorschau aufgreift, das Bestätigte vom Gerüchteweisen trennt, die überprüfbaren Teile gegen echte Daten abgleicht und den einen roten Faden herauszieht, der für den Rest von uns tatsächlich zählt.
Dieser rote Faden lautet: Es geht nicht mehr um „wer hat den höchsten Benchmark", sondern um „wer darf das Modell nutzen, wo darf es laufen und in wessen Workflow ist es schon fest verankert". Ich führe dich durch alles, was sich bewegt hat, und warum.
Was ist die GPT-5.6-Serie? Der Dreier-Modell-Überblick
Die GPT-5.6-Serie ist OpenAIs erste Frontier-Veröffentlichung, die als abgestufte Familie aus drei Modellen erscheint – Sol, Terra und Luna – statt als einzelnes Modell mit Reasoning-Umschaltern, wobei das Flaggschiff hinter einer Freigabe durch die US-Regierung steht. Diese Struktur ist die eigentliche Nachricht, mehr als jede einzelne Zahl.
Laut Vorschau sehen die drei so aus. Behandle die Preise als vorab genannte Zahlen, nicht als veröffentlichtes Preisverzeichnis – OpenAI hatte zum Zeitpunkt der Enthüllung keine offizielle Preisseite online, deshalb übernehme ich die Zahlen wie angegeben und weise entsprechend darauf hin.
Sol ist das Flaggschiff. Die Vorschau beschreibt es als Sprung mit Stufenfunktion gegenüber GPT-5.5 – kein Feinschliff-Release, sondern ein echter Generationswechsel. Berichtete Preise: rund 5 US-Dollar pro Million Input-Tokens und 30 US-Dollar pro Million Output-Tokens. Es führt zwei neue Reasoning-Stufen über der normalen Leiter ein – einen „Max-Reasoning"-Modus und einen „Ultra"-Modus, der mehrere Sub-Agenten auf eine einzige Aufgabe ansetzt. Es ist außerdem die eingeschränkte Stufe. Nur für freigegebene Partner.
Terra ist das ausgewogene Arbeitspferd. Die Vorschau siedelt die Leistung ungefähr auf Höhe von GPT-5.5 an, ausgerichtet auf effiziente Alltagsarbeit, zu einem Listenpreis, der angeblich bei rund der Hälfte von GPT-5.5 liegt. Das ist das Modell, zu dem die meisten Teams im Tagesgeschäft tatsächlich greifen würden – wenn sie es bekommen.
Luna ist der Volumenspieler. Schnell, günstig, bescheiden. Berichtete Preise: rund 1 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens. Gebaut für Hochdurchsatz-Lasten mit geringerem Einsatz, bei denen die Kosten pro Aufruf wichtiger sind als reine Intelligenz – Klassifikation, Massen-Extraktion, das unspektakuläre Rückgrat der meisten Produktions-KI.
Alle drei sollen ein Kontextfenster von rund 1,5 Millionen Tokens teilen. Wenn das stimmt, ist das ein bedeutender Sprung, und er landet die GPT-5.6-Serie im selben Long-Context-Terrain, das ich untersucht habe, als ich Opus 4.6s Million-Token-Fenster getestet habe – der Punkt, an dem „einfach die gesamte Codebasis in den Prompt packen" kein Partytrick mehr ist, sondern ein Workflow wird.
| Variante | Rolle | Berichtet Input / Output | Bemerkenswert | Verfügbarkeit |
|---|---|---|---|---|
| Sol | Flaggschiff | ~5 $ / ~30 $ pro Mio. Tokens | Max- + Ultra-Reasoning, Multi-Sub-Agent | Eingeschränkt – freigegebene Partner |
| Terra | Ausgewogen für den Alltag | ~2x günstiger als GPT-5.5 | ~GPT-5.5-Leistung | Erwartete breite Verfügbarkeit |
| Luna | Hohes Volumen | ~1 $ / ~6 $ pro Mio. Tokens | Günstiger Durchsatz | Erwartet als erstes allgemein verfügbar |
Beachte die Strategie in dieser Tabelle. OpenAI liefert nicht mehr ein Modell aus. Es liefert eine Leiter aus: ein intelligentes, reguliertes, teures Modell an der Spitze für ein winziges freigegebenes Publikum; eine praxistaugliche Mittelklasse; und eine günstige Durchsatzmaschine unten für alle anderen. Das ist eine bewusste Absicherung, und am Ende sehen wir, warum das Sinn ergibt.
Aber die Aufstellung ist nicht das Ungewöhnliche. Die verschlossene Tür ist es.
Warum GPT-5.6 Sol beim Launch abgeschottet blieb
Hier hört die GPT-5.6-Serie auf, wie ein normaler Launch auszusehen.
Die Vorschau war zeitlich seltsam gelegt – die breiteren Erwartungen hatten auf eine Veröffentlichung im Juni oder Juli gedeutet, stattdessen tauchte sie abrupt auf, mit nur einer begrenzten Vorschau über API und Codex, und nur für eine kleine Zahl von der US-Regierung freigegebener Partner. OpenAI verwies angeblich auf ein Dashboard, um die Berechtigung zu prüfen, wobei ein breiterer Zugang in zwei bis drei Wochen erwartet wurde. Sol selbst wird still an ausgewählte Nutzer verteilt, statt mit der üblichen Fanfare angekündigt zu werden.
Lies diesen Ablauf noch einmal, denn seine Form sagt mehr aus als jede offizielle Erklärung. Ein Frontier-Labor hat sein leistungsfähigstes Modell früh durch die Tür geschoben, an eine geprüfte Liste, unter der Art von Zugriffskontrollen, die man normalerweise um exportbeschränkte Hardware herum sieht, nicht um Chat-Modelle. Das ist keine Marketing-Entscheidung. Das ist ein Modell, das in eine regulatorische Umgebung startet, die sich grundlegend verändert hat.
Ich habe die frühen Erschütterungen davon behandelt, als der GPT-5.6-Eintrag zuerst in Codex-Session-Logs auftauchte, Wochen vor jeder offiziellen Meldung, und als der Druck durch Exportkontrollen zu formen begann, wer was liefern darf. Der Leak war das Gerücht. Die abgeschottete Vorschau ist das Gerücht, das zur Politik wird. Frontier-Modelle werden inzwischen von der US-Regierung und zunehmend auch von den Laboren selbst als Dual-Use-Technologie behandelt – dieselbe Kategorie wie die Chips, mit denen sie trainiert werden.
In den ersten Wochen, wenn du als Entwickler darauf gewartet hast, Sol in eine echte Pipeline zu bauen, war die praktische Erkenntnis nüchtern: Du konntest nicht darauf planen. Das änderte sich am 9. Juli, als Sol für die Öffentlichkeit freigegeben wurde – aber die Episode ist es wert, in Erinnerung behalten zu werden, weil das nächste Flaggschiff möglicherweise nicht so schnell entsperrt wird. Für die tiefere Zergliederung der konkreten Behauptungen zu Sol gegenüber überprüfbaren Daten bin ich in meinem GPT-5.6-Sol-Vorschau-Breakdown ausführlich geworden – dieser Post ist die größere Landkarte.
Und was soll Sol nun eigentlich tun, das ihm die Verschlusskiste eingebracht hat?
GPT-5.6 Sols Fähigkeiten: Bestätigt vs. Behauptet
Kurzfassung: OpenAI behauptet, Sol sei sein stärkstes Modell bisher, mit einem neuen State-of-the-Art auf Terminal-Bench 2.1 und Siegen über GPT-5.5, Claude Mythos 5, Claude Fable 5 und Gemini 3.1 Pro quer durch die Benchmark-Suite – aber nichts davon ist bislang unabhängig verifiziert, weil das Modell für die Öffentlichkeit faktisch offline ist.
Ich trenne die Ebenen auseinander, denn das ist wichtig.
Was heute überprüfbar ist: Terminal-Bench ist real, und es ist ein ernstzunehmender Benchmark. Er kam aus dem Laude Institute und wurde 2026 auf der ICLR veröffentlicht. Er setzt einen Agenten in einen Docker-Container mit einer Aufgabe, einem Zeitlimit und einer Reihe von Pytest-Validierungen – und die Bewertung ist Alles-oder-nichts, keine Teilpunkte, über 89 handgebaute Aufgaben aus Softwareentwicklung, Sicherheit, Systemadministration und Data Science. Version 2.1 ist die bereinigte Überarbeitung, die mehrdeutige Aufgaben aus Release 2.0 behoben hat. Stand Mitte Juni 2026 lag Codex zusammen mit GPT-5.5 im öffentlichen Leaderboard bei 83,4 % und Claude Code mit Fable 5 knapp dahinter bei 83,1 %. Wenn die Vorschau also sagt, Sol setze einen neuen SOTA auf Terminal-Bench 2.1, weiß ich genau, welche Zahl es zu schlagen behauptet, und es ist eine Zahl aus einem glaubwürdigen, reproduzierbaren Harness. Das ist der stärkste Teil der Behauptung.
Was behauptet, aber unbestätigt ist: alles Vergleichende. „Schlägt Mythos 5, Fable 5, Gemini 3.1 Pro." Vielleicht. Zum Zeitpunkt der Vorschau konnten wir es nicht überprüfen, weil Sol für unabhängiges Benchmarking nicht zugänglich war – es schien komplett offline zu sein, was genau die öffentlichen Tests verzögerte, die die Zahlen bestätigen oder zerlegen würden. Diese Tests wurden erst möglich, als Sol am 9. Juli öffentlich wurde. Ich habe genügend Launches gesehen, um allergisch auf einen Benchmark zu reagieren, den man nicht reproduzieren kann. Verbuche diese Punkte unter „OpenAI behauptet", nicht unter „OpenAI hat gezeigt".
Die zwei Fähigkeitsstränge, die mich wirklich interessieren:
Erstens, Cybersecurity und harte Wissenschaften. Die Vorschau hebt große Fortschritte in Biologie und Cybersecurity hervor, und eine konkrete, prinzipiell überprüfbare Behauptung: Sol soll Mythos bei fortgeschrittener Schwachstellenforschung mit rund einem Drittel der Output-Tokens ebenbürtig sein. Wenn das stimmt, ist das eine große Sache – nicht wegen der Fähigkeit allein, sondern weil Token-Effizienz bei offensiven Security-Aufgaben genau die Art von Sache ist, die ein Modell sowohl nützlicher als auch gefährlicher macht. Was, nicht zufällig, der Grund ist, warum es abgeschottet ist.
Zweitens, die neuen Reasoning-Modi. „Max Reasoning" und „Ultra" – letzterer setzt mehrere Sub-Agenten auf ein einzelnes Problem an. Die Vorschau beschreibt außerdem ein größeres internes Reasoning-Budget bei höheren Reasoning-Stufen. Ich will hier ehrlich etwas kennzeichnen: Die Originalquelle warf für dieses Budget eine konkrete Token-Zahl ein, die einer Prüfung nicht standhält – sie liest sich wie eine verstümmelte Zahl, deshalb wiederhole ich sie nicht als Fakt. Die Richtungsangabe ist der glaubwürdige Teil: Bei höheren Reasoning-Einstellungen denkt Sol länger und härter, und „Ultra" sieht danach aus, dass OpenAI das Muster der Multi-Agent-Orchestrierung produktisiert, das man bis jetzt selbst bauen musste. Wenn du verfolgt hast, wie Agent-Teams in echten Tests tatsächlich abschneiden, weißt du, dass das der harte, wertvolle Teil ist – und ihn in einen Reasoning-Umschalter einzubacken, ist ein echter Schritt.
Behauptungen sind aber billig. Die Vorschau stützte sich auf Demos. Sehen wir uns die an.
Die Demos: Beeindruckend, aber sorgfältig lesen
Die Vorschau schob eine Handvoll One-Shot-Builds vor, und die ehrliche Zusammenfassung lautet: wirklich beeindruckend, klar ein Sprung gegenüber GPT-5.5 und nicht so sauber, wie die Highlight-Reel-Version suggeriert.
Die Aushängeschilder, wie präsentiert:
- Ein Minecraft-artiger Klon in etwa 90 Minuten – Landing Page, Auswahl von Spielmodi, Wüstenbiome und Mobs, Wolken- und Block-Abbau-Animationen, ein Tag-Nacht-Zyklus. Der Haken, in der Vorschau selbst zugegeben: Manche Interaktionen, etwa das Aufheben von Blöcken, funktionierten nicht vollständig. Lebensechter als das, was Fable produzierte, aber die Quelle sagte offen, dass es Fable 5 in der Gesamt-Raffinesse nicht übertrifft.
- Eine Simulation für den SpaceX-Starship-Booster-Catch – realistische Klemmmechanik und ein glaubwürdiges Verständnis der Physik und Robotik. Der „Chopsticks-Catch" ist etwas, das überzeugend zu simulieren wirklich schwer ist, deshalb hat dieser meine Aufmerksamkeit verdient.
- Ein Pokémon-artiges RPG in etwa 31 Minuten – im Emulator-Stil, mehrere Arenen, acht Orden, Starter-Auswahl, eine Endgame-Liga. Bewusst so gebaut, dass Copyright-Probleme vermieden werden.
- Ein Voxel-3D-Welt-Generator in etwa 44,5 Minuten.
Die Vorschau beschrieb den Sprung von 5.5 zu Sol als „absurd", besonders bei Coding, Frontend, Full-Stack und Simulationsarbeit. Ich glaube die Richtung. Ich bin skeptisch gegenüber der Rahmung. Warum die Zeile „manche Interaktionen liefen nicht" wichtiger ist als der Demo-Glanz: Ein Modell, das einen wunderschönen Minecraft-Klon baut, in dem man keine Blöcke aufheben kann, ist ein Modell, das im Erzeugen plausibler Struktur spektakulär ist und beim Schließen der Schleife zu interaktiver Korrektheit noch unvollkommen. Genau die Lücke, in die ich beim Fahren echter Agent-Loops ständig gerate – das Ding sieht fertig aus und ist es nicht, und die letzten 10 % sind die Stelle, wo das eigentliche Engineering wohnt.
Meine Lesart also: Die GPT-5.6-Serie ist ein echter Fähigkeitssprung, die Demos sind der Richtung nach ehrlich, dass sie Fable 5 nicht schlagen, und wer dir sagt „Sol baut jetzt Produktions-Apps in einem Schuss", verkauft dir den Trailer, nicht den Film. Wir werden es nicht wissen, bevor es zum Testen offen ist – und auch das ist abgeschottet.
Damit sind wir bei dem Modell, das am härtesten abgeschottet wurde.
Der Fable-5-Bann: Wenn ein Modell zum nationalen Sicherheitsproblem wird
Anthropics Fable 5 wurde verboten. Nicht rate-limitiert, nicht auf eine Warteliste gesetzt – gezogen, für rund zwei Wochen, aus Gründen der nationalen Sicherheit, angeblich wegen seiner Fähigkeit, das Hacken in Sicherheitssysteme der US-Regierung zu reproduzieren.
Halte dir vor Augen, wie ungewöhnlich das ist. Wir hatten Modelle, die Aufgaben verweigert haben. Wir hatten Labore, die Launches verschoben haben. Wir hatten in der öffentlichen Ära der Frontier-KI noch nie den Fall, dass ein Staat ein Flaggschiff-Kommerzmodell effektiv ausschalten ließ, wegen dem, was es in den falschen Händen anrichten könnte. Das ist eine neue Kategorie von Ereignis, und es ist das bislang klarste Signal, dass die leistungsfähigsten Modelle jetzt eher wie waffen-nahe Technologie regiert werden als wie Softwareprodukte.
Hier steht, was bestätigt versus berichtet ist, denn die Nuance ist die ganze Geschichte:
Bestätigt (laut Anthropics eigener Erklärung): Seit dem 12. Juni arbeitet Anthropic mit US-Beamten zusammen, um Mythos 5 und Fable 5 wieder freizuschalten. Mythos 5 wurde einer begrenzten Gruppe von Organisationen kritischer Infrastruktur wiederhergestellt – angeblich in der Größenordnung von 100 Organisationen – wobei sich der Zugang schrittweise erweitert, statt einfach zurück auf offen zu klappen. Der öffentliche Zugang bleibt stark eingeschränkt, unter strengen Kontrollen und Sicherheitsprotokollen.
Berichtet / gerüchteweise: Dass die Trump-Administration nach dem etwa zweiwöchigen Ausfall kurz davor stand, breiteren Zugang wiederherzustellen, möglicherweise innerhalb jener Woche, mit Verhandlungen kurz vor dem Abschluss – und dass das wiederhergestellte Modell wahrscheinlich abgeschwächt würde: strengere Sicherheit, reduzierte Fähigkeiten in den sensibelsten Cybersecurity-Bereichen. Behandle das als Berichterstattung, nicht als Fakt. Die Richtungsangabe – „kommt zurück, aber enger" – ist quellenübergreifend konsistent; das konkrete Timing ist der weiche Teil.
Ich habe die Mechanik nachgezeichnet, wie sich ein verbotenes Frontier-Modell zurück in einen eingeschränkten Dienst kämpft, in meinem Breakdown der Rückkehr von Fable 5, und das Muster von damals gilt auch hier: Wiederherstellung ist kein Schalter, sondern eine Verhandlung, und das Modell, das zurückkommt, ist nicht das Modell, das gegangen ist. Wer auf Anthropics Frontier-Stufe baut, sollte diese operative Realität verinnerlichen – Fähigkeit auf diesem Niveau kommt jetzt mit einer Governance-Schicht, die du nicht kontrollierst.
Und nein, das ist nicht ein CEO, der die Regierung zu irgendetwas überredet. Ich gehe dieses Argument direkt an, weil es überall auftaucht.
Hat Dario Amodei die Frontier per „Angstmache" in die Abschottung getrieben?
Es gibt online ein lautes Narrativ, Anthropic-CEO Dario Amodei habe die US-Regierung dazu gebracht, Frontier-Modelle einzuschränken – die ganze Erzählung von der nationalen Sicherheit sei Panikmache eines CEOs, der von regulatorischen Burggräben profitiert. Ich kaufe das nicht ab, und ich will so klar wie möglich darlegen, warum.
Die US-Regierung verbietet ein Modell nicht auf das Wort eines einzelnen Managers. Eine Entscheidung wie das Ziehen von Fable 5 läuft durch mehrere Behörden – die NSA, die Nachrichtendienstgemeinde, spezialisierte Cybersecurity-Fachleute – von denen jede ihre eigene, unabhängige Risikoeinschätzung vornimmt. Wenn ein Modell glaubwürdig dabei helfen kann, Regierungssysteme zu kompromittieren, ist das keine Stimmung, die ein CEO in einem Podcast fabrizieren kann. Das ist ein Befund, ausgewertet von Menschen, deren gesamter Job darin besteht, genau diese Art von Bedrohung zu bewerten.
Die wahrscheinliche Motivation dreht sich nicht einmal primär um Missbrauch im Inland. Sie dreht sich um Gegner – frontier-taugliche offensive Cyber-Fähigkeiten aus den Händen rivalisierender Staaten zu halten, allen voran China. Das ist eine strategische Kalkulation, die unabhängig davon existiert, ob irgendein KI-Executive je öffentlich ein Wort sagt.
Es gab angeblich einige Kommunikationslücken auf Anthropics Seite früh in der Episode – aber das ist ein separates operatives Thema, nicht die Ursache des Banns. „Anthropic hat die Kommunikation unvollkommen gehandhabt" mit „Anthropic hat die Politik gestaltet" gleichzusetzen, ist genau die Art von interessengeleitetem Denken, die für gute Reichweite und schlechte Analyse sorgt.
Ich bin ehrlich mit dir, wo ich lande, weil es kein bequemer Ort ist. Ich will breiten öffentlichen Zugang zu Frontier-Modellen – dort kommt die Innovation her, die mir wichtig ist, das Zeug, auf dem ich meine Arbeit baue. Und ich erkenne auch an, dass ein Modell, das ernsthaft in der Lage ist, kritische Infrastruktur anzugreifen, ein anderes Objekt ist als ein Chatbot, und das Gegenteil zu behaupten, um online einen Streit zu gewinnen, hilft niemandem. Das ist meine Lesart der Fakten, kein Aufstellen in einer politischen Mannschaft. Die Einschränkungen sehen nach dem Ergebnis echter institutioneller Risikoeinschätzung aus, nicht nach dem Lobbying eines einzelnen Mannes.
Wenn das Ziel ist, diese Fähigkeit von Gegnern fernzuhalten, gibt es hier ein Problem: Die Gegner bauen sie auch.
Chinas GLM-5.2: Das Cybersecurity-Rennen kennt keine Bremsen
Chinas Z.ai hat im Juni 2026 GLM-5.2 als Open-Weight-Modell unter MIT-Lizenz veröffentlicht – einen Tag nach dem Zuschlagen der Exportkontrollen auf Fable 5 – und die Behauptung, die zählt, lautet: Es hält bei der Schwachstellensuche mit Claude mit. Das ist nicht nur das Wort von Z.ai: Semgreps unabhängiger IDOR-Benchmark bewertete GLM-5.2 mit 39 % F1, vor Claude bei rund 32 % – genau die Fähigkeit, die westliche Frontier-Modelle überhaupt erst hat abschotten lassen.
Ob diese Behauptung real-world oder nur benchmark-only ist, ist ehrlich gesagt unbestätigt, und dabei will ich es belassen. „Auf einem Benchmark ebenbürtig" und „in einem echten Einsatz gegen ein gehärtetes Ziel ebenbürtig" sind sehr unterschiedliche Dinge, und die Kluft zwischen ihnen ist genau der Ort, an dem viel Modell-Hype stirbt. Also: unbestätigt, aufmerksam beobachten.
Aber das Signal ist unmissverständlich, egal ob die exakte Parität-Behauptung Bestand hat. Cybersecurity ist zum zentralen Schlachtfeld des US-chinesischen KI-Rennens geworden, und es gibt keinen Hinweis auf eine Verlangsamung auf der chinesischen Seite. Ich verfolge die Entwicklung von GLM schon eine Weile – als ich GLM gegen Qwen und Opus gebenchmarkt habe, war die Erkenntnis, dass die chinesischen Open-Weight-Modelle die Lücke schneller schließen, als das gemütliche westliche Narrativ zugeben wollte. Dass GLM-5.2 frontier-taugliche Schwachstellensuche erreicht, wäre, falls es stimmt, dieser Trend, der bei der strategisch sensibelsten Fähigkeit ankommt, die es gibt.
Hier ist die unbequeme strategische Schleife. Die USA schotten Fable 5 ab, um offensive Cyber-Fähigkeit von China fernzuhalten. China liefert GLM-5.2, Open-Weight und MIT-lizenziert, mit unabhängig getesteter vergleichbarer Fähigkeit trotzdem aus. Die Absperrung schützt die USA davor, einen Gegner zu beschleunigen, den sie vielleicht gar nicht wirklich verlangsamen können. Diese Spannung hat keine saubere Auflösung, und jede Analyse, die so tut, als hätte sie eine, ist nicht ehrlich mit dir. Für den tieferen Tauchgang, warum ausgerechnet Cyber-Fähigkeiten der Zündpunkt sind, habe ich das in meinem Beitrag über Mythos und Cybersecurity auseinandergenommen.
Während die Frontier abgeriegelt und umkämpft wird, ist im Geschäft darunter etwas Leiseres und wohl Wichtigeres passiert.
Anthropics Enterprise-Schub: Das Spiel ist zu den Workflows gewandert
Und hier ist die Entwicklung, um die sich Entwickler tatsächlich neu ordnen sollten: Anthropics Enterprise-Geschäft ist von Ende 2025 bis Anfang 2026 stark gestiegen, und nach mehreren unabhängigen Messungen hat es OpenAI in dem Teil des Marktes überholt, der zahlt – Unternehmensausgaben für KI-Developer-Tools.
Diese Sache kann ich mit überprüfbaren Daten belegen, und sie ist eindrucksvoll. Laut Enterprise-Ausgaben-Tracking hält Claude Code 2026 rund 54 % der Unternehmens-Coding-Ausgaben gegenüber OpenAIs 21 % – und Coding macht mittlerweile mehr als die Hälfte des gesamten Unternehmens-Einsatzes generativer KI aus. Ramps AI Index zeigte, dass Anthropic über 73 % der Ausgaben unter Unternehmen einfängt, die zum ersten Mal KI-Tools kaufen. Und im April 2026 kippte die Geschäftsübernahme über eine Linie, die vorher nicht überschritten worden war: Anthropic bei 34,4 % gegenüber OpenAI bei 32,3 % – das erste Mal, dass Anthropic OpenAI in der Enterprise-Adoption anführte. Menlo Ventures verortete die Enterprise-LLM-Ausgaben grob bei 40 % Anthropic zu 27 % OpenAI. Die Quellen widersprechen sich in der genauen Größenordnung. Sie sind sich in der Richtung einig.
Was hat sich also verändert? Der Wettbewerb dreht sich nicht mehr darum, welches Labor das beste Modell hat, sondern darum, in wessen täglichen Workflow das Modell eingebettet ist. Ich komme immer wieder auf die Windows/Office-Analogie aus den 1990ern zurück. Microsoft hat nicht gewonnen, weil es immer die beste einzelne Anwendung geliefert hat – es hat gewonnen, weil seine Software zu dem wurde, was man jeden Morgen ohne nachzudenken geöffnet hat. Anthropic spielt dieses Playbook mit Engineering-Teams durch: Claude Code lebt im Terminal, im Review-Zyklus, an dem Ort, an dem die Arbeit tatsächlich stattfindet. Sobald ein Tool im täglichen Loop eines Teams lasttragend ist, werden die Wechselkosten – nicht der Benchmark-Score – zum entscheidenden Faktor.
Das ist die eigentliche Verschiebung, in die die GPT-5.6-Serie hineinstartet. Das Wettrüsten dreht sich jetzt um Workflow-Ökonomie: Reibungsreduktion, Governance, Integration und nachweisbare Wertschöpfung – schnelleres Coden, weniger Bugs, kürzere Code-Review-Zyklen – nicht um zwei Punkte mehr in einem Eval. Ein Modell, das man demonstrieren kann, und ein Modell, das in das Muskelgedächtnis von zehntausend Ingenieuren eingewoben ist, sind sehr unterschiedliche Vermögenswerte, und den zweiten wieder herauszulösen, ist deutlich schwerer.
Zwei ehrliche Einschränkungen, denn die triumphalistische Version dieser Geschichte ist falsch. Erstens ist ein Anstieg keine Krönung – das ist nicht OpenAIs Niederlage. OpenAI bleibt stark wettbewerbsfähig, besonders in breiterer Produktivität und am günstigeren Ende des Marktes, weshalb es die Luna-Stufe überhaupt gibt. Zweitens ist der Enterprise-KI-Markt komplex und segmentiert; „Anthropic führt bei Coding-Ausgaben" und „OpenAI führt bei Consumer-Reichweite" sind gleichzeitig wahr. Wer das zu „X hat gewonnen" plattdrückt, verkauft ein Narrativ, kein Marktbild.
Ein weiterer Bewerber hat gerade das Feld betreten, und er trägt ein Tesla-Abzeichen.
Grok 4.5: Musks Coding-Schachzug, in privater Beta
Elon Musk sagt, Grok 4.5 sei in privater Beta innerhalb von SpaceX und Tesla, und nähere sich angeblich Claude-Opus-Niveau – wobei unklar ist, welche Opus-Version genau gemeint ist.
Die interessante technische Behauptung: Grok 4.5 basiere angeblich auf xAIs rund 1,5 Billionen Parameter großem „V9"-Foundation-Modell, dann weitertrainiert mit Cursors Daten, um das Coden zu schärfen. Wenn dieses Detail stimmt, ist es ein Hinweis auf die Strategie – xAI skaliert nicht nur ein Basismodell, es zielt gezielt auf den Coding-Agent-Markt und trainiert auf der Art echter Editier-Daten, die ein Modell in dem Loop gut machen, den Entwickler tatsächlich fahren. Das ist ein direkter Schuss auf das Segment, in dem Anthropic aktuell dominiert.
Halte die Skepsis aber richtig kalibriert. „In privater Beta bei SpaceX und Tesla" bedeutet, dass Musks eigene Firmen die Tester sind, was ungefähr das freundlichste Bewertungsumfeld ist, das es gibt. „Nähert sich Opus-Niveau" mit unklarer Versionsnummer ist eine weiche Behauptung, verpackt um eine hart klingende Parameterzahl. Ich würde Grok 4.5 solide in die Spalte „öffentliche Benchmarks beobachten, Founder-Tweets ignorieren" einsortieren, bis es etwas Reproduzierbares gibt. Aber die Absicht ist klar und glaubwürdig: xAI will ein ernsthafter Coding-Konkurrent sein und trainiert gezielt für diesen Kampf.
Was heißt all das nun für einen Entwickler, der echte Entscheidungen treffen will?
Was hier wirklich zählt (Die Entwickler-Sicht)
Tritt einen Schritt zurück von den Modellnamen und Benchmark-Behauptungen, und diesen Monat sind drei Dinge gleichzeitig wahr – und alle drei sind haltbarer als jede einzelne Veröffentlichung.
Erstens: Die Spitze der Frontier wird nach nationaler Sicherheit regiert, und das ist kein vorübergehender Schluckauf. GPT-5.6 Sol, das zunächst nur freigegebenen Partnern zur Verfügung stand, bevor es am 9. Juli geöffnet wurde, Fable 5, das gebannt und unter strengeren Kontrollen teilweise wiederhergestellt wurde, Mythos 5, das zu rund 100 Organisationen kritischer Infrastruktur zurücktröpfelt – das sind nicht getrennte Geschichten. Es ist dieselbe Geschichte. Die leistungsfähigsten Modelle werden als strategische Dual-Use-Technologie regiert. Wenn deine Roadmap annimmt, dass du am selben Tag API-Zugriff auf das jeweils Stärkste bekommst, baue diese Annahme jetzt um.
Zweitens: Das Wettbewerbsspiel hat sich von Benchmark-Vorherrschaft zur Workflow-Integration verlagert. Anthropic hat OpenAI bei den Enterprise-Coding-Ausgaben nicht durch einen Benchmark-Sieg überholt – es hat es geschafft, indem es zum Tool wurde, das Ingenieure ohne nachzudenken öffnen. Für diejenigen von uns, die Produkte auf diesen Modellen bauen, ist das die Lektion zum Übernehmen: Der Burggraben ist nicht das Modell, sondern wie tief dein Ding im täglichen Loop von jemandem lebt. Ich habe das aus Bausicht in meinem Beitrag über den Weg zu agent-native argumentiert, und die Enterprise-Daten haben es gerade mit Geld bestätigt.
Drittens: Geopolitik ist jetzt eine Variable in der Modellauswahl. GLM-5.2, das angeblich mit Mythos bei der Schwachstellensuche mithält, bedeutet: Die Absperrung, die die USA schützt, verlangsamt vielleicht die globale Verbreitung der Fähigkeit gar nicht. Für Entwickler übersetzt sich das in eine praktische Realität: Welches Modell du nutzen darfst, wo es legal laufen darf und was es tun darf, wird genauso wichtig wie, wie klug es ist.
Wenn ich den ganzen Monat für eine beschäftigte Ingenieurin in einen Satz pressen müsste: Höre auf, rein für das intelligenteste Modell zu optimieren, und fang an, für das intelligenteste Modell zu optimieren, das du in deiner Jurisdiktion, innerhalb des Workflows, den du bereits besitzt, tatsächlich einsetzen kannst. Das ist ein weniger aufregender Satz als „Sol baut in einem Schuss einen Minecraft-Klon". Es ist auch der Satz, der im nächsten Quartal noch wahr ist.
Ich kam nach zwei Wochen Abwesenheit zurück und dachte, ich hätte einen Benchmark-Krieg verpasst. Was ich tatsächlich betrat, war der Moment, in dem sich die Regeln änderten – als die Frage aufhörte zu lauten wie gut ist das Modell und wurde wer darf es benutzen, und ist es schon Teil davon, wie du arbeitest. Die Labore, die das nächste Jahr gewinnen, werden nicht die mit der höchsten Zahl in einer Grafik sein, die niemand außerhalb einer geheimen Partnerliste reproduzieren kann. Sie werden die sein, deren Modelle in deinem Tag still lasttragend werden, bevor du überhaupt merkst, dass du aufgehört hast, sie zu wählen.
Deshalb ist hier die Frage, mit der ich heute Abend sitzen würde, egal woran du baust: Wenn das stärkste Modell der Welt hinter einer Regierungsfreigabe eingesperrt wird, die du niemals bekommen wirst – ist dein Produkt darauf ausgelegt, mit roher Intelligenz zu gewinnen, oder damit, wie tief es in der Arbeit lebt? Denn eines davon ist jetzt abgeschottet. Das andere gehört immer noch dir zum Verdienen.
Häufig gestellte Fragen
Was ist die GPT-5.6-Serie?
Die GPT-5.6-Serie ist OpenAIs abgestufte Frontier-Veröffentlichung aus drei Modellen – Sol (Flaggschiff), Terra (ausgewogen) und Luna (hohes Volumen) – jedes auf einen anderen Preis-Leistungs-Punkt abgestimmt. Die Flaggschiff-Stufe Sol ist auf von der US-Regierung freigegebene Partner beschränkt. Den vollen Überblick gibt es im Modellabschnitt oben.
Warum wurde Anthropics Fable 5 verboten?
Fable 5 wurde angeblich für rund zwei Wochen aus Gründen der nationalen Sicherheit gezogen, wegen seiner Fähigkeit, das Hacken in Sicherheitssysteme der US-Regierung zu reproduzieren. Laut Anthropics eigener Erklärung kooperiert das Unternehmen seit dem 12. Juni mit US-Beamten, um Fable 5 und Mythos 5 unter strengeren Kontrollen und eingeschränktem Zugang wieder freizuschalten.
Ist GPT-5.6 Sol öffentlich verfügbar?
Ja, seit dem 9. Juli 2026. Sol war in den ersten Wochen nur in eingeschränktem Rollout über API und Codex an vorab freigegebene US-Partner verfügbar, aber die US-Regierung genehmigte am 9. Juli eine breite Freigabe, und OpenAI öffnete Sol zusammen mit Terra und Luna für die Öffentlichkeit.
Hat Anthropic OpenAI im Enterprise überholt?
Nach mehreren unabhängigen Messungen ja – im Segment der Developer-Tools. Enterprise-Daten aus 2026 zeigen, dass Claude Code rund 54 % der Unternehmens-Coding-Ausgaben hält gegenüber OpenAIs 21 %, und der April 2026 markierte den ersten Monat, in dem Anthropic OpenAI in der Gesamt-Geschäftsübernahme anführte. OpenAI bleibt stark in Consumer-Reichweite und den günstigeren Stufen.
Ist Chinas GLM-5.2 wirklich so leistungsfähig wie Claude bei Cybersecurity?
Bei der Schwachstellensuche sagen unabhängige Tests ja: Semgreps IDOR-Benchmark bewertete das Open-Weight-Modell GLM-5.2 mit 39 % F1, vor Claudes rund 32 %. Benchmarks sind nicht die ganze Geschichte, aber das ist nicht nur eine Anbieterbehauptung. Das breitere Signal ist unabhängig davon klar: Chinas Frontier-KI-Entwicklung zeigt keine Verlangsamung, wobei Cybersecurity ein zentrales Schlachtfeld ist.
Auf einer Frontier bauen, die sich ständig bewegt?
Wenn sich Modellzugang, Preise und Exportregeln von Monat zu Monat verschieben, ist der haltbare Schachzug eine Architektur, die Modelle austauschen kann, ohne dass du deinen Stack umschreiben musst. Diese Portabilität zu entwerfen – und das Routing und die Leitplanken drumherum – ist die Arbeit, die ich übernehme. Wenn das ein Problem ist, das du lieber abgibst, hier findest du mich.