La serie GPT-5.6 y la frontera cerrada de la IA: una lectura desde el lado del builder
Volví de dos semanas de viaje esperando ponerme al día con un ciclo de noticias tranquilo. En lugar de eso, abrí mi feed y me encontré con que OpenAI había presentado en silencio toda una serie GPT-5.6 —Sol, Terra, Luna— dos días antes de que nadie estuviera listo, y la reacción más ruidosa no fue por los benchmarks. Fue sobre quién tiene permiso para tocar la cosa.
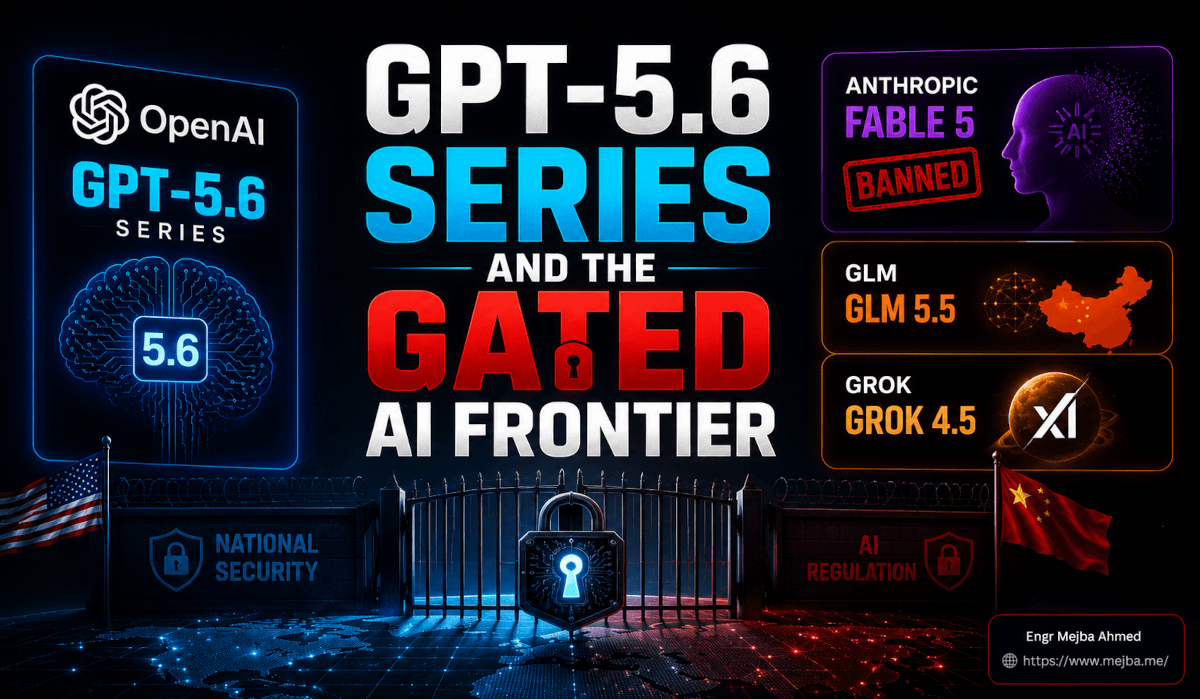
Aquí está la parte que reorganizó cómo estoy pensando este momento entero. Durante tres años, un lanzamiento frontier significaba una sola cosa: un post en el blog, un gráfico de benchmark y una API key que podías pegar en tu terminal esa misma tarde. La serie GPT-5.6 rompió ese ritual. El buque insignia está bloqueado detrás de una autorización del gobierno de EE. UU. El modelo más capaz de Anthropic fue prohibido directamente durante dos semanas. Y se dice que el próximo modelo de coding de China iguala al mejor modelo cibernético occidental en descubrimiento de vulnerabilidades. La frontera no solo se volvió más inteligente este mes. Se volvió cerrada.
Quiero ser directo contigo antes de seguir, porque la mitad de los posts que vas a leer sobre esto van a fingir lo contrario. Cuando esta preview salió a la luz por primera vez yo no había probado GPT-5.6 Sol —estaba fuera de EE. UU. cuando se lanzó, y aun dentro del país estaba restringido a una lista corta de socios pre-autorizados. (Esa puerta se abrió el 9 de julio de 2026, cuando OpenAI abrió Sol al público tras una autorización gubernamental amplia.) La persona que sacó a la luz la preview tampoco podía acceder del todo. Así que esto no es una reseña con las manos en la masa. Es algo que creo más útil ahora mismo: un builder tomando cada afirmación de la preview, separando lo confirmado de lo rumoreado, cruzando las partes verificables con datos reales, y sacando el único hilo conductor que de verdad importa para el resto de nosotros.
Ese hilo es este: el juego dejó de ser "quién tiene el benchmark más alto" y pasó a ser "quién puede usar el modelo, dónde se permite ejecutarlo y dentro del workflow de quién ya vive". Déjame llevarte por todo lo que se movió y por qué.
¿Qué es la serie GPT-5.6? Desglose de los tres modelos
La serie GPT-5.6 es el primer lanzamiento frontier de OpenAI que llega como una familia escalonada de tres modelos —Sol, Terra y Luna— en lugar de un único modelo con conmutadores de razonamiento, con el buque insignia bloqueado detrás de la aprobación del gobierno de EE. UU. Esa estructura es la noticia, más que cualquier cifra individual.
Según la preview, así se desglosan los tres. Trata los precios como cifras de preview, no como una tarifa publicada —OpenAI no había publicado una página oficial de precios cuando esto salió, así que llevo los números tal cual se declararon y los marco como tales.
Sol es el buque insignia. La preview lo enmarca como un salto de función escalón sobre GPT-5.5 —no un lanzamiento de pulido, un movimiento generacional genuino. Precio reportado: aproximadamente 5 USD por millón de tokens de entrada y 30 USD por millón de tokens de salida. Introduce dos nuevos niveles de razonamiento por encima de la escalera normal —un modo "max reasoning" y un modo "ultra" que despliega múltiples subagentes sobre una sola tarea. También es el tier restringido. Solo socios autorizados.
Terra es el caballo de batalla equilibrado. La preview lo posiciona con rendimiento aproximadamente comparable a GPT-5.5, dirigido al trabajo eficiente del día a día, a un precio de lista reportado en torno a la mitad del de GPT-5.5. Este es el que la mayoría de equipos usaría realmente día a día —si pueden conseguirlo.
Luna es la jugada de volumen. Rápido, barato, modesto. Precio reportado: unos 1 USD por millón de tokens de entrada y 6 USD por millón de tokens de salida. Construido para cargas de alto throughput y menor riesgo donde te importa más el coste por llamada que la inteligencia bruta —clasificación, extracción masiva, la columna vertebral poco glamorosa de la mayoría de la IA en producción.
Los tres, según se reporta, comparten una ventana de contexto de alrededor de 1,5 millones de tokens. Si eso se mantiene, es un salto significativo, y coloca la serie GPT-5.6 en el mismo territorio de contexto largo que exploré cuando probé la ventana de un millón de tokens de Opus 4.6 —el punto en el que "simplemente mete todo el codebase en el prompt" deja de ser un truco de fiesta y empieza a ser un workflow.
| Variante | Rol | Entrada / salida reportadas | Notable | Disponibilidad |
|---|---|---|---|---|
| Sol | Buque insignia | ~5 USD / ~30 USD por M tokens | Razonamiento Max + Ultra, multi-subagente | Restringido — socios autorizados |
| Terra | Diario equilibrado | ~2x más barato que GPT-5.5 | Rendimiento ~GPT-5.5 | Se espera amplia |
| Luna | Alto volumen | ~1 USD / ~6 USD por M tokens | Throughput barato | Se espera GA primero |
Fíjate en la estrategia de esa tabla. OpenAI ya no está lanzando un modelo. Está lanzando una escalera: un modelo inteligente, regulado y caro en la cima para una pequeña audiencia autorizada; un tier medio práctico; y un motor de throughput barato en la base para todos los demás. Es una cobertura deliberada, y al final veremos por qué tiene sentido.
Pero el lineup no es la parte inusual. La puerta cerrada sí.
Por qué GPT-5.6 Sol se mantuvo bloqueado al lanzarse
Aquí es donde la serie GPT-5.6 deja de parecerse a un lanzamiento normal.
La preview estuvo curiosamente cronometrada —las expectativas más amplias apuntaban a un lanzamiento en junio o julio, y en su lugar salió a la luz de manera abrupta, con solo una preview limitada disponible a través de la API y Codex, y solo para un pequeño número de socios aprobados por el gobierno de EE. UU. OpenAI, según se reporta, envió a la gente a un dashboard para comprobar la elegibilidad, con acceso más amplio esperado en dos o tres semanas. Sol en sí se está desplegando en silencio a usuarios seleccionados en lugar de anunciarse con la fanfarria habitual.
Vuelve a leer esa secuencia, porque la forma que tiene te dice más que cualquier declaración oficial. Un laboratorio frontier sacó su modelo más capaz por la puerta pronto, a una lista examinada, bajo el tipo de controles de acceso que normalmente ves en torno a hardware con restricciones de exportación, no a modelos de chat. Eso no es una elección de marketing. Es un modelo lanzándose a un entorno regulatorio que ha cambiado fundamentalmente.
Cubrí los primeros temblores de esto cuando la entrada de GPT-5.6 se filtró por primera vez en los logs de sesiones de Codex semanas antes de cualquier palabra oficial, y cuando la presión de los controles de exportación empezó a rediseñar quién puede lanzar qué. La filtración era el rumor. La preview cerrada es el rumor volviéndose política. Los modelos frontier están siendo tratados ahora, por el gobierno de EE. UU. y cada vez más por los propios laboratorios, como tecnología de doble uso —la misma categoría que los chips que los entrenan.
Durante sus primeras semanas, si eras un builder esperando meter Sol en un pipeline real, la conclusión práctica era desapasionada: no podías planificar en torno a él. Eso cambió el 9 de julio, cuando Sol se abrió al público —pero el episodio vale la pena recordar, porque el próximo buque insignia puede que no se desbloquee tan rápido. Para la disección más profunda de las afirmaciones específicas de Sol frente a datos verificables, me extendí en mi desglose de la preview de GPT-5.6 Sol —este post es el mapa más amplio.
Ahora bien, ¿qué se supone que Sol realmente hace que le ganó la caja fuerte?
Capacidades de GPT-5.6 Sol: confirmadas frente a afirmadas
Versión corta: OpenAI afirma que Sol es su modelo más fuerte hasta la fecha, marcando un nuevo estado del arte en Terminal-Bench 2.1 y superando a GPT-5.5, Claude Mythos 5, Claude Fable 5 y Gemini 3.1 Pro a través de su suite de benchmarks —pero nada de eso está verificado de forma independiente todavía, porque el modelo está efectivamente fuera de línea para el público.
Déjame separar las capas, porque esto importa.
Lo verificable hoy: Terminal-Bench es real, y es un benchmark serio. Salió del Laude Institute y se publicó en ICLR 2026. Suelta a un agente en un contenedor Docker con una tarea, un límite de tiempo y un conjunto de validaciones pytest —y es todo-o-nada en la puntuación, sin crédito parcial, a través de 89 tareas construidas a mano que abarcan ingeniería de software, seguridad, sysadmin y ciencia de datos. La versión 2.1 es la revisión limpia que arregló las tareas ambiguas del lanzamiento 2.0. A mediados de junio de 2026, el leaderboard público tenía a Codex emparejado con GPT-5.5 al 83,4% y a Claude Code con Fable 5 justo detrás al 83,1%. Así que cuando la preview dice que Sol establece un nuevo SOTA en Terminal-Bench 2.1, sé exactamente qué número está afirmando superar, y es un número de un arnés creíble y reproducible. Esa es la parte más fuerte de la afirmación.
Lo afirmado pero no verificado: Todo lo comparativo. "Supera a Mythos 5, Fable 5, Gemini 3.1 Pro". Quizás. En el momento de la preview no podíamos comprobarlo, porque Sol no era accesible para benchmarking independiente —parecía estar completamente fuera de línea, lo que retrasó exactamente las pruebas públicas que confirmarían o pincharían los números. Esas pruebas solo fueron posibles cuando Sol se hizo público el 9 de julio. He visto suficientes lanzamientos como para ser alérgico a un benchmark que no puedes reproducir. Archiva esto bajo "OpenAI afirma", no "OpenAI demostró".
Los dos hilos de capacidad que genuinamente me interesan:
Primero, ciberseguridad y ciencias duras. La preview señala grandes avances en biología y ciberseguridad, y una afirmación específica, comprobable en principio: Sol, según se reporta, iguala a Mythos en investigación avanzada de vulnerabilidades usando aproximadamente un tercio de los tokens de salida. Si eso se mantiene, es un gran asunto —no por la capacidad en sí, sino porque la eficiencia de tokens en tareas de seguridad ofensiva es precisamente el tipo de cosa que hace a un modelo a la vez más útil y más peligroso. Lo cual, no por casualidad, es la razón por la que está cerrado.
Segundo, los nuevos modos de razonamiento. "Max reasoning" y "ultra" —este último levantando múltiples subagentes sobre un único problema. La preview también describe un presupuesto interno de razonamiento más grande en niveles de razonamiento más altos. Quiero señalar algo honestamente aquí: la fuente original lanzó una cifra específica de tokens para ese presupuesto que no aguanta el escrutinio —se lee como un número confuso, así que no voy a repetirlo como hecho. La afirmación direccional es la parte creíble: en configuraciones de razonamiento más altas, Sol piensa más tiempo y más fuerte, y "ultra" parece que OpenAI está productizando el patrón de orquestación multi-agente que, hasta ahora, tenías que construir tú mismo. Si has seguido cómo los equipos de agentes realmente rinden en pruebas reales, sabes que esa es la parte difícil y valiosa —y hornearla en un conmutador de razonamiento es un movimiento real.
Las afirmaciones son baratas, sin embargo. La preview se apoyó en demos. Vamos a mirarlas.
Las demos: impresionantes, pero léelas con cuidado
La preview empujó un puñado de builds one-shot, y el resumen honesto es: genuinamente impresionantes, claramente un salto sobre GPT-5.5, y no tan limpias como el highlight reel implica.
Los destacados, tal como se presentaron:
- Un clon estilo Minecraft en unos 90 minutos —landing page, selectores de modo de juego, biomas de desierto y mobs, animaciones de nubes y de romper bloques, un ciclo de día/noche. La trampa, declarada en la propia preview: algunas interacciones, como recoger bloques, no funcionaban del todo. Más realista que lo que produjo Fable, pero la fuente fue franca en que no superó a Fable 5 en sofisticación general.
- Una simulación de captura del booster de SpaceX Starship —mecánica de las pinzas realista y una comprensión creíble de la física y la robótica. La "captura con palillos" es algo genuinamente difícil de simular de forma convincente, así que este se ganó mi atención.
- Un RPG estilo Pokémon en unos 31 minutos —estilo emulador, múltiples gimnasios, ocho medallas, selección de inicial, una Liga final. Construido para evitar problemas de copyright.
- Un generador de mundo 3D voxel en unos 44,5 minutos.
La preview describió el salto de 5.5 a Sol como "absurdo", especialmente en trabajo de coding, front-end, full-stack y simulación. Creo la dirección. Soy escéptico con el enmarcado. Aquí está por qué esa línea de "algunas interacciones no funcionaban" importa más que el glosado de la demo: un modelo que construye un hermoso clon de Minecraft donde no puedes recoger bloques es un modelo que es espectacular generando estructura plausible y todavía imperfecto cerrando el bucle en la corrección interactiva. Esa es exactamente la brecha con la que choco constantemente ejecutando bucles de agente reales —la cosa parece hecha y no lo está, y el último 10% es donde vive la ingeniería real.
Así que mi lectura: la serie GPT-5.6 es un salto real de capacidad, las demos son direccionalmente honestas en no superar a Fable 5, y quien te diga "Sol produce apps de producción en un solo intento" te está vendiendo el tráiler, no la película. No sabremos hasta que esté abierto para pruebas —y eso también está cerrado.
Lo que nos lleva al modelo que quedó cerrado con más fuerza.
El veto a Fable 5: cuando un modelo se convierte en un problema de seguridad nacional
Fable 5 de Anthropic fue vetado. No con rate limit, ni en lista de espera —retirado, durante aproximadamente dos semanas, por motivos de seguridad nacional, presuntamente por su capacidad para replicar el hackeo a sistemas de seguridad del gobierno de EE. UU.
Siéntate con lo inusual que es eso. Hemos tenido modelos que rechazan tareas. Hemos tenido laboratorios que retrasan lanzamientos. Nunca, en la era pública de la IA frontier, hemos tenido a un estado ordenar efectivamente que un modelo comercial insignia se retire del mercado por lo que podría hacer en las manos equivocadas. Esa es una nueva categoría de evento, y es la señal más clara hasta la fecha de que los modelos más capaces están siendo gobernados como tecnología adyacente a las armas y no como productos de software.
Aquí está lo que está confirmado frente a lo reportado, porque el matiz es la historia entera:
Confirmado (según la propia declaración de Anthropic): Desde el 12 de junio, Anthropic ha estado cooperando con funcionarios de EE. UU. para reactivar Mythos 5 y Fable 5. Mythos 5 fue restaurado a un grupo limitado de organizaciones de infraestructura crítica —reportado en el orden de 100 organizaciones— con el acceso ampliándose gradualmente, no volviendo a estar abierto. El acceso público sigue altamente restringido, bajo estrictos controles y protocolos de seguridad.
Reportado / rumoreado: Que la administración Trump estaba cerca de restaurar un acceso más amplio tras el apagón de aproximadamente dos semanas, posiblemente esa misma semana, con las negociaciones cerca de resolverse —y que el modelo restaurado probablemente estaría nerfeado: seguridad más estricta, capacidad reducida en los dominios de ciberseguridad más sensibles. Trata eso como reporte, no como hecho. La afirmación direccional —"volviendo, pero más restringido"— es consistente entre fuentes; el timing específico es la parte blanda.
Tracé la mecánica de cómo un modelo frontier vetado se abre paso de vuelta a un servicio limitado en mi desglose del retorno de Fable 5, y el patrón de allí se mantiene aquí: la restauración no es un interruptor, es una negociación, y el modelo que vuelve no es el modelo que se fue. Si construyes sobre el tier frontier de Anthropic, esa es la realidad operativa que hay que interiorizar —la capacidad a este nivel viene ahora con una capa de gobernanza que no controlas.
Y no, esto no es un CEO convenciendo al gobierno de nada. Déjame lidiar con ese argumento directamente, porque está en todas partes.
¿"Sembró miedo" Dario Amodei para llevar la frontera al cierre?
Hay una narrativa ruidosa en línea de que el CEO de Anthropic, Dario Amodei, convenció al gobierno de EE. UU. de restringir los modelos frontier —de que todo el encuadre de seguridad nacional es siembra de miedo por parte de un CEO que se beneficia de fosos regulatorios. No me lo compro, y quiero explicar por qué de la forma más llana posible.
El gobierno de EE. UU. no veta un modelo por la palabra de un ejecutivo. Una decisión como retirar Fable 5 pasa por múltiples agencias —la NSA, la comunidad de inteligencia, expertos dedicados en ciberseguridad— cada una haciendo su propia evaluación de riesgo independiente. Cuando un modelo puede asistir de manera creíble en comprometer sistemas gubernamentales, eso no es un vibe que un CEO pueda fabricar en un podcast. Es un hallazgo, evaluado por personas cuyo trabajo entero es evaluar exactamente ese tipo de amenaza.
La motivación probable ni siquiera es principalmente el uso indebido doméstico. Es sobre adversarios —mantener la capacidad ciber-ofensiva frontier fuera de las manos de estados rivales, con China a la cabeza. Ese es un cálculo estratégico que existe diga o no un ejecutivo de IA una palabra en público.
Según se reporta, hubo algunos lapsos de comunicación por parte de Anthropic al principio del episodio —pero ese es un problema operativo separado, no la causa del veto. Confundir "Anthropic manejó la comunicación de forma imperfecta" con "Anthropic diseñó la política" es exactamente el tipo de razonamiento motivado que produce buena tracción online y mal análisis.
Voy a ser honesto sobre dónde acabo, porque no es un lugar cómodo. Quiero acceso público amplio a los modelos frontier —de ahí viene la innovación que me importa, la materia sobre la que construyo mi trabajo. Y también reconozco que un modelo genuinamente capaz de atacar infraestructura crítica es un objeto distinto de un chatbot, y fingir lo contrario para ganar una discusión online no ayuda a nadie. Esto es yo leyendo los hechos, no eligiendo un equipo político. Las restricciones parecen ser el resultado de una evaluación institucional real del riesgo, no el lobby de un solo hombre.
Si el objetivo es mantener esta capacidad lejos de los adversarios, aquí está el problema: los adversarios también la están construyendo.
GLM-5.2 de China: la carrera de ciberseguridad no tiene frenos
La empresa china Z.ai lanzó GLM-5.2 como un modelo open-weight con licencia MIT en junio de 2026 —un día después de que los controles de exportación golpearan a Fable 5— y la afirmación que importa es esta: iguala a Claude en descubrimiento de vulnerabilidades. Eso no es solo la palabra de Z.ai: el benchmark IDOR independiente de Semgrep puntuó a GLM-5.2 con un 39% F1, por delante de Claude con ~32% —exactamente la capacidad que hizo que los modelos frontier occidentales se cerraran en primer lugar.
Si esa afirmación es real-world o solo de benchmark está genuinamente sin verificar, y quiero mantenerlo ahí. "Iguala en un benchmark" e "iguala en un enfrentamiento en vivo contra un objetivo endurecido" son cosas muy diferentes, y la brecha entre ellas es exactamente donde mucho hype de modelos va a morir. Así que: no confirmado, ojo atento.
Pero la señal es inequívoca independientemente de si la afirmación exacta de paridad se sostiene. La ciberseguridad se ha convertido en el campo de batalla central de la carrera de IA entre EE. UU. y China, y no hay evidencia de una desaceleración por el lado chino. Llevo un tiempo siguiendo la trayectoria de GLM —cuando comparé GLM contra Qwen y Opus, la conclusión fue que los modelos chinos open-weight estaban cerrando la brecha más rápido de lo que la cómoda narrativa occidental quería admitir. Que GLM-5.2 alcance descubrimiento de vulnerabilidades de clase frontier, si es real, es esa tendencia impactando en la capacidad estratégicamente más sensible que existe.
Aquí está el incómodo bucle estratégico. EE. UU. cierra Fable 5 para mantener la capacidad ciber-ofensiva lejos de China. China lanza GLM-5.2, open-weight y con licencia MIT, con capacidad comparable comprobada de forma independiente de todas maneras. La puerta protege a EE. UU. de acelerar a un adversario al que quizás no pueda frenar realmente. Esa tensión no tiene una resolución limpia, y cualquier análisis que finja que sí no está siendo honesto contigo. Para la inmersión más profunda en por qué específicamente la capacidad ciber es el punto álgido, lo desmenucé en mi pieza sobre Mythos y ciberseguridad.
Mientras la frontera se cierra y se disputa, algo más silencioso y posiblemente más importante le pasó al negocio subyacente.
El auge empresarial de Anthropic: el juego se movió a los workflows
Aquí está el desarrollo alrededor del cual creo que los builders deberían reorganizarse: el negocio empresarial de Anthropic se disparó desde finales de 2025 hasta principios de 2026, y por múltiples medidas independientes, ha superado a OpenAI en la parte del mercado que paga —el gasto corporativo en herramientas de desarrollo con IA.
Este puedo respaldarlo con datos verificables, y es llamativo. Según el seguimiento del gasto empresarial, Claude Code ostenta aproximadamente el 54% del gasto empresarial en coding en 2026 contra el 21% de OpenAI —y el coding ya representa más de la mitad de todo el uso empresarial de IA generativa. El AI Index de Ramp mostró a Anthropic capturando más del 73% del gasto entre empresas que compran herramientas de IA por primera vez. Y en abril de 2026, la adopción empresarial cruzó una línea que no se había cruzado antes: Anthropic con un 34,4% frente a OpenAI con un 32,3% —la primera vez que Anthropic lideró a OpenAI en adopción empresarial. Menlo Ventures situó el gasto empresarial en LLM en aproximadamente 40% Anthropic frente a 27% OpenAI. Las fuentes discrepan sobre la magnitud exacta. Coinciden en la dirección.
Entonces, ¿qué cambió? La competencia dejó de ser sobre qué laboratorio tiene el mejor modelo y pasó a ser sobre el modelo de quién está embebido en el workflow diario. Sigo volviendo a la analogía Windows/Office de los 90. Microsoft no ganó porque siempre lanzara la mejor aplicación individual —ganó porque su software se convirtió en la cosa que abrías cada mañana sin pensar. Anthropic está ejecutando ese playbook con los equipos de ingeniería: Claude Code vive en la terminal, en el ciclo de revisión, en el lugar donde el trabajo realmente ocurre. Una vez que una herramienta es portante en el bucle diario de un equipo, el coste de cambio —no la puntuación en un benchmark— se convierte en el factor decisivo.
Ese es el cambio real hacia el que está lanzándose la serie GPT-5.6. La carrera armamentística va ahora sobre economía del workflow: reducción de fricción, gobernanza, integración y entrega de valor comprobable —coding más rápido, menos bugs, ciclos de revisión de código más cortos— no una subida de dos puntos en una eval. Un modelo que puedes hacer demo y un modelo que está tejido en la memoria muscular de diez mil ingenieros son activos muy distintos, y el segundo es muchísimo más difícil de desalojar.
Dos matices honestos, porque la versión triunfalista de esta historia es errónea. Primero, un auge no es una coronación —esto no es la derrota de OpenAI. OpenAI sigue siendo fuertemente competitiva, especialmente en productividad más amplia y en el extremo más barato del mercado, que es exactamente por qué existe el tier Luna. Segundo, el mercado empresarial de IA es complejo y segmentado; "Anthropic lidera el gasto en coding" y "OpenAI lidera el alcance al consumidor" son ambos verdaderos a la vez. Cualquiera que aplane eso en "X ganó" está vendiendo una narrativa, no describiendo un mercado.
Un competidor más acaba de pisar el terreno, y lleva una insignia de Tesla.
Grok 4.5: la jugada de coding de Musk, en beta privada
Elon Musk dice que Grok 4.5 está en beta privada dentro de SpaceX y Tesla, y presuntamente se aproxima a la capacidad de Claude Opus —aunque qué versión de Opus es genuinamente incierto.
La afirmación técnica interesante: Grok 4.5, según se reporta, está construido sobre el modelo fundacional "V9" de xAI de aproximadamente 1,5 billones de parámetros, luego entrenado adicionalmente con datos de Cursor para afinar el coding. Si ese detalle es preciso, es una pista sobre la estrategia —xAI no solo está escalando un modelo base, sino que está apuntando específicamente al mercado de agentes de coding, entrenando con el tipo de datos reales de edición que hacen a un modelo bueno en el bucle que los desarrolladores realmente ejecutan. Ese es un disparo directo al segmento que Anthropic domina actualmente.
Mantén el escepticismo calibrado, sin embargo. "En beta privada en SpaceX y Tesla" significa que las propias empresas de Musk son las testers, lo que es un entorno de evaluación tan amistoso como existe. "Se aproxima al nivel de Opus" con un número de versión incierto es una afirmación blanda envuelta en un recuento de parámetros que suena duro. Yo pondría a Grok 4.5 firmemente en la columna de "mira los benchmarks públicos, ignora los tweets del fundador" hasta que haya algo reproducible. Pero la intención es clara y creíble: xAI quiere ser un competidor serio en coding, y se está entrenando para esa pelea específicamente.
Entonces, ¿dónde deja todo esto a un builder que intenta tomar decisiones reales?
Lo que realmente importa aquí (la lectura del builder)
Da un paso atrás de los nombres de modelos y las afirmaciones de benchmarks, y tres cosas son verdaderas a la vez este mes —y las tres son más duraderas que cualquier lanzamiento individual.
Uno: la cima de la frontera está siendo gobernada por seguridad nacional, y eso no es un fallo temporal. GPT-5.6 Sol lanzándose primero a socios autorizados antes de abrirse el 9 de julio, Fable 5 siendo vetado y parcialmente restaurado bajo controles más estrictos, Mythos 5 volviendo poco a poco a ~100 organizaciones de infraestructura crítica —estas no son historias separadas. Son la misma historia. Los modelos más capaces están siendo gobernados como tecnología estratégica de doble uso. Si tu roadmap asume que obtendrás acceso API el mismo día a lo que sea más fuerte, reconstruye esa suposición ahora.
Dos: el juego competitivo se movió de la supremacía en benchmarks a la integración en workflows. Anthropic no superó a OpenAI en gasto empresarial de coding ganando un benchmark —lo hizo convirtiéndose en la herramienta que los ingenieros abren sin pensar. Para quienes construimos productos sobre estos modelos, esa es la lección a robar: el foso no es el modelo, es cuán profundamente tu cosa vive dentro del bucle diario de alguien. He argumentado esto desde el lado del builder en mi visión sobre volverse agent-native, y los datos empresariales acaban de confirmarlo con dinero.
Tres: la geopolítica es ahora una variable de selección de modelo. Que GLM-5.2 iguale reportadamente a Mythos en descubrimiento de vulnerabilidades significa que el bloqueo que protege a EE. UU. quizá no ralentice realmente la difusión global de la capacidad. Para los builders, eso se traduce en una realidad práctica: qué modelo puedes usar, dónde puede ejecutarse legalmente y qué se le permite hacer se están volviendo tan importantes como cuán inteligente es.
Si tuviera que comprimir todo el mes en una frase para un ingeniero ocupado: deja de optimizar puramente por el modelo más inteligente, y empieza a optimizar por el modelo más inteligente que realmente puedas desplegar, en tu jurisdicción, dentro del workflow que ya posees. Es una frase menos emocionante que "Sol produce un clon de Minecraft en un solo intento". Es también la que seguirá siendo verdadera el próximo trimestre.
Volví de dos semanas fuera pensando que me había perdido una guerra de benchmarks. Con lo que realmente me topé fue con el momento en que las reglas cambiaron —cuando la pregunta dejó de ser qué tan bueno es el modelo y pasó a ser a quién se le permite usarlo, y ya es parte de cómo trabajas. Los laboratorios que ganen el próximo año no serán los que tengan el número más alto en un gráfico que nadie fuera de una lista de socios autorizados puede reproducir. Serán aquellos cuyos modelos son silenciosamente portantes en tu día antes de que siquiera notes que dejaste de elegirlos.
Así que aquí está la pregunta con la que me sentaría esta noche, sea lo que sea que estés construyendo: si el modelo más fuerte del mundo queda cerrado detrás de una autorización gubernamental que nunca tendrás, ¿tu producto está diseñado para ganar por inteligencia bruta —o por cuán profundamente vive dentro del trabajo? Porque uno de esos está ahora cerrado. El otro sigue siendo tuyo para ganártelo.
Preguntas frecuentes
¿Qué es la serie GPT-5.6?
La serie GPT-5.6 es el lanzamiento frontier escalonado de OpenAI compuesto por tres modelos —Sol (buque insignia), Terra (equilibrado) y Luna (alto volumen)— cada uno afinado para un punto distinto de precio-rendimiento. El tier insignia Sol está restringido a socios aprobados por el gobierno de EE. UU. Consulta el desglose completo en la sección de modelos más arriba.
¿Por qué fue vetado Fable 5 de Anthropic?
Se reporta que Fable 5 fue retirado durante aproximadamente dos semanas por motivos de seguridad nacional, debido a su capacidad para replicar el hackeo a sistemas de seguridad del gobierno de EE. UU. Según la propia declaración de Anthropic, la compañía ha cooperado con funcionarios de EE. UU. desde el 12 de junio para reactivar Fable 5 y Mythos 5 bajo controles más estrictos y acceso restringido.
¿Está GPT-5.6 Sol disponible al público?
Sí, desde el 9 de julio de 2026. Sol pasó sus primeras semanas en lanzamiento limitado a través de la API y Codex solo para socios estadounidenses pre-autorizados, pero el gobierno de EE. UU. aprobó un lanzamiento amplio el 9 de julio y OpenAI abrió Sol al público junto con Terra y Luna.
¿Superó Anthropic a OpenAI en el ámbito empresarial?
Por múltiples medidas independientes, sí —en el segmento de herramientas para desarrolladores. Los datos empresariales de 2026 muestran a Claude Code manteniendo alrededor del 54% del gasto empresarial en coding frente al 21% de OpenAI, y abril de 2026 marcó el primer mes en que Anthropic lideró a OpenAI en adopción empresarial general. OpenAI sigue siendo fuerte en alcance al consumidor y en tiers de menor coste.
¿Es realmente GLM-5.2 de China tan capaz como Claude en ciberseguridad?
En descubrimiento de vulnerabilidades, las pruebas independientes dicen que sí: el benchmark IDOR de Semgrep puntuó al modelo open-weight GLM-5.2 con un 39% F1, por delante del ~32% de Claude. Los benchmarks no son la historia completa, pero esto no es solo una afirmación del proveedor. La señal más amplia es clara independientemente: el desarrollo frontier de IA de China no muestra desaceleración, con la ciberseguridad como campo de batalla central.
¿Construyendo sobre una frontera que se mueve constantemente?
Cuando el acceso a modelos, los precios y las reglas de exportación cambian de mes en mes, el movimiento duradero es una arquitectura que pueda intercambiar modelos sin reescribir tu stack. Diseñar esa portabilidad —y el enrutamiento y las guardas alrededor de ella— es el trabajo del que me hago cargo. Si ese es un problema que preferirías delegar, aquí es donde puedes encontrarme.