Ik zat midden in een traditionele RAG-pipeline toen Andrej Karpathy iets op X postte dat me elk architectuurbesluit van de afgelopen zes maanden deed heroverwegen.
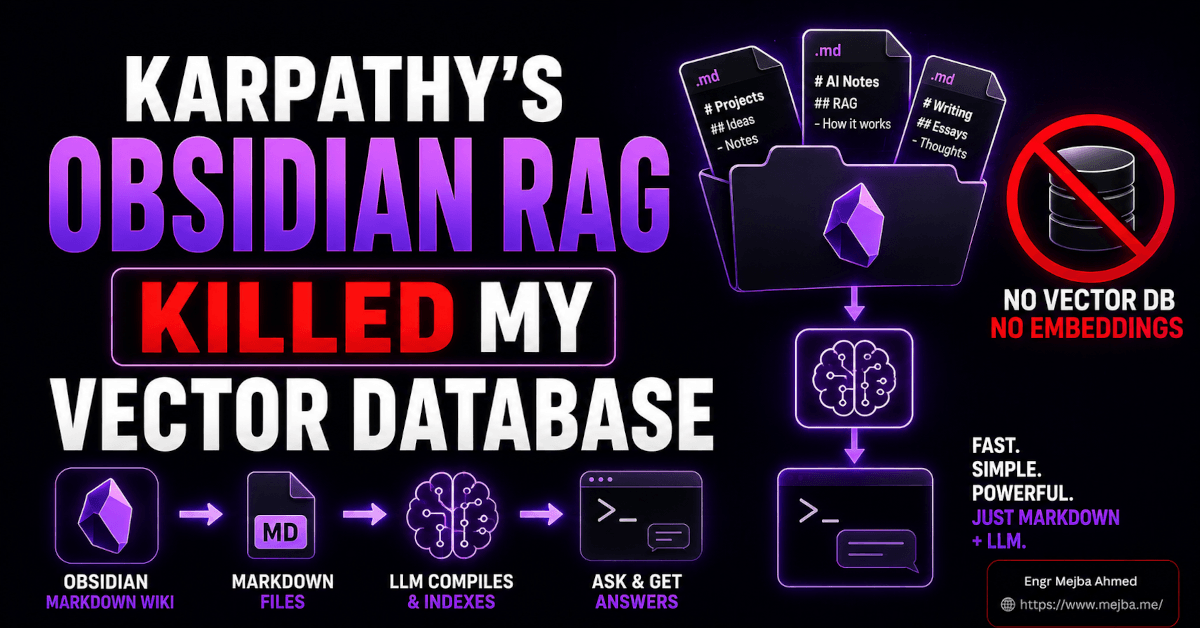
Geen vectordatabase. Geen embeddings. Geen chunking-strategie. Geen similarity-drempels om af te stellen. Gewoon markdown-bestanden, een mappenstructuur, en een LLM die tegelijkertijd als bibliothecaris en auteur fungeert.
Mijn eerste reactie was scepsis. Ik heb RAG-systemen gebouwd. Ik heb retrieval-fouten gedebugged, geworsteld met chunk-overlappingsinstellingen, en gezien hoe perfect relevante documenten bedolven raakten onder cosine-similarityscores die nergens op sloegen. Het idee dat je al die infrastructuur kon overslaan en betere resultaten kon krijgen voor een persoonlijke kennisbank voelde alsof iemand zei dat je een auto kon inhalen door te wandelen — in de juiste richting.
Toen bouwde ik het. En de wandel-in-de-juiste-richting-metafoor bleek oncomfortabel accuraat.
Karpathy's systeem — dat hij "LLM Knowledge Bases" noemt — werkt omdat het iets exploiteert dat de meeste RAG-architecten over het hoofd zien: voor datasets onder ongeveer 400.000 woorden (ruwweg 100 substantiële artikelen) geeft een goed georganiseerde markdown-structuur met samenvattingen en indexbestanden de LLM meer bruikbare context dan vectorzoekopdrachten ooit zouden kunnen. Het model haalt geen fragmenten op. Het navigeert door een kennisgrafiek die het zelf heeft gebouwd, volgt links die het zelf heeft aangemaakt, leest samenvattingen die het zelf heeft geschreven.
Dat onderscheid — de LLM als auteur van de kennisstructuur, niet slechts een consument van opgehaalde chunks — verandert alles aan hoe het systeem presteert. En het is het deel dat de meeste berichtgeving over Karpathy's aanpak onder de kop begraaft.
Waarom Traditionele RAG Faalt op de Schaal Waarop de Meeste Mensen Daadwerkelijk Werken
Hier is iets dat niemand in het RAG-ecosysteem wil toegeven: voor 90% van individuele ontwikkelaars en kleine teams is traditionele RAG overkill die de resultaten actief verslechtert.
Ik heb het niet over enterprise-zoekopdrachten in miljoenen documenten. Dat is een ander probleem met andere beperkingen. Ik heb het over de ontwikkelaar die 50-200 gebookmarkte artikelen heeft, een handvol onderzoekspapers, wat repo-documentatie, en een groeiende stapel notities waar ze een LLM over willen laten redeneren.
Voor die use case — die de meesten van ons beschrijft — introduceert de traditionele RAG-pipeline drie problemen die markdown-first systemen simpelweg niet hebben.
Het chunking-probleem. Elk RAG-systeem splitst documenten in chunks. De chunkgrootte is een compromis: te klein en je verliest context, te groot en je verspilt tokens aan irrelevante tekst. Er is geen universeel correcte chunkgrootte, en de verkeerde keuze degradeert stilletjes elke query. Ik heb hele middagen besteed aan het afstemmen van chunk-overlappingspercentages, en de eerlijke waarheid is dat het altijd voelde alsof ik onderhandelde met het systeem in plaats van het te configureren.
Het retrieval-ruisprobleem. Vector-similariteitszoeken retourneren de wiskundig meest vergelijkbare chunks, niet de meest bruikbare. Ik heb queries gehad waarbij de top-5 opgehaalde chunks allemaal uit dezelfde sectie van hetzelfde document kwamen — vijf licht verschillende paragrafen die bijna hetzelfde zeiden — terwijl het daadwerkelijk relevante inzicht uit een ander document op positie 47 in de resultaten zat. Relevantie en similariteit zijn niet hetzelfde, en vectorzoeken optimaliseert voor de verkeerde.
Het black box-probleem. Met een vectordatabase kun je niet eenvoudig zien wat erin zit. Je kunt je kennisbank niet doorbladen zoals je een map doorbladert. Je kunt niet handmatig controleren of een document correct geïndexeerd is. Je kunt geen hiaten in je dekking opsporen door een lijst te scannen. De data verdwijnt in embeddings, en je interacteert ermee alleen via queries die misschien wel of misschien niet boven water brengen wat je nodig hebt.
Karpathy's systeem omzeilt alle drie. Geen chunking — de LLM leest gestructureerde samenvattingen en volgt links naar volledige documenten wanneer nodig. Geen vectorsimilariteit — de LLM navigeert door een index die het heeft gebouwd en begrijpt. Geen black box — elk stukje kennis leeft in een leesbaar markdown-bestand dat je in elke teksteditor kunt openen.
De afweging? Het schaalt niet naar miljoenen documenten. Maar als je kennisbank wordt gemeten in honderden artikelen in plaats van miljoenen, is die afweging een van de beste deals in AI op dit moment.
Hoe Karpathy's LLM-Kennisbank Daadwerkelijk Werkt
Op 3 april 2026 publiceerde Karpathy een GitHub-gist genaamd llm-wiki die de volledige architectuur uiteenzet. Het systeem heeft drie lagen, en begrijpen hoe ze samenwerken is de sleutel om het werkend te krijgen.
Laag 1: De Ruwe Kluis
Alles begint in een raw/-map binnen een Obsidian-vault. Dit is het staginggebied — een verzamelplaats voor alles wat je de LLM uiteindelijk wilt laten weten. Artikelen gekopieerd van het web. PDF-onderzoekspapers. Repository-documentatie. Screenshots. Code-fragmenten. Podcast-transcripties.
De raw-map heeft één regel: niets erin hoeft georganiseerd te zijn. Je gooit dingen erin, en de LLM organiseert ze later. Dit is belangrijker dan het klinkt. De meeste kennismanagementsystemen falen omdat de innamefrictie te hoog is — je moet dingen taggen, categoriseren, op de juiste plek opslaan. Met Karpathy's aanpak is inname zo simpel als een bestand naar een map slepen.
Voor webartikelen gebruikt Karpathy de Obsidian Web Clipper — een Chrome-extensie die elke webpagina omzet naar een markdown-bestand en het direct in je raw-map plaatst. Eén klik. Het artikel zit in je systeem, afbeeldingen en al.
Over afbeeldingen gesproken: Obsidian handelt inline afbeeldingen van geknipte webpagina's niet automatisch af. Je hebt de "Local Images Plus" community-plugin nodig, die externe afbeeldingen downloadt en ze lokaal opslaat in de vault. Zonder deze plugin zullen je geknipte artikelen gebroken afbeeldingslinks hebben zodra je offline gaat — en de LLM kan geen visuele inhoud raadplegen via zijn vision-mogelijkheden.
Laag 2: De Gecompileerde Wiki
Hier wijkt Karpathy's systeem af van elke andere kennismanagement-aanpak die ik heb gezien.
In plaats van de ruwe documenten te indexeren voor retrieval, leest de LLM ze en schrijft nieuwe documenten. Het compileert het ruwe materiaal tot een gestructureerde wiki — encyclopedische artikelen over kernconcepten, samenvattingen van brondocumenten, en expliciete backlinks tussen gerelateerde ideeën.
De wiki leeft in een wiki/-map, parallel aan raw/. Binnenin vind je:
-
Een masterindex (
index.md) — een enkel markdown-bestand dat elke aangemaakte wiki opsomt, met korte beschrijvingen en links. Dit is het startpunt van de LLM voor elke query. Het leest de masterindex, identificeert welke wiki relevant is, navigeert dan naar de eigen index en artikelen van die wiki. -
Sub-wiki mappen — elk onderwerp krijgt zijn eigen map met zijn eigen
index.mden een set gecompileerde artikelen. Een wiki over "transformer-architecturen" kan artikelen bevatten over aandachtsmechanismen, positionele codering, en schalingswetten, allemaal onderling gelinkt. -
Backlinks en kruisverwijzingen — de LLM maakt
[[wiki-stijl links]]aan tussen gerelateerde concepten over verschillende wiki's heen. Deze zijn niet decoratief. Ze vormen de navigatiestructuur die de LLM gebruikt bij het beantwoorden van queries die meerdere onderwerpen bestrijken.
De compilatiestap is waar de LLM zijn waarde bewijst. Het kopieert geen tekst van ruwe documenten naar wiki-artikelen. Het synthetiseert — het identificeert de kernconcepten, schrijft heldere uitleg, noteert tegenstrijdigheden tussen bronnen, en bouwt een web van verbindingen dat geen vectordatabase zou kunnen repliceren.
Hier is hoe een compilatieprompt er in de praktijk uitziet. Je wijst je LLM-agent (Karpathy gebruikt Claude Code) naar de raw-map en zegt zoiets als:
Lees door de bestanden in raw/ die betrekking hebben op [onderwerp].
Maak een nieuwe wiki aan in wiki/[onderwerpnaam]/ met:
1. Een index.md die alle artikelen in deze wiki opsomt
2. Individuele artikelen voor elk groot concept
3. Backlinks naar gerelateerde wiki's waar relevant
4. Werk de master wiki/index.md bij om deze nieuwe wiki op te nemen
De LLM doet het onderzoek, schrijft de artikelen, bouwt de links, en werkt de indexen bij. Je bekijkt de output in Obsidian's UI — schoon, navigeerbaar, menselijk leesbaar.
Laag 3: De Query-Interface
Wanneer je de LLM een vraag stelt over je kennisbank, doorzoekt het geen ruwe documenten. Het volgt een gestructureerd pad:
- Leest de master
wiki/index.mdom relevante wiki's te identificeren - Opent de
index.mdvan de relevante wiki om specifieke artikelen te vinden - Leest die artikelen (die gesynthetiseerde kennis plus bronverwijzingen bevatten)
- Volgt backlinks naar gerelateerde concepten als de vraag meerdere onderwerpen bestrijkt
- Retourneert een antwoord gebaseerd op de gecompileerde wiki, met verwijzingen naar specifieke artikelen
Dit lijkt meer op hoe een menselijke onderzoeker werkt dan wat vectorzoeken ook maar biedt. Een onderzoeker scant niet elk document in een bibliotheek op trefwoorden. Ze controleren de index, vinden de juiste sectie, lezen de relevante artikelen, en volgen verwijzingen naar gerelateerd materiaal.
Het prestatieverschil is reëel. Voor Karpathy's dataset van ruwweg 100 artikelen en 400.000 woorden gaf de wiki-navigatiebenadering meer coherente, beter onderbouwde antwoorden dan een traditionele RAG-pipeline zou geven — omdat de LLM redeneerde over gestructureerde kennis die het al had gesynthetiseerd, in plaats van te proberen opgehaalde chunks in realtime te begrijpen.
Dit Vanaf Nul Opzetten: De Volledige Handleiding
Ik herbouwde Karpathy's systeem op mijn eigen machine in minder dan een uur. Hier is elke stap, inclusief de stappen die de meeste gidsen overslaan.
Stap 1: Installeer Obsidian en maak de vault-structuur aan.
Download Obsidian van obsidian.md. Het is gratis voor persoonlijk gebruik. Maak een nieuwe vault aan — Obsidian vraagt je een map te kiezen. Ik noemde de mijne vault en plaatste het in mijn homedirectory, maar de locatie maakt niet uit.
Maak binnenin de vault twee mappen aan:
vault/
  raw/
  wiki/
Dat is de volledige bestandsstructuur om te beginnen. De wiki-map wordt gevuld naarmate je compileert.
Stap 2: Installeer de Web Clipper.
Ga naar obsidian.md/clipper en installeer de Chrome-extensie. Stel in de clipper-instellingen de standaard opslaglocatie in op je raw/-map. Nu is elk webartikel slechts één klik verwijderd van je kennisbank.
Test het meteen. Knip een artikel dat je al wilde lezen. Open Obsidian en bevestig dat het markdown-bestand verscheen in raw/. Als afbeeldingen niet worden weergegeven, heb je stap 3 nodig.
Stap 3: Installeer Local Images Plus.
Ga in Obsidian naar Instellingen > Community Plugins > Bladeren. Zoek naar "Local Images Plus" en installeer het. Schakel de plugin in, configureer het dan om afbeeldingen te downloaden naar een submap in je vault (ik gebruik vault/assets/images/).
Na het inschakelen van deze plugin, knip opnieuw een webartikel. De afbeeldingen zouden nu lokaal moeten downloaden en correct worden weergegeven in Obsidian's voorbeeldmodus. Dit is vooral cruciaal als je technische artikelen knipt met diagrammen, architectuurschema's of code-screenshots — de visuele context is belangrijk, en moderne LLM's met vision-mogelijkheden kunnen deze afbeeldingen daadwerkelijk lezen.
Stap 4: Vul je raw-map.
Dit is het leuke deel. Begin met het dumpen van inhoud in raw/. Enkele bronnen die goed werken:
- Technische blogposts die je hebt gebookmarkt (gebruik de Web Clipper)
- Onderzoekspapers (opslaan als PDF of converteren naar markdown)
- GitHub repo README's (kopieer de markdown direct)
- Je eigen notities, outlines en projectdocumentatie
- Transcripties van conferentiepresentaties
- Nieuwsbriefuitgaven die je hebt bewaard
Organiseer ze niet. Hernoem ze niet. Tag ze niet. Krijg ze gewoon in de map. De LLM handelt de organisatie af in de volgende stap.
Ik begon met 63 artikelen over AI-agentarchitecturen — een mix van blogposts, papers en mijn eigen projectnotities. Het totaal kwam op ongeveer 180.000 woorden aan ruw materiaal.
Stap 5: Maak je eerste wiki-compilatie.
Hier breng je je LLM-agent in. Als je Claude Code gebruikt (wat ik aanbeveel voor deze workflow omdat het bestandsoperaties native afhandelt), navigeer naar je vault-directory en voer een compilatieprompt uit.
Hier is de prompt die ik gebruikte voor mijn eerste wiki:
Bekijk de bestanden in raw/ die AI-agentarchitecturen, multi-agent
systemen of agent-orchestratiepatronen bespreken.

Maak een wiki aan op wiki/ai-agent-architectures/ met:
- Een index.md die elk artikel in de wiki opsomt met een één-regel beschrijving
- Individuele artikelen voor grote concepten (minimaal: orchestratiepatronen,
  tool use-patronen, geheugenarchitecturen, multi-agent communicatie)
- Elk artikel moet informatie uit meerdere ruwe bronnen synthetiseren
- Voeg [[backlinks]] toe naar gerelateerde concepten binnen de wiki
- Vermeld aan het einde van elk artikel de ruwe bronbestanden waaruit het putte
- Maak wiki/index.md (de masterindex) aan als het niet bestaat,
  en voeg deze wiki eraan toe
Claude Code las de relevante ruwe bestanden door, identificeerde de kernconcepten, en genereerde een wiki met 11 artikelen, een uitgebreide index en kruisverwijzingen ertussen. Het hele proces duurde ongeveer vier minuten.
De outputkwaliteit verraste me. Het was niet louter samenvatting — het was echte synthese. Een artikel over "Geheugenarchitecturen voor AI-Agenten" haalde inzichten uit zeven verschillende ruwe bronnen, organiseerde ze in een coherent raamwerk, en noteerde waar twee van de bronnen elkaar tegenspraken over de kwestie van langetermijngeheugenopslag.
Stap 6: Stel de masterindex in.
Na je eerste compilatie zou wiki/index.md moeten bestaan. Open het in Obsidian en controleer of het er goed uitziet. Naarmate je meer wiki's aanmaakt, wordt dit bestand het startpunt van je LLM — de inhoudsopgave voor je gehele kennisbank.
Een gezonde masterindex ziet er ongeveer zo uit:
# Kennisbank Index

## Wiki's

### AI-Agentarchitecturen
Orchestratiepatronen, tool use, geheugensystemen en multi-agent
communicatieraamwerken.
→ [[ai-agent-architectures/index]]

### Transformer Schalingswetten
Trainingscompute, parameteraantallen, datavereisten en
emergente mogelijkheden over modelgroottes.
→ [[transformer-scaling/index]]
Stap 7: Bevraag je kennisbank.
Nu komt de beloning. Wanneer je je kennisbank een vraag wilt stellen, vertel je Claude Code om bij de masterindex te beginnen:
Lees wiki/index.md om jezelf te oriënteren op wat er beschikbaar is in mijn
kennisbank. Beantwoord dan deze vraag met behulp van de relevante wiki-
artikelen: [jouw vraag hier]
De LLM leest de index, identificeert de relevante wiki, navigeert naar de specifieke artikelen, en geeft je een antwoord gebaseerd op je gecompileerde kennis — met verwijzingen naar specifieke artikelen die je kunt verifiëren.
Pro-tip: voeg een changelog.md toe aan je vault-root. Elke keer dat je een nieuwe wiki compileert of een bestaande bijwerkt, log de datum en wat er veranderde. Karpathy beveelt een consistent prefix-formaat aan zoals ## [2026-04-05] ingest | Artikeltitel zodat het logboek parseerbaar wordt met standaard unix-tools. Dit geeft jou (en de LLM) een tijdlijn van hoe de kennisbank zich heeft ontwikkeld.
Wat Dit Beter Doet Dan Traditionele RAG Verkeerd Doet
Na beide systemen een week parallel te hebben gedraaid — mijn oude vectorgebaseerde RAG-pipeline op dezelfde dataset naast de Karpathy-stijl wiki — merkte ik drie specifieke voordelen op die niet voor de hand liggen totdat je beide hebt gebruikt.
Het synthesevoordeel. Toen ik mijn vector-RAG-systeem vroeg "Wat zijn de afwegingen tussen gecentraliseerde en gedecentraliseerde agent-orchestratie?", retourneerde het vijf chunks uit drie verschillende documenten. De chunks waren relevant, maar ik moest ze zelf mentaal synthetiseren. Het wiki-systeem had die synthese al gedaan tijdens de compilatie. Het artikel over orchestratiepatronen legde de afwegingen uit in een gestructureerde vergelijking, puttend uit dezelfde brondocumenten maar ze presenterend als een coherent argument in plaats van fragmenten.
Het ontdekkingsvoordeel. De backlink-structuur van de wiki brengt verbindingen naar boven waar je niet naar vroeg. Toen ik het wiki-systeem bevroeg over geheugenarchitecturen, verwees het antwoord naar een backlink naar een concept in de "tool use-patronen" wiki dat ik mentaal niet had verbonden. De backlink bestond omdat de LLM tijdens compilatie opmerkte dat het geheugenopslagprobleem bij agenten structureel vergelijkbaar is met het toestandsbeheerprobleem in tool-ketens. Vectorzoeken vindt deze verbindingen niet omdat ze niet lexicaal vergelijkbaar zijn — ze zijn conceptueel gerelateerd op een niveau dat begrip vereist, geen matching.
Het transparantievoordeel. Wanneer het wiki-systeem me een antwoord geeft, kan ik de bronartikelen openen in Obsidian en ze zelf lezen. Ik kan zien wat de LLM heeft gesynthetiseerd, ik kan controleren of de synthese accuraat is, ik kan het corrigeren als het verkeerd is. Met vector-RAG krijg ik chunks en similarityscores. Debuggen waarom het systeem een slecht antwoord gaf betekent graven door embeddings en retrieval-logs. Met het wiki-systeem open ik een markdown-bestand en lees het. Het debug-oppervlak is menselijk leesbare tekst.
Als je liever hebt dat iemand een volledig LLM-kennisbanksysteem bouwt dat is aangepast aan jouw specifieke onderzoeksworkflow, neem ik precies dit soort AI-infrastructuurprojecten aan. Je kunt zien wat ik heb gebouwd op fiverr.com/s/EgxYmWD.
De Eerlijke Beperkingen — Waar Deze Aanpak Het Laat Afweten
Ik zou je een slechte dienst bewijzen als ik de grenzen niet duidelijk uiteenzette. Karpathy's systeem is briljant voor zijn beoogde use case, maar het heeft echte beperkingen die ertoe doen.
Schaalplafond. Deze aanpak werkt voor ruwweg 100-400 artikelen (tot ongeveer 400.000 woorden aan ruw materiaal). Daarboven begint de LLM te worstelen met het onderhouden van coherente indexen en groeit de compilatietijd aanzienlijk. Als je met duizenden documenten werkt, heb je traditionele RAG of een hybride aanpak nodig. Het break-evenpunt hangt af van het contextvenster van je LLM — met Opus 4.6's 1M token-context kun je verder pushen dan Karpathy's oorspronkelijke schattingen, maar er is nog steeds een praktisch plafond.
Compilatiekosten. Elke keer dat je significant nieuw materiaal toevoegt, moet je de betrokken wiki hercompileren. Dat betekent LLM-aanroepen, wat tokens betekent, wat geld betekent. Voor een hobbyproject is dit verwaarloosbaar. Voor een continu bijgewerkte kennisbank met dagelijkse inname lopen de compilatiekosten op. Ik heb gemerkt dat batching — ruw materiaal een week lang verzamelen en dan één keer compileren — de kosten redelijk houdt.
Geen real-time retrieval. De wiki is een momentopname. Als je tien minuten geleden een artikel hebt geknipt maar de relevante wiki niet hebt hergecompileerd, weet de LLM er tijdens een query niets van. Je kunt het naar de raw-map wijzen voor recente toevoegingen, maar dat is een handmatige stap. Traditionele RAG-systemen indexeren nieuwe documenten binnen seconden na inname.
Enkelvoudig gebruikersontwerp. Dit is fundamenteel een persoonlijk kennismanagementsysteem. Er is geen multigebruikerstoegangsbeheer, geen waarborgen voor gelijktijdig bewerken, geen versiegeschiedenis buiten wat git biedt. Voor teams zou je samenwerkingsinfrastructuur er bovenop moeten bouwen — op welk punt je misschien beter af bent met een speciaal gebouwd RAG-systeem.
LLM-afhankelijkheid. De kwaliteit van je wiki is direct gekoppeld aan de kwaliteit van de LLM die de compilatie uitvoert. Ik heb dit getest met kleinere modellen en de resultaten zijn merkbaar zwakker — de synthese is oppervlakkiger, de kruisverwijzingen zijn minder inzichtelijk, en de indexorganisatie is minder intuïtief. Je wilt een frontier-model voor de compilatiestap. Voor queries kan een kleiner model vaak prima werken omdat het alleen een goed gestructureerde wiki navigeert.
Deze zijn geen dealbreakers. Het zijn ontwerpgrenzen. Karpathy bouwde dit systeem voor een specifiek profiel — een individuele onderzoeker of ontwikkelaar die een persoonlijke kennisbank van bescheiden omvang beheert — en binnen die grenzen werkt het beter dan al het andere dat ik heb geprobeerd.
Wat Ik Anders Zou Doen Na Een Week Hiermee Te Werken
Mijn eerste wiki-compilatie was slordig. Niet omdat de LLM slecht werk leverde, maar omdat ik het te veel ruw materiaal tegelijk gaf zonder een duidelijke onderwerpgrens. Ik wees Claude Code naar 63 artikelen en zei "maak een wiki over AI-agenten." Het resultaat was uitgebreid — 11 artikelen die alles behandelden van prompt engineering tot multi-agent coördinatie tot tool calling, met backlinks die concepten verbonden die slechts in de losste zin gerelateerd waren.
De tweede keer was ik chirurgischer. Ik groepeerde mijn ruwe bestanden in grove onderwerpsclusters voor compilatie: 18 artikelen over orchestratiepatronen in de ene batch, 12 over geheugenarchitecturen in een andere, 15 over tool use in een derde. Elk werd zijn eigen wiki met zijn eigen gerichte index. De kruisverwijzingen tussen wiki's waren betekenisvoller omdat elke wiki een duidelijke scope had.
Dat is mijn grootste praktische les: compileer smal, link breed. Elke wiki moet een strak onderwerp behandelen. De verbindingen tussen wiki's ontstaan natuurlijk via backlinks, en die verbindingen zijn waardevoller wanneer ze echt verschillende domeinen overbruggen in plaats van aangrenzende paragrafen in hetzelfde uitgebreide onderwerp te linken.
Tweede les: bekijk de eerste compilatie van elke wiki handmatig. De LLM maakt af en toe structurele keuzes die je zelf niet zou maken — concepten anders groeperen dan je verwacht, of artikelen aanmaken met een granulariteit die niet past bij hoe jij over het onderwerp denkt. Een review- en herstructureringsronde van 10 minuten na de eerste compilatie bespaart je het verergeren van structurele problemen naarmate de wiki groeit.
Derde les: je raw-map wordt rommelig, en dat is prima. Ik begon met het organiseren van ruwe bestanden in submappen per brontype. Het was verspilde moeite. De LLM maakt het niet uit of je ruwe bestanden georganiseerd zijn. Het leest ze allemaal, haalt eruit wat relevant is, en negeert de rest. Laat de wiki je georganiseerde laag zijn. Laat raw je rommella zijn.
Ik bouw al een tijdje persoonlijke kennismanagementsystemen met Obsidian — als je mijn handleiding hebt gelezen over Obsidian en Claude Code omvormen tot een tweede brein, herken je sommige van deze patronen. Maar Karpathy's compilatiebenadering gaat verder. Mijn oorspronkelijke setup gebruikte Obsidian voornamelijk als contextbron — wijs de LLM naar markdown-bestanden en laat het ze lezen. Karpathy's inzicht is dat de LLM ook de kennisstructuur moet schrijven, niet alleen consumeren.
Waar Dit Past in het RAG-Landschap van 2026
De timing van Karpathy's post was geen toeval. We zitten op een kantelpunt waar de tools voor het bouwen van kennissystemen zijn gesplitst in twee kampen.
Kamp één: zware RAG-platforms met vectordatabases, embedding-pipelines, herrangschikkingsmodellen en complexe retrieval-strategieën. Deze zijn speciaal gebouwd voor enterprise-schaal — miljoenen documenten, duizenden gelijktijdige queries, strikte latentievereisten. Ze werken. Maar ze zijn duur om te bouwen, duur om te onderhouden, en overkill voor iedereen wiens documentverzameling in een map past.
Kamp twee: wat Karpathy "LLM Knowledge Bases" noemt. Markdown-bestanden, gestructureerde indexen, LLM-gecompileerde wiki's. Nul infrastructuur buiten een teksteditor en een LLM-API. Deze zijn speciaal gebouwd voor individuele onderzoekers, ontwikkelaars en kleine teams wiens kennisbank wordt gemeten in honderden artikelen, niet miljoenen.
De fout die de meeste mensen maken is het gebruik van kamp-één-tools voor kamp-twee-problemen. Ik heb solo-ontwikkelaars Pinecone-instanties zien opzetten om 40 documenten te beheren. Dat is geen engineering, dat is cv-gedreven architectuur. De juiste tool voor een 40-documenten kennisbank is een map met markdown-bestanden en een slimme LLM.
Als je behoeften voorbij groeien aan wat de markdown-first aanpak aankan, kun je altijd migreren. De ruwe bestanden zijn platte tekst. De wiki's zijn platte tekst. Er is geen propriëtair formaat, geen vendor lock-in, geen migratienachtmerrie. Je pakt je markdown-bestanden op en voert ze in welk systeem dan ook waar je naartoe doorgroeit.
Dat is misschien het meest ondergewaardeerde aspect van Karpathy's ontwerp: het optimaliseert voor het uitgangspad, niet alleen het ingangspad. Elk stukje kennis in het systeem wordt opgeslagen in het meest draagbare formaat dat mogelijk is. Als Obsidian morgen verdwijnt, werken je bestanden nog steeds in VS Code, Notion, Bear of elke andere markdown-editor. Als je het systeem ontgroeit, verhuist je inhoud met je mee.
Als je Obsidian al gebruikt met Claude Code voor persistent geheugen — iets dat ik uitgebreid behandelde in mijn bericht over waarom Obsidian Claude Code's grootste zwakte oploste — is Karpathy's wiki-compilatiebenadering de logische volgende stap. Je slaat al context op in markdown. Laat nu de LLM die context organiseren in iets waar het intelligent doorheen kan navigeren.
De Verschuiving Die Meer Uitmaakt Dan De Technische Details
Ik blijf terugkomen bij één onderscheid dat Karpathy's aanpak fundamenteel anders laat aanvoelen dan traditionele RAG.
In een traditioneel RAG-systeem is de LLM een consument. Het ontvangt chunks, leest ze, en genereert een antwoord. De kennisstructuur — de embeddings, de index, de retrieval-logica — wordt gebouwd door engineering-infrastructuur, niet door het model zelf.
In Karpathy's systeem is de LLM zowel architect als bewoner. Het bouwt de kennisstructuur tijdens compilatie. Het schrijft de samenvattingen, maakt de links, organiseert de index. Vervolgens navigeert het tijdens queries door een huis dat het zelf heeft ontworpen. Het weet waar dingen zijn omdat het ze daar zelf heeft neergezet.
Dat is geen klein technisch verschil. Het is een ander paradigma voor hoe we denken over LLM's en kennis.
Het grootste deel van de AI-gemeenschap in 2026 is gefocust op het slimmer maken van retrieval — betere embeddings, betere herrangschikking, betere chunkselectie. Karpathy stelt een fundamenteel andere vraag: wat als we stoppen met de LLM als zoekmachine te behandelen en beginnen het als onderzoeksbibliothecaris te behandelen? Niet een die boeken vindt op verzoek, maar een die al elk boek in de collectie heeft gelezen, samenvattingen van elk heeft geschreven, een kruisverwijzingscatalogus heeft gemaakt, en je direct naar de plank kan leiden die je nodig hebt.
Die vraag gaat er meer toe doen naarmate contextvensters blijven groeien. Met Opus 4.6 die 1 miljoen tokens verwerkt, is de hoeveelheid kennis die een LLM kan navigeren via gestructureerde indexen — zonder enige vectorzoekopdracht — al praktisch voor de meeste persoonlijke en kleine-team use cases. En contextvensters worden alleen maar groter.
Mijn vectordatabase gaat nergens heen. Ik heb hem nog steeds nodig voor het productie-RAG-systeem dat ik bouwde voor het archief van 2 miljoen documenten van een klant. Maar voor mijn persoonlijke kennisbank? Voor het onderzoek dat ik doe naar AI-agenten, de artikelen die ik lees, de ideeën die ik verzamel? De vectordatabase is uitgeschakeld. De Obsidian-vault staat open. En voor het eerst voelt mijn kennisbank als iets dat ik daadwerkelijk kan doorbladeren, niet alleen bevragen.
Begin met 20 artikelen over een onderwerp waar je actief onderzoek naar doet. Knip ze in raw. Voer een compilatie uit. Stel de wiki een vraag. Kijk wat het verbindt. De setup kost een uur. Het moment dat het een verband legt tussen twee ideeën die je zelf niet had gelinkt — dat is wanneer je begrijpt waarom Karpathy dit bouwde in plaats van naar nog een vectordatabase te grijpen.
Veelgestelde Vragen
Vereist Karpathy's Obsidian RAG-systeem programmeerkennis?
Minimale programmeerkennis is nodig. Het systeem gebruikt Obsidian (gratis, grafisch) voor de interface en een LLM-agent zoals Claude Code voor wiki-compilatie. Je schrijft prompts in natuurlijke taal, geen code. Basiscomfort met de commandoregel helpt maar is niet strikt vereist.
Hoeveel documenten kan het Obsidian wiki-systeem verwerken?
Karpathy's aanpak werkt goed voor ongeveer 100-400 artikelen tot maximaal 400.000 woorden. Daarboven groeien de compilatietijden en verslechtert de indexcoherentie. Voor grotere collecties is een hybride aanpak of traditionele RAG-pipeline geschikter.
Kan ik GPT of andere LLM's gebruiken in plaats van Claude Code voor wiki-compilatie?
Ja. Karpathy's GitHub-gist noemt expliciet compatibiliteit met OpenAI Codex, Claude Code en andere LLM-agenten. De kwaliteit van compilatie hangt af van het redeneervermogen van het model — frontier-modellen produceren merkbaar betere synthese en kruisverwijzingen dan kleinere modellen.
Wat gebeurt er als Obsidian niet meer wordt onderhouden?
Er breekt niets. Elk bestand in het systeem is platte markdown die lokaal op je machine is opgeslagen. Je kunt de hele kennisbank openen in VS Code, Notion, Bear of elke teksteditor. Er is nul vendor lock-in by design.
Hoe verschilt dit van gewoon bestanden in een map zetten en ChatGPT gebruiken?
Het cruciale verschil is de compilatiestap. Ruwe bestanden die in een chat worden gedumpt geven de LLM ongestructureerde context. Karpathy's systeem laat de LLM die bestanden compileren tot gestructureerde wiki-artikelen met indexen, samenvattingen en kruisverwijzingen — waardoor een navigeerbare kennisstructuur ontstaat in plaats van een stapel documenten.
Laten We Samenwerken
Op zoek naar het bouwen van AI-systemen, het automatiseren van workflows of het opschalen van je tech-infrastructuur? Ik help graag.
- Fiverr (maatwerk builds & integraties): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (enterprise-oplossingen): ramlit.com
- ColorPark (design & branding): colorpark.io
- xCyberSecurity (beveiligingsdiensten): xcybersecurity.io