OKF Second Brain: Ich habe mein Claude-Setup umgestellt und es hörte endlich auf zu vergessen
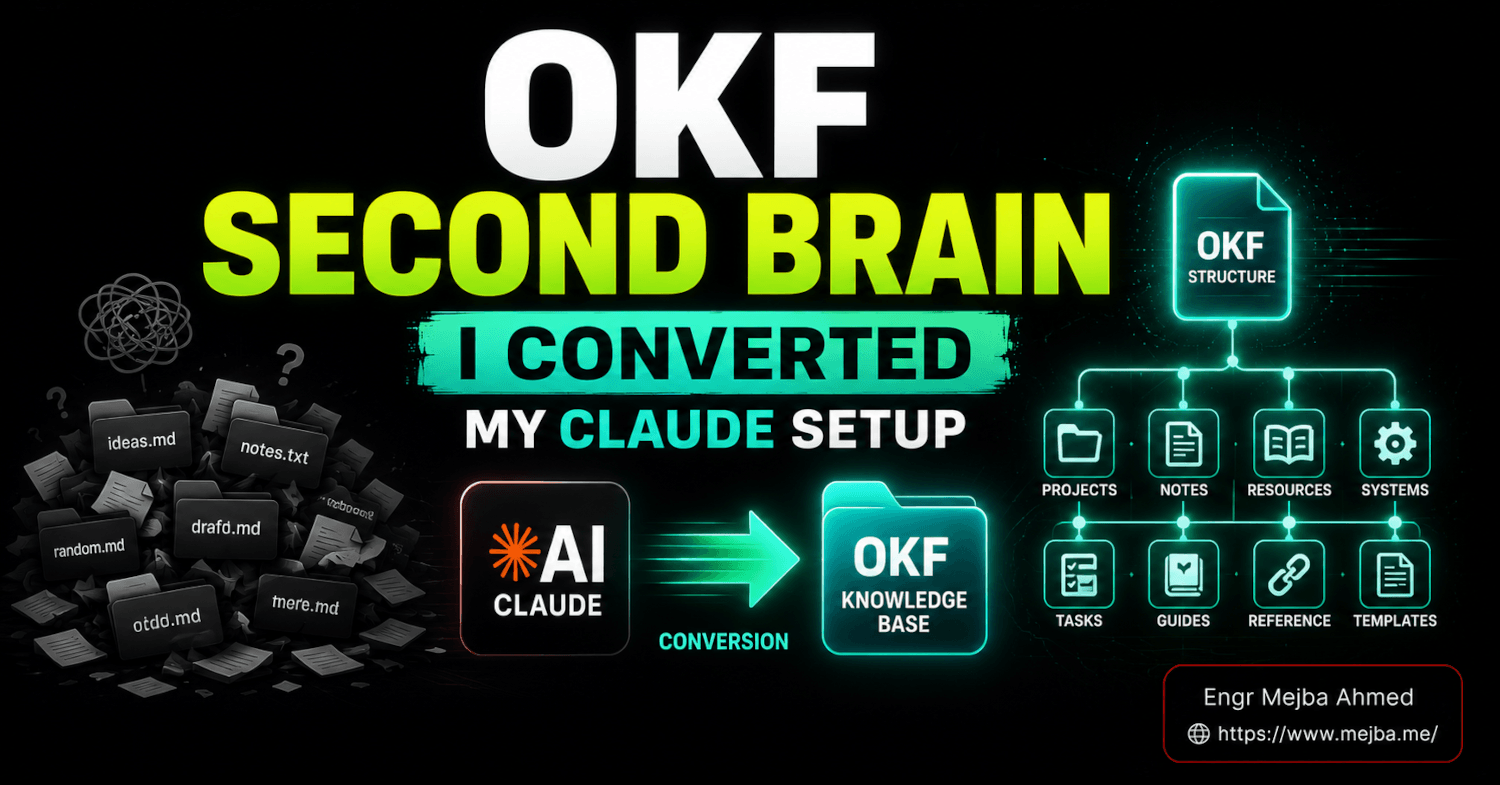
Ein OKF Second Brain ist eine persönliche Wissensbasis, die nach Googles Open Knowledge Format neu strukturiert wurde — ein Ordner mit Markdown-Konzeptdateien samt YAML-Frontmatter, angeführt von einer index.md-Karte, die sowohl du als auch ein KI-Agent wie Claude lesen, durchnavigieren und aktualisieren können. Ich habe meine an einem Wochenende im Juni 2026 konvertiert, und damit wurde das eine Problem gelöst, das ein Jahr Ordnerdisziplin nie in den Griff bekommen hat.
Der Moment, in dem ich mein altes Setup aufgab, war, als ich Claude dabei zusah, wie es eine Datei namens pricing-v2-FINAL.md mehrere Ordner tief anlegte — direkt neben der pricing.md, die es Wochen zuvor geschrieben und deren Existenz es offenbar vergessen hatte. Zwei Dateien. Dasselbe Wissen. Widersprechen sich. Beide selbstbewusst „korrekt".
Das ist die Fäulnis, die sich in jede persönliche Wissensbasis einschleicht, die so aufgebaut ist wie meine: ein Wildwuchs aus Markdown-Notizen, zusammengehalten von einer heldenhaften Claude.md-Datei, die gleichzeitig Index, Bibliothekarin und Gedächtnis spielt. Bei dreißig Dateien funktioniert das wunderbar. Bei dreihundert bricht es leise zusammen. Mein Agent war nicht dumm — er hatte nur keine zuverlässige Möglichkeit zu wissen, was bereits existierte, bevor er etwas Neues schrieb. Also leitete er neu ab, fasste neu zusammen und duplizierte, Session für Session.
Genau dieses Problem sollte Googles Open Knowledge Format aus der Welt schaffen, und mein Setup darum herum neu aufzubauen war der einzige Weg herauszufinden, ob das Format das Chaos tatsächlich behebt oder es nur umbenennt. Ich nehme dich mit durch die echte Konvertierung — die Ordnerchirurgie, den Konvertierungs-Skill, auf den ich mich verlassen habe, die eine Zeile, die ich zu Claude.md hinzugefügt habe und alles verändert hat, was kaputtging und das ehrliche Vorher-Nachher. Wenn du eine Markdown-Wissensbasis hast, die Claude wie eine Kramschublade behandelt, ist das der Weg heraus.
Ich setze voraus, dass du grob weißt, was OKF ist. Falls nicht, lies zuerst meinen Erstblick eines Erbauers auf das Open Knowledge Format — der behandelt die Spezifikation von Grund auf. Dieser Beitrag ist der Teil danach: Ich habe bereits ein Second Brain. Und jetzt?
Warum mein Claude Second Brain gegen die Wand fuhr
Lass mich das Setup beschreiben, weil deins vermutlich ähnlich reimt.
Ich hatte etwa ein Jahr lang eine persönliche Wissensbasis betrieben — die Art, die ich in meinem Claude Code Second Brain Build dokumentiert habe. Markdown-Dateien, verschachtelte Ordner nach Projekt und Thema und eine fette Claude.md im Root, die Claude sagte, wo die Dinge lagen und wie es sich verhalten sollte. Client-Playbooks. Preislogik. Code-Snippets. Meeting-Notizen. Hart erarbeitete Heuristiken, die ich nie wieder neu lernen wollte.
Das System hatte vier Fehlerarten, und die wurden schlimmer, je größer es wurde.
Claude konnte nicht erkennen, ob etwas schon existierte. Ohne eine maschinenlesbare Karte war die einzige Möglichkeit für den Agenten, „habe ich schon eine Notiz zur Rückerstattungsrichtlinie?" zu prüfen, Dateinamen zu greppen und Ordner zu überfliegen. Das ist langsam, Token-hungrig und unzuverlässig. Also prüfte er häufig nicht — und schrieb ein Duplikat. Der pricing-v2-FINAL.md-Moment war keine Ausnahme.
Suchen war eine Steuer. Jeder Abruf bedeutete, dass der Agent sich durch verschachtelte Verzeichnisse aufteilte, Dateien öffnete, um zu sehen, ob sie relevant waren, und Kontext in Sackgassen verbrannte. Je tiefer der Ordnerbaum, desto höher die Steuer.
Nichts war portabel. Mein Second Brain war maßgeschneidert auf meinen Workflow und meine Claude.md. Ich konnte es keinem Teamkollegen übergeben, in einen anderen Agenten einhängen oder einen Ausschnitt teilen, ohne dass das Ganze seine Bedeutung verlor. Es war ein privater Dialekt, keine Sprache.
Die Claude.md war auf gefährliche Weise tragend. Die gesamte Struktur lebte in der Prosa einer einzigen Datei. Wenn diese Datei aus dem Takt mit den tatsächlichen Ordnern geriet — und das tat sie immer — navigierte der Agent auf einer veralteten Karte.
Keines dieser Probleme ist exotisch. Sie sind das, was jede nicht standardisierte Second Brain ab einer bestimmten Größe trifft. Die Struktur, die sich am Anfang wie Freiheit anfühlte, wurde zu dem, was sie erwürgte. Ich hatte versucht, das mit besserer Ordnerdisziplin und einer längeren Claude.md zu beheben. Das ist, ein strukturelles Problem mit Willenskraft zu behandeln. Es hält nicht.
Was ich tatsächlich brauchte, war eine Standardform — eine, auf die sich der Agent verlassen kann, ohne dass ich jede Navigation an die Hand nehme. Genau darauf setzt OKF. Zeit, es zu testen.
Wie ein OKF Second Brain wirklich aussieht
Hier ist die Neurahmung, die das Format für mich Klick machte: OKF verlangt nicht, dass du Tooling hinzufügst. Es verlangt, dass du dich auf eine Form einigst. Und die Form ist fast beleidigend einfach — Markdown-Konzeptdateien mit YAML-Frontmatter, gruppiert zu einem Bundle, angeführt von einer index.md, die als Karte fungiert.
Mein altes Second Brain organisierte nach Projekt. Mein OKF Second Brain organisiert nach Konzept, mit einer harten Trennung, die mir Karpathys LLM-Wiki-Gist eingebläut hat: halte rohes Quellmaterial von synthetisiertem Wissen getrennt. Rohe Transkripte, gescrapte Seiten und abgeladene Notizen leben in /raw. Die sauberen, agentenlesbaren Konzepte leben im Wiki selbst. Der Agent liest /raw, extrahiert Konzepte und schreibt strukturierte Seiten — er serviert dir den rohen Haufen niemals direkt.
Die neue Struktur sieht so aus:
second-brain/
├── index.md              # the map: every concept, one line each
├── log.md                # append-only history of changes
├── raw/                  # source material, untouched
│   ├── call-2026-06-18.md
│   └── scraped-pricing-research.md
├── clients/
│   ├── index.md          # sub-map for this folder
│   ├── onboarding-sequence.md
│   └── escalation-playbook.md
└── business/
    ├── index.md
    ├── pricing-logic.md
    └── positioning.md
Jede Konzeptdatei trägt Frontmatter, das der Agent liest, bevor er den Body öffnet:
---
type: playbook
title: Client Onboarding Sequence
description: The exact steps I run when a new AI automation client signs.
tags: [onboarding, process, clients]
timestamp: 2026-06-18
---

# Client Onboarding Sequence

When a new client signs, I run these steps in order. Each step has a
trigger and a definition of done...
Das type-Feld ist das einzige, das OKF v0.1 strikt verlangt. Alles andere — title, description, tags, timestamp — ist empfohlen. Aber die description ist der stille Held hier, und ich zeige dir im Ergebnisteil, warum. Sie ist das, was einem Agenten erlaubt zu entscheiden, ob er eine Datei öffnen soll, ohne sie zu öffnen.
Die index.md ist der Ort, an dem ein flacher Ordner zu einem navigierbaren Graphen wird:
---
type: index
title: Second Brain — Root Index
---

# Second Brain Index

## clients/
- **onboarding-sequence** — steps run when a new client signs
- **escalation-playbook** — how to handle an unhappy client mid-project

## business/
- **pricing-logic** — how I price AI automation engagements
- **positioning** — who I serve and who I turn away
Diese einzeilige Beschreibung pro Konzept ist der ganze Trick. Der Agent liest den Index, sieht dreißig Beschreibungen und entscheidet, welche zwei Dateien er tatsächlich braucht — dann öffnet er nur diese. Es ist Progressive Disclosure, dasselbe Prinzip, das gut gebaute Claude-Skills effizient macht. Der Index ist das Spotlight. Die Konzepte sind das, worauf es zeigt.
Das ist der strukturelle Unterschied zwischen einem OKF Second Brain und dem Haufen, den ich vorher hatte: die Karte ist eine Datei, keine in Claude.md vergrabene Prosa, und sie lebt neben dem, was sie beschreibt. Wenn ich ein Konzept hinzufüge, aktualisiere ich seinen lokalen Index. Karte und Territorium bleiben synchron, weil sie Nachbarn sind.
Das ist das Ziel. Jetzt die Migration.
Wie ich mein Second Brain zu OKF konvertiert habe
Ich habe absichtlich zwei Durchgänge gemacht, weil ich das Format erst per Hand fühlen wollte, bevor ich ein Tool daran ließ. Es ist dieselbe Lektion, die ich immer wieder neu lerne: eine Spezifikation zu lesen lehrt dich fast nichts im Vergleich dazu, einen Ordner schlecht zu konvertieren.
Durchgang eins: das Rückgrat, per Hand. Ich griff mir meinen einen chaotischsten Ordner — Client-Arbeit — und baute ihn manuell neu auf. Ich erstellte die index.md, ging dann Datei für Datei durch, entschied den type und schrieb für jede eine einzeilige description. Das war langsam, und die Langsamkeit war der Punkt. Zu entscheiden, ob mein Preisdokument ein pricing, ein policy oder eine reference war, zwang mich dazu, tatsächlich zu verstehen, was jede Notiz war. Die Hälfte meiner „Duplikat"-Dateien entpuppte sich als dasselbe Konzept, zweimal aus unterschiedlichen Blickwinkeln geschrieben. Die Konvertierung brachte die Duplizierung an die Oberfläche, für die ich blind gewesen war.
Meine mit Abstand größte Erkenntnis aus Durchgang eins: schreibe dein type-Vokabular als eigene Konzeptdatei nieder, bevor du irgendetwas konvertierst. OKF diktiert deine Typen absichtlich nicht, und diese Freiheit wird schnell zu Entscheidungsmüdigkeit und Inkonsistenz. Ich erstellte business/type-vocabulary.md mit den acht Typen, die ich zulassen würde — playbook, runbook, reference, pricing, case-study, glossary, decision, index — und weigerte mich, spontan einen neunten zu erfinden. Konsistente Typen sind der Unterschied zwischen einem Bundle, das ein Agent gut durchnavigiert, und einem, in dem er stolpert.
Durchgang zwei: Automatisierung für die Masse. Dreihundert Dateien per Hand zu konvertieren war nie der Plan. Für den Rest stützte ich mich auf das okf-skills Claude Code Plugin — ein Open-Source-Set an Skills, das Claude Code beibringt, OKF-Bundles zu erstellen, zu pflegen und zu validieren, gesteuert von der wortwörtlichen Spezifikation und abgesichert durch einen Konformitätsprüfer. Dieser letzte Teil ist wichtiger, als er klingt: er bedeutet, dass die Ausgabe des Agenten gegen die Spezifikation geprüft wird, statt ihr blind zu vertrauen. Ich habe mir auch Suganthan Mohanadasans OKF Bundle Generator für den URL-zu-Bundle-Weg angesehen, aber für einen lokalen Markdown-Ordner passte der Claude-Code-Skill-Weg besser.
Und jetzt der ehrliche Teil: die Automatisierung traf die einfachen 80 % perfekt und stolperte bei den wertvollen 20 %. Seite-zu-Markdown-mit-Frontmatter ist ein gelöstes Problem — der Skill fügte meinen bestehenden Notizen sauber die Felder type und description hinzu und markierte Spezifikationsverstöße. Was er zuverlässig nicht konnte, war der harte Akt: eine 2.000-Wörter-Notiz zu lesen, die insgeheim drei verschiedene Konzepte enthielt, und sie in drei Dateien zu splitten. Diese Dekomposition — das Entbacken einer verknoteten Notiz in ihre separaten Ideen — bleibt größtenteils an dir hängen. Ein LLM kann es versuchen, aber naiv auf „zerlege das in Konzepte" angesetzt produziert es überlappende, sich widersprechende Dateien. Ich habe jeden Split von Hand überprüft.
Die eine Zeile, die alles veränderte. Nichts von der Struktur zählt, wenn der Agent sie nicht nutzt. Der Durchbruch war eine kleine, explizite Anweisung ganz oben in Claude.md:
## Knowledge Base Protocol

This is an OKF bundle. Before answering any question or creating any file:

1. Read `index.md` at the relevant level FIRST.
2. Use file `description` fields to decide what to open — do NOT open
   files to check relevance.
3. Before creating a concept, check the index for an existing one.
   Update it instead of duplicating.
4. After any change, append a line to `log.md`.
Das war's. Vier Regeln. Das Format gibt dem Agenten eine zuverlässige Karte; das sagt ihm, die Karte auch tatsächlich zuerst zu lesen. Ohne diese Anweisungen behandelte Claude das OKF-Bundle wie jeden anderen Ordner und ging zurück zum Greppen. Mit ihnen änderte sich sein Verhalten sichtbar — was die eigentliche Ergebnisstory ist.
Falls du diese Konvertierung lieber für dich erledigen lässt — das Typvokabular entworfen, die Dekomposition richtig gemacht, das Claude.md-Protokoll fein abgestimmt — genau solche Pipelines baue ich. Du siehst die Arbeit unter fiverr.com/s/EgxYmWD. Aber im Ernst: konvertiere zuerst einen Ordner von Hand. Es dauert einen Nachmittag und bringt dir bei, was dir kein Tool beibringen wird.
Was während der Konvertierung kaputtging
Ein Build-Log ohne die Fehler ist Marketing, kein Lehren. Drei Dinge haben mich gebissen.
Die description-Felder waren faul, und der Agent erbte meine Faulheit. Meine erste Charge Beschreibungen waren Dinge wie „Notizen zum Pricing" — nutzlos. Wenn die gesamte Navigationsstrategie davon abhängt, dass der Agent Beschreibungen statt Dateien liest, bricht eine vage Beschreibung das System still. Der Agent kann pricing-logic nicht von pricing-history unterscheiden, wenn beide „Notizen zum Pricing" sagen, also öffnet er beide, und du bist zurück bei der Token-Steuer, der du entkommen wolltest. Ich musste jede Beschreibung so umschreiben, dass sie unterscheidend wurde — was diese Datei von ihren Nachbarn abhebt — nicht nur beschreibend. Dieses Umschreiben dauerte länger als die strukturelle Konvertierung.
Überall veraltete Links. Wenn du Dateien splittest und umbenennst, verrotten interne Referenzen. Meine alten Notizen kreuzverwiesen sich per Dateiname, und die Hälfte dieser Namen änderte sich. OKF toleriert kaputte Links per Design — die Spezifikation behandelt Links als untypisierte Kanten und zuckt bei toten die Schultern — was tolerant ist, aber auch bedeutet, dass dich nichts warnt. Ich musste manuell nach verwaisten Referenzen greppen. Ein Link-Checker kommt auf meine Irgendwann-Liste.
Ich habe anfangs überatomisiert. Betrunken von der Regel „ein Konzept pro Datei" zersplitterte ich ein kohärentes Onboarding-Playbook in elf Mikrodateien: eine pro Schritt. Das ist nicht Minimalismus, das ist Konfetti. Der Agent musste jetzt einen einzigen Prozess aus elf Fragmenten wieder zusammensetzen, was schlechter ist als eine gut strukturierte Datei. Minimalismus in OKF heißt eine kohärente Idee pro Datei, nicht ein Satz pro Datei. Ich habe sie wieder zu einer einzigen onboarding-sequence.md mit überschriebenen Abschnitten zusammengefügt. Die Grenze zwischen „atomar" und „zerschreddert" ist Urteilssache, und ich lag falsch, bevor ich richtig lag.
Keines davon ist ein Dealbreaker. Es ist die normale Reibung, einem Jahr organischen Chaos eine Struktur aufzuzwingen. Aber wenn du reingehst und erwartest, dass ein Tool das übernimmt, lieferst du ein Bundle, das konform aussieht und schlecht navigiert. Die Spezifikation validiert Form, nicht Qualität. Qualität ist immer noch dein Job.
Das abgehakt — hier ist, was ich tatsächlich für das Wochenende bekam.
Die OKF Second Brain Ergebnisse: Was sich wirklich änderte
Ich will hier vorsichtig sein, weil genau an dieser Stelle Wissensdatenbank-Content unehrlich wird mit erfundenen Benchmarks. Ich habe keine kontrollierte Token-Zählung-Studie mit sauberen Fehlerbalken durchgeführt, also gebe ich dir keine gefakte „73 % weniger Tokens"-Zahl. Was ich dir geben kann, ist das, was sich am beobachtbaren Agentenverhalten geändert hat, und der Mechanismus, der es erklärt.
Die Duplizierung hörte auf. Das war der ganze Grund, warum ich angefangen hatte. Weil Regel 3 des Protokolls einen Index-Check vor der Erstellung erzwingt und weil der Index eine echte Karte ist, die der Agent günstig scannen kann, findet Claude jetzt das bestehende Konzept und aktualisiert es, statt ein thing-v2-FINAL.md zu schreiben. In den Wochen seit der Konvertierung habe ich kein einziges Duplikat-Konzept mehr erwischt. Allein das rechtfertigt das Wochenende.
Der Agent öffnet weniger Dateien, um zu antworten. Vorher bedeutete das Beantworten einer Frage, dass der Agent mehrere Dateien überflog, um die relevante zu finden. Jetzt liest er die index.md, wählt die Datei, deren description passt, und öffnet diese. Ich habe ihm dabei zugesehen, wie er eine Frage beantwortete, die nur eins von vierzig Konzepten adressieren konnte — er las den Index, öffnete genau diese Datei und rührte die anderen neununddreißig nie an. Der Mechanismus ist simpel und real: eine kurze YAML-Beschreibung zu parsen ist weit günstiger als einen kompletten Datei-Body zu lesen, also bedeutet ein Vorfiltern nach Beschreibungen weniger verschwendete Volldateilesungen. Das ist kein Benchmark; so funktioniert Progressive Disclosure.
Er hörte auf, Kontext neu abzuleiten. Die befriedigendste Veränderung ist die am schwersten zu screenshottende. Mit einer stabilen, navigierbaren Wissensbasis hört der Agent auf, jede Session denselben Hintergrund neu zusammenzufassen, weil er die synthetisierte Version, die er letztes Mal geschrieben hat, zuverlässig finden kann. Die Trennung zwischen /raw und Wiki verstärkt das — fertiges Denken lebt im Wiki und wird wiederverwendet, statt jedes Mal neu aus rohen Notizen extrahiert zu werden.
Es ist endlich portabel. Mein Second Brain ist jetzt ein Ordner mit Standard-Markdown, den ich in ein Git-Repo pushen, einem anderen Agenten übergeben oder als Ausschnitt teilen könnte, und es würde in einem fremden Setup immer noch etwas bedeuten. Das stimmte vorher nicht. Das Format ist die gemeinsame Sprache, die ein privates System für jeden lesbar macht — Mensch oder Agent.
Für die tiefere Argumentation „warum schlägt standardisierte Struktur eine clevere Claude.md" habe ich die Ebenen des Agentengedächtnisses in meinen sechs Ebenen der Claude Code Memory Systeme aufgeschlüsselt — OKF ist im Wesentlichen eine saubere, teilbare Implementierung der höheren Ebenen.
Die ehrliche Zusammenfassung: OKF hat meinen Agenten nicht klüger gemacht. Es hat die Umgebung meines Agenten lesbar gemacht, und eine lesbare Umgebung ist das, was einen fähigen Agenten davon abhält, sich dumm zu verhalten.
Solltest du dein Second Brain zu OKF konvertieren?
Direkte Antwort: konvertiere, wenn deine Wissensbasis groß genug ist, dass der Agent den Überblick verliert — und lass es sein, wenn du unter fünfzig Dateien bist und alles bequem in den Kopf des Agenten passt.
Die Konvertierung hat echte Kosten. Du wirst Stunden damit verbringen, unterscheidende Beschreibungen zu schreiben, ein Typ-Vokabular zu entwerfen und automatisierte Splits zu überprüfen. Diese Kosten zahlen sich erst aus, wenn deine Basis groß genug ist, dass die Navigation zum Flaschenhals geworden ist. Bei dreißig gut benannten Dateien ist eine gute Claude.md wirklich in Ordnung, und OKF ist übertrieben. Die Duplizierungs- und Suchsteuer, gegen die ich lief, ist ein Skalierungsproblem.
Konvertiere, wenn irgendetwas davon zutrifft: dein Agent dupliziert Wissen, das er schon hat; das Abrufen fühlt sich langsam und Token-schwer an; du willst die Basis über Tools hinweg teilen oder einhängen; oder du betreibst schon ein Karpathy-artiges lebendiges Wiki und willst, dass es einen Standard spricht, den andere Tools konsumieren können. Wenn du dieses Living-Wiki-Muster baust, passt mein Obsidian + Claude Code Second Brain-Walkthrough natürlich zu OKF — Obsidian für die menschliche Graphenansicht, OKF als der On-Disk-Standard darunter.
Warte ab, wenn du unter fünfzig Dateien bist, wenn deine Basis rein persönlich ist und nie geteilt wird, oder wenn du versucht bist zu konvertieren, weil OKF neu und glänzend ist und nicht, weil du gegen eine echte Wand gelaufen bist. Neu ist kein Grund. Eine Wand schon.
Eines würde ich nicht tun: OKF v0.1 als fertig behandeln. Google hat es einen Startpunkt genannt, und das ist es — es ist noch kein formales Discovery-Protokoll eingebacken, keine Link-Validierung, keine Qualitätsdurchsetzung. Darauf aufzubauen ist klug. Deinen gesamten Betrieb auf die aktuelle Form zu setzen ist es nicht. Konvertiere den Teil, der schmerzt, lerne die Form, und lass die Spezifikation reifen, bevor du all in gehst.
Häufig gestellte Fragen
Was ist ein OKF Second Brain?
Ein OKF Second Brain ist eine persönliche Wissensbasis, die nach Googles Open Knowledge Format strukturiert ist — ein Verzeichnis aus Markdown-Konzeptdateien mit YAML-Frontmatter, angeführt von einer index.md-Karte, das sowohl du als auch ein KI-Agent wie Claude lesen, durchnavigieren und aktualisieren können. Es ersetzt Ad-hoc-Ordner und eine lange Claude.md durch eine standardisierte, portable Form.
Wie konvertiere ich eine bestehende Claude-Wissensbasis zu OKF?
Konvertiere zuerst einen Ordner per Hand, um das Format zu lernen, definiere ein festes type-Vokabular, und nutze dann ein Tool wie das okf-skills Claude Code Plugin, um den Rest mit Frontmatter zu versehen. Der schwierigste Schritt — zusammengebackene Notizen in saubere Einzelkonzepte zu splitten — braucht immer noch menschliche Prüfung. Schließe ab, indem du deiner Claude.md ein Index-zuerst-Protokoll hinzufügst. Siehe den Konvertierungs-Walkthrough oben für die exakten Schritte.
Macht OKF Claude schneller beim Durchsuchen meiner Notizen?
OKF reduziert verschwendete Dateilesungen, statt das Modell selbst schneller zu machen. Weil der Agent kurze YAML-description-Felder im Index liest, bevor er irgendeine Datei öffnet, filtert er auf das relevante Konzept, ohne irrelevante zu überfliegen — was den Token-Verbrauch beim Abrufen senkt. Der Gewinn skaliert damit, wie groß und chaotisch deine Basis anfangs war.
Brauche ich mit einem OKF Second Brain immer noch eine Claude.md-Datei?
Ja, aber ihre Aufgabe schrumpft. Statt deine gesamte Struktur in Prosa zu halten, wird die Claude.md zu einem kurzen Protokoll, das dem Agenten sagt, zuerst die index.md zu lesen, nach Beschreibungen zu navigieren, vor dem Anlegen auf Duplikate zu prüfen und Änderungen zu protokollieren. Die Struktur lebt im Bundle; die Claude.md sagt dem Agenten nur, wie er sie nutzen soll.
Ist OKF besser als RAG für ein Second Brain?
Sie lösen unterschiedliche Probleme. RAG durchsucht einen statischen Haufen eingebetteter Chunks und baut den Kontext bei jeder Anfrage neu auf, ohne Wissen anzuhäufen. Ein OKF Second Brain ist eine kuratierte, lebendige Sammlung von Konzepten, die der Agent im Lauf der Zeit liest und aktualisiert, sodass es sich anhäuft. Für sich entwickelndes persönliches Wissen, das du überarbeitest, passt OKFs wartbare Struktur tendenziell besser als reines Vektor-RAG.
Der Ordner, der aufhörte zu vergessen
Ich habe dieses ganze Experiment wegen zweier sich widersprechender Preisdateien begonnen. Ich beende es auch dort, weil die Auflösung der Punkt ist.
Ein paar Tage nach der Konvertierung bat ich Claude, meine Preislogik für eine neue Servicestufe zu aktualisieren. Es las den Root-Index, ging direkt zu business/pricing-logic.md, öffnete diese eine Datei, überarbeitete sie und hängte eine Zeile an log.md an. Keine neue Datei. Kein v2-FINAL. Kein Widerspruch. Es fand das, was es schon wusste, und änderte es, wie es eine Person mit echtem Gedächtnis tun würde.
Das ist das ganze Versprechen eines OKF Second Brain, und es ist kleiner und ehrlicher, als der Hype um das Format vermuten lässt. OKF hat meinem Agenten keine Intelligenz gegeben. Es hat ihm eine Karte gegeben, der er trauen kann — und ein fähiger Agent mit einer vertrauenswürdigen Karte hört auf, sich wie ein Amnesiker zu verhalten. Das Format wird sich über v0.1 hinaus weiterentwickeln, das Tooling wird besser werden, und der verkaufbare Bundle-Marktplatz, den die Leute vorhersagen, kommt oder auch nicht. Nichts davon ändert den Schritt, der dir heute offensteht.
Also hier ist das eine, was es wert ist, vor Wochenende noch zu tun: nimm deinen einen chaotischsten Wissensordner — den, in dem dein Agent immer wieder stolpert — und konvertiere nur diesen einen per Hand zu OKF. Schreibe den Index. Schreibe unterscheidende Beschreibungen. Füge das Vier-Zeilen-Protokoll zu Claude.md hinzu. Dann stelle deinem Agenten eine Frage, die nur eine Datei beantworten kann, und schau, was er tut. Wenn er die Karte liest und genau die richtige Datei öffnet, wirst du in dreißig Sekunden verstehen, was mich ein Wochenende gekostet hat zu fühlen.
Willst du das erledigt haben
Das Typ-Vokabular zu entwerfen, zusammengebackene Notizen sauber zu splitten und das Claude.md-Protokoll fein abzustimmen ist der fummelige Teil — und genau die Pipeline baue ich für Leute, deren Second Brain aus einem handgeschriebenen Index herausgewachsen ist. Wenn du deins ohne das Trial-and-Error in ein sauberes, portables OKF-Bundle konvertiert haben willst, ist das die Arbeit, die ich drüben auf Fiverr annehme.