OKF Second Brain: Converti a Minha Configuração Claude e Finalmente Deixou de Esquecer
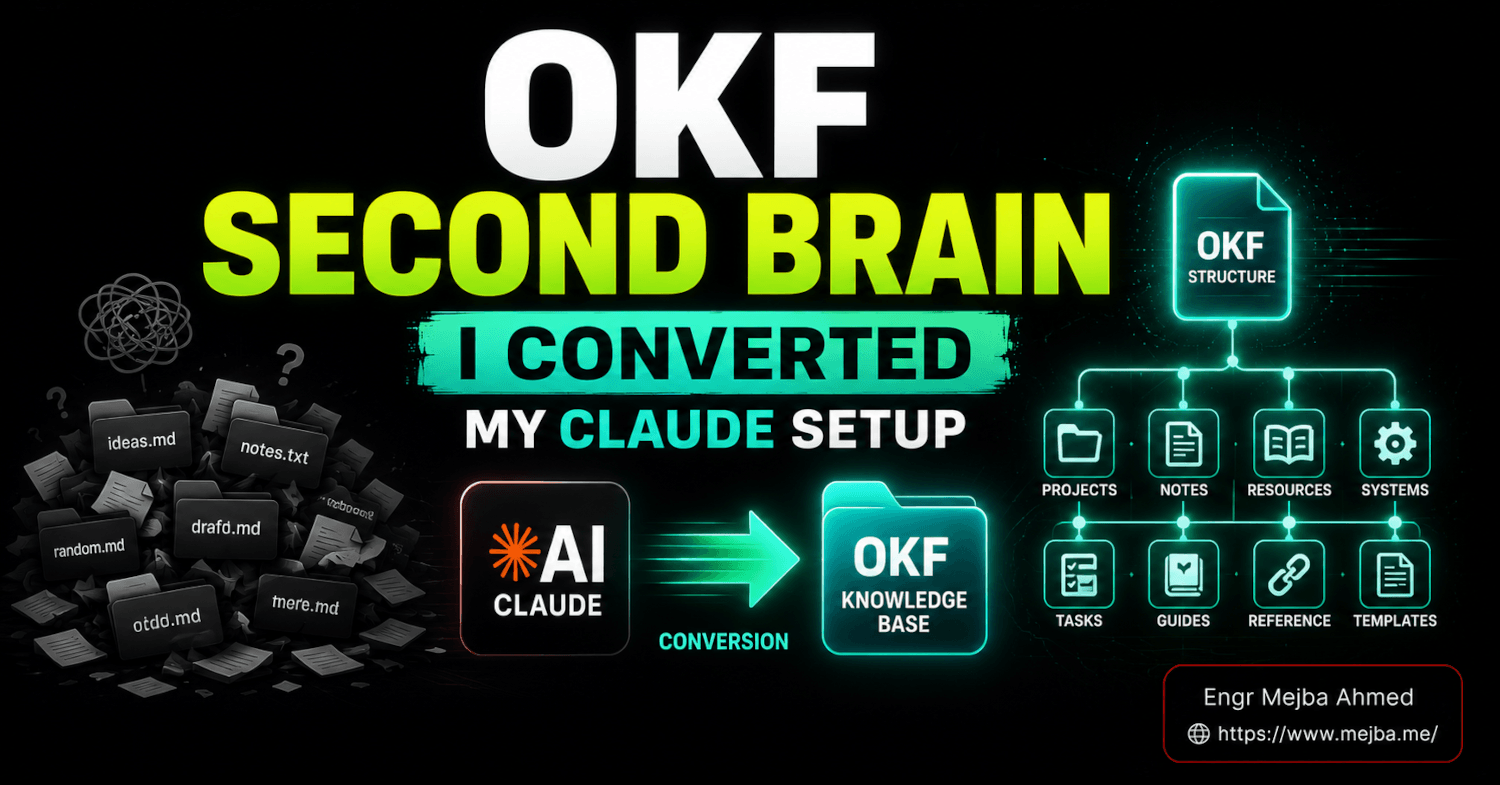
Um OKF second brain é uma base de conhecimento pessoal reestruturada segundo o Open Knowledge Format da Google — uma pasta de ficheiros markdown de conceitos com front matter YAML, encabeçada por um mapa index.md que tanto tu como um agente de IA como o Claude conseguem ler, navegar e atualizar. Converti a minha durante um fim de semana em junho de 2026, e resolveu o único problema que um ano de disciplina de pastas nunca conseguiu.
O momento em que desisti da minha antiga configuração foi ao ver o Claude criar um ficheiro chamado pricing-v2-FINAL.md várias pastas abaixo — mesmo ao lado do pricing.md que ele próprio tinha escrito semanas antes e aparentemente esquecido que existia. Dois ficheiros. O mesmo conhecimento. A contradizerem-se. Ambos confiantemente "corretos".
É essa a podridão que se instala em qualquer base de conhecimento pessoal construída como a minha: um emaranhado de notas markdown mantido junto por um ficheiro Claude.md heroico a fazer o trabalho de um índice, de um bibliotecário e de uma memória, tudo ao mesmo tempo. Funciona lindamente com trinta ficheiros. Desmorona-se em silêncio aos trezentos. O meu agente não era burro — simplesmente não tinha forma fiável de saber o que já existia antes de escrever algo novo. Por isso re-derivava, re-resumia e duplicava, sessão após sessão.
É exatamente este problema que o Open Knowledge Format da Google foi criado para matar, e reconstruir a minha configuração à volta dele era a única forma de descobrir se o formato resolve mesmo a confusão ou apenas lhe muda o nome. Vou guiar-te pela conversão real — a cirurgia de pastas, a skill de conversão em que me apoiei, a linha que acrescentei ao Claude.md e que mudou tudo, o que correu mal, e o antes-e-depois honesto. Se tens uma base de conhecimento em markdown que o Claude trata como uma gaveta de trastes, este é o caminho para sair dela.
Vou assumir que já sabes mais ou menos o que é o OKF. Se não sabes, lê primeiro o meu primeiro olhar de construtor sobre o Open Knowledge Format — cobre a especificação do zero. Este texto é a parte que vem a seguir: já tenho um second brain. E agora?
Porque é que o Meu Claude Second Brain Bateu Numa Parede
Deixa-me descrever a configuração, porque a tua provavelmente rima com ela.
Andava a manter uma base de conhecimento pessoal há cerca de um ano — do género que documentei na minha construção de second brain com Claude Code. Ficheiros markdown, pastas aninhadas por projeto e tópico, e um Claude.md gordo na raiz a dizer ao Claude onde as coisas viviam e como se comportar. Playbooks de clientes. Lógica de preços. Snippets de código. Notas de reunião. Heurísticas ganhas a duras penas que eu não queria voltar a aprender.
O sistema tinha quatro modos de falha, e pioravam à medida que crescia.
O Claude não conseguia saber se algo já existia. Sem um mapa legível por máquina, a única forma de o agente verificar "já tenho uma nota sobre política de reembolsos?" era fazer grep aos nomes de ficheiros e folhear pastas. É lento, gasta tokens e não é fiável. Por isso frequentemente não verificava — e escrevia um duplicado. Aquele momento pricing-v2-FINAL.md não foi caso isolado.
A pesquisa era um imposto. Cada consulta obrigava o agente a espalhar-se por diretórios aninhados, a abrir ficheiros para ver se eram relevantes, e a queimar contexto em becos sem saída. Quanto mais profunda a árvore de pastas, mais pesado o imposto.
Nada era portátil. O meu second brain era feito à medida do meu fluxo de trabalho e do meu Claude.md. Não o podia passar a um colega, montar noutro agente, ou partilhar uma fatia sem que tudo perdesse sentido. Era um dialeto privado, não uma língua.
O Claude.md era estrutural de uma forma perigosa. Toda a estrutura vivia na prosa de um ficheiro. Se esse ficheiro se desalinhasse das pastas reais — e desalinhava-se sempre — o agente navegava por um mapa desatualizado.
Nenhum destes problemas é exótico. São os que qualquer second brain não padronizado enfrenta a partir de certa dimensão. A estrutura que parecia liberdade no início transformou-se naquilo que a estava a estrangular. Tinha tentado remediar com melhor disciplina de pastas e um Claude.md mais longo. Isso é tratar um problema estrutural com força de vontade. Não dura.
O que eu precisava mesmo era de uma forma-padrão — uma em que o agente pudesse confiar sem que eu lhe pegasse na mão a cada navegação. É essa a aposta do OKF. Hora de a testar.
O Que É que um OKF Second Brain Parece Mesmo
Aqui está a reformulação que fez o formato encaixar para mim: o OKF não te pede para acrescentar ferramentas. Pede-te para concordar com uma forma. E a forma é quase insultuosamente simples — ficheiros markdown de conceitos com front matter YAML, agrupados num bundle, encabeçados por um index.md que serve de mapa.
O meu antigo second brain organizava por projeto. O meu OKF second brain organiza por conceito, com uma separação dura que o gist do LLM Wiki do Karpathy me martelou na cabeça: manter material bruto separado de conhecimento sintetizado. Transcrições em bruto, páginas raspadas e notas despejadas ficam em /raw. Os conceitos limpos, legíveis pelo agente, ficam no próprio wiki. O agente lê o /raw, extrai conceitos, e escreve páginas estruturadas — nunca te serve a pilha bruta diretamente.
A nova estrutura parece-se com isto:
second-brain/
├── index.md              # the map: every concept, one line each
├── log.md                # append-only history of changes
├── raw/                  # source material, untouched
│   ├── call-2026-06-18.md
│   └── scraped-pricing-research.md
├── clients/
│   ├── index.md          # sub-map for this folder
│   ├── onboarding-sequence.md
│   └── escalation-playbook.md
└── business/
    ├── index.md
    ├── pricing-logic.md
    └── positioning.md
Cada ficheiro de conceito carrega front matter que o agente lê antes de abrir o corpo:
---
type: playbook
title: Client Onboarding Sequence
description: The exact steps I run when a new AI automation client signs.
tags: [onboarding, process, clients]
timestamp: 2026-06-18
---

# Client Onboarding Sequence

When a new client signs, I run these steps in order. Each step has a
trigger and a definition of done...
O campo type é o único que a OKF v0.1 exige estritamente. Tudo o resto — title, description, tags, timestamp — é recomendado. Mas o description é o herói silencioso, e vou mostrar-te porquê na secção dos resultados. É o que permite a um agente decidir se abre um ficheiro sem o abrir.
O index.md é onde uma pasta plana se torna um grafo navegável:
---
type: index
title: Second Brain — Root Index
---

# Second Brain Index

## clients/
- **onboarding-sequence** — steps run when a new client signs
- **escalation-playbook** — how to handle an unhappy client mid-project

## business/
- **pricing-logic** — how I price AI automation engagements
- **positioning** — who I serve and who I turn away
Aquela descrição de uma linha por conceito é o truque todo. O agente lê o índice, vê trinta descrições, e decide quais os dois ficheiros de que precisa mesmo — depois abre apenas esses. É divulgação progressiva, o mesmo princípio que torna eficientes as skills bem construídas para o Claude. O índice é o holofote. Os conceitos são aquilo para onde ele aponta.
Esta é a diferença estrutural entre um OKF second brain e a pilha que eu tinha antes: o mapa é um ficheiro, não prosa enterrada no Claude.md, e vive ao lado daquilo que descreve. Quando acrescento um conceito, atualizo o índice local. O mapa e o território mantêm-se sincronizados porque são vizinhos.
É esse o alvo. Agora, a migração.
Como Converti o Meu Second Brain para OKF
Fiz duas passagens de propósito, porque queria sentir o formato à mão antes de deixar uma ferramenta tocar-lhe. É a mesma lição que ando sempre a reaprender: ler uma especificação ensina-te quase nada comparado com converter uma pasta mal.
Primeira passagem: a espinha, à mão. Escolhi a minha pasta mais bagunçada — trabalho com clientes — e reconstruí-a manualmente. Criei o index.md, depois fui ficheiro a ficheiro a decidir o type e a escrever uma description de uma linha para cada. Foi lento, e a lentidão era o ponto. Decidir se o meu documento de preços era pricing, policy ou reference obrigou-me a perceber mesmo o que cada nota era. Metade dos meus ficheiros "duplicados" acabaram por ser o mesmo conceito escrito duas vezes de ângulos diferentes. A conversão trouxe à tona a duplicação para a qual estivera cego.
A minha maior conclusão da primeira passagem: escreve o teu vocabulário de type como o seu próprio ficheiro de conceito antes de converteres seja o que for. O OKF deliberadamente não te dita os tipos, e essa liberdade transforma-se depressa em fadiga de decisão e inconsistência. Criei business/type-vocabulary.md a listar os oito tipos que ia permitir — playbook, runbook, reference, pricing, case-study, glossary, decision, index — e recusei-me a inventar um nono no momento. Tipos consistentes são a diferença entre um bundle em que o agente navega bem e um em que tropeça.
Segunda passagem: automação para o grosso. Converter trezentos ficheiros à mão nunca esteve nos planos. Para o resto, apoiei-me no plugin okf-skills para Claude Code — um conjunto open-source de skills que ensina o Claude Code a criar, manter e validar bundles OKF, orientado pela especificação literal e apoiado num verificador de conformidade. Essa última parte é mais importante do que parece: significa que o output do agente é verificado contra a especificação em vez de aceite às cegas. Também olhei para o OKF Bundle Generator do Suganthan Mohanadasan para o caminho URL-para-bundle, mas para uma pasta markdown local a rota da skill Claude Code encaixou melhor.
Aqui vai a parte honesta: a automação acertou nos 80% fáceis e atrapalhou-se nos 20% valiosos. Página-para-markdown-com-front-matter é um problema resolvido — a skill acrescentou campos type e description às minhas notas existentes de forma limpa e assinalou violações da especificação. O que ela não conseguiu fazer de forma fiável foi o ato difícil: ler uma nota de 2.000 palavras que secretamente continha três conceitos distintos e dividi-la em três ficheiros. Essa decomposição — desamarrotar uma nota emaranhada nas suas ideias separadas — é a parte que ainda depende sobretudo de ti. Um LLM pode tentá-la, mas apontado ingenuamente a "parte isto em conceitos" produz ficheiros sobrepostos e contraditórios. Revi cada divisão à mão.
A linha que mudou tudo. Nada da estrutura importa se o agente não a usar. O desbloqueio foi uma instrução pequena e explícita no topo do Claude.md:
## Knowledge Base Protocol

This is an OKF bundle. Before answering any question or creating any file:

1. Read `index.md` at the relevant level FIRST.
2. Use file `description` fields to decide what to open — do NOT open
   files to check relevance.
3. Before creating a concept, check the index for an existing one.
   Update it instead of duplicating.
4. After any change, append a line to `log.md`.
É isto. Quatro regras. O formato dá ao agente um mapa fiável; isto diz-lhe para ler mesmo o mapa primeiro. Sem estas instruções, o Claude tratava o bundle OKF como qualquer outra pasta e voltava ao grep. Com elas, o comportamento mudou de forma visível — que é toda a história dos resultados.
Se preferires ter esta conversão feita por ti — o vocabulário de tipos desenhado, a decomposição feita como deve ser, o protocolo do Claude.md afinado — é exatamente o tipo de pipeline que construo. Podes ver o trabalho em fiverr.com/s/EgxYmWD. Mas a sério: converte uma pasta à mão primeiro. Leva uma tarde e ensina-te o que nenhuma ferramenta te ensina.
O Que Se Partiu Durante a Conversão
Um registo de construção sem as falhas é marketing, não ensino. Três coisas trincaram-me.
Os campos description foram preguiçosos, e o agente herdou a minha preguiça. O meu primeiro lote de descrições eram coisas como "notas sobre preços" — inúteis. Quando toda a estratégia de navegação depende de o agente ler descrições em vez de ficheiros, uma descrição vaga parte o sistema em silêncio. O agente não consegue distinguir pricing-logic de pricing-history se ambos disserem "notas sobre preços", por isso abre os dois, e estás de volta ao imposto de tokens que tentavas evitar. Tive de reescrever cada descrição para ser discriminante — o que torna este ficheiro diferente dos vizinhos — e não apenas descritiva. Essa reescrita demorou mais do que a conversão estrutural.
Ligações desatualizadas por todo o lado. Quando divides e renomeias ficheiros, as referências internas apodrecem. As minhas notas antigas referenciavam-se umas às outras pelo nome de ficheiro, e metade desses nomes mudou. O OKF tolera ligações partidas por desenho — a especificação trata ligações como arestas não tipadas e encolhe os ombros perante as mortas — o que é indulgente mas também significa que nada te avisa. Tive de fazer grep manualmente por referências órfãs. Um verificador de ligações vai para a minha lista de um-dia-destes.
Sobre-atomizei no início. Embriagado com a regra "um conceito por ficheiro", estilhacei um playbook coeso de onboarding em onze microficheiros: um por passo. Isso não é minimalismo, é confete. O agente tinha agora de reconstruir um único processo a partir de onze fragmentos, o que é pior do que um ficheiro bem estruturado. Minimalismo em OKF significa uma ideia coerente por ficheiro, não uma frase por ficheiro. Recompus tudo num único onboarding-sequence.md com secções tituladas. A linha entre "atómico" e "picado" é uma questão de bom senso, e errei antes de acertar.
Nenhum destes é impeditivo. São o atrito normal de impor estrutura a um ano de bagunça orgânica. Mas se entrares à espera que uma ferramenta trate deles, entregas um bundle que parece conforme e navega mal. A especificação valida a forma, não a qualidade. A qualidade continua a ser trabalho teu.
Isto arrumado, aqui está o que ganhei de facto pelo fim de semana.
Os Resultados do OKF Second Brain: O Que Mudou de Facto
Quero ser cuidadoso aqui, porque é exatamente onde o conteúdo sobre bases de conhecimento se torna desonesto com benchmarks inventados. Não corri um estudo controlado de contagem de tokens com barras de erro decentes, por isso não te vou entregar um número falso do género "73% menos tokens". O que posso dar-te é o que mudou no comportamento observável do agente, e o mecanismo que o explica.
A duplicação parou. Foi a razão toda pela qual comecei. Como a regra 3 do protocolo força uma verificação do índice antes da criação, e como o índice é um mapa real que o agente pode varrer a baixo custo, o Claude encontra agora o conceito existente e atualiza-o em vez de escrever thing-v2-FINAL.md. Nas semanas desde a conversão, não apanhei um único conceito duplicado. Só isso justificou o fim de semana.
O agente abre menos ficheiros para responder. Antes, responder a uma pergunta implicava o agente a folhear vários ficheiros para encontrar o relevante. Agora lê o index.md, escolhe o ficheiro cuja description combina, e abre esse. Vi-o a responder a uma pergunta que só um de quarenta conceitos podia responder — leu o índice, abriu exatamente esse ficheiro, e nunca tocou nos outros trinta e nove. O mecanismo é simples e real: analisar uma description YAML curta é muito mais barato do que ler o corpo inteiro de um ficheiro, portanto filtrar por descrições primeiro significa menos leituras de ficheiro inteiro desperdiçadas. Não é um benchmark; é como a divulgação progressiva funciona.
Deixou de re-derivar contexto. A mudança mais satisfatória é a mais difícil de fotografar. Com uma base de conhecimento estável e navegável, o agente deixa de re-resumir o mesmo fundo em cada sessão porque consegue de facto encontrar a versão sintetizada que escreveu da última vez. A separação /raw vs. wiki reforça isto — o pensamento acabado vive no wiki e é reutilizado, em vez de ser re-extraído das notas em bruto a cada vez.
Finalmente é portátil. O meu second brain é agora uma pasta de markdown padrão que eu podia empurrar para um repositório Git, entregar a outro agente, ou partilhar uma fatia, e continuaria a fazer sentido na configuração de um estranho. Isso não era verdade antes. O formato é a língua partilhada que torna um sistema privado legível para qualquer um — humano ou agente.
Para o argumento mais profundo de "porque é que uma estrutura padronizada bate um Claude.md esperto", decompus os níveis de memória do agente nos meus seis níveis de sistemas de memória do Claude Code — o OKF é essencialmente uma implementação limpa e partilhável dos níveis mais altos.
O resumo honesto: o OKF não tornou o meu agente mais inteligente. Tornou o ambiente do meu agente legível, e um ambiente legível é o que impede um agente capaz de agir como um burro.
Devias Converter o Teu Second Brain para OKF?
Resposta direta: converte se a tua base de conhecimento for grande o suficiente para o agente perder o rasto do que lá está dentro — e salta se tens menos de cinquenta ficheiros e tudo ainda cabe confortavelmente na cabeça do agente.
A conversão tem custo real. Vais gastar horas a escrever descrições discriminantes, a desenhar um vocabulário de tipos, e a rever divisões automatizadas. Esse custo só compensa quando a tua base é grande o bastante para a navegação se ter tornado o estrangulamento. Com trinta ficheiros bem nomeados, um bom Claude.md chega e sobra, e o OKF é exagero. O imposto de duplicação e pesquisa em que bati é um problema de escala.
Converte se algum destes for verdade: o teu agente duplica conhecimento que já tem, a consulta parece lenta e pesada em tokens, queres partilhar ou montar a base em várias ferramentas, ou já estás a manter um wiki vivo à Karpathy e queres que fale um padrão que outras ferramentas consumam. Se estás a construir esse padrão de wiki vivo, o meu passo-a-passo second brain com Obsidian + Claude Code combina naturalmente com OKF — Obsidian para a vista de grafo humana, OKF como o padrão em disco por baixo.
Adia se tens menos de cinquenta ficheiros, se a tua base é puramente pessoal e nunca vai ser partilhada, ou se estás tentado a converter porque o OKF é novo e brilhante em vez de porque bateste numa parede real. Novo não é uma razão. Uma parede é.
Uma coisa que eu não faria: tratar a OKF v0.1 como acabada. A Google chamou-lhe um ponto de partida, e é — não há ainda um protocolo formal de descoberta embutido, nem validação de ligações, nem imposição de qualidade. Construir em cima é inteligente. Apostar a tua operação toda na forma atual, não. Converte a parte que dói, aprende a forma, e deixa a especificação amadurecer antes de mergulhares de cabeça.
Perguntas Frequentes
O que é um OKF second brain?
Um OKF second brain é uma base de conhecimento pessoal estruturada segundo o Open Knowledge Format da Google — um diretório de ficheiros markdown de conceitos com front matter YAML, encabeçado por um mapa index.md, que tanto tu como um agente de IA como o Claude conseguem ler, navegar e atualizar. Substitui pastas ad hoc e um Claude.md longo por uma forma padronizada e portátil.
Como converto uma base de conhecimento Claude existente para OKF?
Converte primeiro uma pasta à mão para aprender o formato, define um vocabulário fixo de type, depois usa uma ferramenta como o plugin okf-skills para Claude Code para acrescentar front matter ao resto. O passo mais difícil — separar notas amalgamadas em conceitos únicos e limpos — continua a precisar de revisão humana. Termina acrescentando ao teu Claude.md um protocolo que diz "índice primeiro". Vê o passo-a-passo da conversão acima para os passos exatos.
O OKF torna o Claude mais rápido a pesquisar as minhas notas?
O OKF reduz leituras de ficheiro desperdiçadas em vez de tornar o próprio modelo mais rápido. Como o agente lê campos description curtos em YAML no índice antes de abrir qualquer ficheiro, filtra para o conceito relevante sem folhear os irrelevantes — o que baixa o uso de tokens na consulta. O ganho escala com o quão grande e desarrumada a tua base era à partida.
Ainda preciso de um ficheiro Claude.md com um OKF second brain?
Sim, mas o seu papel encolhe. Em vez de segurar toda a tua estrutura em prosa, o Claude.md passa a ser um protocolo curto a dizer ao agente para ler o index.md primeiro, navegar por descrições, verificar duplicados antes de criar, e registar alterações. A estrutura vive no bundle; o Claude.md só diz ao agente como o usar.
O OKF é melhor que RAG para um second brain?
Resolvem problemas diferentes. O RAG pesquisa uma pilha estática de chunks embebidos e reconstrói contexto em cada consulta sem acumular conhecimento. Um OKF second brain é um conjunto vivo e curado de conceitos que o agente lê e atualiza ao longo do tempo, portanto compõe-se. Para conhecimento pessoal em evolução que revês, a estrutura manutenível do OKF tende a encaixar melhor do que o RAG vetorial puro.
A Pasta Que Deixou de Esquecer
Comecei toda esta experiência por causa de dois ficheiros de preços contraditórios. Vou terminar por aí também, porque a resolução é o ponto.
Uns dias depois da conversão, pedi ao Claude que atualizasse a minha lógica de preços para um novo escalão de serviço. Leu o índice raiz, foi direto a business/pricing-logic.md, abriu esse único ficheiro, revi-o, e acrescentou uma linha ao log.md. Sem ficheiro novo. Sem v2-FINAL. Sem contradição. Encontrou aquilo que já sabia e alterou-o, à maneira de uma pessoa com memória a sério.
É essa a promessa toda de um OKF second brain, e é mais pequena e mais honesta do que o hype à volta do formato sugere. O OKF não deu inteligência ao meu agente. Deu-lhe um mapa em que ele podia confiar — e um agente capaz com um mapa fiável deixa de se comportar como um amnésico. O formato vai evoluir para lá da v0.1, o ferramental vai melhorar, e o mercado de bundles vendáveis que as pessoas continuam a prever pode ou não chegar. Nada disso muda a jogada que está disponível para ti hoje.
Portanto aqui vai a única coisa que vale a pena fazer antes desta semana acabar: pega na tua pasta de conhecimento mais bagunçada — aquela em que o teu agente continua a tropeçar — e converte só essa para OKF à mão. Escreve o índice. Escreve descrições discriminantes. Acrescenta o protocolo de quatro linhas ao Claude.md. Depois faz ao teu agente uma pergunta que só um ficheiro pode responder, e vê o que ele faz. Se ler o mapa e abrir exatamente o ficheiro certo, vais perceber em trinta segundos aquilo que me levou um fim de semana a sentir.
Queres Isto Feito Por Ti
Desenhar o vocabulário de tipos, separar notas amalgamadas de forma limpa, e afinar o protocolo do Claude.md é a parte fininha — e é exatamente o pipeline que construo para pessoas cujo second brain ultrapassou um índice escrito à mão. Se queres o teu convertido num bundle OKF limpo e portátil sem a tentativa-erro, é esse o trabalho que aceito lá no Fiverr.