OKF Second Brain : j'ai converti mon setup Claude et il a enfin cessé d'oublier
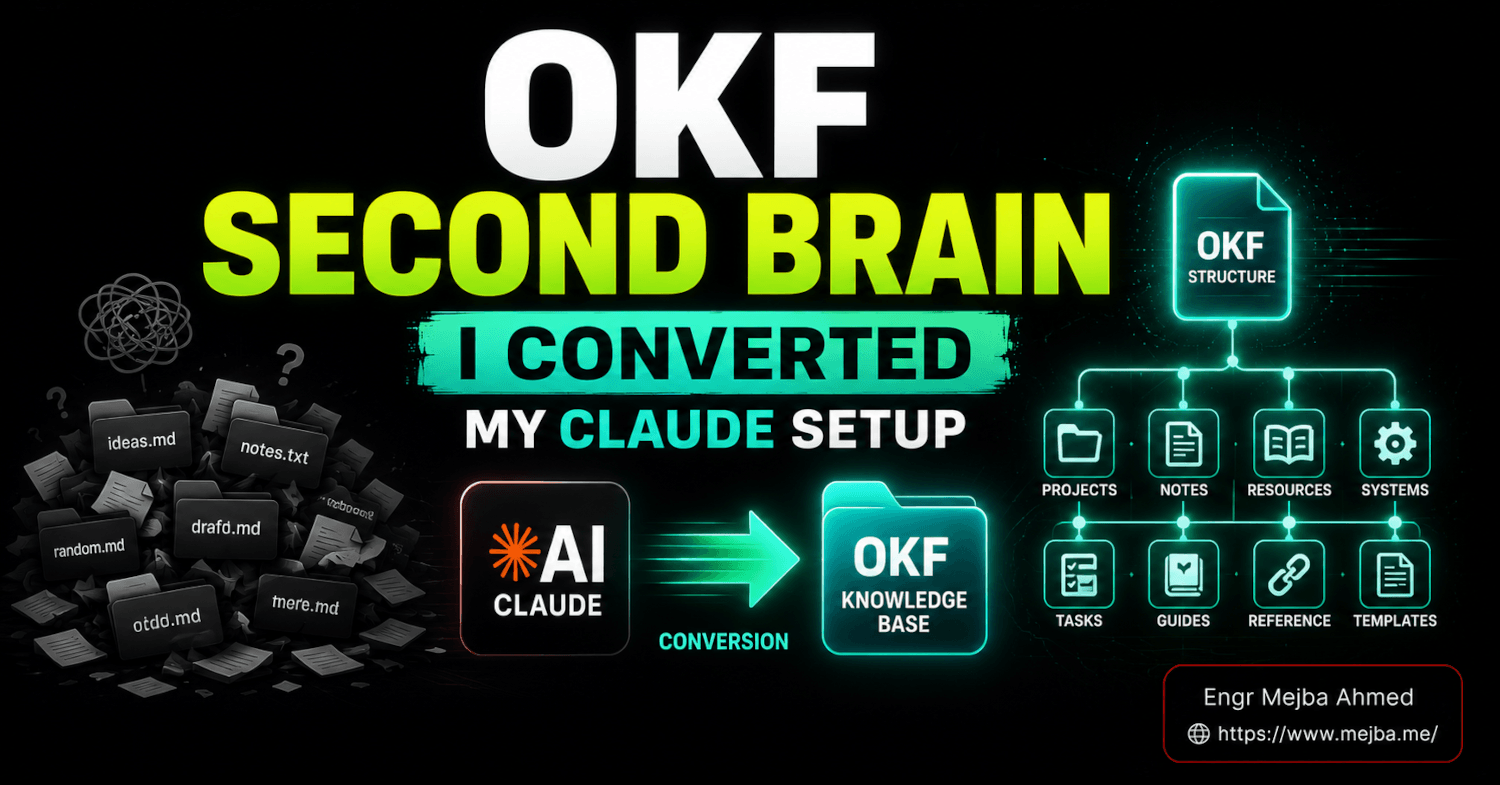
Un OKF second brain est une base de connaissances personnelle restructurée selon l'Open Knowledge Format de Google — un dossier de fichiers markdown de concepts avec front matter YAML, précédé d'une carte index.md que vous, comme un agent IA tel que Claude, pouvez lire, parcourir et mettre à jour. J'ai converti la mienne pendant un week-end de juin 2026, et cela a réglé le seul problème qu'une année de discipline sur les dossiers n'avait jamais résolu.
Le moment où j'ai abandonné mon ancien setup, c'est en voyant Claude créer un fichier nommé pricing-v2-FINAL.md à plusieurs niveaux dans l'arborescence — juste à côté du pricing.md qu'il avait écrit quelques semaines plus tôt et dont il avait apparemment oublié l'existence. Deux fichiers. Même savoir. Se contredisant l'un l'autre. Tous deux fièrement « corrects ».
C'est la pourriture qui s'installe dans toute base de connaissances personnelle construite comme la mienne : un fouillis de notes markdown maintenu par un fichier Claude.md héroïque qui joue à la fois le rôle d'index, de bibliothécaire et de mémoire. Ça fonctionne magnifiquement à trente fichiers. Ça s'effondre discrètement à trois cents. Mon agent n'était pas idiot — il n'avait simplement aucun moyen fiable de savoir ce qui existait déjà avant d'écrire quelque chose de nouveau. Alors il redérivait, résumait à nouveau et dupliquait, session après session.
C'est exactement le problème que l'Open Knowledge Format de Google a été conçu pour tuer, et reconstruire mon setup autour de lui était le seul moyen de découvrir si le format règle vraiment le désordre ou s'il se contente de le renommer. Je vais vous emmener à travers la vraie conversion — la chirurgie des dossiers, la skill de conversion sur laquelle je me suis appuyé, la seule ligne que j'ai ajoutée à Claude.md qui a tout changé, ce qui a cassé, et l'avant/après honnête. Si vous avez une base de connaissances markdown que Claude traite comme un tiroir fourre-tout, voici le chemin de sortie.
Je pars du principe que vous savez à peu près ce qu'est l'OKF. Si ce n'est pas le cas, lisez d'abord mon premier regard de builder sur l'Open Knowledge Format — il couvre la spec depuis zéro. Ce billet-ci est la partie qui vient après : j'ai déjà un second brain. Et maintenant ?
Pourquoi mon Claude second brain a heurté un mur
Je vais vous décrire le setup, parce que le vôtre lui ressemble sans doute.
Je faisais tourner une base de connaissances personnelle depuis environ un an — du genre que j'ai documenté dans mon build de second brain Claude Code. Fichiers markdown, dossiers imbriqués par projet et par sujet, et un gros Claude.md à la racine qui indiquait à Claude où les choses vivaient et comment se comporter. Playbooks client. Logique de tarification. Snippets de code. Notes de réunion. Heuristiques durement acquises que je ne voulais plus jamais réapprendre.
Le système avait quatre modes de défaillance, et ils empiraient à mesure qu'il grandissait.
Claude ne pouvait pas dire si quelque chose existait déjà. Sans carte lisible par une machine, la seule façon pour l'agent de vérifier « ai-je déjà une note sur la politique de remboursement ? » était de grep les noms de fichiers et de survoler les dossiers. C'est lent, gourmand en tokens et peu fiable. Alors, souvent, il ne vérifiait pas — et écrivait un doublon. Ce moment pricing-v2-FINAL.md n'était pas un incident isolé.
La recherche était une taxe. Chaque récupération signifiait que l'agent explorait des dossiers imbriqués, ouvrait des fichiers pour voir s'ils étaient pertinents et brûlait du contexte sur des impasses. Plus l'arborescence était profonde, plus la taxe était lourde.
Rien n'était portable. Mon second brain était sur mesure pour mon workflow et mon Claude.md. Je ne pouvais pas le passer à un coéquipier, le monter dans un autre agent, ou en partager une tranche sans que l'ensemble perde son sens. C'était un dialecte privé, pas une langue.
Le Claude.md était porteur d'une manière dangereuse. Toute la structure vivait dans la prose d'un seul fichier. Si ce fichier dérivait par rapport aux vrais dossiers — et c'était toujours le cas —, l'agent naviguait sur une carte périmée.
Aucun de ces problèmes n'est exotique. Ce sont ceux que toute second brain non standardisée rencontre au-delà d'une certaine taille. La structure qui semblait libératrice au départ devient ce qui l'étrangle. J'avais essayé de régler cela avec plus de discipline sur les dossiers et un Claude.md plus long. C'est traiter un problème structurel par la volonté. Ça ne tient pas.
Ce dont j'avais vraiment besoin, c'était d'une forme standard — une sur laquelle l'agent pouvait s'appuyer sans que je lui tienne la main pour chaque navigation. C'est le pari de l'OKF. Il était temps de le tester.
À quoi ressemble vraiment un OKF second brain
Voici la reformulation qui a fait déclic pour moi : l'OKF ne vous demande pas d'ajouter de l'outillage. Il vous demande de vous entendre sur une forme. Et cette forme est presque insultante de simplicité — des fichiers markdown de concepts avec front matter YAML, regroupés en un bundle, précédés d'un index.md qui sert de carte.
Mon ancien second brain était organisé par projet. Mon OKF second brain est organisé par concept, avec une séparation nette que le gist LLM Wiki de Karpathy m'a martelée : gardez la matière source brute séparée du savoir synthétisé. Les transcriptions brutes, les pages scrapées et les notes vidées vivent dans /raw. Les concepts propres et lisibles par l'agent vivent dans le wiki lui-même. L'agent lit /raw, extrait des concepts et écrit des pages structurées — il ne vous sert jamais directement le tas brut.
La nouvelle structure ressemble à ceci :
second-brain/
├── index.md              # the map: every concept, one line each
├── log.md                # append-only history of changes
├── raw/                  # source material, untouched
│   ├── call-2026-06-18.md
│   └── scraped-pricing-research.md
├── clients/
│   ├── index.md          # sub-map for this folder
│   ├── onboarding-sequence.md
│   └── escalation-playbook.md
└── business/
    ├── index.md
    ├── pricing-logic.md
    └── positioning.md
Chaque fichier de concept porte un front matter que l'agent lit avant d'ouvrir le corps :
---
type: playbook
title: Client Onboarding Sequence
description: The exact steps I run when a new AI automation client signs.
tags: [onboarding, process, clients]
timestamp: 2026-06-18
---

# Client Onboarding Sequence

When a new client signs, I run these steps in order. Each step has a
trigger and a definition of done...
Le champ type est le seul strictement requis par OKF v0.1. Tout le reste — title, description, tags, timestamp — est recommandé. Mais la description est le héros silencieux ici, et je vous montrerai pourquoi dans la section résultats. C'est ce qui permet à un agent de décider s'il faut ouvrir un fichier sans l'ouvrir.
L'index.md est là où un dossier plat devient un graphe navigable :
---
type: index
title: Second Brain — Root Index
---

# Second Brain Index

## clients/
- **onboarding-sequence** — steps run when a new client signs
- **escalation-playbook** — how to handle an unhappy client mid-project

## business/
- **pricing-logic** — how I price AI automation engagements
- **positioning** — who I serve and who I turn away
Cette description d'une ligne par concept est toute l'astuce. L'agent lit l'index, voit trente descriptions et décide quels deux fichiers il lui faut vraiment — puis n'ouvre que ceux-là. C'est de la divulgation progressive, le même principe qui rend les Claude skills bien construites efficaces. L'index est le projecteur. Les concepts sont ce sur quoi il pointe.
C'est la différence structurelle entre un OKF second brain et le tas que j'avais avant : la carte est un fichier, pas de la prose enterrée dans Claude.md, et elle vit à côté de la chose qu'elle décrit. Quand j'ajoute un concept, je mets à jour son index local. La carte et le territoire restent synchronisés parce qu'ils sont voisins.
Voilà la cible. Passons maintenant à la migration.
Comment j'ai converti mon second brain en OKF
J'ai volontairement fait deux passes, parce que je voulais sentir le format à la main avant de laisser un outil y toucher. C'est la même leçon que je réapprends sans cesse : lire une spec ne vous apprend presque rien comparé à convertir un dossier mal.
Passe une : la colonne vertébrale, à la main. J'ai choisi mon dossier le plus foutraque — le travail client — et je l'ai reconstruit manuellement. J'ai créé l'index.md, puis parcouru fichier par fichier en décidant du type et en écrivant une description d'une ligne pour chacun. C'était lent, et la lenteur était le but. Décider si mon doc de tarification était un pricing, une policy ou une reference m'a forcé à comprendre réellement ce que chaque note était. La moitié de mes fichiers « en double » se sont révélés être le même concept écrit deux fois sous des angles différents. La conversion a fait remonter les doublons qui m'étaient invisibles.
Mon plus gros enseignement de la passe une : écrivez votre vocabulaire de type comme un fichier de concept à part entière avant de convertir quoi que ce soit. OKF ne dicte volontairement pas vos types, et cette liberté se transforme vite en fatigue décisionnelle et en incohérence. J'ai créé business/type-vocabulary.md listant les huit types que je m'autoriserais — playbook, runbook, reference, pricing, case-study, glossary, decision, index — et j'ai refusé d'en inventer un neuvième à la volée. Des types cohérents font la différence entre un bundle qu'un agent parcourt bien et un dans lequel il trébuche.
Passe deux : automatisation pour le gros. Convertir trois cents fichiers à la main n'a jamais été le plan. Pour le reste, je me suis appuyé sur le plugin Claude Code okf-skills — un ensemble open source de skills qui apprend à Claude Code à créer, maintenir et valider des bundles OKF, piloté par la spec en toutes lettres et adossé à un vérificateur de conformité. Cette dernière partie compte davantage qu'il n'y paraît : cela signifie que la sortie de l'agent est vérifiée contre la spec au lieu d'être crue aveuglément. J'ai aussi jeté un œil à l'OKF Bundle Generator de Suganthan Mohanadasan pour le chemin URL-vers-bundle, mais pour un dossier markdown local la voie de la skill Claude Code convenait mieux.
Voilà la partie honnête : l'automatisation a réussi les 80 % faciles et raté les 20 % précieux. Convertir une page en markdown avec front matter est un problème résolu — la skill a ajouté proprement les champs type et description à mes notes existantes et signalé les violations de la spec. Ce qu'elle ne pouvait pas faire de manière fiable, c'est l'acte difficile : lire une note de 2 000 mots qui contenait en secret trois concepts distincts et la fractionner en trois fichiers. Cette décomposition — défaire une note enchevêtrée en ses idées séparées — reste largement de votre ressort. Un LLM peut s'y essayer, mais dirigé naïvement vers « découpe ça en concepts » il produit des fichiers qui se chevauchent et se contredisent. J'ai revu chaque découpe à la main.
La seule ligne qui a tout changé. Rien de la structure ne compte si l'agent ne l'utilise pas. Le déclic a été une instruction petite et explicite en tête du Claude.md :
## Knowledge Base Protocol

This is an OKF bundle. Before answering any question or creating any file:

1. Read `index.md` at the relevant level FIRST.
2. Use file `description` fields to decide what to open — do NOT open
   files to check relevance.
3. Before creating a concept, check the index for an existing one.
   Update it instead of duplicating.
4. After any change, append a line to `log.md`.
C'est tout. Quatre règles. Le format donne à l'agent une carte fiable ; ceci lui dit d'aller vraiment lire la carte d'abord. Sans ces instructions, Claude traitait le bundle OKF comme n'importe quel autre dossier et repartait dans le grep. Avec elles, son comportement a changé visiblement — et c'est toute l'histoire des résultats.
Si vous préférez que cette conversion soit faite pour vous — le vocabulaire de types conçu, la décomposition réalisée correctement, le protocole Claude.md ajusté —, c'est exactement le genre de pipeline que je construis. Vous pouvez voir ce travail sur fiverr.com/s/EgxYmWD. Mais sincèrement : convertissez un dossier à la main d'abord. Ça vous prendra un après-midi et vous apprendra ce qu'aucun outil ne vous apprendra.
Ce qui a cassé pendant la conversion
Un journal de build sans les échecs est du marketing, pas de la pédagogie. Trois choses m'ont mordu.
Les champs description étaient paresseux, et l'agent a hérité de ma paresse. Ma première fournée de descriptions ressemblait à « notes sur la tarification » — inutile. Quand toute la stratégie de navigation dépend du fait que l'agent lise les descriptions plutôt que les fichiers, une description vague casse le système en silence. L'agent ne peut pas distinguer pricing-logic de pricing-history si les deux disent « notes sur la tarification », alors il ouvre les deux, et vous revoilà à la taxe de tokens que vous cherchiez à éviter. J'ai dû réécrire chaque description pour qu'elle soit discriminante — ce qui rend ce fichier différent de ses voisins — et pas juste descriptive. Cette réécriture a pris plus de temps que la conversion structurelle.
Des liens périmés partout. Quand vous fractionnez et renommez des fichiers, les références internes pourrissent. Mes anciennes notes se référençaient entre elles par nom de fichier, et la moitié de ces noms avait changé. OKF tolère les liens brisés par conception — la spec traite les liens comme des arêtes non typées et hausse les épaules devant les liens morts —, ce qui est indulgent mais signifie aussi que rien ne vous prévient. J'ai dû chercher manuellement les références orphelines. Un vérificateur de liens est sur ma liste « un jour ».
J'ai sur-atomisé au départ. Grisé par la règle « un concept par fichier », j'ai éclaté un playbook d'onboarding cohérent en onze micro-fichiers : un par étape. Ce n'est pas du minimalisme, ce sont des confettis. L'agent devait maintenant réassembler un processus unique à partir de onze fragments, ce qui est pire qu'un seul fichier bien structuré. Le minimalisme dans OKF signifie une idée cohérente par fichier, pas une phrase par fichier. Je les ai recombinés en un seul onboarding-sequence.md avec des sections à titres. La ligne entre « atomique » et « déchiqueté » est affaire de jugement, et je l'ai eue fausse avant de l'avoir juste.
Aucun de ces problèmes n'est rédhibitoire. Ce sont les frictions normales lorsqu'on impose une structure à une année de désordre organique. Mais si vous entrez en pensant qu'un outil les gérera, vous livrerez un bundle qui paraît conforme et navigue mal. La spec valide la forme, pas la qualité. La qualité reste votre boulot.
Cela couvert, voici ce que j'ai réellement récolté pour le week-end.
Les résultats de l'OKF second brain : ce qui a vraiment changé
Je veux être prudent ici, parce que c'est exactement là que le contenu sur les bases de connaissances devient malhonnête avec des benchmarks inventés. Je n'ai pas fait d'étude contrôlée du nombre de tokens avec des barres d'erreur propres, donc je ne vais pas vous servir un faux chiffre « 73 % de tokens en moins ». Ce que je peux vous donner, c'est ce qui a changé dans le comportement observable de l'agent, et le mécanisme qui l'explique.
La duplication a cessé. C'était toute la raison pour laquelle j'ai commencé. Parce que la règle 3 du protocole force une vérification de l'index avant création, et parce que l'index est une vraie carte que l'agent peut scanner à moindre coût, Claude trouve désormais le concept existant et le met à jour au lieu d'écrire truc-v2-FINAL.md. Dans les semaines qui ont suivi la conversion, je n'ai pas surpris un seul concept dupliqué. À lui seul, cela justifiait le week-end.
L'agent ouvre moins de fichiers pour répondre. Avant, répondre à une question signifiait que l'agent survolait plusieurs fichiers pour trouver le pertinent. Maintenant, il lit index.md, choisit le fichier dont la description correspond, et ouvre celui-là. Je l'ai regardé répondre à une question à laquelle un seul de quarante concepts pouvait répondre — il a lu l'index, ouvert exactement ce fichier, et n'a jamais touché les trente-neuf autres. Le mécanisme est simple et réel : parser une courte description YAML coûte bien moins cher que de lire le corps entier d'un fichier, donc filtrer d'abord sur les descriptions signifie moins de lectures complètes gaspillées. Ce n'est pas un benchmark ; c'est simplement comment fonctionne la divulgation progressive.
Il a cessé de redériver le contexte. Le changement le plus satisfaisant est aussi le plus difficile à capturer en capture d'écran. Avec une base de connaissances stable et navigable, l'agent cesse de résumer à nouveau le même arrière-plan à chaque session parce qu'il peut retrouver de manière fiable la version synthétisée qu'il a écrite la fois d'avant. La séparation /raw vs wiki renforce cela — la pensée finie vit dans le wiki et est réutilisée, au lieu d'être ré-extraite des notes brutes à chaque fois.
C'est enfin portable. Mon second brain est désormais un dossier de markdown standard que je pourrais pousser sur un dépôt Git, passer à un autre agent, ou dont je pourrais partager une tranche, et qui aurait encore du sens pour le setup d'un inconnu. Ce n'était pas vrai avant. Le format est le langage commun qui rend un système privé lisible par n'importe qui — humain ou agent.
Pour l'argument plus profond « pourquoi une structure standardisée bat un Claude.md malin », j'ai décomposé les niveaux de mémoire d'agent dans mes six niveaux de systèmes de mémoire Claude Code — OKF est essentiellement une implémentation propre et partageable des niveaux supérieurs.
Le résumé honnête : OKF n'a pas rendu mon agent plus intelligent. Il a rendu l'environnement de mon agent lisible, et un environnement lisible est ce qui empêche un agent capable d'agir bêtement.
Devriez-vous convertir votre second brain en OKF ?
Réponse directe : convertissez si votre base de connaissances est assez grosse pour que l'agent perde le fil de ce qui s'y trouve — et laissez tomber si vous êtes sous la barre de cinquante fichiers et que tout tient encore confortablement dans la tête de l'agent.
La conversion a un vrai coût. Vous passerez des heures à écrire des descriptions discriminantes, à concevoir un vocabulaire de types et à revoir les découpes automatisées. Ce coût ne se rentabilise que lorsque votre base est assez grande pour que la navigation soit devenue le goulot d'étranglement. À trente fichiers bien nommés, un bon Claude.md est réellement suffisant et l'OKF est overkill. La taxe duplication-et-recherche que j'ai heurtée est un problème d'échelle.
Convertissez si l'un des éléments suivants est vrai : votre agent duplique du savoir qu'il possède déjà, la récupération semble lente et gourmande en tokens, vous voulez partager ou monter la base sur plusieurs outils, ou vous faites déjà tourner un wiki vivant à la Karpathy et voulez qu'il parle un standard que d'autres outils peuvent consommer. Si vous construisez ce pattern de wiki vivant, ma présentation du second brain Obsidian + Claude Code se marie naturellement avec OKF — Obsidian pour la vue graphe humaine, OKF comme standard sur disque en dessous.
Attendez si vous êtes sous cinquante fichiers, si votre base est purement personnelle et ne sera jamais partagée, ou si vous êtes tenté de convertir parce qu'OKF est neuf et brillant plutôt que parce que vous avez heurté un vrai mur. Le neuf n'est pas une raison. Un mur, si.
Une chose que je ne ferais pas : traiter OKF v0.1 comme fini. Google l'a qualifié de point de départ, et c'en est un — il n'y a pas encore de protocole de découverte formel intégré, pas de validation de liens, pas d'application de la qualité. Construire dessus est intelligent. Parier toute votre opération sur sa forme actuelle ne l'est pas. Convertissez la partie qui fait mal, apprenez la forme et laissez la spec mûrir avant de tout miser dessus.
Foire aux questions
Qu'est-ce qu'un OKF second brain ?
Un OKF second brain est une base de connaissances personnelle structurée selon l'Open Knowledge Format de Google — un répertoire de fichiers markdown de concepts avec front matter YAML, précédé d'une carte index.md, que vous, comme un agent IA tel que Claude, pouvez lire, parcourir et mettre à jour. Il remplace des dossiers ad hoc et un long Claude.md par une forme standardisée et portable.
Comment convertir une base de connaissances Claude existante en OKF ?
Convertissez un dossier à la main d'abord pour apprendre le format, définissez un vocabulaire de type fixe, puis utilisez un outil comme le plugin Claude Code okf-skills pour ajouter le front matter au reste. L'étape la plus difficile — fractionner des notes enchevêtrées en concepts uniques propres — nécessite encore une revue humaine. Terminez en ajoutant un protocole « index d'abord » à votre Claude.md. Voir la marche à suivre de conversion ci-dessus pour les étapes exactes.
OKF rend-il Claude plus rapide pour rechercher dans mes notes ?
OKF réduit les lectures de fichiers gaspillées plutôt que de rendre le modèle lui-même plus rapide. Parce que l'agent lit les courts champs description YAML dans l'index avant d'ouvrir un fichier, il filtre pour ne garder que le concept pertinent sans survoler les autres — ce qui abaisse la consommation de tokens à la récupération. Le gain croît avec la taille et le désordre de votre base au départ.
Ai-je encore besoin d'un fichier Claude.md avec un OKF second brain ?
Oui, mais son rôle rétrécit. Au lieu de contenir toute votre structure en prose, Claude.md devient un court protocole qui dit à l'agent de lire d'abord index.md, de naviguer par descriptions, de vérifier les doublons avant de créer, et de journaliser les changements. La structure vit dans le bundle ; Claude.md dit juste à l'agent comment l'utiliser.
OKF est-il meilleur que RAG pour un second brain ?
Ils résolvent des problèmes différents. Le RAG cherche dans un tas statique de chunks embedded et reconstruit le contexte à chaque requête sans accumuler de savoir. Un OKF second brain est un ensemble curé et vivant de concepts que l'agent lit et met à jour dans le temps, donc qui capitalise. Pour du savoir personnel évolutif que vous révisez, la structure maintenable d'OKF colle en général mieux que le RAG vectoriel pur.
Le dossier qui a cessé d'oublier
J'ai lancé toute cette expérience à cause de deux fichiers de tarification qui se contredisaient. Je vais la terminer là aussi, parce que la résolution est le vrai propos.
Quelques jours après la conversion, j'ai demandé à Claude de mettre à jour ma logique de tarification pour un nouveau palier de service. Il a lu l'index racine, est allé directement à business/pricing-logic.md, a ouvert ce seul fichier, l'a révisé et a ajouté une ligne à log.md. Pas de nouveau fichier. Pas de v2-FINAL. Pas de contradiction. Il a trouvé la chose qu'il savait déjà et l'a modifiée, comme une personne dotée d'une vraie mémoire l'aurait fait.
C'est toute la promesse d'un OKF second brain, et elle est plus petite et plus honnête que ne le suggère la hype autour du format. OKF n'a pas donné d'intelligence à mon agent. Il lui a donné une carte à laquelle il pouvait se fier — et un agent capable doté d'une carte digne de confiance cesse de se comporter comme un amnésique. Le format évoluera au-delà de la v0.1, l'outillage s'améliorera, et la marketplace de bundles à vendre que les gens n'arrêtent pas de prédire arrivera ou pas. Rien de tout cela ne change le mouvement qui vous est accessible aujourd'hui.
Alors voici la seule chose à faire avant la fin de la semaine : prenez votre dossier de connaissances le plus foutraque — celui que votre agent n'arrête pas de patauger — et convertissez juste celui-là en OKF à la main. Écrivez l'index. Rédigez des descriptions discriminantes. Ajoutez le protocole en quatre lignes à Claude.md. Puis posez à votre agent une question à laquelle un seul fichier peut répondre, et regardez ce qu'il fait. S'il lit la carte et ouvre exactement le bon fichier, vous comprendrez en trente secondes ce qu'il m'a fallu un week-end pour ressentir.
Vous voulez que ce soit fait pour vous
Concevoir le vocabulaire de types, fractionner proprement des notes enchevêtrées et ajuster le protocole Claude.md est la partie pointilleuse — et c'est exactement le pipeline que je construis pour ceux dont le second brain a débordé d'un index écrit à la main. Si vous voulez le vôtre converti en un bundle OKF propre et portable sans le tâtonnement, c'est le travail que je prends en charge sur Fiverr.