Eu quase escrevi mais uma comparação de modelos. Estava com a aba aberta — Opus 4.8 à esquerda, GPT-5.5 à direita, o gráfico de benchmark já capturado em print, o título "qual deles vence" digitado pela metade. Então me peguei fazendo exatamente aquilo que vivo dizendo para as pessoas pararem de fazer.
Eu estava tratando o modelo como se fosse o produto.
Ele não é. Não mais. A pergunta real em 2026 deixou de ser qual modelo vence e passou a ser se você é agent native — se você reorganizou sua forma de trabalhar em torno de agentes, ou se ainda está cutucando uma caixa de chat torcendo para que o próximo point release te salve. Em algum momento das últimas seis semanas — entre o lançamento do Claude Opus 4.8 em 28 de maio e a OpenAI ativando discretamente o controle do computador no Windows para o Codex no dia seguinte — o centro de gravidade se deslocou. O modelo mais inteligente deixou de ser o que mais importa. A camada de aplicação acabou de ficar mais importante do que a camada de modelo, e a maioria dos desenvolvedores ainda não percebeu.
É dessa virada que quero falar. Não de "qual modelo é o melhor" — vou te dar minha leitura honesta sobre o Opus 4.8 versus o GPT-5.5, porque os números são genuinamente interessantes e um deles provavelmente vai te surpreender. Mas a briga de modelos é a história menor. A história maior é que o lugar onde você realmente vive e trabalha — a plataforma — agora é o que importa. Ao final deste texto você terá uma resposta clara para uma pergunta que nem sabia que deveria estar fazendo: estou produzindo com esses agentes, ou estou sendo consumido por eles?
Vou começar pelo modelo que não deveria tirar o sono de ninguém.
O lançamento do Opus 4.8 que pareceu uma atualização de iPhone
Uma confissão que vai me criar problemas com a turma da Anthropic: rodei o Claude Opus 4.8 lado a lado com o Opus 4.7 e mal consegui distinguir um do outro.
Não no mau sentido. No sentido de produto maduro. Sabe quando um novo iPhone é lançado, a câmera é tecnicamente melhor, o chip é tecnicamente mais rápido e, depois de uma semana, você genuinamente não lembra qual dos dois está segurando? Esse é o Opus 4.8. A Anthropic o lançou em 28 de maio de 2026 como um point release em cima do 4.7, e manteve a mesma janela de contexto de 1M tokens e a mesma tabela de preços de US$ 5/US$ 25 por milhão de tokens. O recurso de destaque, no enquadramento da própria Anthropic, é a honestidade — o modelo é bem menos propenso do que o 4.7 a deixar passar sem comentário uma falha no próprio código, segundo o system card.
Essa honestidade é real, e eu adoro. Já vi o Opus 4.8 parar no meio de uma tarefa e me dizer "não tenho confiança de que isto trata o caso de concorrência, você deveria revisar" em vez de declarar vitória e sair de campo. Se você leu minha análise aprofundada sobre os níveis de esforço do Opus 4.8, já sabe que essa é a coisa mais subestimada deste lançamento.
Mas no dia a dia? A diferença em relação ao 4.7 é pequena. O veredito honesto é: trata-se de um refinamento incremental de um modelo que já era excelente, não de um salto. E tudo bem. É assim que uma linha de produtos saudável se parece. A era em que cada lançamento de modelo reorganizava todo o seu fluxo de trabalho está acabando. Estamos entrando na fase do bom-e-sem-graça, em que o modelo é um utilitário confiável e o trabalho interessante acontece em outro lugar.
O que me leva ao benchmark sobre o qual todo mundo está discutindo — e ao único lugar onde o Opus 4.8 de fato perde.
Onde o Opus 4.8 vence, e o único benchmark em que perde para o GPT-5.5
Vou te passar os números reais, porque o vídeo que motivou todo este post acertou neles, e a nuance importa.
No SWE-Bench Pro — o benchmark que mede a resolução de issues reais do GitHub em uma codebase completa — o Opus 4.8 marca 69,2%, contra 64,3% do 4.7. O GPT-5.5 fica em 58,6%. Isso não é erro de arredondamento. No tipo de trabalho com vários arquivos, do tipo "vá corrigir este bug no nosso repo de verdade", que paga as minhas contas, o Opus está claramente à frente.
Aí você chega ao Terminal-Bench 2.1 — programação agêntica no terminal, o mundo das longas cadeias de comandos de shell, orquestração de CI, scripts de infraestrutura — e o quadro se inverte, pelo menos segundo uma comparação de terceiros. O GPT-5.5 marca 78,2% contra 74,6% do Opus 4.8. É uma derrota genuína para a Anthropic, e não vou fingir o contrário. Quando a tarefa inteira vive no terminal, o Codex com GPT-5.5 é só um pouco mais seguro.
Mas aqui está a parte que me surpreendeu — a parte que as fichas técnicas não capturam. Eficiência de custo. No preço de tabela os dois estão próximos: o GPT-5.5 custa US$ 5 de entrada / US$ 30 de saída por milhão de tokens contra US$ 5 / US$ 25 do Opus, então, por token, o Opus é na verdade um pouquinho mais barato na saída. A história real é o comportamento. A Artificial Analysis descobriu que o Opus 4.8 é verboso — ele roda cerca de 30% mais turnos e aproximadamente 3x os tokens de saída por tarefa em comparação com o GPT-5.5 para concluir trabalho agêntico. Mais turnos e mais tokens significam mais tempo de relógio e mais gasto, e em um loop autônomo longo esse multiplicador de 3x se acumula rápido — o suficiente para engolir a pequena vantagem por token do Opus. Então, em um fluxo agêntico profundo, de várias horas, o GPT-5.5 com frequência termina mais barato e mais rápido, e muita gente em quem confio relata ter mais confiança em entregar a ele o trabalho de terminal realmente crítico.
Então, quem vence?
Pergunta errada. Veja como eu realmente faço o roteamento, e esta é a coisa mais útil de toda esta seção:
- Trabalho em codebases complexas, code review, qualquer coisa em que eu queira que o modelo pegue os próprios erros → Opus 4.8. A diferença no SWE-Bench Pro e o upgrade de honestidade justificam.
- Trabalho pesado de terminal, infra, CI, loops autônomos longos em que o custo de tokens se acumula → GPT-5.5 no Codex. A eficiência de tokens e a vantagem no terminal são reais.
- Tarefas simples de alto volume → um modelo mais barato, totalmente. Queimar um modelo de fronteira em formatação de strings é como você recebe uma fatura surpresa.
Só essa disciplina de roteamento tende a reduzir de forma significativa o gasto com modelos, em comparação com enfiar um único modelo de fronteira em todo trabalho. Se você quiser a comparação completa lado a lado, detalhei o GPT-5.5 versus o Opus 4.7 aqui, e o 4.8 não muda o formato daquela conclusão — ele a deixa mais nítida.
Mas repare no que acabou de acontecer. Passei três parágrafos dizendo para você usar modelos de duas empresas diferentes para trabalhos diferentes. O modelo não é uma torcida da qual você faz parte. É uma ferramenta para a qual você roteia. E o que faz o roteamento — o lugar onde você realmente vive e trabalha — essa é a camada que acabou de ficar interessante.
A história real é o Codex virando um sistema operacional
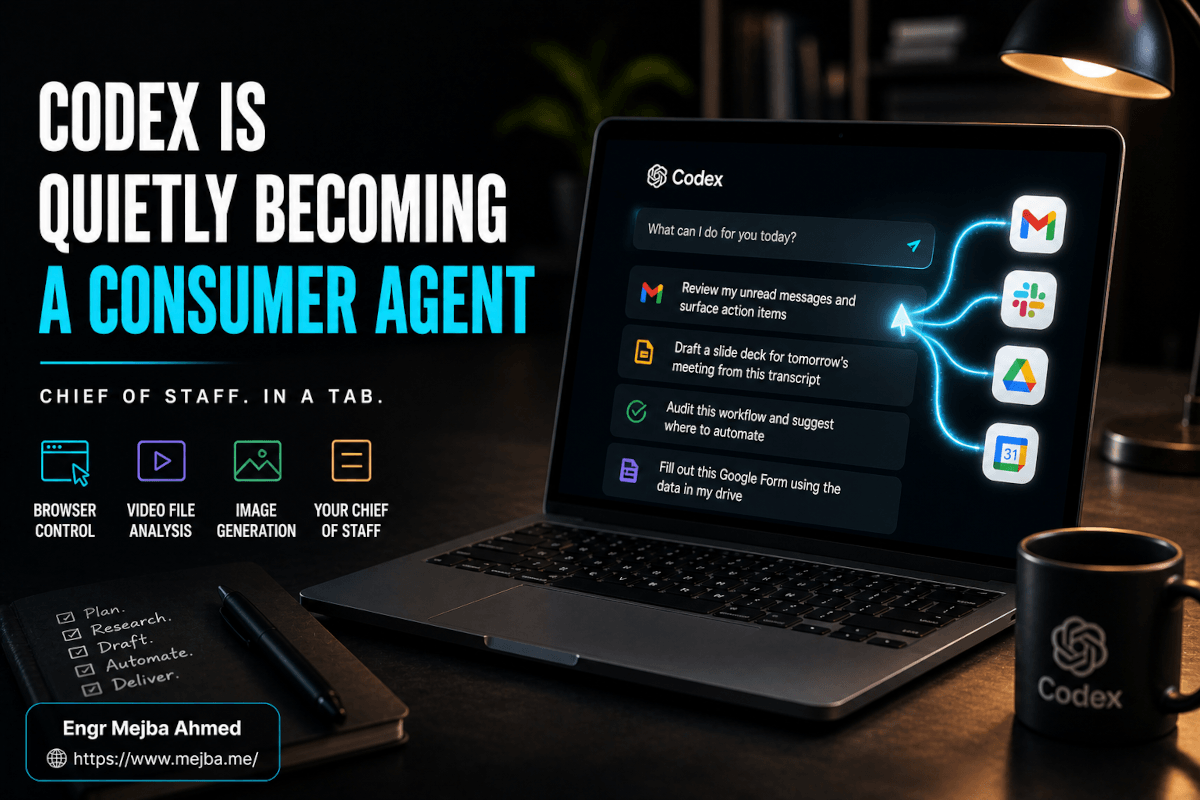
Enquanto todo mundo tirava print do gráfico de benchmark do Opus 4.8, a OpenAI transformava discretamente o Codex em algo que parece muito menos uma ferramenta de programação e muito mais um sistema operacional para agentes. Foi para aí que minha atenção realmente foi este mês, e acho que é para aí que a sua deveria ir também.
Veja o que foi lançado:
Uso do computador no Windows. Em 29 de maio de 2026, a OpenAI ativou o controle total do computador para o Codex no Windows — o agente consegue ver, clicar e digitar dentro de aplicativos do Windows, não só em um navegador em sandbox. O agente saiu da IDE e passou a circular pela máquina inteira.
Controle remoto pelo celular. O Codex mostra um QR code, você o escaneia com o app mobile do ChatGPT e agora está pilotando uma sessão do Codex no seu desktop pelo celular — Windows ou Mac. O desktop virou um trabalhador que supervisiono à distância, em vez de uma cadeira à qual estou acorrentado.
Abas de navegador persistentes e logadas. O navegador interno do Codex agora mantém o estado de login em várias abas, como uma sessão real do Chrome. Isso parece banal. Não é. É a diferença entre um agente que só consegue tocar em páginas públicas e um que consegue operar dentro das suas ferramentas autenticadas de verdade.
Orquestração de threads multiagente. Você pode disparar um prompt mestre que cria várias threads de subagentes, cada uma mastigando uma parte de uma tarefa maior, coordenadas entre projetos e git worktrees. É trabalho em equipe de agentes como recurso de primeira classe, não uma gambiarra. Se orquestração multiagente é novidade para você, minha explicação dos dynamic workflows do Claude Code percorre o mesmo padrão de fan-out e merge pelo lado do Claude — os conceitos se transferem diretamente.
Busca dentro do chat em todas as conversas, além de uma página de atividade no estilo do GitHub que acompanha sequências diárias, duração das tarefas e uso de tokens. Eles estão gamificando o seu uso de agentes do mesmo jeito que o GitHub gamificou os commits. Isso diz muito sobre para onde as coisas estão indo.
Junte tudo e o enquadramento muda completamente. O Codex não é mais "uma IA que escreve código". É uma superfície de controle multidispositivo e multiagente que alcança seus arquivos, suas sessões de navegador e agora o seu desktop inteiro. Coloquei o Codex frente a frente com o Claude Code neste teste prático — mas cada atualização o afasta mais de "app" e o aproxima de "ambiente onde você vive". O modelo lá dentro é quase incidental. A plataforma é o produto.
E, quando você enxerga o Codex como uma plataforma em vez de uma ferramenta, uma previsão que soava como ficção científica seis meses atrás começa a parecer óbvia.
Vibe coding está virando um recurso, não um produto
Lembra quando "vibe coding" significava se cadastrar em uma plataforma dedicada? Você ia ao Replit, ao Lovable ou ao Bolt, descrevia seu app, e ele fazia o scaffold, hospedava, configurava a autenticação e provisionava um banco de dados. Essas plataformas vão bem no papel — o Lovable teria chegado a 8 milhões de usuários e US$ 200 milhões de ARR, e o Bolt alcançou US$ 40 milhões de ARR em cerca de cinco meses. A categoria é real e está crescendo.
Mas observe para onde a gravidade está puxando.
Por que abrir uma plataforma de vibe coding separada quando o agente que já roda no seu terminal consegue gerar o app, pré-visualizá-lo, hospedá-lo e configurar autenticação e banco de dados a partir de um único prompt? A capacidade está colapsando para dentro do agente. Geração de código, preview instantâneo, deploy, autenticação, banco de dados — essas coisas deixam de ser um destino que você visita e viram skills que o seu agente já tem à mão.
Acho que essa é a trajetória, e vou dizer com todas as letras: vibe coding vira um recurso dentro do ecossistema mais amplo de agentes, não um produto independente. O estado final provável é uma capacidade de vibe coding completa, nativa de IA e baseada em plugins vivendo dentro do Codex ou de um ambiente movido pelo Claude — com "traga seus próprios tokens" e traga seus próprios agentes, para que você controle o custo e a flexibilidade em vez de pagar a margem de uma plataforma.
Já defendi uma versão disso antes: vibe coding não morreu no sentido de sumir, morreu no sentido de se dissolver. A habilidade sobrevive. O produto independente é absorvido. Do mesmo jeito que os "apps de escrita com IA" independentes foram absorvidos por todas as ferramentas que você já usa.
Se você está construindo um negócio em cima de uma plataforma dedicada de vibe coding agora, isso não é motivo para pânico. É motivo para perguntar onde está de fato o seu diferencial competitivo. Porque a capacidade de geração não é — ela está virando um recurso commodity. Esse é, aliás, exatamente o tipo de questão estratégica que ajudo fundadores a resolver; se você prefere ter alguém mapeando sua arquitetura de IA antes de construir sobre uma base instável, você pode ver o que eu construo em fiverr.com/s/EgxYmWD.
Então, se o modelo é um utilitário e o vibe coding é um recurso, qual é a fronteira de verdade? É uma categoria de software cujo nome a maioria das pessoas ainda nem ouviu.
Apps agent native e a chegada dos mini apps
Dan Shipper — CEO da Every — tem uma frase que não sai da minha cabeça há semanas: a maior parte dos softwares novos será só "Claude Code de sobretudo". Novos recursos são só botões que disparam prompts para um agente geral por baixo.
Esse é o coração dos apps agent native: software projetado desde o início para ser operado por um agente de IA, em que a UI e o agente são parceiros iguais — tudo o que a UI faz, o agente faz, e vice-versa. O time de Shipper construiu um chamado Proof, um editor de documentos em que humanos e IA trabalham lado a lado em tempo real, originalmente marcando o texto da IA em roxo e o humano em verde para que desse para ver exatamente quem escreveu o quê. Quando o reconstruíram como um web app colaborativo, todo mundo na Every passou a usá-lo para tudo. Esse é o sinal: agent native não é truque, é uma forma melhor de trabalhar que as pessoas adotam sem precisar que alguém mande.
Agora leve a ideia um passo além, para a coisa que genuinamente me empolga: mini apps.
Um mini app é uma UI pequena, específica para uma tarefa, que um agente gera sob demanda e conecta diretamente às suas ferramentas reais por meio de plugins logados. Imagine isso de forma concreta. Você pede ao seu agente para cuidar da sua caixa de entrada. Em vez de despejar um muro de texto, ele cria uma pequena UI de cartões no estilo Tinder: cada e-mail é um cartão com uma resposta já redigida. Você desliza para aprovar, toca para editar, desliza para o outro lado para arquivar. Ele aprende com cada deslize — seu tom, o que você ignora, o que você sempre responde — e os rascunhos vão melhorando. Esse mini app não existia cinco minutos atrás. O agente o construiu para essa tarefa, conectado ao seu Gmail de verdade, e ele vai se dissolver quando você terminar.
Essa é a visão: UIs modulares, geradas por agentes, plugadas diretamente nos seus dados por conexões autenticadas — Gmail, Slack, Notion, tudo. Você as personaliza, você as compartilha. É a base de como um sistema operacional de agentes realmente se parece.
Agora a limitação honesta, porque não vou te vender fumaça. Ainda não chegamos totalmente lá. O Codex hoje ainda não permite construir apps profundamente integrados aos seus plugins de usuário autenticados do jeito que essa visão exige — construir um mini app que leia e escreva com segurança no seu Gmail ao vivo, com as permissões certas, é exatamente o problema difícil e meio resolvido que fica entre hoje e esse futuro. Os plugins existem. O navegador logado existe. A orquestração de agentes existe. A primitiva limpa e segura de "construa para mim um mini app conectado às minhas contas reais" é a peça que falta. Mas cada atualização deste ano vem assentando exatamente esse trilho.
E esse é todo o motivo pelo qual "tornar-se agent native" é a habilidade a construir agora, antes que as ferramentas alcancem totalmente. Porque, quando os mini apps chegarem, quem já pensa em agentes vai construir seu próprio software pessoal em uma tarde. Quem ainda estiver digitando em uma caixa de chat vai ficar esperando alguém lançar isso por ele.
Tornando-se agent native: quatro hábitos para construir agora
Vou deixar isso prático, porque "seja agent native" é inútil como conselho se eu não disser o que fazer de fato.
Tornar-se agent native, em 2026, significa reestruturar seu trabalho em torno de quatro hábitos:
-
Roteie, não idolatre. Pare de escolher um modelo como se fosse time de futebol. Use o Opus 4.8 para trabalho profundo em codebases e review com autoverificação, o GPT-5.5 no Codex para trabalho pesado de terminal e loops autônomos longos, e um modelo barato para o trabalho braçal de volume. A habilidade é casar o trabalho com a ferramenta, toda vez.
-
Supervisione em vez de operar. Fique à vontade para disparar o trabalho do agente, se afastar e pilotar à distância — pelo celular, entre worktrees, entre threads. Se você ainda está vigiando cada tecla, está usando uma ferramenta de 2026 com um fluxo de trabalho de 2023.
-
Pense em orquestração. Pare de pensar "um prompt, uma resposta". Comece a pensar "tarefa mestre, criar subagentes, coordenar, fazer merge". Threads multiagente não são mais brinquedo de power user; são o jeito de destravar a vazão de verdade.
-
Trate software como descartável. Quando os mini apps chegarem, a pergunta deixa de ser "que app eu devo baixar" e passa a ser "que interface eu quero que meu agente construa para esta tarefa agora". Comece a praticar essa mentalidade antes que as ferramentas a imponham a você.
Há uma analogia com as redes sociais que cristaliza tudo isso. Em toda plataforma existem dois tipos de pessoas: produtores, que controlam as ferramentas e moldam o feed, e consumidores, que são moldados pelo algoritmo. A revolução da IA está se dividindo exatamente do mesmo jeito. Ou você aprende a pilotar esses agentes — e se torna um produtor, construindo alavancagem a cada tarefa — ou deixa que eles passem por cima de você, como consumidor passivo de qualquer interface que outra pessoa te entregar.
Essa é a escolha. E é por isso que parei de escrever comparações de modelos como atração principal. O modelo agora é a parte fácil. A parte difícil, valiosa e aprendível é a postura de produtor: organizar toda a sua vida profissional em torno de agentes que você dirige, em vez de esperar o próximo gráfico de benchmark dizer a qual deles ser fiel.
A diferença de benchmark entre o Opus 4.8 e o GPT-5.5 vai fechar, se inverter e fechar de novo uma dúzia de vezes este ano. Nada disso vai importar para quem já é agent native — essa pessoa só vai rerrotear e continuar entregando. Então, da próxima vez que um modelo for lançado e seu instinto for perguntar "ele é o melhor?", se segure. Faça a pergunta melhor: estou produzindo com isto, ou estou sendo consumido por isto? Responda com honestidade, e você vai saber exatamente no que trabalhar em seguida.
Perguntas frequentes
O que significa "agent native"?
Tornar-se agent native significa reestruturar sua forma de trabalhar para que agentes de IA façam a operação e você faça a direção — roteando tarefas para o modelo certo, supervisionando à distância, orquestrando vários agentes e tratando software como algo que um agente constrói sob demanda. É uma postura de trabalho, não uma ferramenta ou produto único que você compra.
O Claude Opus 4.8 é melhor que o GPT-5.5 para programar?
Depende do trabalho. O Opus 4.8 lidera em trabalho com a codebase completa (69,2% vs 58,6% no SWE-Bench Pro) e em code review com autoverificação, enquanto o GPT-5.5 vence em programação no terminal (78,2% vs 74,6% no Terminal-Bench 2.1) e conclui loops autônomos longos com menos turnos e tokens. Roteie code review profundo para o Opus e trabalho pesado de terminal para o GPT-5.5.
O que são apps agent native e mini apps?
Apps agent native são construídos para que o agente de IA e a UI sejam parceiros iguais — tudo o que você pode clicar, o agente pode fazer, e vice-versa. Mini apps são interfaces pequenas e específicas para uma tarefa que um agente gera sob demanda e conecta às suas ferramentas reais por meio de plugins logados, e que depois se dissolvem quando a tarefa termina. Veja a seção sobre agent native acima para uma explicação completa.
Plataformas de vibe coding como Replit e Lovable vão desaparecer?
Não vão desaparecer, mas vão se dissolver nos agentes. A capacidade central — gerar, pré-visualizar, hospedar, adicionar autenticação e um banco de dados a partir de um prompt — está colapsando para dentro de agentes gerais como o Codex e o Claude Code, transformando o vibe coding de produto independente em recurso. As plataformas sobrevivem com especialização e onboarding, não apenas com a capacidade de geração.
O hábito que eu começaria esta semana
Parei de escrever posts de "qual modelo vence" porque a resposta honesta muda todo mês e nada disso faz diferença real. O que se acumula é a postura: dirigir agentes em vez de esperar o próximo gráfico de benchmark. Então, aqui está a única coisa sobre a qual eu agiria hoje — dispare uma tarefa de agente, se afaste e pilote-a à distância pelo celular. Essa única mudança reconfigurou meu jeito de trabalhar mais do que qualquer lançamento de modelo deste ano.