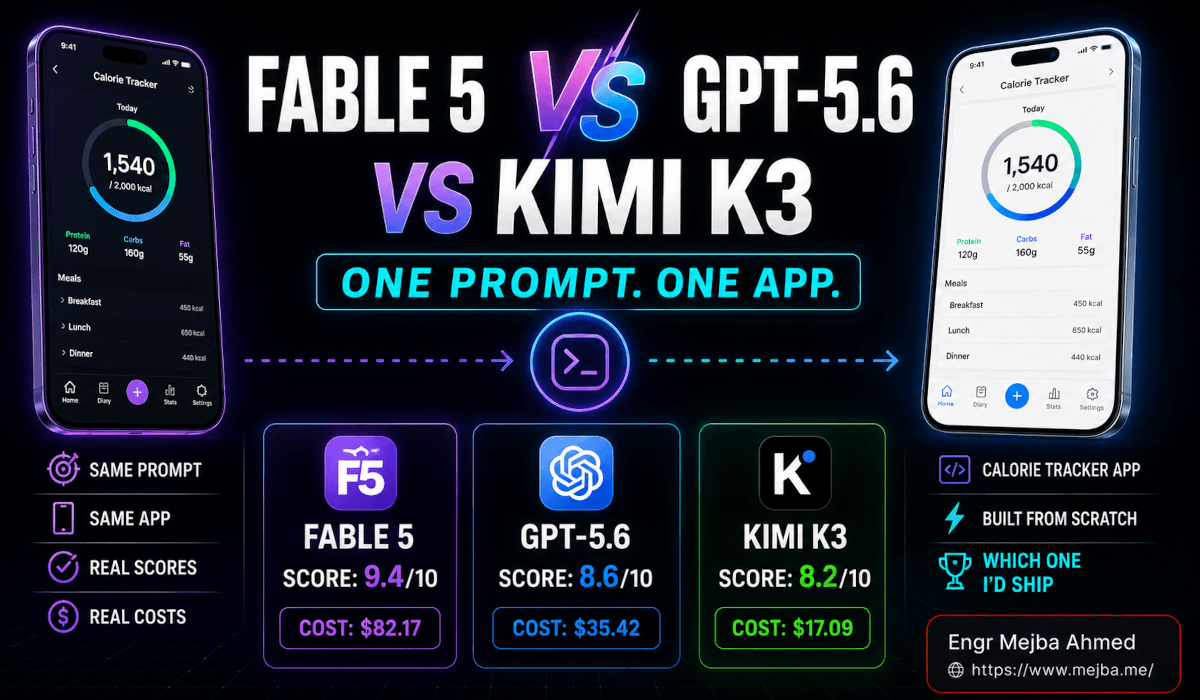
$82,30. Foi o que um desses agentes cobrou para construir um app de rastreamento de calorias a partir de um único prompt. O mais barato dos três fez o mesmo trabalho por $17,20 — uma diferença de 4,8x em trabalho idêntico, entregue na mesma tarde.
Aqui está a resposta curta para quem está avaliando Fable 5 vs GPT-5.6 vs Kimi K3 em trabalho real de construção de apps em vez de rankings: os três entregaram um contador de calorias funcional a partir de um prompt com zero revisões. O Fable 5 venceu a pontuação combinada 17 contra 8 contra 8, quase inteiramente por polimento de design e usabilidade. O GPT-5.6 Sol terminou mais rápido em 48 minutos e custou $23,93, mas produziu o app mais fino dos três. O Kimi K3 foi o mais lento com 1 hora e 54 minutos, custou menos, e — apesar da interface mais feia do grupo — foi o único que entregou um paywall que a Apple não rejeitaria.
Essa última frase é a que vale a pena absorver, e vou explicar por quê.
De Quem São Esses Recibos
Não executei este build. Deixo isso claro de início, porque a internet está afogada em teatro de benchmarks em primeira pessoa e prefiro ser quem desmonta resultados do que quem finge tê-los executado.
O experimento surgiu de uma comparação ao vivo: três agentes de código principal, um prompt idêntico, um app móvel completo de rastreamento de calorias, sem correções posteriores permitidas. Os apps foram pontuados em quatro eixos — velocidade de desenvolvimento, funcionalidade, design de UI e fidelidade de features nativas móveis — com totais reais de fatura vinculados a cada execução.
O que eu fiz foi verificar cada afirmação externa contra fontes publicadas, porque uma única execução por modelo é uma anedota até que algo independente corrobore o mecanismo. Duas coisas corroboram esta inusualmente bem, e mostrarei ambas.
Primeiro, uma limpeza de nomes, já que a transcrição fonte deformou dois dos três:
- GPT-5.6 Sol, não "Soul." O nível principal da OpenAI na família GPT-5.6, anunciado em 26 de junho de 2026, acima de Terra e Luna.
- Kimi K3, não "Kimik A3." O modelo mixture-of-experts de 2,8 trilhões de parâmetros da Moonshot AI, anunciado em 16 de julho de 2026 com pesos abertos em 27 de julho sob uma licença MIT modificada. Ativa aproximadamente 104 bilhões de parâmetros por token e tem uma janela de contexto de 1M tokens.
- Claude Fable 5 é o único que a transcrição acertou.
Agora a tabela de resultados, exatamente como registrada.
| Modelo | Tempo | Funcionalidade | Design | Features nativas | Total | Custo (USD) |
|---|---|---|---|---|---|---|
| Claude Fable 5 | 1h 26m | 4 | 9 | 4 | 17 | $82,30 |
| GPT-5.6 Sol | 48m | 1 | 5 | 2 | 8 | $23,93 |
| Kimi K3 | 1h 54m | 2 | 2 | 4 | 8 | $17,20 |
Três apps. Quatro horas e oito minutos de tempo total. $123,43 no total.
Leia a coluna de totais e a história parece decidida: o Fable 5 dobrou o campo. Leia os eixos individuais e a história desmorona — que é exatamente a parte sobre a qual ninguém cobrindo esses modelos está escrevendo.
Fable 5 vs GPT-5.6 vs Kimi K3: O Paradoxo do Benchmark
Antes deste build, se você tivesse perguntado aos rankings publicados qual desses três escreve o melhor código frontend, a resposta teria sido Kimi K3. Nem de perto.
O Kimi K3 estreou em primeiro lugar na Frontend Code Arena da Arena.ai com 1.679 pontos, à frente do Claude Fable 5 com 1.631 e GPT-5.6 Sol com 1.618. Também lidera o Program Bench com 77,8, ligeiramente acima de GPT-5.6 Sol com 77,6 e Fable 5 com 76,8. No Terminal Bench 2.1 pontua 88,3 contra 88,8 do Sol, superando tanto o Fable 5 quanto o Opus 4.8, que empatam em 84,6. No amplo Artificial Analysis Intelligence Index os três se agrupam em 60, 59 e 57 — três pontos de diferença em toda a fronteira.
Então o Kimi K3 construiu este app e pontuou 2 de um possível 9-plus em design.
Raios de borda inconsistentes. Telas desordenadas. O tipo de interface que faz um usuário fechar o app antes de registrar sua primeira refeição. O modelo que era, por medição, o melhor codificador frontend do mundo produziu o produto com pior aparência da sala.
Essa contradição não é um erro de pontuação. É a descoberta mais útil de toda a execução, e se resume ao que esses benchmarks realmente medem.
A Frontend Code Arena pontua gerações isoladas, julgadas por humanos — um componente, uma página, um trecho autocontido, avaliado por seus próprios méritos com a tarefa totalmente especificada. Program Bench e Terminal Bench pontuam correção contra testes e resultados de terminal. Cada uma dessas tarefas dá ao modelo um problema delimitado com uma resposta verificável.
Um contador de calorias construído a partir de um prompt é uma classe de tarefa completamente diferente. O agente tem que inventar um sistema de design que ninguém especificou, depois mantê-lo consistente ao longo de um fluxo de onboarding, uma tela de registro, um caminho de captura de câmera, uma visualização de histórico, um painel de configurações e um paywall — tudo enquanto conecta três SDKs de terceiros e não se contradiz trinta arquivos depois. Nada testa isso. Não há benchmark para coerência mantida ao longo de uma superfície não especificada durante noventa minutos de trabalho autônomo.
O Fable 5 é incomumente bom exatamente nisso. Sempre foi — fiz a mesma observação quando olhei como Fable 5 e Opus 5 se dividem em nove tarefas reais de trabalho do conhecimento, onde o Fable perdeu decisivamente em encontrar bugs e ganhou com a mesma decisão em tudo com uma superfície de design. Mesmo padrão, bateria de tarefas diferente, e agora confirmado em mobile.
A regra de trabalho que surge disso: benchmarks de frontend preveem qualidade de snippets, não coerência de produto. Trate-os como medindo habilidades diferentes, porque é isso que fazem.
O que levanta a pergunta óbvia — quanto da vitória esmagadora do Fable é realmente design?
Remova o Design e o Ranking Se Inverte
Olhe para a forma da rubrica antes de confiar nos totais. Ao longo de três modelos e quatro eixos, exatamente uma pontuação ultrapassa 4, e é o 9 do Fable em design. Cada outra célula na tabela fica entre 1 e 4. O design roda em uma escala visivelmente mais ampla que os outros eixos, o que significa que carrega peso desproporcional na coluna total.
Então recalculei os totais nos dois eixos que um desenvolvedor não consegue arrumar em uma tarde — funcionalidade e fidelidade de features nativas. Você pode reestilizar um app. Não pode facilmente retrofitar um modelo de dados ou um caminho de sincronização com HealthKit.
| Modelo | Funcionalidade | Features nativas | Subtotal engenharia | Custo | Custo por ponto de engenharia |
|---|---|---|---|---|---|
| Claude Fable 5 | 4 | 4 | 8 | $82,30 | $10,29 |
| Kimi K3 | 2 | 4 | 6 | $17,20 | $2,87 |
| GPT-5.6 Sol | 1 | 2 | 3 | $23,93 | $7,98 |
O ranking muda completamente.
O Kimi K3 vai de empatado em último para um claro segundo, a aproximadamente um quarto do custo do Fable por ponto de engenharia entregue. O GPT-5.6 Sol — o finalizador mais rápido, a execução estável, o que nunca caiu — cai para último por ampla margem, e nem era o mais barato.
O Fable ainda ganha. Deveria; 8 supera 6. Mas "ganha por pouco em engenharia e por muito em estética" é uma decisão de compra fundamentalmente diferente de "ganha 17 a 8." A primeira te diz para contratar o Fable para a passada de polimento. A segunda te diz para contratá-lo para tudo, e essa seria a leitura errada.
Esta é a parte onde pontuações combinadas enganam as pessoas. Qualquer composto que junta um eixo subjetivo e um eixo objetivo em um número entregará silenciosamente o volante ao eixo subjetivo. Olhe para as colunas, não para a soma.
O custo é onde isso fica ainda mais nítido.
O Que Realmente Gerou a Conta de $82
Tarifas de API publicadas, todas verificadas no início de agosto de 2026:
| Modelo | Input / 1M tokens | Output / 1M tokens | Input em cache |
|---|---|---|---|
| Claude Fable 5 | $10,00 | $50,00 | $1,00 |
| GPT-5.6 Sol | $5,00 | $30,00 | $0,50 |
| Kimi K3 | $3,00 | $15,00 | $0,30 |
O Fable 5 custa 3,33x o Kimi K3 por token tanto em input quanto output. Mas a proporção da fatura foi 4,79x — $82,30 contra $17,20.
Tarifas sozinhas não explicam isso. Faça a divisão: 4,79 ÷ 3,33 ≈ 1,44. O Fable queimou aproximadamente 40-45% mais volume de tokens que o Kimi no mesmo brief. Não é só mais caro por token; faz mais pensamento por unidade de output.
A comparação Fable versus Sol cai da mesma forma. O Sol é metade do preço de input do Fable e 60% do preço de output, então uma lacuna puramente por tarifa cairia perto de 1,7-2x. A lacuna real foi 3,44x. Mais tokens novamente.
Agora a corroboração que mencionei antes, e é boa. A Artificial Analysis publica custo médio por tarefa no DeepSWE: $21,63 para Fable 5, $8,39 para GPT-5.6 Sol, $4,65 para Kimi K3. Fable-para-Kimi nesse benchmark de código agêntico independente e completamente não relacionado resulta em 4,65x. Este build de app produziu 4,79x.
Duas avaliações, tipos de tarefa diferentes, avaliadores diferentes, mesmo múltiplo de custo com diferença de 3%. Isso não é coincidência — é uma propriedade estável de como esses modelos gastam tokens, e significa que você pode orçar com base nisso. Se o Kimi K3 te custa X em um build agêntico, planeje aproximadamente 4,5-5x esse número se passar o mesmo trabalho para o Fable 5.
O quadro por minuto é interessante por si só. O Fable rodou a aproximadamente $0,96 por minuto de relógio, Sol a $0,50, Kimi a $0,15. Se você é o tipo de pessoa que deixa um agente rodando enquanto faz café, essa é uma diferença significativa no que uma hora sem supervisão te custa. Escrevi um artigo completo sobre cortar custos de uso do Fable 5 sem degradar o modelo, e cada técnica nele aplica em dobro para builds autônomos longos como este.
Por Que o Modelo Mais Barato Demorou Mais
O Kimi K3 foi a execução mais lenta com 1 hora e 54 minutos — 33% mais longo que o Fable, 138% mais longo que o Sol — e foi lento por uma razão pouco glamorosa. Encontrou erros e reconstruiu. Múltiplas vezes.
Isso merece mais atenção do que normalmente recebe, porque loops de reconstrução são onde o argumento do preço-por-token morre silenciosamente para muitas equipes.
O Kimi ainda saiu mais barato aqui, então os loops não apagaram sua vantagem de custo nesta execução. Mas consumiram 28 minutos extras frente ao Fable e 66 frente ao Sol. Se você é uma agência que fatura esse tempo, ou um construtor solo com três horas entre ligações de clientes, o modelo que te economizou $65 acabou de tomar o slot mais longo da sua agenda. Tokens baratos e horas baratas não são a mesma moeda, e só uma delas aparece na fatura.
O outro lado é que a execução de 48 minutos do Sol foi estável e limpa, e produziu o app menos completo do grupo. Velocidade sem nada para mostrar é seu próprio tipo de caro. Há uma versão desse trade-off onde a execução rápida, barata e estável é a resposta certa — prototipagem, demos descartáveis, provar um conceito antes de comprometer orçamento real — e uma versão onde desperdiça a tarde toda porque você precisa construir de novo corretamente.
Três modelos, três modos de falha distintos: o Fable queima dinheiro, o Kimi queima tempo, o Sol queima escopo. Escolha seu veneno baseado em qual você pode absorver esta semana.
As Integrações São Por Que Isso Funcionou
Deixe a comparação de modelos de lado por um segundo, porque a configuração merece crédito que normalmente vai para os agentes.
O prompt especificou três serviços de terceiros:
- Clerk para autenticação
- RevenueCat para gerenciamento de assinaturas e paywalls
- Gemini API para análise de calorias baseada em imagem
Nenhum dos agentes construiu auth. Nenhum construiu uma camada de pagamentos. Nenhum treinou um modelo de visão para olhar um prato de comida e estimar macros. Eles conectaram SDKs.
Essa é a verdadeira chave por trás dos apps de um único prompt, e é um ponto arquitetônico, não de modelo. Peça a qualquer um desses três agentes para construir manualmente gerenciamento de sessões, validação de recibos em duas app stores e um pipeline de reconhecimento de alimentos, e você terá noventa minutos de código confiante e não-entregável. Dê a eles um brief onde as partes difíceis, sensíveis à segurança e próximas à regulação já estão resolvidas por serviços com SDKs bem documentados, e eles performam como engenheiros competentes de nível médio.
A lição se generaliza muito além de contadores de calorias. A maior alavanca na qualidade de builds de um único prompt não é qual modelo você escolhe — é quanto do problema você já removeu do prato do modelo antes dele começar. Encontrei exatamente essa restrição quando construí um app móvel de nicho com Claude Code e React Native em um fim de semana: cada hora que economizei veio de um serviço que não pedi ao agente para reinventar.
Se prefere deixar a arquitetura de integração para alguém que já mapeou quais serviços são seguros para delegar a um agente e quais absolutamente não são, isso é grande parte do que faço em builds personalizados — fiverr.com/s/EgxYmWD.
Agora o eixo que separa um app real de um site web fantasiado.
O Que Features Nativas Realmente Provam em um App Construído com IA?
A fidelidade de features nativas é o eixo que te diz se você recebeu um app móvel ou uma página web vestida de um. Neste build cobriu sincronização com Apple Health, notificações push, navegação nativa com bottom tabs, live activities e widgets.
Pontuações: Fable 5 e Kimi K3 empataram em 4. GPT-5.6 Sol conseguiu 2.
Registro de refeições, integração com Apple Health e notificações foram bem tratados por todos os três — a linha de base é genuinamente sólida agora, e essa é a descoberta principal que as pessoas devem levar desta execução. Onde a lacuna se abriu foi no acabamento específico da plataforma: bottom tabs reais versus uma div estilizada, live activities que realmente aparecem na tela de bloqueio, widgets que respeitam o layout do sistema.
O Kimi K3 implementou bottom tabs nativos e elementos de paywall corretamente, o que explica por que empatou com o Fable neste eixo enquanto pontuou 2 em estética. Construiu as estruturas certas e as vestiu mal. Isso é, mecanicamente, o problema mais fácil de resolver — um designer pode reestilizar uma pilha de navegação correta em um dia, mas retrofitar navegação nativa em um app que a simula com uma scroll view significa destripar o shell.
O 2 do Sol é o número que mais me preocuparia em produção. Fidelidade nativa fraca mais 1 em funcionalidade significa que você não está polindo um app, está reescrevendo um.
O que me leva ao detalhe mais praticamente importante de todo o experimento, e pertence ao modelo que pontuou por último em design.
O Detalhe do Paywall Que Decide Se Você Lança
O paywall do Kimi K3 incluía links proeminentes para a política de privacidade e termos de uso.
Parece uma nota de rodapé. É a diferença entre lançar e não lançar.
A App Store Review Guideline 3.1.2 da Apple exige que apps com assinaturas auto-renováveis forneçam links funcionais tanto para a política de privacidade quanto para os termos de uso (EULA). A tela de assinatura dentro do app deve mostrar o título da assinatura, sua duração e seu preço, junto com os termos completos de assinatura auto-renovável. E os revisores avaliam o que um usuário pode alcançar de dentro do app em execução — se um revisor não pode tocar em um link visível e abrir o documento imediatamente, o requisito não é atendido. Links ausentes sob 3.1.2 são uma das causas mais comuns de rejeição de apps de assinatura, e cada ida e volta com App Review custa dias.
O app mais feio do teste foi o mais próximo de realmente passar na revisão.
Continuo voltando a isso, porque inverte como a maioria das pessoas avalia esses outputs. Julgamos apps construídos com IA pela captura de tela. App Review os julga pela tubulação de conformidade que nunca aparece em uma captura. Uma interface linda de 9-de-9 com um paywall sem o link EULA está mais longe do App Store do que uma desordenada que acertou o mobiliário legal.
Então quando você está auditando um app gerado por IA antes de lançar, a checklist que importa não se parece nada com a que você usaria para uma revisão de design:
- O paywall linka para uma política de privacidade e termos de uso ativos, tocáveis de dentro do app?
- Mostra título da assinatura, período de cobrança e preço sem ambiguidade?
- O texto completo dos termos de assinatura auto-renovável está presente?
- Os links abrem documentos que realmente existem nessas URLs?
- Há um caminho funcional de restaurar compras?
Nada disso está na rubrica de quatro eixos. Tudo isso determina seu lançamento.
Fable 5 vs GPT-5.6 vs Kimi K3: Para Que Usar Cada Um
Aqui está a alocação que eu faria, dado o que este build mostra e o que os benchmarks publicados mostram junto.
Use Fable 5 quando a superfície de design é o produto. Apps de consumo, fluxos de onboarding, qualquer coisa onde um usuário decide em oito segundos se mantém o app. Seu 9 em design, sua integração de onboarding, o tratamento de teclado, as entradas de calorias editáveis, as animações de gráficos — esses pontos bônus são mecânicas de conversão, não decoração. Um melhor fluxo de onboarding em um app de assinatura paga um build de $82 em um punhado de conversões de teste. Só entre sabendo que está pagando aproximadamente 4,5-5x a tarifa do Kimi.
Use Kimi K3 quando estrutura importa mais que pele. Ferramentas internas, superfícies de admin, MVPs indo para uma passada de design de qualquer forma, e qualquer projeto onde um designer humano faz a camada visual independentemente. Acerta a arquitetura, entrega o mobiliário de conformidade, custa um quarto por ponto de engenharia, e os pesos são abertos sob uma licença MIT modificada se precisar de self-hosting. Orce os ciclos de reconstrução na sua agenda, não só no cartão. Minha visão mais completa de onde funciona e onde não está na review do Kimi K3.
Use GPT-5.6 Sol para velocidade-até-algo. Quarenta e oito minutos e uma execução estável é genuinamente útil quando precisa de um artefato funcional na frente de um stakeholder antes do almoço. Não confunda o artefato com um fundamento — 1 em funcionalidade significa que está demonstrando uma ideia, não começando uma base de código.
Ou divida o trabalho. A opção mais interessante que esses dados sugerem não é escolher um. Deixe o Kimi K3 ou Sol produzir o build estrutural barato, depois passe o resultado para o Fable 5 para uma passada de design e usabilidade só na camada superficial. Pagaria a tarifa do Fable em uma fração dos tokens. Não vi ninguém publicar números limpos sobre esse híbrido, e é o experimento que mais gostaria de ver executado. A mesma lógica de divisão apareceu quando olhei como esses modelos divergem em trabalho criativo — o vencedor muda com a tarefa, então pare de procurar um só.
O Que Esta Execução Não Prova
Tamanho de amostra um. Por modelo. Em uma categoria de app.
Te faria um desserviço apresentar isso como benchmark, então deixe-me nomear os limites específicos.
Uma única execução não pode separar capacidade do modelo de sorte do prompt. Repita o mesmo brief três vezes por modelo e quase certamente veria as pontuações se moverem — possivelmente muito, dado quanto do eixo de design é julgamento subjetivo. Os ciclos de reconstrução do Kimi em particular podem ser uma propriedade do modelo, ou um seed ruim em uma tarde. Uma execução não pode dizer qual.
A rubrica pesa design fortemente e nunca publica seus tetos por eixo, por isso recalculei nos eixos de engenharia em vez de confiar nos totais. E um contador de calorias com três integrações SDK bem documentadas está próximo de um caso ideal para geração de um único prompt — categoria bem percorrida, dados de treinamento abundantes, partes difíceis terceirizadas para serviços. Tente isso com um editor colaborativo em tempo real ou qualquer coisa com gerenciamento de estado genuinamente novel e esperaria que todas as três pontuações desmoronem.
O que a execução estabelece, e o que dados independentes apoiam, é direcional e útil: os três agentes de fronteira agora passam a barra de "funciona?" em mobile, a diferenciação se moveu de funcionalidade para coerência e polimento, e a diferença de custo entre eles é grande e previsível o suficiente para planejar.
Isso é um mundo diferente de doze meses atrás, quando a pergunta era se algo disso compilava.
O Número Que Fica Comigo
Não os $82,30. Não a pontuação 17-a-8.
São $123,43 — o total dos três apps — contra quatro horas e oito minutos de relógio. Três aplicações móveis funcionais, integradas e prontas para assinatura, com autenticação, pagamentos, análise de alimentos baseada em visão e sincronização com Apple Health, a partir de três prompts, em meio dia de trabalho, por menos que a taxa horária do desenvolvedor que antes era necessário para construir um deles.
Nenhum está pronto para publicar hoje. Cada um precisa de uma auditoria de conformidade, uma passada de design e um humano que entenda o que o App Review fará com um paywall com um link quebrado. A lacuna de polimento é real, e é exatamente onde está o trabalho restante.
Mas a lacuna entre "IA gerou algo com forma de app" e "IA gerou algo que você poderia terminar em uma tarde" fechou enquanto a maioria ainda discutia sobre tabelas de benchmark.
Escolha o modelo que corresponda ao eixo que você não pode arrumar sozinho. Depois descubra quanto da tarde restante é realmente sua.
Perguntas Frequentes
Qual é o melhor modelo de IA para construir apps móveis em 2026?
O Claude Fable 5 produziu o melhor app móvel geral neste teste de prompt único, pontuando 17 contra 8 tanto para GPT-5.6 Sol quanto para Kimi K3, impulsionado principalmente por design e usabilidade. O Kimi K3 entregou o melhor valor de engenharia a aproximadamente $2,87 por ponto de funcionalidade e fidelidade de features nativas. Veja a análise de alocação acima.
Por que o Claude Fable 5 é tão mais caro que o Kimi K3?
O Fable 5 tem preço de $10/$50 por milhão de tokens de entrada/saída contra $3/$15 do Kimi K3 — uma diferença de tarifa de 3,33x. A lacuna real da fatura foi 4,79x porque o Fable também consome aproximadamente 40-45% mais volume de tokens na mesma tarefa. Dados independentes de custo por tarefa do DeepSWE mostram um múltiplo quase idêntico de 4,65x.
Agentes de código IA podem construir um app completo a partir de um prompt?
Sim, com uma ressalva significativa sobre integrações. Os três agentes produziram contadores de calorias funcionais com registro de refeições, sincronização com Apple Health e notificações a partir de um único prompt — mas só porque auth, pagamentos e visão foram delegados ao Clerk, RevenueCat e API Gemini em vez de construídos do zero.
O Kimi K3 supera o Fable 5 em programação?
Em benchmarks publicados, às vezes. O Kimi K3 lidera a Frontend Code Arena com 1.679 contra 1.631 do Fable 5 e encabeça o Program Bench com 77,8. Neste build de app completo pontuou 2 em design contra 9 do Fable — esses benchmarks medem qualidade de código isolada, não coerência mantida ao longo de toda uma superfície de produto.
O que faz um app gerado por IA ser rejeitado do App Store?
Links ausentes para política de privacidade e termos de uso no paywall de assinatura estão entre as falhas mais comuns, sob a App Store Review Guideline 3.1.2. Revisores devem poder tocar em um link visível dentro do app em execução e abrir o documento imediatamente. Verifique a auditoria de paywall de cinco pontos acima antes de enviar.
Vamos Trabalhar Juntos
Quer construir sistemas de IA, automatizar fluxos de trabalho ou escalar sua infraestrutura tecnológica? Adoraria ajudar.
- Fiverr (builds personalizados e integrações): fiverr.com/s/EgxYmWD
- Portfólio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io