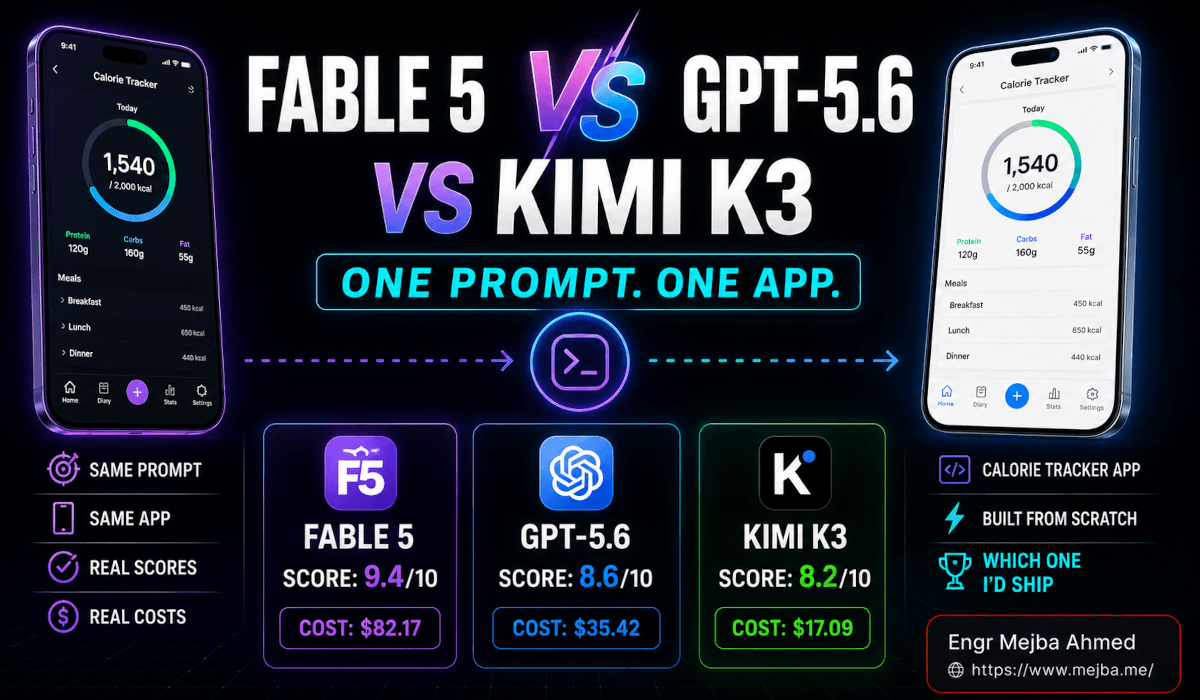
82,30 $. C'est ce que l'un de ces agents a facturé pour construire une application de suivi des calories à partir d'un seul prompt. Le moins cher des trois a fait le même travail pour 17,20 $ — un écart de 4,8x sur un travail identique, livré le même après-midi.
Voici la réponse courte pour quiconque évalue Fable 5 vs GPT-5.6 vs Kimi K3 sur du vrai travail de construction d'apps plutôt que sur des classements : les trois ont livré un compteur de calories fonctionnel à partir d'un prompt avec zéro révision. Fable 5 a remporté le score combiné 17 contre 8 contre 8, presque entièrement grâce au polish de design et d'utilisabilité. GPT-5.6 Sol a terminé le plus vite en 48 minutes et a coûté 23,93 $, mais a produit l'app la plus mince des trois. Kimi K3 était le plus lent à 1 heure 54 minutes, a coûté le moins, et — malgré l'interface la plus laide du groupe — était le seul à livrer un paywall qu'Apple ne rejetterait pas.
Cette dernière phrase mérite qu'on s'y arrête, et je vais expliquer pourquoi.
À Qui Appartiennent Ces Reçus
Je n'ai pas exécuté ce build. Je le dis d'emblée, parce qu'internet croule sous le théâtre de benchmarks à la première personne et je préfère être celui qui démonte les résultats plutôt que celui qui prétend les avoir exécutés.
L'expérience est née d'une comparaison en direct : trois agents de code phares, un prompt identique, une application mobile complète de suivi des calories, aucune correction ultérieure autorisée. Les apps ont été notées sur quatre axes — vitesse de développement, fonctionnalité, design UI et fidélité des fonctionnalités natives mobiles — avec des totaux de facture réels attachés à chaque exécution.
Ce que j'ai fait, c'est vérifier chaque affirmation externe contre des sources publiées, car une seule exécution par modèle est une anecdote tant que quelque chose d'indépendant ne corrobore pas le mécanisme. Deux choses corroborent celle-ci inhabituellement bien, et je montrerai les deux.
D'abord, un peu de nettoyage de noms, puisque la transcription source a déformé deux des trois :
- GPT-5.6 Sol, pas « Soul ». Le niveau phare d'OpenAI dans la famille GPT-5.6, annoncé le 26 juin 2026, au-dessus de Terra et Luna.
- Kimi K3, pas « Kimik A3 ». Le modèle mixture-of-experts de 2,8 billions de paramètres de Moonshot AI, annoncé le 16 juillet 2026 avec des poids ouverts le 27 juillet sous une licence MIT modifiée. Il active environ 104 milliards de paramètres par token et dispose d'une fenêtre de contexte de 1M tokens.
- Claude Fable 5 est le seul que la transcription a eu juste.
Maintenant la table de résultats, exactement telle qu'enregistrée.
| Modèle | Durée | Fonctionnalité | Design | Features natives | Total | Coût (USD) |
|---|---|---|---|---|---|---|
| Claude Fable 5 | 1h 26m | 4 | 9 | 4 | 17 | 82,30 $ |
| GPT-5.6 Sol | 48m | 1 | 5 | 2 | 8 | 23,93 $ |
| Kimi K3 | 1h 54m | 2 | 2 | 4 | 8 | 17,20 $ |
Trois apps. Quatre heures et huit minutes de temps total. 123,43 $ au total.
Lisez la colonne des totaux et l'histoire semble réglée : Fable 5 a doublé le peloton. Lisez les axes individuels et l'histoire s'effondre — ce qui est exactement la partie sur laquelle personne couvrant ces modèles n'écrit.
Fable 5 vs GPT-5.6 vs Kimi K3 : Le Paradoxe du Benchmark
Avant ce build, si vous aviez demandé aux classements publiés lequel de ces trois écrit le meilleur code frontend, la réponse aurait été Kimi K3. Pas de peu, non plus.
Kimi K3 a débuté numéro un sur la Frontend Code Arena d'Arena.ai avec 1 679 points, devant Claude Fable 5 à 1 631 et GPT-5.6 Sol à 1 618. Il domine aussi Program Bench à 77,8, devançant de peu GPT-5.6 Sol à 77,6 et Fable 5 à 76,8. Sur Terminal Bench 2.1 il obtient 88,3 contre 88,8 pour Sol, battant à la fois Fable 5 et Opus 4.8, qui sont à égalité à 84,6. Sur le large Artificial Analysis Intelligence Index les trois se regroupent à 60, 59 et 57 — un écart de trois points sur toute la frontière.
Puis Kimi K3 a construit cette app et a obtenu 2 sur un possible 9-plus en design.
Des rayons de bordure incohérents. Des écrans encombrés. Le genre d'interface qui fait fermer l'app à un utilisateur avant de noter son premier repas. Le modèle qui était, par mesure, le meilleur codeur frontend au monde a produit le produit le plus laid de la pièce.
Cette contradiction n'est pas une erreur de notation. C'est la découverte la plus utile de toute l'exécution, et cela se résume à ce que ces benchmarks mesurent réellement.
La Frontend Code Arena note des générations isolées, jugées par des humains — un composant, une page, un extrait autonome, évalué sur ses propres mérites avec la tâche entièrement spécifiée. Program Bench et Terminal Bench notent la correction contre des tests et des résultats de terminal. Chacune de ces tâches donne au modèle un problème délimité avec une réponse vérifiable.
Un compteur de calories construit à partir d'un prompt est une classe de tâche entièrement différente. L'agent doit inventer un système de design que personne n'a spécifié, puis le maintenir cohérent à travers un flux d'onboarding, un écran de journalisation, un chemin de capture caméra, une vue d'historique, un panneau de paramètres et un paywall — le tout en câblant trois SDKs tiers et sans se contredire trente fichiers plus tard. Rien ne teste ça. Il n'y a pas de benchmark pour la cohérence maintenue sur une surface non spécifiée pendant quatre-vingt-dix minutes de travail autonome.
Fable 5 est inhabituellement bon à ça précisément. Il l'a toujours été — j'ai fait la même observation quand j'ai regardé comment Fable 5 et Opus 5 se répartissent sur neuf tâches réelles de travail du savoir, où Fable a perdu de façon décisive en recherche de bugs et a gagné tout aussi décisivement sur tout ce qui avait une surface de design. Même schéma, batterie de tâches différente, et maintenant confirmé sur mobile.
La règle de travail qui en ressort : les benchmarks frontend prédisent la qualité des snippets, pas la cohérence du produit. Traitez-les comme mesurant des compétences différentes, car c'est ce qu'ils font.
Ce qui soulève la question évidente — combien de la victoire écrasante de Fable est réellement du design ?
Retirez le Design et le Classement S'Inverse
Regardez la forme de la rubrique avant de faire confiance à ses totaux. Sur trois modèles et quatre axes, exactement un score dépasse 4, et c'est le 9 de Fable en design. Chaque autre cellule du tableau se situe entre 1 et 4. Le design tourne sur une échelle visiblement plus large que les autres axes, ce qui signifie qu'il porte un poids disproportionné dans la colonne totale.
J'ai donc recalculé les totaux sur les deux axes qu'un développeur ne peut pas corriger en un après-midi — fonctionnalité et fidélité des fonctionnalités natives. On peut restyler une app. On ne peut pas facilement adapter un modèle de données ou un chemin de synchronisation HealthKit.
| Modèle | Fonctionnalité | Features natives | Sous-total ingénierie | Coût | Coût par point d'ingénierie |
|---|---|---|---|---|---|
| Claude Fable 5 | 4 | 4 | 8 | 82,30 $ | 10,29 $ |
| Kimi K3 | 2 | 4 | 6 | 17,20 $ | 2,87 $ |
| GPT-5.6 Sol | 1 | 2 | 3 | 23,93 $ | 7,98 $ |
Le classement change complètement.
Kimi K3 passe d'ex-aequo dernier à un clair deuxième, à environ un quart du coût de Fable par point d'ingénierie livré. GPT-5.6 Sol — le finisseur le plus rapide, l'exécution stable, celui qui n'est jamais tombé — tombe au dernier rang par une large marge, et il n'était même pas le moins cher.
Fable gagne encore. Il devrait ; 8 bat 6. Mais « gagne d'un cheveu en ingénierie et d'un kilomètre en esthétique » est une décision d'achat fondamentalement différente de « gagne 17 à 8 ». La première vous dit d'embaucher Fable pour la passe de polish. La deuxième vous dit de l'embaucher pour tout, et ce serait la mauvaise lecture.
C'est la partie où les scores mixtes trompent les gens. Tout composite qui fusionne un axe subjectif et un axe objectif en un seul nombre donne silencieusement le volant à l'axe subjectif. Regardez les colonnes, pas la somme.
Le coût est là où ça devient encore plus net.
Ce Qui a Réellement Généré la Facture de 82 $
Tarifs API publiés, tous vérifiés début août 2026 :
| Modèle | Input / 1M tokens | Output / 1M tokens | Input en cache |
|---|---|---|---|
| Claude Fable 5 | 10,00 $ | 50,00 $ | 1,00 $ |
| GPT-5.6 Sol | 5,00 $ | 30,00 $ | 0,50 $ |
| Kimi K3 | 3,00 $ | 15,00 $ | 0,30 $ |
Fable 5 coûte 3,33x Kimi K3 par token en entrée et en sortie. Mais le ratio de facturation était de 4,79x — 82,30 $ contre 17,20 $.
Les tarifs seuls n'expliquent pas ça. Faites la division : 4,79 ÷ 3,33 ≈ 1,44. Fable a brûlé environ 40-45 % de volume de tokens en plus que Kimi sur le même brief. Il n'est pas seulement plus cher par token ; il fait plus de réflexion par unité de sortie.
La comparaison Fable versus Sol atterrit de la même façon. Sol est à la moitié du prix d'entrée de Fable et à 60 % de son prix de sortie, donc un écart purement tarifaire atterrirait quelque part autour de 1,7-2x. L'écart réel était de 3,44x. Plus de tokens encore.
Maintenant la corroboration que j'ai mentionnée plus tôt, et c'est une bonne. Artificial Analysis publie le coût moyen par tâche sur DeepSWE : 21,63 $ pour Fable 5, 8,39 $ pour GPT-5.6 Sol, 4,65 $ pour Kimi K3. Fable-vers-Kimi sur ce benchmark de code agentique indépendant et totalement sans rapport donne 4,65x. Ce build d'app a produit 4,79x.
Deux évaluations, types de tâches différents, évaluateurs différents, même multiple de coût à 3 % près. Ce n'est pas une coïncidence — c'est une propriété stable de la façon dont ces modèles dépensent les tokens, et ça signifie que vous pouvez budgéter en conséquence. Si Kimi K3 vous coûte X sur un build agentique, prévoyez environ 4,5-5x ce montant si vous donnez le même travail à Fable 5.
L'image par minute est intéressante en soi. Fable tournait à environ 0,96 $ par minute d'horloge, Sol à 0,50 $, Kimi à 0,15 $. Si vous êtes le genre de personne qui laisse un agent tourner pendant qu'elle fait du café, c'est une différence significative dans ce qu'une heure sans surveillance vous coûte. J'ai écrit un article entier sur réduire les coûts d'utilisation de Fable 5 sans dégrader le modèle, et chaque technique s'applique double pour les builds autonomes longs comme celui-ci.
Pourquoi le Modèle le Moins Cher a Pris le Plus de Temps
Kimi K3 était l'exécution la plus lente à 1 heure 54 minutes — 33 % plus long que Fable, 138 % plus long que Sol — et il était lent pour une raison peu glamour. Il a rencontré des erreurs et reconstruit. Plusieurs fois.
Ça mérite plus d'attention que ça n'en reçoit habituellement, parce que les boucles de reconstruction sont là où l'argument du prix-par-token meurt silencieusement pour beaucoup d'équipes.
Kimi est quand même sorti le moins cher ici, donc les boucles n'ont pas effacé son avantage de coût sur cette exécution. Mais elles ont consommé 28 minutes supplémentaires par rapport à Fable et 66 par rapport à Sol. Si vous êtes une agence qui facture ce temps, ou un constructeur solo avec trois heures entre des appels clients, le modèle qui vous a économisé 65 $ vient de prendre le créneau le plus long de votre calendrier. Des tokens bon marché et des heures bon marché ne sont pas la même monnaie, et seule l'une d'elles apparaît sur la facture.
Le revers est que l'exécution de 48 minutes de Sol était stable et propre, et elle a produit l'app la moins complète du groupe. La vitesse sans rien à montrer est son propre genre de cher. Il y a une version de ce compromis où l'exécution rapide, bon marché et stable est la bonne réponse — prototypage, démos jetables, prouver un concept avant d'engager du vrai budget — et une version où elle gaspille tout l'après-midi parce que vous devez reconstruire correctement.
Trois modèles, trois modes de défaillance distincts : Fable brûle de l'argent, Kimi brûle du temps, Sol brûle du périmètre. Choisissez votre poison selon ce que vous pouvez réellement absorber cette semaine.
Les Intégrations Sont la Raison Pour Laquelle Ça a Fonctionné
Mettez la comparaison de modèles de côté une seconde, parce que la configuration mérite le crédit qui revient habituellement aux agents.
Le prompt spécifiait trois services tiers :
- Clerk pour l'authentification
- RevenueCat pour la gestion des abonnements et les paywalls
- Gemini API pour l'analyse calorique basée sur l'image
Aucun des agents n'a construit l'auth. Aucun n'a construit une couche de paiements. Aucun n'a entraîné un modèle de vision pour regarder une assiette de nourriture et estimer les macros. Ils ont câblé des SDKs.
C'est le vrai déclencheur derrière les apps à prompt unique, et c'est un point architectural, pas un point de modèle. Demandez à n'importe lequel de ces trois agents de construire manuellement la gestion de sessions, la validation de reçus sur deux app stores et un pipeline de reconnaissance alimentaire, et vous obtiendrez quatre-vingt-dix minutes de code confiant et non-livrable. Donnez-leur un brief où les parties difficiles, sensibles à la sécurité et proches de la réglementation sont déjà résolues par des services avec des SDKs bien documentés, et ils performent comme des ingénieurs compétents de niveau intermédiaire.
La leçon se généralise bien au-delà des compteurs de calories. Le plus grand levier sur la qualité des builds à prompt unique n'est pas quel modèle vous choisissez — c'est combien du problème vous avez déjà retiré de l'assiette du modèle avant qu'il commence. J'ai exactement rencontré cette contrainte quand j'ai construit une app mobile de niche avec Claude Code et React Native en un week-end : chaque heure économisée venait d'un service que je n'ai pas demandé à l'agent de réinventer.
Si vous préférez confier l'architecture d'intégration à quelqu'un qui a déjà cartographié quels services sont sûrs à déléguer à un agent et quels ne le sont absolument pas, c'est une grande partie de ce que je fais sur les builds sur mesure — fiverr.com/s/EgxYmWD.
Maintenant l'axe qui sépare une vraie app d'un site web déguisé.
Que Prouvent Réellement les Fonctionnalités Natives dans une App Construite par IA ?
La fidélité des fonctionnalités natives est l'axe qui vous dit si vous avez obtenu une app mobile ou une page web qui en porte une. Sur ce build, elle couvrait la synchronisation Apple Health, les notifications push, la navigation native par onglets bas, les live activities et les widgets.
Scores : Fable 5 et Kimi K3 à égalité à 4. GPT-5.6 Sol a obtenu 2.
Le journal des repas, l'intégration Apple Health et les notifications étaient bien gérés par les trois — la base est maintenant véritablement solide, et c'est la découverte principale que les gens devraient retenir de cette exécution. Là où l'écart s'est ouvert, c'est dans le chrome spécifique à la plateforme : de vrais onglets bas versus une div stylisée, des live activities qui apparaissent réellement sur l'écran de verrouillage, des widgets qui respectent la disposition du système.
Kimi K3 a implémenté correctement les onglets bas natifs et les éléments de paywall, ce qui explique pourquoi il a égalé Fable sur cet axe tout en obtenant un 2 en esthétique. Il a construit les bonnes structures et les a mal habillées. C'est, mécaniquement, le problème le plus facile à corriger — un designer peut restyler une pile de navigation correcte en un jour, mais adapter rétroactivement la navigation native dans une app qui la simule avec une scroll view signifie éventrer la coque.
Le 2 de Sol est le chiffre qui m'inquiéterait le plus en production. Une fidélité native faible plus un 1 en fonctionnalité signifie que vous ne polissez pas une app, vous en réécrivez une.
Ce qui m'amène au détail le plus pratiquement important de toute l'expérience, et il appartient au modèle qui a obtenu le dernier score en design.
Le Détail du Paywall Qui Décide Si Vous Lancez
Le paywall de Kimi K3 incluait des liens proéminents vers la politique de confidentialité et les conditions d'utilisation.
Ça ressemble à une note de bas de page. C'est la différence entre lancer et ne pas lancer.
La App Store Review Guideline 3.1.2 d'Apple exige que les apps avec des abonnements auto-renouvelables fournissent des liens fonctionnels vers la politique de confidentialité et les conditions d'utilisation (EULA). L'écran d'abonnement in-app doit montrer le titre de l'abonnement, sa durée et son prix, ainsi que les termes complets d'abonnement auto-renouvelable. Et les examinateurs évaluent ce qu'un utilisateur peut atteindre depuis l'intérieur de l'app en cours d'exécution — si un examinateur ne peut pas appuyer sur un lien visible et ouvrir le document immédiatement, l'exigence n'est pas remplie. Les liens manquants sous 3.1.2 sont l'une des causes les plus courantes de rejet d'apps à abonnement, et chaque aller-retour avec App Review coûte des jours.
L'app la plus laide du test était celle la plus proche de passer réellement la revue.
J'y reviens sans cesse, parce que ça inverse la façon dont la plupart des gens évaluent ces outputs. Nous jugeons les apps construites par IA sur la capture d'écran. App Review les juge sur la plomberie de conformité qui n'apparaît jamais dans une capture d'écran. Une magnifique interface 9-sur-9 avec un paywall manquant son lien EULA est plus loin de l'App Store qu'une encombrée qui a bien placé le mobilier juridique.
Donc quand vous auditez une app générée par IA avant de la lancer, la checklist qui compte ne ressemble en rien à celle que vous utiliseriez pour une revue de design :
- Le paywall renvoie-t-il vers une politique de confidentialité et des conditions d'utilisation actives, accessibles depuis l'intérieur de l'app ?
- Affiche-t-il le titre de l'abonnement, la période de facturation et le prix sans ambiguïté ?
- Le texte complet des conditions d'abonnement auto-renouvelable est-il présent ?
- Les liens ouvrent-ils des documents qui existent réellement à ces URLs ?
- Y a-t-il un chemin fonctionnel de restauration des achats ?
Rien de tout ça n'est dans la rubrique à quatre axes. Tout ça conditionne votre lancement.
Fable 5 vs GPT-5.6 vs Kimi K3 : Pour Quoi Utiliser Chacun
Voici l'allocation que j'appliquerais, vu ce que ce build montre et ce que les benchmarks publiés montrent à côté.
Utilisez Fable 5 quand la surface de design est le produit. Apps grand public, flux d'onboarding, tout ce où un utilisateur décide en huit secondes s'il garde l'app. Son 9 en design, son intégration d'onboarding, la gestion du clavier, les entrées de calories éditables, les animations de graphiques — ces points bonus sont des mécaniques de conversion, pas de la décoration. Un meilleur flux d'onboarding sur une app à abonnement rembourse un build à 82 $ en une poignée de conversions d'essai. Entrez simplement en sachant que vous payez environ 4,5-5x le tarif de Kimi.
Utilisez Kimi K3 quand la structure compte plus que l'habillage. Outils internes, surfaces d'administration, MVPs destinés à une passe de design de toute façon, et tout projet où un designer humain fait la couche visuelle quoi qu'il arrive. Il obtient la bonne architecture, livre le mobilier de conformité, coûte un quart par point d'ingénierie, et les poids sont ouverts sous une licence MIT modifiée si vous avez besoin de self-hosting. Budgétez les boucles de reconstruction sur votre calendrier, pas seulement sur votre carte. Mon avis plus complet sur où il tient et où il ne tient pas est dans la review de Kimi K3.
Utilisez GPT-5.6 Sol pour la vitesse-vers-quelque-chose. Quarante-huit minutes et une exécution stable est véritablement utile quand vous avez besoin d'un artéfact fonctionnel devant un stakeholder avant le déjeuner. Ne confondez pas l'artéfact avec une fondation — un 1 en fonctionnalité signifie que vous démontrez une idée, pas que vous démarrez une base de code.
Ou divisez le travail. L'option la plus intéressante que ces données suggèrent n'est pas d'en choisir un. Laissez Kimi K3 ou Sol produire le build structurel à bas coût, puis passez le résultat à Fable 5 pour une passe de design et d'utilisabilité sur la couche de surface uniquement. Vous paieriez le tarif de Fable sur une fraction des tokens. Je n'ai vu personne publier de chiffres propres sur cet hybride, et c'est l'expérience que j'aimerais le plus voir réalisée. La même logique de division est apparue quand j'ai regardé comment ces modèles divergent sur le travail créatif — le gagnant change avec la tâche, alors arrêtez d'en chercher un seul.
Ce Que Cette Exécution Ne Prouve Pas
Taille d'échantillon un. Par modèle. Sur une catégorie d'app.
Je vous rendrais un mauvais service en présentant ça comme un benchmark, alors laissez-moi nommer les limites spécifiques.
Une seule exécution ne peut pas séparer la capacité du modèle de la chance du prompt. Refaites le même brief trois fois par modèle et vous verriez presque certainement les scores bouger — peut-être beaucoup, vu combien de l'axe design est un jugement subjectif. Les boucles de reconstruction de Kimi en particulier pourraient être une propriété du modèle, ou un mauvais seed un après-midi. Une exécution ne peut pas vous dire lequel.
La rubrique pèse lourdement le design et ne publie jamais ses plafonds par axe, c'est pourquoi j'ai recalculé sur les axes d'ingénierie plutôt que de faire confiance aux totaux. Et un compteur de calories avec trois intégrations SDK bien documentées est proche d'un cas idéal pour la génération à prompt unique — catégorie bien battue, données d'entraînement abondantes, parties difficiles externalisées à des services. Essayez ça avec un éditeur collaboratif en temps réel ou quoi que ce soit avec une gestion d'état véritablement nouvelle et je m'attendrais à ce que les trois scores s'effondrent.
Ce que l'exécution établit, et ce que des données indépendantes soutiennent, est directionnel et utile : les trois agents de frontière passent maintenant la barre du « est-ce que ça fonctionne du tout » sur mobile, la différenciation s'est déplacée de la fonctionnalité vers la cohérence et le polish, et l'écart de coût entre eux est à la fois grand et suffisamment prévisible pour planifier autour.
C'est un monde différent de celui d'il y a douze mois, quand la question était de savoir si quelque chose compilait.
Le Chiffre Qui Reste Avec Moi
Pas les 82,30 $. Pas le score de 17 à 8.
Ce sont 123,43 $ — le total des trois apps — contre quatre heures et huit minutes d'horloge. Trois applications mobiles fonctionnelles, intégrées et prêtes à l'abonnement, avec authentification, paiements, analyse alimentaire basée sur la vision et synchronisation Apple Health, à partir de trois prompts, en une demi-journée de travail, pour moins que le taux horaire du développeur qui était autrefois nécessaire pour en construire une.
Aucune n'est prête à publier aujourd'hui. Chacune a besoin d'un audit de conformité, d'une passe de design et d'un humain qui comprend ce que App Review fera à un paywall avec un lien cassé. L'écart de polish est réel, et c'est exactement là que se trouve le travail restant.
Mais l'écart entre « l'IA a généré quelque chose en forme d'app » et « l'IA a généré quelque chose que vous pourriez finir en un après-midi » s'est comblé pendant que la plupart des gens débattaient encore des tables de benchmarks.
Choisissez le modèle qui correspond à l'axe que vous ne pouvez pas corriger vous-même. Puis allez découvrir combien du reste de l'après-midi est vraiment à vous.
Questions Fréquentes
Quel modèle IA est le meilleur pour construire des apps mobiles en 2026 ?
Claude Fable 5 a produit la meilleure app mobile globale dans ce test à prompt unique, obtenant 17 contre 8 pour GPT-5.6 Sol et Kimi K3, principalement grâce au design et à l'utilisabilité. Kimi K3 a livré la meilleure valeur d'ingénierie à environ 2,87 $ par point de fonctionnalité et fidélité des features natives. Voir l'analyse d'allocation ci-dessus.
Pourquoi Claude Fable 5 est-il tellement plus cher que Kimi K3 ?
Fable 5 est tarifé à 10 $/50 $ par million de tokens entrée/sortie contre 3 $/15 $ pour Kimi K3 — une différence de tarif de 3,33x. L'écart réel de facture était de 4,79x parce que Fable consomme aussi environ 40-45 % de volume de tokens en plus sur la même tâche. Les données indépendantes de coût par tâche de DeepSWE montrent un multiple presque identique de 4,65x.
Les agents de code IA peuvent-ils construire une app complète à partir d'un prompt ?
Oui, avec une réserve importante sur les intégrations. Les trois agents ont produit des compteurs de calories fonctionnels avec journal des repas, synchronisation Apple Health et notifications à partir d'un seul prompt — mais seulement parce que l'auth, les paiements et la vision ont été délégués à Clerk, RevenueCat et l'API Gemini plutôt que construits de zéro.
Kimi K3 bat-il Fable 5 en programmation ?
Sur les benchmarks publiés, parfois. Kimi K3 mène la Frontend Code Arena avec 1 679 contre 1 631 pour Fable 5 et domine Program Bench à 77,8. Sur ce build d'app complet il a obtenu 2 en design contre le 9 de Fable — ces benchmarks mesurent la qualité de code isolée, pas la cohérence maintenue sur toute une surface de produit.
Qu'est-ce qui fait qu'une app générée par IA est rejetée de l'App Store ?
Les liens manquants vers la politique de confidentialité et les conditions d'utilisation sur le paywall d'abonnement sont parmi les échecs les plus courants, sous la App Store Review Guideline 3.1.2. Les examinateurs doivent pouvoir appuyer sur un lien visible à l'intérieur de l'app en cours d'exécution et ouvrir le document immédiatement. Vérifiez l'audit paywall en cinq points ci-dessus avant de soumettre.
Travaillons Ensemble
Vous cherchez à construire des systèmes IA, automatiser des workflows ou faire évoluer votre infrastructure technologique ? J'adorerais vous aider.
- Fiverr (builds sur mesure et intégrations) : fiverr.com/s/EgxYmWD
- Portfolio : mejba.me
- Ramlit Limited (solutions entreprise) : ramlit.com
- ColorPark (design et branding) : colorpark.io
- xCyberSecurity (services de sécurité) : xcybersecurity.io