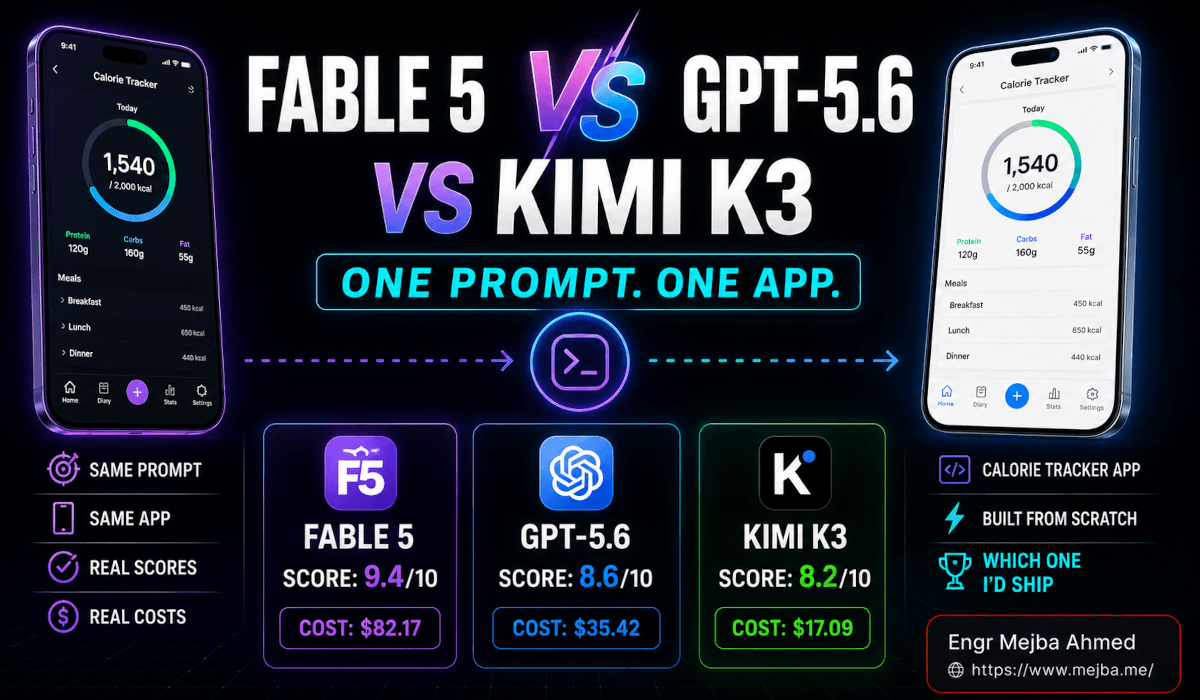
$82,30. Eso es lo que uno de estos agentes cobró por construir una app de seguimiento de calorías desde un solo prompt. El más barato de los tres hizo el mismo trabajo por $17,20 — una diferencia de 4,8x en trabajo idéntico, entregado la misma tarde.
Aquí está la respuesta corta para cualquiera que esté evaluando Fable 5 vs GPT-5.6 vs Kimi K3 en trabajo real de construcción de apps en vez de tablas de clasificación: los tres entregaron un contador de calorías funcional desde un prompt con cero revisiones. Fable 5 ganó la puntuación combinada 17 contra 8 contra 8, casi enteramente por pulido de diseño y usabilidad. GPT-5.6 Sol terminó más rápido en 48 minutos y costó $23,93, pero produjo la app más delgada de las tres. Kimi K3 fue el más lento con 1 hora 54 minutos, costó menos, y — a pesar de la interfaz más fea del grupo — fue el único que entregó un paywall que Apple no rechazaría.
Esa última oración es la que vale la pena considerar, y explicaré por qué.
De Quién Son Estos Recibos
No ejecuté este build. Permítanme decirlo de entrada, porque internet está ahogado en teatro de benchmarks en primera persona y prefiero ser el tipo que desmonta resultados que el que pretende haberlos ejecutado.
El experimento surgió de una comparación en vivo: tres agentes de código insignia, un prompt idéntico, una app móvil completa de seguimiento de calorías, sin correcciones posteriores permitidas. Las apps fueron puntuadas en cuatro ejes — velocidad de desarrollo, funcionalidad, diseño de UI y fidelidad de features nativas móviles — con totales de factura reales asociados a cada ejecución.
Lo que sí hice fue verificar cada afirmación externa contra fuentes publicadas, porque una sola ejecución por modelo es una anécdota hasta que algo independiente corrobore el mecanismo. Dos cosas corroboran esta inusualmente bien, y mostraré ambas.
Primero, algo de limpieza de nombres, ya que la transcripción fuente deformó dos de los tres:
- GPT-5.6 Sol, no "Soul." El nivel insignia de OpenAI en la familia GPT-5.6, anunciado el 26 de junio de 2026, por encima de Terra y Luna.
- Kimi K3, no "Kimik A3." El modelo de mezcla de expertos de 2,8 billones de parámetros de Moonshot AI, anunciado el 16 de julio de 2026 con pesos abiertos el 27 de julio bajo una licencia MIT modificada. Activa aproximadamente 104 mil millones de parámetros por token y tiene una ventana de contexto de 1M tokens.
- Claude Fable 5 es el único que la transcripción acertó.
Ahora la tabla de resultados, exactamente como fue registrada.
| Modelo | Tiempo | Funcionalidad | Diseño | Features nativas | Total | Costo (USD) |
|---|---|---|---|---|---|---|
| Claude Fable 5 | 1h 26m | 4 | 9 | 4 | 17 | $82,30 |
| GPT-5.6 Sol | 48m | 1 | 5 | 2 | 8 | $23,93 |
| Kimi K3 | 1h 54m | 2 | 2 | 4 | 8 | $17,20 |
Tres apps. Cuatro horas y ocho minutos de tiempo total. $123,43 en total.
Lee la columna de totales y la historia parece resuelta: Fable 5 duplicó al campo. Lee los ejes individuales y la historia se desmorona — que es exactamente la parte sobre la que nadie que cubre estos modelos está escribiendo.
Fable 5 vs GPT-5.6 vs Kimi K3: La Paradoja del Benchmark
Antes de este build, si hubieras preguntado a las tablas de clasificación publicadas cuál de estos tres escribe el mejor código frontend, la respuesta habría sido Kimi K3. Ni siquiera cerca.
Kimi K3 debutó en el número uno de la Frontend Code Arena de Arena.ai con 1.679 puntos, por delante de Claude Fable 5 con 1.631 y GPT-5.6 Sol con 1.618. También lidera Program Bench con 77,8, superando por poco a GPT-5.6 Sol con 77,6 y Fable 5 con 76,8. En Terminal Bench 2.1 obtiene 88,3 contra los 88,8 de Sol, superando tanto a Fable 5 como a Opus 4.8, que empatan en 84,6. En el amplio Artificial Analysis Intelligence Index los tres se agrupan en 60, 59 y 57 — una diferencia de tres puntos a lo largo de toda la frontera.
Luego Kimi K3 construyó esta app y obtuvo 2 de un posible 9-plus en diseño.
Radios de borde inconsistentes. Pantallas desordenadas. El tipo de interfaz que hace que un usuario cierre la app antes de registrar su primera comida. El modelo que era, por medición, el mejor codificador frontend del mundo produjo el producto peor presentado de la sala.
Esa contradicción no es un error de puntuación. Es el hallazgo más útil de toda la ejecución, y se reduce a lo que esos benchmarks realmente miden.
Frontend Code Arena puntúa generaciones aisladas, juzgadas por humanos — un componente, una página, un fragmento autocontenido, evaluado por sus propios méritos con la tarea completamente especificada. Program Bench y Terminal Bench puntúan corrección contra tests y resultados de terminal. Cada una de esas tareas le da al modelo un problema acotado con una respuesta verificable.
Un contador de calorías construido desde un prompt es una clase de tarea completamente diferente. El agente tiene que inventar un sistema de diseño que nadie especificó, luego mantenerlo consistente a lo largo de un flujo de onboarding, una pantalla de registro, una ruta de captura de cámara, una vista de historial, un panel de configuración y un paywall — todo mientras conecta tres SDKs de terceros y no se contradice treinta archivos después. Nada prueba eso. No hay benchmark para coherencia mantenida a lo largo de una superficie no especificada durante noventa minutos de trabajo autónomo.
Fable 5 es inusualmente bueno en eso específico. Siempre lo ha sido — hice la misma observación cuando miré cómo Fable 5 y Opus 5 se dividen en nueve tareas reales de trabajo del conocimiento, donde Fable perdió decisivamente en encontrar bugs y ganó igual de decisivamente en todo lo que tenía una superficie de diseño. Mismo patrón, diferente batería de tareas, y ahora confirmado en móvil.
La regla de trabajo que surge de esto: los benchmarks de frontend predicen calidad de fragmentos, no coherencia de producto. Trátalos como midiendo habilidades diferentes, porque eso hacen.
Lo que plantea la pregunta obvia — ¿cuánto de la victoria aplastante de Fable es realmente diseño?
Elimina el Diseño y la Clasificación Se Invierte
Mira la forma de la rúbrica antes de confiar en sus totales. A lo largo de tres modelos y cuatro ejes, exactamente una puntuación supera 4, y es el 9 de Fable en diseño. Cada otra celda en la tabla está entre 1 y 4. El diseño corre en una escala visiblemente más amplia que los otros ejes, lo que significa que lleva un peso desproporcionado en la columna total.
Así que recalculé los totales en los dos ejes que un desarrollador no puede arreglar en una tarde — funcionalidad y fidelidad de features nativas. Puedes rediseñar una app. No puedes retrofitear fácilmente un modelo de datos o una ruta de sincronización con HealthKit.
| Modelo | Funcionalidad | Features nativas | Subtotal ingeniería | Costo | Costo por punto de ingeniería |
|---|---|---|---|---|---|
| Claude Fable 5 | 4 | 4 | 8 | $82,30 | $10,29 |
| Kimi K3 | 2 | 4 | 6 | $17,20 | $2,87 |
| GPT-5.6 Sol | 1 | 2 | 3 | $23,93 | $7,98 |
La clasificación cambia completamente.
Kimi K3 pasa de empatado-en-último a un claro segundo, a aproximadamente un cuarto del costo de Fable por punto de ingeniería entregado. GPT-5.6 Sol — el finalizador más rápido, la ejecución estable, el que nunca se cayó — cae al último por un amplio margen, y ni siquiera era el más barato.
Fable aún gana. Debería; 8 vence a 6. Pero "gana por un pelo en ingeniería y por una milla en estética" es una decisión de compra fundamentalmente diferente a "gana 17 a 8." La primera te dice que contrates a Fable para la pasada de pulido. La segunda te dice que lo contrates para todo, y esa sería la lectura equivocada.
Esta es la parte donde las puntuaciones combinadas engañan a la gente. Cualquier compuesto que combine un eje subjetivo y un eje objetivo en un número le entregará silenciosamente el volante al eje subjetivo. Mira las columnas, no la suma.
El costo es donde esto se pone aún más nítido.
Qué Impulsó Realmente la Factura de $82
Tarifas de API publicadas, todas verificadas a principios de agosto de 2026:
| Modelo | Input / 1M tokens | Output / 1M tokens | Input cacheado |
|---|---|---|---|
| Claude Fable 5 | $10,00 | $50,00 | $1,00 |
| GPT-5.6 Sol | $5,00 | $30,00 | $0,50 |
| Kimi K3 | $3,00 | $15,00 | $0,30 |
Fable 5 cuesta 3,33x Kimi K3 por token tanto en entrada como en salida. Pero la proporción de la factura fue 4,79x — $82,30 contra $17,20.
Las tarifas solas no explican eso. Haz la división: 4,79 ÷ 3,33 ≈ 1,44. Fable quemó aproximadamente 40-45% más volumen de tokens que Kimi en el mismo brief. No es solo más caro por token; hace más pensamiento por unidad de salida.
La comparación Fable versus Sol cae de la misma manera. Sol es la mitad del precio de entrada de Fable y el 60% de su precio de salida, así que una brecha puramente impulsada por tarifas caería alrededor de 1,7-2x. La brecha real fue 3,44x. Más tokens otra vez.
Ahora la corroboración que mencioné antes, y es buena. Artificial Analysis publica costo promedio por tarea en DeepSWE: $21,63 para Fable 5, $8,39 para GPT-5.6 Sol, $4,65 para Kimi K3. Fable-a-Kimi en ese benchmark de código agéntico independiente y completamente no relacionado resulta en 4,65x. Este build de app produjo 4,79x.
Dos evaluaciones, diferentes tipos de tarea, diferentes evaluadores, mismo múltiplo de costo dentro del 3%. Eso no es coincidencia — es una propiedad estable de cómo estos modelos gastan tokens, y significa que puedes presupuestar en consecuencia. Si Kimi K3 te cuesta X en un build agéntico, planifica aproximadamente 4,5-5x ese número si le das el mismo trabajo a Fable 5.
La imagen por minuto es interesante por sí misma. Fable corrió a aproximadamente $0,96 por minuto de reloj, Sol a $0,50, Kimi a $0,15. Si eres el tipo de persona que deja un agente corriendo mientras hace café, esa es una diferencia significativa en lo que una hora sin supervisión te cuesta. Escribí un artículo completo sobre reducir los costos de uso de Fable 5 sin degradar el modelo, y cada técnica aplica doble para builds autónomos largos como este.
Por Qué el Modelo Más Barato Tardó Más
Kimi K3 fue la ejecución más lenta con 1 hora 54 minutos — 33% más largo que Fable, 138% más largo que Sol — y fue lento por una razón poco glamorosa. Encontró errores y reconstruyó. Múltiples veces.
Eso merece más atención de la que usualmente recibe, porque los ciclos de reconstrucción son donde el argumento del precio-por-token muere silenciosamente para muchos equipos.
Kimi aún salió más barato aquí, así que los ciclos no borraron su ventaja de costo en esta ejecución. Pero consumieron 28 minutos extra frente a Fable y 66 frente a Sol. Si eres una agencia que factura ese tiempo, o un constructor individual con tres horas entre llamadas de clientes, el modelo que te ahorró $65 acaba de tomar el espacio más largo de tu calendario. Tokens baratos y horas baratas no son la misma moneda, y solo una de ellas aparece en la factura.
El lado opuesto es que la ejecución de 48 minutos de Sol fue estable y limpia, y produjo la app menos completa del grupo. Velocidad sin nada que mostrar es su propio tipo de caro. Hay una versión de este compromiso donde la ejecución rápida, barata y estable es la respuesta correcta — prototipos, demos desechables, probar un concepto antes de comprometer presupuesto real — y una versión donde desperdicia toda la tarde porque tienes que construirlo de nuevo correctamente.
Tres modelos, tres modos de fallo distintos: Fable quema dinero, Kimi quema reloj, Sol quema alcance. Elige tu veneno según cuál puedes absorber esta semana.
Las Integraciones Son Por Qué Esto Funcionó
Deja la comparación de modelos un segundo, porque la configuración merece crédito que usualmente se le da a los agentes.
El prompt especificó tres servicios de terceros:
- Clerk para autenticación
- RevenueCat para gestión de suscripciones y paywalls
- Gemini API para análisis de calorías basado en imágenes
Ninguno de los agentes construyó auth. Ninguno construyó una capa de pagos. Ninguno entrenó un modelo de visión para mirar un plato de comida y estimar macros. Conectaron SDKs.
Esa es la verdadera clave detrás de las apps de un solo prompt, y es un punto arquitectónico, no de modelo. Pídele a cualquiera de estos tres agentes que construya manualmente gestión de sesiones, validación de recibos en dos app stores y un pipeline de reconocimiento de alimentos, y obtendrás noventa minutos de código seguro e inservible. Dales un brief donde las partes difíciles, sensibles a la seguridad y cercanas a la regulación ya están resueltas por servicios con SDKs bien documentados, y rinden como ingenieros competentes de nivel medio.
La lección se generaliza mucho más allá de contadores de calorías. La palanca más grande en la calidad de builds de un solo prompt no es qué modelo eliges — es cuánto del problema ya has quitado del plato del modelo antes de que empiece. Me topé exactamente con esta restricción cuando construí una app móvil de nicho con Claude Code y React Native en un fin de semana: cada hora que ahorré vino de un servicio que no le pedí al agente que reinventara.
Si prefieres dejar la arquitectura de integración a alguien que ya ha mapeado qué servicios son seguros para delegar a un agente y cuáles absolutamente no, eso es gran parte de lo que hago en builds personalizados — fiverr.com/s/EgxYmWD.
Ahora el eje que separa una app real de un sitio web disfrazado.
¿Qué Prueban Realmente las Features Nativas en una App Construida con IA?
La fidelidad de features nativas es el eje que te dice si obtuviste una app móvil o una página web vestida de una. En este build cubrió sincronización con Apple Health, notificaciones push, navegación nativa con bottom tabs, live activities y widgets.
Puntuaciones: Fable 5 y Kimi K3 empataron en 4. GPT-5.6 Sol logró 2.
El registro de comidas, la integración con Apple Health y las notificaciones fueron bien manejados por los tres — la línea base es genuinamente sólida ahora, y ese es el hallazgo principal que la gente debería llevarse de esta ejecución. Donde se abrió la brecha fue en el acabado específico de la plataforma: bottom tabs reales versus un div con estilo, live activities que realmente aparecen en la pantalla de bloqueo, widgets que respetan el layout del sistema.
Kimi K3 implementó bottom tabs nativos y elementos de paywall correctamente, lo que explica por qué empató con Fable en este eje mientras obtenía un 2 en estética. Construyó las estructuras correctas y las vistió mal. Eso es, mecánicamente, el problema más fácil de arreglar — un diseñador puede rediseñar una pila de navegación correcta en un día, pero retrofitear navegación nativa en una app que la simula con una vista de scroll significa destrozar el caparazón.
El 2 de Sol es el número que más me preocuparía en producción. Fidelidad nativa débil más un 1 en funcionalidad significa que no estás puliendo una app, estás reescribiéndola.
Lo que me lleva al detalle más prácticamente importante de todo el experimento, y pertenece al modelo que puntuó último en diseño.
El Detalle del Paywall Que Decide Si Lanzas
El paywall de Kimi K3 incluía enlaces prominentes a la política de privacidad y términos de uso.
Eso suena como una nota al pie. Es la diferencia entre lanzar y no lanzar.
La App Store Review Guideline 3.1.2 de Apple requiere que las apps con suscripciones auto-renovables proporcionen enlaces funcionales tanto a la política de privacidad como a los términos de uso (EULA). La pantalla de suscripción dentro de la app debe mostrar el título de la suscripción, su duración y su precio, junto con los términos completos de suscripción auto-renovable. Y los revisores evalúan lo que un usuario puede alcanzar desde dentro de la app en ejecución — si un revisor no puede tocar un enlace visible y abrir el documento inmediatamente, el requisito no se cumple. Los enlaces faltantes bajo 3.1.2 son una de las causas más comunes de rechazo de apps de suscripción, y cada ida y vuelta con App Review cuesta días.
La app más fea de la prueba era la más cercana a pasar la revisión realmente.
Sigo volviendo a eso, porque invierte cómo la mayoría evalúa estos outputs. Juzgamos las apps construidas con IA por la captura de pantalla. App Review las juzga por la fontanería de cumplimiento que nunca aparece en una captura. Una interfaz magnífica de 9-de-9 con un paywall al que le falta el enlace EULA está más lejos del App Store que una desordenada que acertó con el mobiliario legal.
Así que cuando auditas una app generada por IA antes de lanzarla, la lista de verificación que importa no se parece en nada a la que usarías para una revisión de diseño:
- ¿El paywall enlaza a una política de privacidad y términos de uso activos, tocables desde dentro de la app?
- ¿Muestra título de suscripción, período de facturación y precio sin ambigüedad?
- ¿Está presente el texto completo de los términos de suscripción auto-renovable?
- ¿Los enlaces abren documentos que realmente existen en esas URLs?
- ¿Hay una ruta funcional de restaurar compras?
Nada de eso está en la rúbrica de cuatro ejes. Todo eso determina tu lanzamiento.
Fable 5 vs GPT-5.6 vs Kimi K3: Para Qué Usar Cada Uno
Aquí está la asignación que ejecutaría, dado lo que este build muestra y lo que los benchmarks publicados muestran junto a él.
Usa Fable 5 cuando la superficie de diseño es el producto. Apps de consumo, flujos de onboarding, cualquier cosa donde un usuario decide en ocho segundos si conserva la app. Su 9 en diseño, su integración de onboarding, el manejo del teclado, las entradas de calorías editables, las animaciones de gráficos — esos puntos extra son mecánicas de conversión, no decoración. Un mejor flujo de onboarding en una app de suscripción paga un build de $82 en un puñado de conversiones de prueba. Solo entra sabiendo que pagas aproximadamente 4,5-5x la tarifa de Kimi.
Usa Kimi K3 cuando la estructura importa más que la piel. Herramientas internas, superficies de administración, MVPs que de todos modos van hacia una pasada de diseño, y cualquier proyecto donde un diseñador humano hace la capa visual de todas formas. Obtiene la arquitectura correcta, entrega el mobiliario de cumplimiento, cuesta un cuarto por punto de ingeniería, y los pesos son abiertos bajo una licencia MIT modificada si necesitas self-hosting. Presupuesta los ciclos de reconstrucción en tu calendario, no solo en tu tarjeta. Mi visión más completa sobre dónde funciona y dónde no está en la review de Kimi K3.
Usa GPT-5.6 Sol para velocidad-hacia-algo. Cuarenta y ocho minutos y una ejecución estable es genuinamente útil cuando necesitas un artefacto funcional frente a un stakeholder antes del almuerzo. No confundas el artefacto con un cimiento — un 1 en funcionalidad significa que estás demostrando una idea, no empezando una base de código.
O divide el trabajo. La opción más interesante que estos datos sugieren no es elegir uno. Deja que Kimi K3 o Sol produzcan el build estructural barato, luego pasa el resultado a Fable 5 para una pasada de diseño y usabilidad solo en la capa superficial. Pagarías la tarifa de Fable en una fracción de los tokens. No he visto a nadie publicar números limpios sobre ese híbrido, y es el experimento que más me gustaría ver ejecutado. La misma lógica de división apareció cuando miré cómo estos modelos divergen en trabajo creativo — el ganador cambia con la tarea, así que deja de buscar uno solo.
Lo Que Esta Ejecución No Prueba
Tamaño de muestra uno. Por modelo. En una categoría de app.
Te haría un mal servicio presentar eso como un benchmark, así que permíteme nombrar los límites específicos.
Una sola ejecución no puede separar la capacidad del modelo de la suerte del prompt. Repite el mismo brief tres veces por modelo y casi seguro verías moverse las puntuaciones — posiblemente mucho, dado cuánto del eje de diseño es juicio subjetivo. Los ciclos de reconstrucción de Kimi en particular podrían ser una propiedad del modelo, o un mal seed en una tarde. Una ejecución no puede decirte cuál.
La rúbrica pesa el diseño fuertemente y nunca publica sus techos por eje, por lo que recalculé en los ejes de ingeniería en vez de confiar en los totales. Y un contador de calorías con tres integraciones SDK bien documentadas está cerca de un caso ideal para generación de un solo prompt — categoría bien transitada, datos de entrenamiento abundantes, partes difíciles externalizadas a servicios. Prueba esto con un editor colaborativo en tiempo real o cualquier cosa con gestión de estado genuinamente novedosa y esperaría que las tres puntuaciones colapsen.
Lo que la ejecución sí establece, y lo que datos independientes apoyan, es direccional y útil: los tres agentes de frontera ahora pasan la barra de "¿funciona siquiera?" en móvil, la diferenciación se ha movido de funcionalidad a coherencia y pulido, y la diferencia de costos entre ellos es tanto grande como predecible como para planificar en torno a ella.
Ese es un mundo diferente al de hace doce meses, cuando la pregunta era si algo de esto compilaba.
El Número Que Se Queda Conmigo
No los $82,30. No la puntuación 17-a-8.
Son $123,43 — el total de las tres apps — contra cuatro horas y ocho minutos de reloj. Tres aplicaciones móviles funcionales, integradas y listas para suscripción, con autenticación, pagos, análisis de alimentos basado en visión y sincronización con Apple Health, desde tres prompts, en medio día laboral, por menos que la tarifa por hora del desarrollador que antes se requería para construir una de ellas.
Ninguna está lista para publicar hoy. Cada una necesita una auditoría de cumplimiento, una pasada de diseño y un humano que entienda lo que App Review hará con un paywall con un enlace roto. La brecha de pulido es real, y es exactamente donde está el trabajo restante.
Pero la brecha entre "la IA generó algo con forma de app" y "la IA generó algo que podrías terminar en una tarde" se cerró mientras la mayoría seguía discutiendo sobre tablas de benchmarks.
Elige el modelo que coincida con el eje que no puedes arreglar tú mismo. Luego descubre cuánto de la tarde restante es realmente tuya.
Preguntas Frecuentes
¿Cuál es el mejor modelo de IA para construir apps móviles en 2026?
Claude Fable 5 produjo la mejor app móvil general en esta prueba de un solo prompt, puntuando 17 contra 8 tanto para GPT-5.6 Sol como para Kimi K3, impulsado principalmente por diseño y usabilidad. Kimi K3 entregó el mejor valor de ingeniería a aproximadamente $2,87 por punto de funcionalidad y fidelidad de features nativas. Ve el desglose de asignación arriba.
¿Por qué Claude Fable 5 es tanto más caro que Kimi K3?
Fable 5 tiene un precio de $10/$50 por millón de tokens de entrada/salida contra los $3/$15 de Kimi K3 — una diferencia de tarifa de 3,33x. La brecha real de factura fue 4,79x porque Fable también consume aproximadamente 40-45% más volumen de tokens en la misma tarea. Datos independientes de costo por tarea de DeepSWE muestran un múltiplo casi idéntico de 4,65x.
¿Pueden los agentes de código IA construir una app completa desde un prompt?
Sí, con una advertencia significativa sobre integraciones. Los tres agentes produjeron contadores de calorías funcionales con registro de comidas, sincronización con Apple Health y notificaciones desde un solo prompt — pero solo porque auth, pagos y visión fueron delegados a Clerk, RevenueCat y la API de Gemini en vez de construirse desde cero.
¿Kimi K3 supera a Fable 5 en programación?
En benchmarks publicados, a veces. Kimi K3 lidera Frontend Code Arena con 1.679 contra los 1.631 de Fable 5 y encabeza Program Bench con 77,8. En este build de app completa obtuvo 2 en diseño contra el 9 de Fable — esos benchmarks miden calidad de código aislada, no coherencia mantenida a lo largo de toda una superficie de producto.
¿Qué hace que una app generada por IA sea rechazada del App Store?
Los enlaces faltantes a la política de privacidad y términos de uso en el paywall de suscripción están entre los fallos más comunes, bajo la App Store Review Guideline 3.1.2. Los revisores deben poder tocar un enlace visible dentro de la app en ejecución y abrir el documento inmediatamente. Revisa la auditoría de paywall de cinco puntos arriba antes de enviar.
Trabajemos Juntos
¿Buscas construir sistemas de IA, automatizar flujos de trabajo o escalar tu infraestructura tecnológica? Me encantaría ayudar.
- Fiverr (builds personalizados e integraciones): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (soluciones empresariales): ramlit.com
- ColorPark (diseño y branding): colorpark.io
- xCyberSecurity (servicios de seguridad): xcybersecurity.io