Eu estava rolando uma thread de discussão no GitHub às 23h de uma segunda-feira quando alguém postou uma captura de tela que me fez largar o café. Era um trecho do pacote npm do Claude Code — o código-fonte real, não uma maquete — mostrando strings de versão para modelos que ainda não existem. Claude Opus 4.7. Claude Sonnet 4.8. E um tier chamado Capybara que ficava acima de tudo o que a Anthropic já lançou publicamente.
Em poucas horas, aquela captura de tela estava em todo lugar. E em poucos dias, um segundo vazamento — desta vez do próprio sistema de gerenciamento de conteúdo da Anthropic — despejou quase 3.000 documentos não publicados à vista do público, incluindo rascunhos de comparações de benchmarks e notas de arquitetura interna para algo com o codinome Capiara.
Dois vazamentos acidentais em cinco dias. De uma empresa cuja marca inteira é construída sobre segurança e controle cuidadoso. A ironia era tão grossa que dava para cortar com um git revert.
Passei a última semana juntando as peças do que esses vazamentos realmente nos dizem — separando os fatos confirmados da especulação, o sinal genuíno do ruído. Porque enterrada em 500.000 linhas de código-fonte expostas e uma pilha de documentos de marketing em rascunho está uma imagem surpreendentemente clara de para onde a Anthropic está indo. E se você está construindo qualquer coisa sobre a API do Claude agora, precisa entender isso antes de ser lançado.
O que realmente vazou — e como
Dois incidentes separados. Mesma empresa. Mesma semana. Vulnerabilidades diferentes. A linha do tempo importa porque te diz algo sobre a escala do que foi exposto.
Vazamento um: o erro de empacotamento do npm (31 de março de 2026). Uma atualização defeituosa do pacote npm do Claude Code foi lançada com arquivos-fonte que deveriam ter sido removidos antes da publicação. Aproximadamente 500.000 linhas de código em 1.900 arquivos ficaram acessíveis. A comunidade encontrou em minutos. A Anthropic emitiu solicitações de remoção, mas o código já havia sido espelhado, forkado e analisado por desenvolvedores em três continentes.
Dentro daquele código: referências a Opus 4.7 e Sonnet 4.8 como "strings de versão proibidas" no que parece ser um modo de teste interno chamado Undercover Mode. Os modelos não eram executáveis a partir do código vazado — não havia pesos, endpoints ou forma de realmente usá-los. Mas os identificadores de versão confirmaram que existem como builds internos. Isso não é especulação. São literais de string em código de produção.
Vazamento dois: a configuração incorreta do CMS (aproximadamente 1-2 de abril de 2026). Um erro de configuração no sistema de gerenciamento de conteúdo da Anthropic tornou cerca de 3.000 ativos não publicados publicamente acessíveis. De acordo com a cobertura da Fortune, isso aconteceu apenas alguns dias após o incidente do npm. Os documentos expostos incluíam rascunhos de posts de blog, comparações de benchmarks e descrições de arquitetura para uma geração de modelos chamada Mythos — com o nome de tier Capybara (também referenciado como Capiara em alguns documentos internos).
A resposta da Anthropic foi rápida, mas mínima. Eles atribuíram o vazamento do npm a um erro de empacotamento. Bloquearam o CMS. Emitiram remoções. Não confirmaram cronogramas específicos, benchmarks ou planos de lançamento para qualquer modelo não lançado. A posição oficial da empresa em 9 de abril de 2026: Mythos existe, clientes de acesso antecipado estão testando, sem data pública de lançamento.
Essa é a base confirmada. Tudo o que vou discutir se apoia no que foi encontrado nesses dois conjuntos de dados.
Decodificando a convenção de nomes: Mythos, Capybara, Capiara, Opus 4.7
A situação dos nomes confundiu quase todas as análises iniciais que li. Deixa eu desembaraçar isso, porque a distinção entre esses termos revela como a Anthropic pensa sobre seu roadmap de produto.
Mythos é um nome de geração. Pensa em como a Apple usa "iPhone 16" — é a família do produto. Mythos representa a próxima geração de modelos Claude, sucedendo a atual família Claude 4.x.
Capybara é um nome de tier. A Anthropic atualmente tem três tiers: Haiku (rápido e barato), Sonnet (equilibrado) e Opus (poderoso e caro). Capybara seria um quarto tier — posicionado acima do Opus. Maior, mais capaz e significativamente mais caro. Esta é a primeira vez que vemos evidências de que a Anthropic está expandindo além de três tiers.
Capiara aparece em alguns documentos vazados como uma grafia alternativa ou codinome — possivelmente um nome interno inicial antes de Capybara ser formalizado. Se é um erro de digitação, um codinome para uma variante específica do Capybara ou um projeto interno distinto, não fica claro nos materiais vazados.
Opus 4.7 é uma versão dentro do tier Opus da geração atual. Seria o próximo lançamento Opus depois do 4.6, seguindo o padrão do Opus 4.5 (novembro de 2025) e Opus 4.6 (fevereiro de 2026).
Isto é o que significa na prática: Opus 4.7 e Capybara/Mythos são provavelmente coisas diferentes. Opus 4.7 é a próxima atualização incremental do Opus — ainda dentro da família Claude 4.x. Capybara/Mythos é um tier totalmente novo, potencialmente representando um salto geracional. O código vazado fazia referência a ambos, o que significa que a Anthropic está trabalhando em pelo menos duas atualizações de modelo não lançadas simultaneamente.
Esse é um sinal significativo de alocação de recursos. A Anthropic não está apenas iterando sobre a arquitetura atual — eles estão construindo uma nova categoria acima dela enquanto continuam a melhorar a linha existente. A estratégia de dois trilhos espelha o que vimos com OpenAI e seus modelos de raciocínio da série o rodando ao lado dos lançamentos do GPT, mas a abordagem da Anthropic a formaliza como um tier permanente em vez de uma linha de produto paralela.
O que os benchmarks sugerem — com um grande asterisco
Preciso ser cuidadoso aqui, porque nenhum dos números de benchmark dos vazamentos foi verificado de forma independente. A Anthropic não os confirmou. Os documentos vazados são rascunhos — não resultados publicados. Trate tudo nesta seção como "alegações vazadas", não como desempenho comprovado.
Com esse aviso firmemente estabelecido: os números são notáveis.
Os documentos de rascunho vazados afirmam que o Opus 4.7 superará o Opus 4.6 por "grandes margens" em raciocínio de múltiplas etapas, compreensão de código complexa, depuração e tarefas de planejamento. Nenhum percentual específico foi incluído nos documentos que foram analisados publicamente, mas a linguagem é mais forte do que o material interno de rascunho típico. Engenheiros da Anthropic não jogam casualmente "grandes margens" em documentos que esperam que seus chefes leiam.
Para contexto sobre o que o Opus 4.6 já alcança: ele pontua 80,8% no SWE-bench Verified, tornando-o um dos principais modelos de codificação disponíveis. Pontuou 65,4% no SE-bench (um benchmark de engenharia de software diferente, mais difícil). Está em 91,3% no GPQA Diamond para raciocínio científico. Esses são números de classe frontier.
Se o Opus 4.7 melhorar esses números por "grandes margens", estamos olhando para um modelo que poderia empurrar o SWE-bench Verified além dos 85% — território que era considerado próximo do teto seis meses atrás. Em raciocínio matemático e científico, os documentos vazados sugerem que o Opus 4.7 competirá no ou acima do nível do Gemini 3, que pontuou 1501 ELO no LM Arena e mostrou uma melhoria de 41% no ARC-AGI-2.
A alegação sobre codificação é a que acho mais crível, e aqui está o porquê. A Anthropic está em uma sequência com benchmarks de codificação. O Opus 4.6 saltou à frente da pontuação de 54,6% do GPT-4.1 no SE-bench com seus 65,4%. A prévia do Mythos — que é o tier Capybara, não o Opus 4.7 — já atingiu 93,9% no SWE-bench Verified. Se o tier Capybara está atingindo 93,9%, é totalmente plausível que o Opus 4.7 — um modelo menos poderoso do mesmo pipeline de pesquisa — fique em algum lugar significativamente acima do Opus 4.6 mas abaixo do Capybara.
Minha previsão aproximada, e isso é pura especulação baseada no padrão: Opus 4.7 SWE-bench Verified na faixa de 85-90%, com SE-bench potencialmente quebrando 75%. Se esses números se mantiverem, isso tornaria o Opus 4.7 o segundo modelo de codificação mais capaz que a Anthropic já testou — atrás apenas do tier restrito Capybara/Mythos.
Mas aqui está o asterisco sobre o asterisco. Benchmarks não são desempenho no mundo real. Testei o Opus 4.6 extensivamente em tarefas reais de codificação — construindo jogos, produzindo podcasts, gerando apresentações — e a experiência no mundo real frequentemente diverge das pontuações de benchmark. Um modelo que pontua 5% mais alto no SWE-bench pode parecer idêntico no uso diário. Ou pode ser dramaticamente melhor nas tarefas específicas que esse benchmark não mede bem, como planejamento de longo prazo ou decisões arquiteturais. Até que eu possa realmente usar o Opus 4.7, os benchmarks são pontos de dados interessantes, não conclusões.
A arquitetura por baixo do capô
Os documentos vazados descrevem a arquitetura do Opus 4.7 como um transformer decodificador denso — sem mistura esparsa de especialistas (MoE). Essa é a mesma abordagem fundamental do Opus 4.6, e é uma escolha filosófica deliberada que diferencia o Claude de modelos como o GLM-5.1 (que usa MoE com 754 bilhões de parâmetros, mas ativa apenas uma fração na inferência).
Transformers densos usam todos os seus parâmetros para cada token que processam. Modelos MoE roteiam diferentes entradas através de diferentes sub-redes "especialistas", ativando apenas um subconjunto dos parâmetros totais. O trade-off é direto: modelos densos são computacionalmente mais caros por token, mas tendem a produzir qualidade de raciocínio mais consistente. Modelos MoE são mais baratos de rodar, mas podem ser irregulares — brilhantes em algumas entradas, medíocres em outras.
A aposta da Anthropic na arquitetura densa diz algo sobre suas prioridades. Estão otimizando para confiabilidade e profundidade em vez de custo de inferência. Quando você cobra US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída (preços do Opus 4.6), você pode se dar ao luxo de rodar um modelo mais pesado porque o ponto de preço sustenta a computação. O preço premium subsidia a arquitetura premium.
O número de parâmetros não foi divulgado oficialmente para nenhum modelo Claude — a Anthropic tem sido mais reservada sobre isso do que quase qualquer outro laboratório. Estimativas de analistas para o Opus 4.6 ficam na faixa de "centenas de bilhões". O Opus 4.7, de acordo com os rascunhos vazados, é "ainda maior". Se isso significa 10% maior ou 3x maior, é desconhecido.
O que acho mais interessante do que a contagem bruta de parâmetros é a descrição dos dados de treinamento. Os vazamentos fazem referência ao treinamento com "trilhões de tokens de texto da internet, código, livros e datasets licenciados". A parte "datasets licenciados" é significativa — sugere que a Anthropic expandiu seus acordos de licenciamento de dados, potencialmente dando ao Opus 4.7 acesso a texto e código proprietário de alta qualidade que concorrentes treinando principalmente em raspagens da web não têm. A qualidade dos dados muitas vezes tem mais impacto do que o tamanho do modelo, e a Anthropic tem sido agressiva em garantir parcerias exclusivas de dados.
Espera-se que a janela de contexto mantenha ou exceda a capacidade de 1 milhão de tokens introduzida com o Opus 4.6. Dado que tanto o GPT-4.1 quanto o Gemini 3 já suportam 1 milhão de tokens, cair abaixo desse limite seria uma regressão competitiva que a Anthropic não pode pagar.
A cadência de lançamento conta uma história
Afaste-se dos detalhes técnicos e olhe para a linha do tempo de lançamentos:
- Opus 4.5: novembro de 2025
- Opus 4.6: fevereiro de 2026 (3 meses depois)
- Opus 4.7 (esperado): meados a final de 2026 (4-6 meses depois)
A cadência está acelerando em capacidade enquanto se estende ligeiramente na linha do tempo. Do Opus 4.5 para o 4.6 houve uma lacuna de 3 meses e introduziu a janela de contexto de 1 milhão de tokens — uma mudança arquitetural massiva. Se o Opus 4.7 demorar 4-6 meses, é porque o escopo da atualização é maior, não porque a Anthropic está desacelerando.
O CEO da Anthropic confirmou testes iniciais com clientes selecionados e descreveu os resultados como um "step change" no desempenho de raciocínio e codificação. Essa linguagem — step change — é específica e deliberada. Significa que a melhoria não é incremental. Algo fundamental mudou no treinamento ou na arquitetura que produz saídas qualitativamente diferentes.
Já vi linguagem de "step change" de laboratórios de IA antes. Às vezes é marketing. Mas a Anthropic tem sido historicamente conservadora com alegações — é mais provável que prometam menos e entreguem mais do que o contrário. Quando Dario Amodei diz "step change", levo a sério.
O padrão de implantação controlada também conta uma história. O Opus 4.6 foi lançado com amplo acesso à API no primeiro dia. Os documentos vazados sugerem que o Opus 4.7 seguirá um lançamento mais cauteloso — primeiro acesso antecipado para equipes de segurança e parceiros selecionados, disponibilidade mais ampla da API depois. Isso espelha o que aconteceu com o Mythos/Capybara, que em abril de 2026 ainda está restrito a um pequeno grupo de clientes de acesso antecipado escolhidos pela Anthropic.
Por que a cautela? Duas possibilidades. Primeiro, o modelo é poderoso o suficiente para que a Anthropic queira que pesquisadores de segurança o submetam a testes de estresse antes do acesso público — a mesma razão por trás da implantação restrita do Mythos no Projeto Glasswing. Segundo, a Anthropic está gerenciando a capacidade de computação. Um modelo maior e mais denso requer mais tempo de GPU por solicitação. Controlar o acesso permite que eles escalem a infraestrutura antes de abrir as comportas.
Minha aposta é em ambos os fatores simultaneamente.
Segurança no ASL-3: o que realmente significa para você
A Anthropic opera seus modelos frontier sob o AI Safety Level 3 (ASL-3) — seu padrão interno de segurança mais alto. Esse framework foi ativado junto com a família Claude 4 e cobre categorias específicas de risco: desenvolvimento de armas químicas, biológicas, radiológicas e nucleares (CBRN); operações cibernéticas autônomas; e autorreplicação de modelos.
Para o Opus 4.7, ASL-3 significa várias coisas concretas:
Maior teste de red-team antes do lançamento. Cada modelo Claude frontier passa por testes adversariais onde equipes tentam ativamente fazê-lo realizar coisas perigosas — sintetizar instruções de bioarmas, escrever código de exploit para infraestrutura crítica, planejar ações autônomas fora de sua sandbox. O Opus 4.6 passou nesses testes com algumas preocupações de caso extremo sinalizadas, mas nenhum risco novo importante identificado. O Opus 4.7 enfrentará um escrutínio mais rigoroso porque é mais capaz.
Tiers de implantação controlados. Nem todos obtêm acesso ao mesmo tempo. Primeiro equipes de segurança e parceiros confiáveis. Depois acesso mais amplo para desenvolvedores. Acesso ao consumidor por último. Este é um padrão deliberado que a Anthropic vem refinando — e espera-se que o lançamento do Opus 4.7 o formalize mais do que qualquer lançamento anterior.
Monitoramento contínuo pós-implantação. ASL-3 não governa apenas o lançamento. A Anthropic monitora comportamentos emergentes após a implantação — padrões de uso indevido, descobertas inesperadas de capacidade ou desvios de alinhamento que só aparecem em escala. Eles se comprometeram a publicar relatórios de risco, como o que lançaram para o Mythos em abril de 2026.
Em fevereiro de 2026, a Anthropic atualizou sua Responsible Scaling Policy para a versão 3.0, que exige a publicação de Frontier Safety Roadmaps com metas detalhadas de segurança e Risk Reports que quantificam o risco em todos os modelos implantados. O Opus 4.7 será o primeiro lançamento Opus de tier padrão sob esses requisitos de divulgação expandidos.
Aqui está minha opinião honesta sobre o que ASL-3 significa praticamente para desenvolvedores. Se você está construindo aplicações padrão — chatbots, assistentes de código, ferramentas de conteúdo, pipelines de análise de dados — ASL-3 não afetará sua experiência diária com o modelo. As medidas de segurança são principalmente voltadas para prevenir uso indevido catastrófico, não para limitar fluxos de trabalho rotineiros de desenvolvedores. Você não notará as proteções na operação normal.
Onde você pode notá-las: se está construindo ferramentas de segurança, agentes autônomos com acesso à rede ou sistemas que interagem com infraestrutura física. Os limites do que o Claude fará e não fará nesses domínios são mais rígidos do que os dos concorrentes, e ficarão mais rígidos com o Opus 4.7. Se isso é uma feature ou uma limitação depende inteiramente do que você está construindo.
Onde o Opus 4.7 se encaixa na guerra competitiva
O cenário de modelos de IA em abril de 2026 é o mais lotado e competitivo que já foi. O Opus 4.7 não está sendo lançado em um vácuo — está pousando no meio de uma briga de quatro lados.
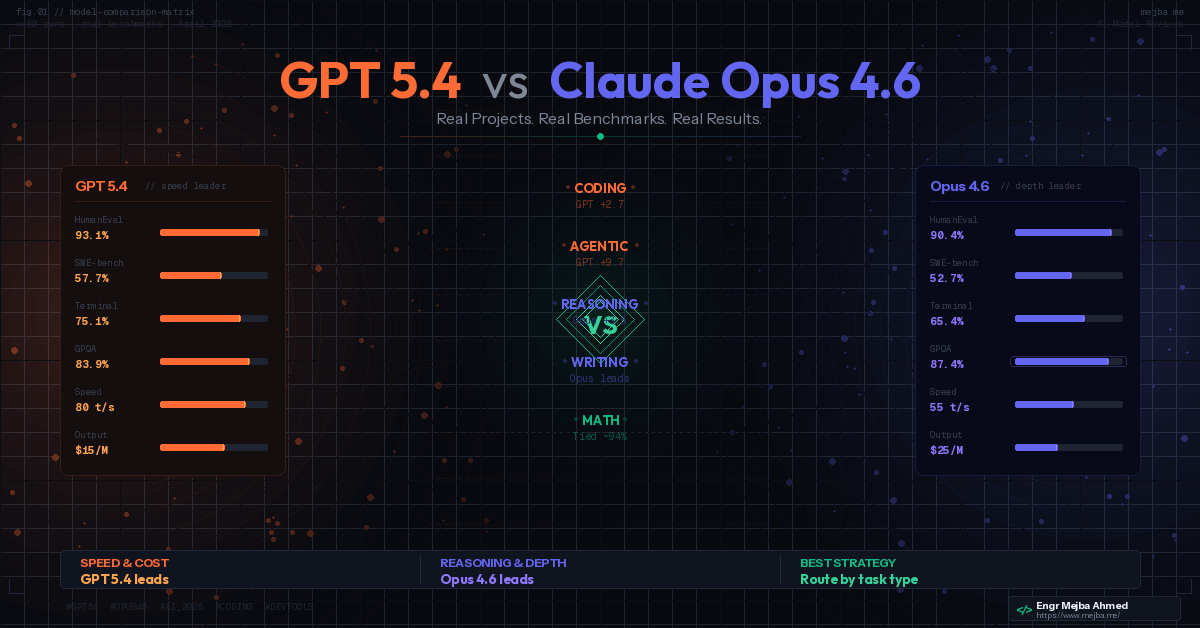
GPT-5.4 da OpenAI lidera em vários benchmarks de codificação, particularmente tarefas envolvendo recursão, tratamento de erros e lógica de casos extremos. Ele pontuou 83% no GDPval (igualando profissionais da indústria em 44 ocupações) e 75% no OSWorld, superando o desempenho humano em tarefas de desktop. A vantagem de ecossistema da OpenAI — base de consumidores do ChatGPT, ampla integração de API, parcerias com a Microsoft — dá ao GPT-5.4 uma distribuição que nenhum outro modelo iguala.
Gemini 3.1 Pro do Google vence em raciocínio abstrato (77,1% no ARC-AGI-2, mais que o dobro da pontuação do Gemini 3 Pro) e raciocínio científico (94,3% no GPQA Diamond, o mais alto de qualquer modelo). Suas capacidades multimodais — vídeo, áudio, raciocínio espacial — ocupam território em que o Claude não compete. E a US$ 2 de entrada / US$ 12 de saída por milhão de tokens, ele subcota significativamente os preços da Anthropic.
Llama 3 (405B) da Meta oferece algo que nenhum dos modelos fechados pode: soberania completa de dados. Código aberto, auto-hospedável, ajustável. Para organizações que não podem enviar dados para APIs externas — saúde, defesa, serviços financeiros — o Llama é frequentemente a única opção, independentemente das pontuações dos benchmarks.
Então onde se encaixa o Opus 4.7?
O fosso do Claude sempre foi a interseção de três coisas: raciocínio profundo de múltiplas etapas, engenharia de software complexa e compreensão massiva de documentos. Se preciso de uma IA para ler uma base de código de 200.000 tokens e sugerir uma refatoração arquitetural, o Claude é minha primeira chamada. Se preciso que ele encadeie uma sessão de depuração em doze arquivos com lógica interdependente, o Claude supera tudo o mais que testei.
O Opus 4.7 parece projetado para alargar esse fosso específico em vez de perseguir concorrentes em seus pontos fortes. Os benchmarks vazados não mencionam compreensão de vídeo, processamento de áudio ou raciocínio espacial — áreas onde o Gemini domina. Não destacam recursos voltados ao consumidor ou integrações de ecossistema — território da OpenAI. Focam implacavelmente em profundidade de raciocínio, qualidade de código e capacidade de planejamento.
Esta é uma escolha estratégica deliberada, e acho que é a certa. Em um mercado onde cada laboratório tenta ser tudo para todos, a Anthropic está apostando que ser definitivamente o melhor em tarefas analíticas e de engenharia complexas é suficiente para construir um negócio massivo. Dado que seus clientes são esmagadoramente desenvolvedores e empresas — não consumidores — essa aposta parece bem calibrada.
O curinga é o preço. Espera-se que o Opus 4.7 custe o mesmo ou mais do que os US$ 5/US$ 25 por milhão de tokens do Opus 4.6. Quando o Gemini 3.1 Pro oferece desempenho de codificação competitivo por menos da metade do preço, a proposta de valor depende inteiramente de se a vantagem de qualidade do Opus 4.7 justifica o premium. Para o meu fluxo de trabalho — codificação agêntica complexa, refatoração de múltiplos arquivos, análise de contexto longo — absolutamente justifica. Perdi mais dinheiro depurando saídas ruins de IA de modelos mais baratos do que já gastei em tokens do Claude.
Mas reconheço que esse não é o cálculo de todos. Se você está rodando tarefas de alto volume e menor complexidade, a diferença de preço importa.
Novas capacidades da API: Chyros e Autodream
Enterradas nos documentos vazados do CMS estavam referências a duas novas capacidades de API com os codinomes Chyros e Autodream. Estas não faziam parte do vazamento de código npm — apareceram no que parecem ser documentos internos de roadmap de produto.
Detalhes são escassos, mas os fragmentos que foram analisados sugerem:
Chyros parece envolver primitivas avançadas de agentes — ferramentas para construir agentes de IA que podem delegar subtarefas, gerenciar seu próprio estado de execução e operar persistentemente entre sessões. Se é isso que parece ser, é uma resposta direta ao florescente ecossistema de agentes. Agora, construir agentes Claude persistentes requer que você costure junto gerenciamento de conversas, chamadas de ferramentas e rastreamento de estado por conta própria. Chyros poderia fornecer essa infraestrutura nativamente.
Venho construindo arquiteturas de enxame de agentes com o Claude há meses, e o maior ponto de dor sempre é o gerenciamento de estado entre sessões. Se a Anthropic lançar memória persistente nativa e delegação de tarefas através da API, isso colapsaria semanas de infraestrutura customizada em chamadas de API. Só isso já justificaria fazer upgrade para o Opus 4.7 para qualquer construtor sério de agentes.
Autodream é ainda mais enigmático. O nome sugere algo relacionado à operação ou planejamento autônomo — possivelmente uma capacidade onde o modelo pode gerar e refinar planos antes de executá-los, semelhante ao pensamento estendido mas aplicado a fluxos de trabalho de agentes de múltiplas etapas em vez de raciocínio de turno único.
Estou especulando bastante aqui. Os fragmentos vazados não dão o suficiente para tirar conclusões firmes. Mas a direção é consistente com tudo o mais que estamos vendo: a Anthropic está construindo em direção a sistemas de IA que podem operar com menos supervisão humana momento a momento. Mythos demonstrou essa capacidade de forma dramática. Chyros e Autodream podem ser as ferramentas voltadas ao desenvolvedor que a tornam acessível e controlável.
O que isso significa para desenvolvedores construindo no Claude agora
Aqui paro de analisar vazamentos e começo a falar sobre o que você realmente deveria fazer com essa informação.
Não espere. Não congele. A pior resposta a um próximo lançamento de modelo é parar de construir. O Opus 4.6 é excelente. Não vai ficar pior quando o 4.7 chegar. Construa no 4.6 agora, e projete seu sistema para trocar modelos com uma única mudança de configuração. Se o seu código está codificado rigidamente para uma versão específica do modelo, isso é um problema independentemente do que for lançado a seguir.
Projete para o salto de janela de contexto. A janela de contexto de 1 milhão de tokens do Opus 4.6 foi um divisor de águas para como construo. O Opus 4.7 vai mantê-la ou excedê-la. Se você não reconstruiu seus fluxos de trabalho em torno de capacidades de contexto longo — alimentando bases de código inteiras, conjuntos completos de documentos, históricos completos de conversas — está deixando a capacidade mais valiosa de lado. Comece agora. As habilidades se transferem diretamente para o que vier a seguir.
Faça orçamento para preços premium. Nada nos vazamentos sugere que o Opus 4.7 será mais barato do que o 4.6. Se algo, os sinais de preços "similares ou mais altos" dos documentos de rascunho sugerem um aumento modesto. Construa seus modelos de custo em torno de US$ 5-7 por milhão de tokens de entrada e US$ 25-30 por milhão de tokens de saída. Se o preço real vier mais baixo, você terá margem. Se vier mais alto, você não será pego desprevenido.
Fique atento ao tier Capybara como um produto separado. Este é o insight dormente dos vazamentos. Se a Anthropic lançar um quarto tier acima do Opus, significa que haverá tarefas onde mesmo o Opus não é a ferramenta certa. O preço do Capybara/Mythos será dramaticamente mais alto — possivelmente US$ 15-25 por milhão de tokens de entrada com base nos custos de tokens relatados para o acesso prévio ao Mythos. Para a maioria dos casos de uso, o Opus continua sendo o ponto ideal. Mas se você está construindo sistemas que precisam do teto absoluto de capacidade de raciocínio — auditoria de segurança, análise legal complexa, pesquisa científica — comece a pensar em como um tier Capybara se encaixa na sua arquitetura.
Leve os limites de segurança a sério. O padrão de implantação controlada não vai embora. Cada lançamento sucessivo do Claude terá mais proteções, mais acesso escalonado, mais monitoramento. Se sua aplicação depende de forçar os limites do que o Claude está disposto a fazer — acesso autônomo à rede, execução de código em ambientes de produção, testes de segurança — construa esses limites explicitamente no design do seu sistema. Não confie no modelo estar disposto. Construa redundância em torno das restrições.
Se você prefere ter alguém construindo essa infraestrutura do zero — a arquitetura de agentes, a camada de troca de modelos, o pipeline de otimização de custos — eu assumo exatamente esse tipo de engajamento. Você pode ver o que construí em fiverr.com/s/EgxYmWD.
A pergunta desconfortável sobre o problema de vazamentos da Anthropic
Não consigo escrever sobre esses vazamentos sem abordar o elefante na sala. A Anthropic — a empresa que se posiciona como o laboratório de IA responsável e focado em segurança — teve duas grandes exposições de dados na mesma semana. Um erro de empacotamento npm que enviou 500.000 linhas de código-fonte. Uma configuração incorreta de CMS que expôs 3.000 documentos internos.
Esses não são ataques sofisticados. São erros operacionais. O tipo de erro que acontece quando a velocidade de envio supera a higiene de segurança.
Não acho que isso prejudique as credenciais de segurança da Anthropic no lado do alinhamento de IA. Segurança do modelo — impedir que o Claude ajude alguém a construir uma bioarma — é uma disciplina fundamentalmente diferente da segurança operacional — impedir que seu próprio código-fonte vaze via npm. Equipes diferentes, processos diferentes, modos de falha diferentes. As pessoas que constroem sistemas de alinhamento RLHF não são as mesmas pessoas que configuram permissões de CMS.
Mas a óptica é brutal. Quando sua promessa de marca é "construímos IA de forma responsável e cuidadosa", dois vazamentos consecutivos abalam a confiança na parte "cuidadosa". Especialmente quando o conteúdo vazado inclui detalhes sobre modelos que poderiam encontrar vulnerabilidades zero-day de forma autônoma. A desconexão entre "somos tão conscientes de segurança que não lançaremos o Mythos publicamente" e "acidentalmente publicamos todo o nosso código-fonte através de um erro de empacotamento" é chocante.
A Anthropic precisa abordar essa lacuna — não apenas com respostas a incidentes e avisos de remoção, mas com uma melhoria visível nas práticas de segurança operacional. O talento técnico claramente está lá. A disciplina de processo, com base nessa evidência, precisa de trabalho.
Para constar, todo grande laboratório de IA teve incidentes similares. O Slack interno da OpenAI foi comprometido em 2024. O Google teve vazamentos relacionados ao Gemini através de seu rastreador de bugs. A velocidade do desenvolvimento de IA cria pressão organizacional que rotineiramente derrota as práticas de segurança padrão. Não é uma desculpa — é contexto.
O que estou observando a seguir
Três sinais me dirão se o vazamento do Opus 4.7 pinta uma imagem precisa:
Sinal um: anúncios de acesso antecipado. Quando a Anthropic começar a dar aos parceiros selecionados acesso ao Opus 4.7 — e vão dar, porque precisam dos dados de teste — as dicas compatíveis com NDA começarão a fluir. Fique atento a desenvolvedores de repente falando sobre "raciocínio melhorado" ou "melhor desempenho em contexto longo" sem nomear o modelo. Esse é o sinal.
Sinal dois: mudanças de preço no line-up atual. Quando a Anthropic está prestes a adicionar um novo tier, eles tipicamente ajustam os preços dos tiers existentes. Se o Opus 4.6 receber um corte de preço nos próximos 2-3 meses, provavelmente significa que o Opus 4.7 (ou Capybara) está prestes a assumir a posição premium. Ajustes de preço do Haiku e Sonnet sinalizariam a mesma coisa.
Sinal três: o relatório da Responsible Scaling Policy. Sob a RSP 3.0, a Anthropic se comprometeu a publicar relatórios de risco para modelos frontier. Quando o relatório de risco do Opus 4.7 for lançado — e será lançado antes ou no lançamento — a lacuna entre os benchmarks de rascunho vazados e os números reais ficará clara.
Minha previsão: o Opus 4.7 chega entre junho e agosto de 2026. As melhorias de codificação serão reais e significativas. Os ganhos de raciocínio serão significativos, mas menos dramáticos do que os vazamentos sugerem. O tier Capybara será lançado separadamente, mais tarde, e a um ponto de preço que fará a maioria dos desenvolvedores piscar. E a corrida de IA continuará acelerando, porque essa é a única direção que conhece.
O código vazado me mostrou strings de versão. Os documentos vazados me mostraram dicas de benchmarks e notas de arquitetura. Mas o que realmente mais me disse sobre o Opus 4.7? Foi a palavra "step change" do CEO da Anthropic. Porque quando uma empresa conhecida por subestimar começa a usar uma linguagem tão forte, o modelo por trás dela geralmente é melhor do que os vazamentos sugerem.
Perguntas frequentes
Quando o Claude Opus 4.7 será lançado?
A Anthropic não confirmou uma data pública de lançamento para o Claude Opus 4.7 em abril de 2026. Com base na cadência de atualização de 3-4 meses (Opus 4.5 em novembro de 2025, Opus 4.6 em fevereiro de 2026), um lançamento de meados a final de 2026 é o mais provável. O acesso antecipado para parceiros selecionados já está em andamento.
Qual é a diferença entre Claude Mythos e Opus 4.7?
Claude Mythos é um nome de geração/produto, enquanto Opus 4.7 é uma versão dentro do tier Opus do Claude 4.x atual. Mythos usa o tier Capybara — um novo quarto tier acima do Opus. Opus 4.7 e Capybara/Mythos são modelos separados em diferentes níveis de capacidade e preço. Para o detalhamento completo, veja a seção de convenção de nomes acima.
Quanto custará o Claude Opus 4.7?
Documentos vazados sugerem preços similares ou superiores aos US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída do Opus 4.6. Otimizações como cache de prompt e execução em lote podem reduzir os custos efetivos. O tier Capybara/Mythos terá preço significativamente mais alto.
O Claude Opus 4.7 é melhor que o GPT-5.4 para codificação?
Benchmarks vazados sugerem que o Opus 4.7 superará significativamente o GPT-4.1 e competirá de perto com o GPT-5.4 em tarefas complexas de engenharia de software. Espera-se que as forças tradicionais do Claude — raciocínio de múltiplas etapas, compreensão de código de contexto longo e depuração — vejam as maiores melhorias. Benchmarks independentes determinarão as classificações finais.
O que foi exposto no vazamento de código-fonte do Claude Code?
Aproximadamente 500.000 linhas de código em 1.900 arquivos foram expostas através de um erro de empacotamento npm em 31 de março de 2026. O código revelou referências ao Opus 4.7 e Sonnet 4.8 como strings de versão internas, junto com detalhes da infraestrutura de testes. Nenhum peso de modelo ou chave de API foi exposto.
Vamos trabalhar juntos
Quer construir sistemas de IA, automatizar fluxos de trabalho ou escalar sua infraestrutura tecnológica? Eu adoraria ajudar.
- Fiverr (builds e integrações personalizadas): fiverr.com/s/EgxYmWD
- Portfólio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io