Ik scrolde op een maandag om 11 uur 's avonds door een GitHub-discussiethread toen iemand een screenshot plaatste waardoor ik mijn koffie neerzette. Het was een fragment uit het npm-pakket van Claude Code — de echte broncode, geen mock-up — met versie-strings voor modellen die nog niet bestaan. Claude Opus 4.7. Claude Sonnet 4.8. En een tier genaamd Capybara die boven alles stond wat Anthropic ooit publiekelijk heeft uitgebracht.
Binnen enkele uren stond die screenshot overal. En binnen enkele dagen dumpte een tweede lek — deze keer uit Anthropics eigen contentmanagementsysteem — bijna 3.000 niet-gepubliceerde documenten op straat, waaronder concept-benchmarkvergelijkingen en interne architectuurnotities voor iets met de codenaam Capiara.
Twee onbedoelde lekken in vijf dagen. Van een bedrijf waarvan het hele merk gebouwd is op veiligheid en zorgvuldige controle. De ironie was zo dik dat je hem met een git revert kon snijden.
Ik heb de afgelopen week besteed aan het in elkaar puzzelen van wat deze lekken ons daadwerkelijk vertellen — de bevestigde feiten scheiden van de speculatie, het echte signaal van de ruis. Want diep in 500.000 regels blootgelegde broncode en een stapel concept-marketingdocumenten schuilt een verrassend helder beeld van waar Anthropic naartoe gaat. En als je op dit moment iets bouwt op Claude's API, moet je dit begrijpen voordat het uitkomt.
Wat er werkelijk gelekt is — en hoe
Twee afzonderlijke incidenten. Hetzelfde bedrijf. Dezelfde week. Verschillende kwetsbaarheden. De tijdlijn is belangrijk omdat die je iets vertelt over de schaal van wat er blootgelegd is.
Lek één: de npm-verpakkingsfout (31 maart 2026). Een foutieve update van het npm-pakket van Claude Code werd uitgebracht met bronbestanden die vóór publicatie verwijderd hadden moeten worden. Ongeveer 500.000 regels code verspreid over 1.900 bestanden kwamen online te staan. De community vond het binnen enkele minuten. Anthropic stuurde takedown-verzoeken, maar de code was al gekopieerd, geforkt en geanalyseerd door ontwikkelaars op drie continenten.
Binnen die code: verwijzingen naar Opus 4.7 en Sonnet 4.8 als 'verboden versie-strings' in wat een interne testmodus lijkt te zijn, Undercover Mode genaamd. De modellen waren niet uitvoerbaar vanuit de gelekte code — er waren geen gewichten, geen endpoints, geen manier om ze daadwerkelijk te gebruiken. Maar de versie-identifiers bevestigden dat ze bestaan als interne builds. Dat is geen speculatie. Het zijn string-literals in productiecode.
Lek twee: de CMS-misconfiguratie (ongeveer 1-2 april 2026). Een configuratiefout in Anthropics contentmanagementsysteem maakte bijna 3.000 niet-gepubliceerde assets publiekelijk toegankelijk. Volgens berichtgeving van Fortune gebeurde dit slechts enkele dagen na het npm-incident. De blootgestelde documenten bevatten concept-blogposts, benchmarkvergelijkingen en architectuurbeschrijvingen voor een modelgeneratie genaamd Mythos — met de tier-naam Capybara (ook wel Capiara genoemd in sommige interne documenten).
Anthropics reactie was snel maar minimaal. Ze schreven het npm-lek toe aan een verpakkingsfout. Ze sloten het CMS af. Ze stuurden takedowns. Ze bevestigden geen specifieke tijdlijnen, benchmarks of releaseplannen voor welk onuitgebracht model dan ook. Het officiële standpunt van het bedrijf per 9 april 2026: Mythos bestaat, early access-klanten testen het, geen publieke lanceringsdatum.
Dat is het bevestigde fundament. Alles wat ik nu ga bespreken, bouwt voort op wat in die twee datasets is gevonden.
De naamgeving ontcijferd: Mythos, Capybara, Capiara, Opus 4.7
De naamgeving bracht bijna elke vroege analyse die ik las in verwarring. Laat me het ontwarren, want het onderscheid tussen deze termen onthult hoe Anthropic denkt over zijn productroadmap.
Mythos is een generatienaam. Zie het zoals Apple 'iPhone 16' gebruikt — het is de productfamilie. Mythos vertegenwoordigt de volgende generatie Claude-modellen, als opvolger van de huidige Claude 4.x-familie.
Capybara is een tier-naam. Anthropic heeft momenteel drie tiers: Haiku (snel en goedkoop), Sonnet (gebalanceerd) en Opus (krachtig en duur). Capybara zou een vierde tier zijn — boven Opus. Groter, capabeler en aanzienlijk duurder. Dit is de eerste keer dat we bewijs zien dat Anthropic uitbreidt voorbij drie tiers.
Capiara verschijnt in sommige gelekte documenten als alternatieve spelling of codenaam — mogelijk een vroege interne naam voordat Capybara werd geformaliseerd. Of het een typefout is, een codenaam voor een specifieke Capybara-variant, of een apart intern project, is niet duidelijk uit het gelekte materiaal.
Opus 4.7 is een versie binnen de Opus-tier van de huidige generatie. Het zou de volgende Opus-release zijn na 4.6, volgens het patroon van Opus 4.5 (november 2025) en Opus 4.6 (februari 2026).
Wat dat in de praktijk betekent: Opus 4.7 en Capybara/Mythos zijn waarschijnlijk verschillende dingen. Opus 4.7 is de volgende incrementele Opus-update — nog steeds binnen de Claude 4.x-familie. Capybara/Mythos is een compleet nieuwe tier, die mogelijk een generatiesprong vertegenwoordigt. De gelekte code verwees naar beide, wat betekent dat Anthropic aan minstens twee onuitgebrachte modelupgrades tegelijk werkt.
Dat is een belangrijk signaal over de toewijzing van middelen. Anthropic itereert niet alleen op de huidige architectuur — ze bouwen een nieuwe categorie erboven terwijl ze de bestaande lijn blijven verbeteren. De tweesporenstrategie weerspiegelt wat we hebben gezien bij OpenAI met hun o-serie redeneermodellen die naast GPT-releases draaien, maar Anthropics aanpak formaliseert het als een permanente tier in plaats van een parallelle productlijn.
Wat de benchmarks suggereren — met een stevig sterretje
Ik moet hier voorzichtig zijn, want geen van de benchmarkcijfers uit de lekken is onafhankelijk geverifieerd. Anthropic heeft ze niet bevestigd. De gelekte documenten zijn concepten — geen gepubliceerde resultaten. Behandel alles in deze sectie als 'gelekte claims', niet als bewezen prestaties.
Met dat voorbehoud stevig op zijn plaats: de cijfers zijn opmerkelijk.
De gelekte conceptdocumenten beweren dat Opus 4.7 beter zal presteren dan Opus 4.6 met 'grote marges' op meerstapsredeneren, complex code-begrip, debugging en planningstaken. Er stonden geen specifieke percentages in de documenten die publiekelijk zijn geanalyseerd, maar de taal is sterker dan typisch intern conceptmateriaal. Anthropic-engineers gooien niet zomaar 'grote marges' rond in documenten waarvan ze verwachten dat hun baas ze zal lezen.
Ter context van wat Opus 4.6 al bereikt: het scoort 80,8% op SWE-bench Verified, waardoor het een van de beste beschikbare codeermodellen is. Het scoorde 65,4% op SE-bench (een andere, zwaardere software engineering-benchmark). Het staat op 91,3% op GPQA Diamond voor wetenschappelijk redeneren. Dit zijn frontier-class cijfers.
Als Opus 4.7 deze verbetert met 'grote marges', kijken we naar een model dat SWE-bench Verified voorbij 85% zou kunnen duwen — een terrein dat zes maanden geleden als bijna het plafond werd beschouwd. Op wiskunde- en wetenschapsredeneren suggereren de gelekte documenten dat Opus 4.7 op of boven het niveau van Gemini 3 zal concurreren, dat 1501 ELO scoorde op LM Arena en een verbetering van 41% op ARC-AGI-2 liet zien.
De codeerclaim vind ik het meest geloofwaardig, en hier is waarom. Anthropic is bezig met een indrukwekkende reeks codeerbenchmarks. Opus 4.6 sprong over de 54,6% SE-bench-score van GPT-4.1 heen met zijn 65,4%. De Mythos-preview — die de Capybara-tier is, niet Opus 4.7 — haalde al 93,9% op SWE-bench Verified. Als de Capybara-tier 93,9% haalt, is het volledig plausibel dat Opus 4.7 — een minder krachtig model uit dezelfde onderzoekspijplijn — ergens beduidend boven Opus 4.6 maar onder Capybara uitkomt.
Mijn ruwe voorspelling, en dit is pure speculatie op basis van het patroon: Opus 4.7 SWE-bench Verified in het bereik van 85-90%, met SE-bench dat mogelijk 75% doorbreekt. Als die cijfers standhouden, zou Opus 4.7 het op één na capabelste codeermodel zijn dat Anthropic ooit heeft getest — alleen achter de beperkte Capybara/Mythos-tier.
Maar hier is het sterretje bij het sterretje. Benchmarks zijn geen prestaties in de echte wereld. Ik heb Opus 4.6 uitgebreid getest op echte codeertaken — games bouwen, podcasts produceren, presentaties genereren — en de ervaring in de echte wereld wijkt vaak af van benchmarkscores. Een model dat 5% hoger scoort op SWE-bench kan in dagelijks gebruik identiek aanvoelen. Of het kan dramatisch beter zijn in de specifieke taken die die benchmark niet goed meet, zoals langetermijnplanning of architectonische beslissingen. Totdat ik Opus 4.7 daadwerkelijk kan gebruiken, zijn de benchmarks interessante datapunten, geen conclusies.
De architectuur onder de motorkap
De gelekte documenten beschrijven de architectuur van Opus 4.7 als een dichte decoder-transformer — geen sparse mixture of experts (MoE). Dit is dezelfde fundamentele aanpak als Opus 4.6, en het is een bewuste filosofische keuze die Claude onderscheidt van modellen als GLM-5.1 (die MoE gebruikt met 754 miljard parameters maar slechts een fractie activeert tijdens inference).
Dense transformers gebruiken al hun parameters voor elk token dat ze verwerken. MoE-modellen routeren verschillende inputs door verschillende 'expert'-subnetwerken, waarbij slechts een subset van de totale parameters wordt geactiveerd. De afweging is eenvoudig: dense modellen zijn computationeel duurder per token, maar produceren doorgaans consistentere redeneerkwaliteit. MoE-modellen zijn goedkoper om te draaien, maar kunnen ongelijkmatig zijn — briljant op sommige inputs, middelmatig op andere.
Anthropics inzet op dense architectuur zegt iets over hun prioriteiten. Ze optimaliseren voor betrouwbaarheid en diepgang boven inference-kosten. Wanneer je $5 per miljoen input-tokens en $25 per miljoen output-tokens rekent (prijzen van Opus 4.6), kun je het je veroorloven om een zwaarder model te draaien omdat het prijspunt de rekenkracht ondersteunt. De premiumprijs subsidieert de premium-architectuur.
Het aantal parameters is voor geen enkel Claude-model officieel bekendgemaakt — Anthropic is hier geheimzinniger over geweest dan vrijwel elk ander lab. Schattingen van analisten voor Opus 4.6 komen uit in het bereik van 'honderden miljarden'. Opus 4.7 is volgens de gelekte concepten 'nog groter'. Of dat 10% groter betekent of 3x groter is onbekend.
Wat ik interessanter vind dan de ruwe parameteromvang, is de beschrijving van de trainingsdata. De lekken verwijzen naar training op 'biljoenen tokens uit internettekst, code, boeken en gelicentieerde datasets'. Het deel 'gelicentieerde datasets' is significant — het suggereert dat Anthropic zijn datalicentieovereenkomsten heeft uitgebreid, waardoor Opus 4.7 mogelijk toegang krijgt tot hoogwaardige propriëtaire tekst en code die concurrenten die voornamelijk op webscrapes trainen niet hebben. Datakwaliteit heeft vaak meer impact dan modelgrootte, en Anthropic is agressief geweest in het veiligstellen van exclusieve datapartnerschappen.
Het contextvenster zal naar verwachting de capaciteit van 1 miljoen tokens behouden of overschrijden, die werd geïntroduceerd met Opus 4.6. Aangezien zowel GPT-4.1 als Gemini 3 al 1 miljoen tokens ondersteunen, zou onder die drempel zakken een concurrentiële regressie zijn die Anthropic zich niet kan veroorloven.
Het releaseritme vertelt een verhaal
Trek je even terug uit de technische details en kijk naar de release-tijdlijn:
- Opus 4.5: november 2025
- Opus 4.6: februari 2026 (3 maanden later)
- Opus 4.7 (verwacht): midden tot eind 2026 (4-6 maanden later)
De cadans versnelt in capaciteit terwijl de tijdlijn iets wordt verlengd. Opus 4.5 naar 4.6 was een kloof van 3 maanden en introduceerde het contextvenster van 1 miljoen tokens — een enorme architectuurverandering. Als Opus 4.7 4-6 maanden duurt, komt dat omdat de omvang van de upgrade groter is, niet omdat Anthropic vertraagt.
De CEO van Anthropic heeft vroege tests met geselecteerde klanten bevestigd en de resultaten beschreven als een 'step change' in redeneer- en codeerprestaties. Die taal — step change — is specifiek en bewust. Het betekent dat de verbetering niet incrementeel is. Er is iets fundamenteels veranderd in de training of architectuur dat kwalitatief andere outputs produceert.
Ik heb 'step change'-taal eerder van AI-labs gehoord. Soms is het marketing. Maar Anthropic is historisch gezien conservatief geweest met claims — ze zijn eerder geneigd om te underpromisen en te overdeliveren dan andersom. Als Dario Amodei 'step change' zegt, neem ik het serieus.
Het patroon van gecontroleerde uitrol vertelt ook een verhaal. Opus 4.6 werd op dag één gelanceerd met brede API-toegang. De gelekte documenten suggereren dat Opus 4.7 een meer voorzichtige release zal volgen — eerst early access voor beveiligingsteams en geselecteerde partners, later bredere API-beschikbaarheid. Dit weerspiegelt wat er met Mythos/Capybara is gebeurd, dat per april 2026 nog steeds beperkt is tot een kleine groep early access-klanten gekozen door Anthropic.
Waarom de voorzichtigheid? Twee mogelijkheden. Ten eerste, het model is krachtig genoeg dat Anthropic wil dat beveiligingsonderzoekers het stress-testen voordat het publiekelijk toegankelijk wordt — dezelfde redenering achter Project Glasswings beperkte implementatie van Mythos. Ten tweede, Anthropic beheert de rekencapaciteit. Een groter, dichter model vereist meer GPU-tijd per verzoek. Toegang beheersen stelt hen in staat om de infrastructuur op te schalen voordat ze de sluizen openen.
Mijn geld zet ik op beide factoren tegelijk.
Veiligheid op ASL-3: wat het daadwerkelijk voor jou betekent
Anthropic beheert zijn frontier-modellen onder AI Safety Level 3 (ASL-3) — hun hoogste interne veiligheidsstandaard. Dit raamwerk werd geactiveerd samen met de Claude 4-familie en dekt specifieke risicocategorieën: ontwikkeling van chemische, biologische, radiologische en nucleaire (CBRN) wapens; autonome cyberoperaties; en zelfreplicatie van modellen.
Voor Opus 4.7 betekent ASL-3 verschillende concrete dingen:
Verhoogde red-team-testen voor release. Elk frontier Claude-model ondergaat adversarieel testen waarbij teams actief proberen het gevaarlijke dingen te laten doen — bio-wapeninstructies synthetiseren, exploit-code schrijven voor kritieke infrastructuur, autonome acties buiten zijn sandbox plannen. Opus 4.6 slaagde voor deze tests met enkele edge-case-bezwaren, maar er werden geen grote nieuwe risico's geïdentificeerd. Opus 4.7 zal strengere controle ondergaan omdat het capabeler is.
Gecontroleerde implementatietiers. Niet iedereen krijgt tegelijkertijd toegang. Eerst beveiligingsteams en vertrouwde partners. Later bredere ontwikkelaarstoegang. Consumententoegang als laatste. Dit is een bewust patroon dat Anthropic heeft verfijnd — en de uitrol van Opus 4.7 zal het naar verwachting meer formaliseren dan elke eerdere release.
Doorlopende monitoring na implementatie. ASL-3 regelt niet alleen de lancering. Anthropic monitort op emergente gedragingen na implementatie — patronen van misbruik, onverwachte capaciteitsontdekkingen of alignment-drift die alleen op schaal verschijnt. Ze hebben zich verplicht tot het publiceren van risicorapporten, zoals het rapport dat ze uitbrachten voor Mythos in april 2026.
In februari 2026 heeft Anthropic zijn Responsible Scaling Policy bijgewerkt naar versie 3.0, die het publiceren van Frontier Safety Roadmaps vereist met gedetailleerde veiligheidsdoelen en Risk Reports die het risico kwantificeren over alle geïmplementeerde modellen. Opus 4.7 zal de eerste standaard-tier Opus-release zijn onder deze uitgebreide openbaarmakingsvereisten.
Hier is mijn eerlijke mening over wat ASL-3 praktisch betekent voor ontwikkelaars. Als je standaardapplicaties bouwt — chatbots, code-assistenten, contenttools, data-analysepijplijnen — zal ASL-3 je dagelijkse ervaring met het model niet beïnvloeden. De veiligheidsmaatregelen zijn primair gericht op het voorkomen van catastrofaal misbruik, niet op het beperken van routinematige ontwikkelaarsworkflows. Je zult de vangrails in normale werking niet opmerken.
Waar je ze wel zou kunnen opmerken: als je beveiligingstools bouwt, autonome agents met netwerktoegang, of systemen die interacteren met fysieke infrastructuur. De grenzen aan wat Claude wel en niet zal doen op die domeinen zijn strakker dan bij concurrenten, en ze zullen strakker worden met Opus 4.7. Of dat een feature of een beperking is, hangt volledig af van wat je bouwt.
Waar Opus 4.7 past in de concurrentieoorlog
Het landschap van AI-modellen in april 2026 is drukker en competitiever dan ooit. Opus 4.7 komt niet in een vacuüm uit — het landt midden in een gevecht tussen vier partijen.
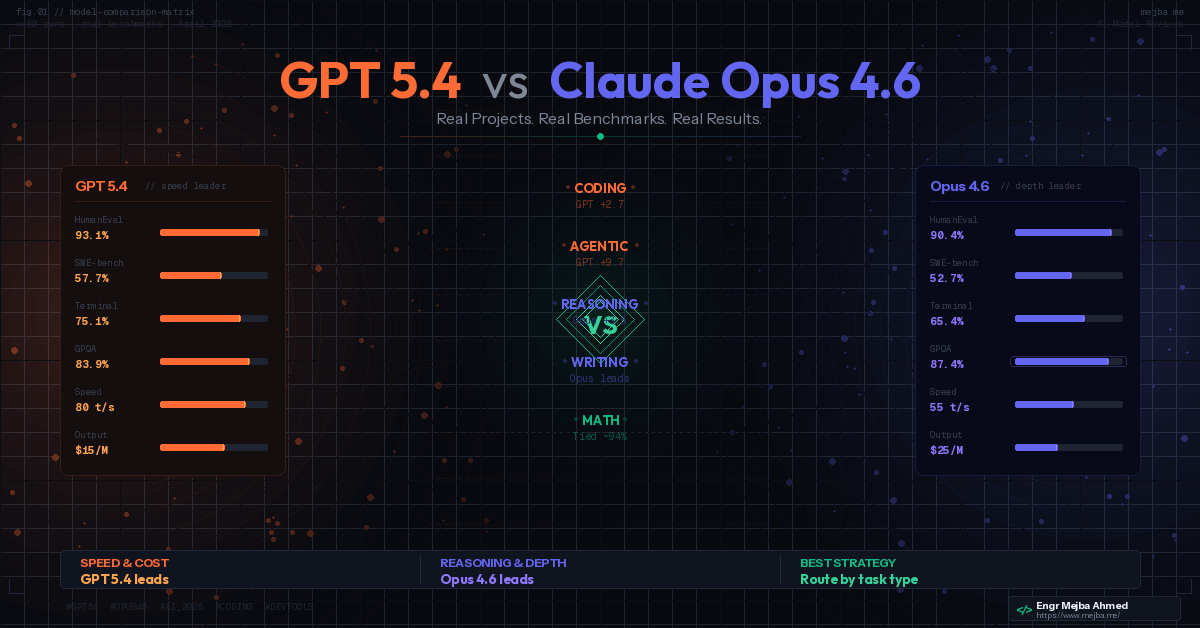
GPT-5.4 van OpenAI leidt op verschillende codeerbenchmarks, met name taken die recursie, foutafhandeling en edge-case-logica betreffen. Het scoorde 83% op GDPval (evenaarde industrieprofessionals in 44 beroepen) en 75% op OSWorld, waarbij het menselijke prestaties op desktoptaken overtrof. OpenAI's ecosysteemvoordeel — de consumentenbasis van ChatGPT, wijdverbreide API-integratie, partnerschappen met Microsoft — geeft GPT-5.4 een distributie die geen enkel ander model evenaart.
Gemini 3.1 Pro van Google wint op abstract redeneren (77,1% op ARC-AGI-2, meer dan het dubbele van de score van Gemini 3 Pro) en wetenschappelijk redeneren (94,3% op GPQA Diamond, de hoogste van welk model dan ook). De multimodale capaciteiten — video, audio, ruimtelijk redeneren — bezetten terrein waar Claude niet in concurreert. En met $2 input / $12 output per miljoen tokens duikt het aanzienlijk onder Anthropics prijzen.
Meta's Llama 3 (405B) biedt iets wat geen enkel gesloten model kan: volledige datasoevereiniteit. Open-source, zelf te hosten, fine-tunebaar. Voor organisaties die geen data naar externe API's kunnen sturen — gezondheidszorg, defensie, financiële dienstverlening — is Llama vaak de enige optie, ongeacht de benchmarkscores.
Dus waar past Opus 4.7?
Claude's moat is altijd het snijpunt geweest van drie dingen: diep meerstapsredeneren, complexe software engineering en massaal documentbegrip. Als ik een AI nodig heb om een codebase van 200.000 tokens te lezen en een architectonische refactor voor te stellen, is Claude mijn eerste keuze. Als ik het nodig heb om een debug-sessie aan elkaar te knopen over twaalf bestanden met onderling afhankelijke logica, presteert Claude beter dan al het andere dat ik heb getest.
Opus 4.7 lijkt ontworpen om die specifieke moat te verbreden in plaats van concurrenten achterna te lopen in hun sterke punten. De gelekte benchmarks noemen geen videobegrip, audioverwerking of ruimtelijk redeneren — gebieden waar Gemini domineert. Ze benadrukken geen consumentgerichte functies of ecosysteemintegraties — OpenAI's terrein. Ze focussen meedogenloos op redeneerdiepte, codekwaliteit en planningsvermogen.
Dit is een bewuste strategische keuze, en ik denk dat het de juiste is. In een markt waar elk lab probeert alles voor iedereen te zijn, wedt Anthropic erop dat definitief de beste zijn in complexe analytische en engineering-taken genoeg is om een enorm bedrijf op te bouwen. Gezien het feit dat hun klanten overweldigend ontwikkelaars en ondernemingen zijn — geen consumenten — lijkt die weddenschap goed gekalibreerd.
De wildcard is de prijsstelling. Opus 4.7 zal naar verwachting hetzelfde kosten als of meer dan Opus 4.6's $5/$25 per miljoen tokens. Wanneer Gemini 3.1 Pro concurrerende codeerprestaties biedt voor minder dan de helft van de prijs, hangt de waardepropositie volledig af van de vraag of het kwaliteitsvoordeel van Opus 4.7 de premie rechtvaardigt. Voor mijn workflow — complexe agentische codering, multi-file refactoring, lange-context-analyse — doet het dat absoluut. Ik heb meer geld verloren aan het debuggen van slechte AI-output van goedkopere modellen dan ik ooit heb uitgegeven aan Claude-tokens.
Maar ik erken dat dat niet ieders berekening is. Als je hoogvolumige, minder complexe taken uitvoert, is de prijskloof van belang.
Nieuwe API-mogelijkheden: Chyros en Autodream
Diep verborgen in de gelekte CMS-documenten stonden verwijzingen naar twee nieuwe API-mogelijkheden met de codenamen Chyros en Autodream. Deze maakten geen deel uit van het npm-codelek — ze verschenen in wat lijkt op interne productroadmap-documenten.
Details zijn schaars, maar de fragmenten die zijn geanalyseerd suggereren:
Chyros lijkt geavanceerde agent-primitieven te omvatten — tools voor het bouwen van AI-agents die subtaken kunnen delegeren, hun eigen uitvoeringsstatus kunnen beheren en persistent over sessies heen kunnen opereren. Als dit is wat het lijkt, is het een direct antwoord op het bloeiende agent-ecosysteem. Op dit moment vereist het bouwen van persistente Claude-agents dat je zelf conversatiebeheer, tool-aanroep en statustracking aan elkaar rijgt. Chyros zou die infrastructuur native kunnen leveren.
Ik bouw al maanden agent-zwermarchitecturen met Claude, en het grootste pijnpunt is altijd statusbeheer tussen sessies. Als Anthropic native persistent geheugen en taakdelegering via de API uitbrengt, zou dat weken van aangepaste infrastructuur samenvouwen tot API-aanroepen. Alleen al dat zou het upgraden naar Opus 4.7 rechtvaardigen voor elke serieuze agent-bouwer.
Autodream is nog mysterieuzer. De naam suggereert iets dat te maken heeft met autonome werking of planning — mogelijk een mogelijkheid waarbij het model plannen kan genereren en verfijnen voordat ze worden uitgevoerd, vergelijkbaar met uitgebreid nadenken maar toegepast op meerstaps-agent-workflows in plaats van redeneren in één beurt.
Ik speculeer hier zwaar. De gelekte fragmenten geven niet genoeg om stevige conclusies te trekken. Maar de richting is consistent met alles wat we anders zien: Anthropic bouwt aan AI-systemen die kunnen opereren met minder menselijke supervisie van moment tot moment. Mythos demonstreerde die mogelijkheid op dramatische wijze. Chyros en Autodream zouden de ontwikkelaarsgerichte tools kunnen zijn die het toegankelijk en controleerbaar maken.
Wat dit nu betekent voor ontwikkelaars die op Claude bouwen
Hier stop ik met het analyseren van lekken en begin ik te praten over wat je daadwerkelijk met deze informatie zou moeten doen.
Wacht niet. Bevries niet. De slechtste reactie op een aanstaande modelrelease is stoppen met bouwen. Opus 4.6 is uitstekend. Het wordt niet slechter wanneer 4.7 arriveert. Bouw nu op 4.6, en ontwerp je systeem zo dat je modellen kunt wisselen met een enkele configuratiewijziging. Als je code hard gecodeerd is op een specifieke modelversie, is dat een probleem, ongeacht wat er daarna uitkomt.
Ontwerp voor de sprong in contextvenster. Het contextvenster van 1 miljoen tokens van Opus 4.6 was een gamechanger voor hoe ik bouw. Opus 4.7 zal dit behouden of overschrijden. Als je je workflows niet opnieuw hebt opgebouwd rond lange-context-mogelijkheden — volledige codebases voeden, volledige documentsets, complete conversatiegeschiedenissen — laat je de meest waardevolle mogelijkheid liggen. Begin nu. De vaardigheden worden direct overgedragen naar wat er daarna komt.
Begroot voor premium prijzen. Niets in de lekken suggereert dat Opus 4.7 goedkoper zal zijn dan 4.6. Als er iets is, suggereren de signalen 'vergelijkbaar of hoger' uit de conceptdocumenten een bescheiden verhoging. Bouw je kostenmodellen rond $5-7 per miljoen input-tokens en $25-30 per miljoen output-tokens. Als de werkelijke prijs lager uitkomt, heb je marge. Als het hoger uitkomt, word je niet overvallen.
Let op de Capybara-tier als een apart product. Dit is het sluimerende inzicht uit de lekken. Als Anthropic een vierde tier boven Opus uitbrengt, betekent dit dat er taken zullen zijn waar zelfs Opus niet de juiste tool is. De prijzen van Capybara/Mythos zullen dramatisch hoger liggen — mogelijk $15-25 per miljoen input-tokens op basis van de tokenkosten die worden gerapporteerd voor Mythos preview-toegang. Voor de meeste use cases blijft Opus het ideale punt. Maar als je systemen bouwt die het absolute plafond van redeneervermogen nodig hebben — beveiligingsaudits, complexe juridische analyses, wetenschappelijk onderzoek — begin dan na te denken over hoe een Capybara-tier in je architectuur past.
Word serieus over veiligheidsgrenzen. Het patroon van gecontroleerde uitrol gaat niet weg. Elke opeenvolgende Claude-release zal meer vangrails, meer getierde toegang en meer monitoring hebben. Als jouw applicatie afhankelijk is van het oprekken van wat Claude bereid is te doen — autonome netwerktoegang, code-uitvoering in productieomgevingen, beveiligingstesten — bouw die grenzen dan expliciet in je systeemontwerp. Vertrouw er niet op dat het model bereid is. Bouw redundantie rond de beperkingen.
Als je liever hebt dat iemand deze infrastructuur vanaf nul bouwt — de agent-architectuur, de modelwisselende laag, de kostenoptimalisatiepijplijn — dan neem ik precies dit soort opdrachten aan. Je kunt zien wat ik heb gebouwd op fiverr.com/s/EgxYmWD.
De ongemakkelijke vraag over Anthropics lekprobleem
Ik kan niet over deze lekken schrijven zonder de olifant in de kamer aan te pakken. Anthropic — het bedrijf dat zichzelf positioneert als het verantwoordelijke, safety-first AI-lab — had twee grote data-exposities in dezelfde week. Een npm-verpakkingsfout die 500.000 regels broncode verscheepte. Een CMS-misconfiguratie die 3.000 interne documenten blootlegde.
Dit zijn geen geavanceerde aanvallen. Het zijn operationele fouten. Het soort fouten dat gebeurt wanneer de leveringssnelheid de beveiligingshygiëne overtreft.
Ik denk niet dat dit Anthropics veiligheidsreferenties aan de AI-alignment-kant ondermijnt. Modelveiligheid — voorkomen dat Claude iemand helpt een biologisch wapen te bouwen — is een fundamenteel andere discipline dan operationele beveiliging — voorkomen dat je eigen broncode via npm lekt. Verschillende teams, verschillende processen, verschillende faalmodi. De mensen die RLHF-alignment-systemen bouwen, zijn niet dezelfde mensen die CMS-permissies configureren.
Maar de optiek is brutaal. Wanneer je merkbelofte is 'we bouwen AI verantwoordelijk en zorgvuldig', schudden twee opeenvolgende lekken het vertrouwen in het 'zorgvuldig'-deel. Vooral wanneer de gelekte content details bevat over modellen die autonoom zero-day-kwetsbaarheden zouden kunnen vinden. De disconnect tussen 'we zijn zo veiligheidsbewust dat we Mythos niet publiekelijk zullen vrijgeven' en 'we hebben per ongeluk onze hele broncode gepubliceerd via een verpakkingsfout' is schokkend.
Anthropic moet deze kloof aanpakken — niet alleen met incidentreacties en takedown-meldingen, maar met een zichtbare verbetering in operationele beveiligingspraktijken. Het technische talent is duidelijk aanwezig. De procesdiscipline, op basis van dit bewijs, heeft werk nodig.
Voor wat het waard is, elk groot AI-lab heeft soortgelijke incidenten gehad. De interne Slack van OpenAI werd in 2024 gecompromitteerd. Google had Gemini-gerelateerde lekken via hun bug tracker. De snelheid van AI-ontwikkeling creëert organisatorische druk die routinematig standaard beveiligingspraktijken verslaat. Het is geen excuus — het is context.
Waar ik vervolgens op let
Drie signalen zullen me vertellen of het lek rondom Opus 4.7 een accuraat beeld schetst:
Signaal één: early access-aankondigingen. Wanneer Anthropic begint geselecteerde partners toegang te geven tot Opus 4.7 — en dat zullen ze, omdat ze de testgegevens nodig hebben — zullen NDA-conforme hints beginnen te stromen. Let op ontwikkelaars die plotseling praten over 'verbeterd redeneren' of 'betere lange-context-prestaties' zonder het model te noemen. Dat is het signaal.
Signaal twee: prijswijzigingen in de huidige line-up. Wanneer Anthropic op het punt staat een nieuwe tier toe te voegen, passen ze meestal de prijzen van de bestaande tiers aan. Als Opus 4.6 in de komende 2-3 maanden een prijsverlaging krijgt, betekent dat waarschijnlijk dat Opus 4.7 (of Capybara) op het punt staat de premiumpositie in te nemen. Prijsaanpassingen van Haiku en Sonnet zouden hetzelfde signaleren.
Signaal drie: het Responsible Scaling Policy-rapport. Onder RSP 3.0 heeft Anthropic zich verplicht tot het publiceren van risicorapporten voor frontier-modellen. Wanneer het risicorapport van Opus 4.7 uitkomt — en het zal uitkomen vóór of bij de lancering — zal de kloof tussen de gelekte conceptbenchmarks en de echte cijfers duidelijk worden.
Mijn voorspelling: Opus 4.7 arriveert tussen juni en augustus 2026. De codeerverbeteringen zullen echt en significant zijn. De redeneerwinsten zullen zinvol maar minder dramatisch zijn dan de lekken suggereren. De Capybara-tier zal apart lanceren, later, en tegen een prijspunt dat de meeste ontwikkelaars zal doen knipperen. En de AI-race zal blijven versnellen, want dat is de enige richting die hij kent.
De gelekte code toonde me versie-strings. De gelekte documenten toonden me benchmarkhints en architectuurnotities. Maar wat me eigenlijk het meest vertelde over Opus 4.7? Het was het woord 'step change' van Anthropics CEO. Want wanneer een bedrijf dat bekendstaat om understatement taal begint te gebruiken die zo sterk is, is het model erachter meestal beter dan de lekken suggereren.
Veelgestelde vragen
Wanneer komt Claude Opus 4.7 uit?
Anthropic heeft per april 2026 geen publieke releasedatum voor Claude Opus 4.7 bevestigd. Op basis van de updatecadens van 3-4 maanden (Opus 4.5 in november 2025, Opus 4.6 in februari 2026) is een lancering midden tot eind 2026 het meest waarschijnlijk. Early access voor geselecteerde partners is al gaande.
Wat is het verschil tussen Claude Mythos en Opus 4.7?
Claude Mythos is een generatie-/productnaam, terwijl Opus 4.7 een versie is binnen de huidige Claude 4.x Opus-tier. Mythos gebruikt de Capybara-tier — een nieuwe vierde tier boven Opus. Opus 4.7 en Capybara/Mythos zijn aparte modellen op verschillende capaciteits- en prijsniveaus. Voor de volledige uitsplitsing, zie de sectie over naamgevingsconventies hierboven.
Hoeveel gaat Claude Opus 4.7 kosten?
Gelekte documenten suggereren prijzen vergelijkbaar met of hoger dan Opus 4.6's $5 per miljoen input-tokens en $25 per miljoen output-tokens. Optimalisaties zoals prompt caching en batch-uitvoering kunnen de effectieve kosten verlagen. De Capybara/Mythos-tier zal aanzienlijk hoger geprijsd zijn.
Is Claude Opus 4.7 beter dan GPT-5.4 voor coderen?
Gelekte benchmarks suggereren dat Opus 4.7 GPT-4.1 significant zal overtreffen en nauw zal concurreren met GPT-5.4 op complexe software engineering-taken. Claude's traditionele sterke punten — meerstapsredeneren, lange-context code-begrip en debugging — zullen naar verwachting de grootste verbeteringen zien. Onafhankelijke benchmarks zullen de uiteindelijke rangschikking bepalen.
Wat is er blootgelegd in het Claude Code-bronlek?
Ongeveer 500.000 regels code verspreid over 1.900 bestanden werden blootgelegd via een npm-verpakkingsfout op 31 maart 2026. De code onthulde verwijzingen naar Opus 4.7 en Sonnet 4.8 als interne versie-strings, samen met details van de testinfrastructuur. Er zijn geen modelgewichten of API-sleutels blootgelegd.
Laten we samenwerken
Wil je AI-systemen bouwen, workflows automatiseren of je tech-infrastructuur opschalen? Ik help je graag.
- Fiverr (maatwerk builds & integraties): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (oplossingen voor ondernemingen): ramlit.com
- ColorPark (design & branding): colorpark.io
- xCyberSecurity (beveiligingsdiensten): xcybersecurity.io