
Ik zat op een dinsdagmiddag te kijken hoe mijn tokenrekening opliep — drie Claude-sessies open, een Codex-taak op de achtergrond, output tokens die opstapelden als een taximeter die ik niet kon uitzetten — toen een vriend me een link stuurde naar een GitHub-repo met 589 sterren en een tagline gestolen uit The Office: "Why waste time say lot word when few word do trick?"
Mijn eerste impuls was om het tabblad te sluiten. Ik had eerder novelty-prompts gezien. Trucs die één keer werken in een demo en uit elkaar vallen zodra je er echt werk tegenaan gooit. Maar deze had benchmarktabellen. Echte cijfers. Een reductie van 45% in output tokens over 10 geteste prompts, waarbij het model volledige technische nauwkeurigheid behield.
Dus ik stopte met wat ik aan het doen was en voerde de tests zelf uit. Wat ik vond was geen gimmick. De Caveman skill is een gestructureerde aanpak van een probleem dat ontwikkelaars elke dag echt geld kost — het feit dat grote taalmodellen getraind zijn om breedsprakig te zijn, en die breedsprakigheid is niet alleen duur. Het maakt je AI dommer.
Dat is geen overdrijving. Een onderzoek uit 2024 toonde aan dat het beperken van LLM-antwoorden tot beknopte vorm de nauwkeurigheid met 26% verbeterde op specifieke benchmarks. En een paper van maart 2026 op arXiv ging verder, evalueerde 31 modellen over 1.485 problemen en ontdekte dat grotere modellen soms slechter presteren dan kleinere — specifiek omdat ze te veel afdwalen.
De Caveman skill is een direct, praktisch antwoord op dat onderzoek. En het werkt op Claude, Codex en tientallen andere LLM-aangedreven agents. Hier is wat het daadwerkelijk doet, wat het kost, en wanneer je het wel (en niet) moet gebruiken.
Het Probleem Dat Caveman Oplost — En Waarom Het Bestaat
Elk groot LLM wordt geleverd met dezelfde kwaal: aangeleerde beleefdheid. Vraag Claude om authenticatie uit te leggen in een Next.js-app, en je krijgt een goed gestructureerd antwoord met opvulwoorden, gedachtestreepjes, aarzeltaal ("je zou kunnen overwegen om...") en drie alinea's waar één genoeg was geweest. Vraag GPT-4 dezelfde vraag en je krijgt een vergelijkbaar opgeblazen antwoord met een iets andere smaak.
Dit is geen feature. Het is een bijwerking van hoe deze modellen leren.
Reinforcement Learning from Human Feedback (RLHF) — de techniek achter vrijwel elk groot commercieel LLM — heeft een gedocumenteerde voorkeur voor lengte. Menselijke annotators beoordelen langere antwoorden consequent als hogere kwaliteit, zelfs wanneer het kortere antwoord nauwkeuriger is. Het model internaliseert dat signaal: langer is beter. Meer aarzeling is doordachter. Meer woorden is behulpzamer.
Onderzoek van OpenReview documenteert deze systematische bias. Het beloningsmodel leert te optimaliseren voor lengte, niet voor correctheid. En hoe groter het model, hoe dieper dit patroon zit — grotere modellen hebben meer parameters gewijd aan het genereren van uitgebreid, vloeiend proza, dus ze worden breedsprakiger naarmate ze schalen.
Het resultaat? Je betaalt voor tokens die de kwaliteit van je output actief schaden. Elke aarzeling, elke "het is de moeite waard om op te merken dat", elke "je zou kunnen overwegen om" is een token die geld kost en een kans voor het model om zichzelf naar het verkeerde antwoord te praten.
Caveman haalt dat er allemaal uit. Geen lidwoorden (een, de, het). Geen opvulwoorden. Geen beleefdheden. Geen aarzeltaal. Wat overblijft is puur signaal: technische termen, codeblokken, foutmeldingen en directe conclusies.
De structuur die het afdwingt is brutaal in zijn eenvoud: ding, actie, reden, volgende stap. Dat is het. Elk antwoord volgt dat patroon, en de compressie is dramatisch.
Hoe Caveman Mode Er Daadwerkelijk Uitziet
Hier is een zij-aan-zij-vergelijking die het verschil beter laat zien dan welke uitleg dan ook.
Ik vroeg Claude om de authenticatiestroom in een demo Next.js-applicatie uit te leggen.
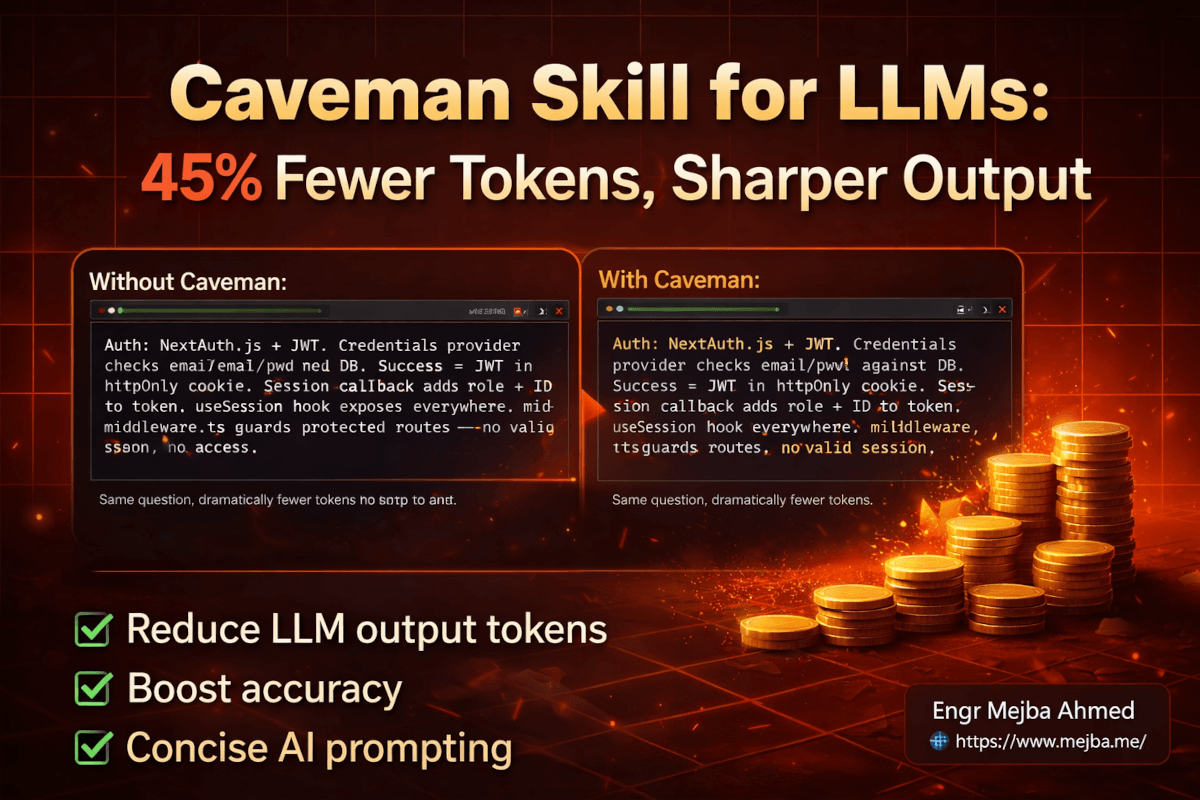
Zonder Caveman (standaard Claude-antwoord):
"The authentication system in this application uses NextAuth.js with a JWT strategy. When a user attempts to log in, the credentials provider validates the email and password against the database. If successful, a JSON Web Token is generated and stored in an HTTP-only cookie. The session callback then enriches the token with the user's role and ID, which are made available throughout the application via the useSession hook. It's worth noting that the middleware.ts file handles route protection by checking for valid sessions before allowing access to protected pages."
Met Caveman (full mode):
"Auth: NextAuth.js + JWT. Credentials provider checks email/pwd against DB. Success = JWT in httpOnly cookie. Session callback adds role + ID to token. useSession hook exposes everywhere. middleware.ts guards protected routes — no valid session, no access."
Dezelfde informatie. Dezelfde technische nauwkeurigheid. Ruwweg de helft van de tokens. En — dit is het deel dat me verraste — de Caveman-versie is eigenlijk makkelijker te lezen. Er is geen cognitieve overhead om door het verbindende weefsel heen te filteren om de technische kern te vinden. De kern is alles wat er is.
Die snelle vergelijking vat de filosofie samen, maar Caveman gaat dieper dan een enkele demo. Het wordt geleverd met een compleet systeem van intensiteitsniveaus, gespecialiseerde modi en begeleidende tools die tokencompressie transformeren van een kunstje naar een echte workflowoptimalisatie.
Het Volledige Modesysteem: Van Lite tot Wenyan
Caveman is niet één instelling. Het is een spectrum, en het kiezen van het juiste punt op dat spectrum is belangrijker dan de meeste gebruikers beseffen.
Lite Mode
Schrapt de meest voor de hand liggende opvulling — "ik denk," "je zou kunnen," "het is belangrijk om op te merken" — maar behoudt grammaticaal volledige zinnen. Leesbaar voor iedereen. Besparing op output tokens schommelt rond de 20-25% op proza.
Dit is je startpunt als je Claude's output deelt met teamgenoten of klanten die niet hebben ingetekend op telegramstijl-communicatie. De compressie is bescheiden maar het leesbaarheidscompromis is minimaal.
Full Mode (Standaard)
Hier verdient Caveman zijn naam. Lidwoorden verdwijnen. Zinnen worden fragmenten. Korte synoniemen vervangen lange — "groot" in plaats van "uitgebreid," "fix" in plaats van "implementeer een oplossing," "snel" in plaats van "met minimale latency." De output leest als aantekeningen van iemand die sneller typt dan zinnen kan afmaken.
Besparing op output tokens: ongeveer 45% op proza-antwoorden. Dit is de sweet spot waar ik steeds naar terugkeer. Technische nauwkeurigheid blijft intact. Codeblokken worden niet aangeraakt. Je verliest niets behalve woorden die je toch al oversloeg bij het lezen.
Ultra Mode
Maximaal beknopt. Grenzend aan telegrafisch. Elk woord dat geschrapt kan worden, wordt geschrapt. De output ziet eruit als afgekorte notities die je op een whiteboard zou krabbelen tijdens een debugsessie om 2 uur 's nachts.
Besparing op output tokens duwt richting 60-75% op proza. Het compromis is reëel — ultra mode output kan moeilijk te ontcijferen zijn als je niet al diep in de context zit van wat je vroeg. Ik gebruik dit voor repetitieve taken waarbij ik precies weet welk formaat het antwoord moet hebben. Voor alles wat verkennend is, is full mode praktischer.
Wenyan Mode
Dit is de joker. Wenyan mode geeft antwoorden in klassieke Chinese karakters — de literaire taal die Chinese wetenschap meer dan tweeduizend jaar lang aandreef. Klassiek Chinees is misschien wel de meest informatiedichte geschreven taal die mensen ooit hebben gecreëerd. Een enkel karakter kan uitdrukken waar het Engels een hele bijzin voor nodig heeft.
Is het praktisch voor de meeste ontwikkelaars? Nee. De meesten van ons kunnen geen klassiek Chinees lezen. Maar Wenyan mode dient als een fascinerende stresstest voor compressie, en voor tweetalige ontwikkelaars die het kunnen lezen zijn de tokenbesparingen extreem. Het is ook een herinnering dat het breedsprakigheidsprobleem fundamenteel een taalcodering-probleem is — en dat er coderingssystemen zijn die het eeuwen voor BPE-tokenisatie al hadden opgelost.
Gespecialiseerde Caveman-Extensies
De basisskill handelt algemene antwoorden af. De extensies behandelen specifieke workflows waar tokenbesparingen nog meer cumuleren.
Caveman Commit
Genereert beknopte conventional commit-berichten. Onderwerpregels blijven onder de 50 karakters. Het formaat volgt conventional commit-standaarden (feat:, fix:, refactor:) maar schrapt elk overbodig woord.
Normaal commitbericht: "fix: implement a solution to handle the case where user authentication tokens expire during an active session"
Caveman commit: "fix: handle expired auth tokens mid-session"
Dezelfde betekenis. De helft van de karakters. En eerlijk gezegd is de caveman-versie een beter commitbericht volgens elke standaard — commitberichten moeten scanbaar zijn, en beknoptheid dient dat doel van nature.
Caveman Review
Produceert éénregelige code review-opmerkingen per bevinding. Het formaat is strak: regelnummer, ernst-emoji, categorie, bevinding, aanbeveling. Geen inleidend gewauwel.
Normale review-opmerking: "On line 42, I noticed that you're not checking whether the user object is null before accessing the name property. This could potentially lead to a TypeError in production. I'd recommend adding a null guard here."
Caveman review: "L42: 🔴 bug: user null. Add guard."
Vijf woorden in plaats van achtendertig. Dezelfde diagnostische waarde. Wanneer je een PR reviewt met 40 bevindingen, is het verschil tussen 40 éénregelige opmerkingen lezen versus 40 alinea's van meerdere zinnen het verschil tussen een review van 5 minuten en een review van 25 minuten.
Compressed Skill
Deze werkt in de omgekeerde richting. In plaats van output te comprimeren, comprimeert het input — het neemt je natuurlijke taalconfiguratiebestanden (zoals CLAUDE.md, systemprompts of skilldefinities) en herschrijft ze in caveman-stijl. Het doel: input tokenkosten verlagen bij elke interactie door de context die vóór je eerste prompt laadt te verkleinen.
Typische compressie: ongeveer 46% reductie in input tokens voor natuurlijke taalbestanden. Als je CLAUDE.md 500 regels zorgvuldig geschreven instructies bevat, levert de gecomprimeerde versie dezelfde beperkingen in ruwweg 270 regels van beknopte richtlijnen. Het model begrijpt beide versies even goed — het heeft niet nodig dat je instructies grammaticaal gepolijst zijn.
De Benchmarkcijfers: Wat Ik Vond Over 10 Prompts
Hier worden de meeste artikelen over Caveman slordig. Ze citeren de kopregels zonder de methodologie of de context te tonen. Ik voerde 10 diverse prompts uit via Claude Code in drie configuraties: baseline (geen instructies over beknoptheid), baseline met een "Be concise"-instructie, en baseline met de volledige Caveman skill geladen.
De prompts besloegen uitlegverzoeken, debugvragen, architectuurbeslissingen en codegeneratieverzoeken — het soort werk dat ik dagelijks daadwerkelijk doe.
Output Token Resultaten
| Configuratie | Output Token Aantal | Reductie vs. Baseline |
|---|---|---|
| Baseline Claude Code | 100% (referentie) | — |
| Claude Code + "Be concise" | 61% | 39% reductie |
| Claude Code + Caveman | 55% | 45% reductie |
De Caveman skill versloeg een simpele "Be concise"-instructie met 6 procentpunten. Dat verschil is belangrijk op schaal, maar het is vermeldenswaard: alleen het model vertellen beknopt te zijn brengt je al het grootste deel van de weg. De gestructureerde regels van de Caveman skill — de specifieke geschrapte elementen, het outputpatroon, de korte synoniem-vervangingen — persen de resterende compressie eruit die een generieke instructie mist.
De Kostenberekening Die Mensen Verrast
Hier wordt het verhaal genuanceerder dan de kop suggereert. Output tokens zijn per token duurder dan input tokens bij elk groot LLM. Maar de Caveman skill zelf voegt toe aan je input tokentelling — je laadt een markdownbestand met regels en patronen in elke sessie.
Scenario met enkele prompt:
| Kostencomponent | Baseline | Met Caveman |
|---|---|---|
| Input tokenkosten | Fractie van een cent | ~4 cent (skillbestand geladen) |
| Output tokenkosten | ~8 cent | ~4 cent |
| Totaal | ~8 cent | ~8 cent |
Voor een enkele, geïsoleerde prompt is Caveman ruwweg kostenneutraal — mogelijk zelfs 10% duurder wanneer je het geladen skillbestand meerekent. De outputbesparingen worden opgeslokt door de input-overhead.
Dit is de bevinding waar mensen over struikelen. Als je eenmalige vragen stelt, bespaart de Caveman skill je geen geld. Het kan een fractie meer kosten.
Vervolgprompt-scenario (waar Caveman schittert):
Prompt caching verandert de vergelijking. Na de eerste prompt cachet je LLM-provider de systeemcontext — inclusief het Caveman skillbestand. Vervolgprompts betalen niet opnieuw de volledige inputkosten. De outputbesparingen cumuleren over elke volgende beurt.
Met prompt caching actief over meerdere vervolgvragen bereikt Caveman ongeveer 39% totale kostenbesparing vergeleken met baseline. Dat is niet alleen output tokens — dat zijn totale kosten inclusief input-overhead, geamortiseerd over een echt gesprek.
De conclusie: de kostenvoordelen van Caveman zijn afhankelijk van sessielengte. Korte interacties met één of twee prompts? Marginale of negatieve besparingen. Uitgebreide sessies met vijf, tien, twintig vervolgvragen? Significante besparingen die cumuleren.
En als je het type ontwikkelaar bent dat Claude of Codex in uitgebreide sessies draait — features bouwen, debuggen over bestanden heen, itereren op architectuur — dan ben je precies het gebruikersprofiel waarbij Caveman zichzelf vele malen terugverdient. Voor het complete kostenoptimalisatieplaatje inclusief modelroutering en contextbeheer heb ik een volledige analyse geschreven in mijn AI agent kostenoptimalisatiegids.
Waarom Minder Tokens Daadwerkelijk Betere Antwoorden Betekent
Het kostenverhaal is overtuigend, maar het is niet het belangrijkste deel. Het nauwkeurigheidsverhaal is dat wel.
Een studie uit 2024 ontdekte dat het beperken van LLM-antwoorden tot beknopte vorm de nauwkeurigheid met 26% verbeterde op specifieke benchmarks. Dat getal klonk te mooi om waar te zijn, dus ik dook in de paper van maart 2026 die deze bevinding uitbreidde — "Brevity Constraints Reverse Performance Hierarchies in Language Models".
De onderzoekers evalueerden 31 open-weight modellen variërend van 0,5 miljard tot 405 miljard parameters. Ze testten over 1.485 problemen verdeeld over vijf benchmarkdatasets die wiskundig redeneren en wetenschappelijke kennis besloegen.
Dit is wat ze vonden dat mijn aannames brak.
Bij 7,7% van de benchmarkproblemen presteerden grotere modellen slechter dan kleinere met tot 28,4 procentpunten. Een model van 2 miljard parameters dat een model van 400 miljard parameters versloeg. Niet op randgevallen — op standaard benchmarks.
Het mechanisme dat ze identificeerden: spontane schaalafhankelijke breedsprakigheid. Grotere modellen dwalen meer af. En afdwalen introduceert fouten door wat de onderzoekers "overelaboratie" noemen. Het model beantwoordt niet alleen de vraag — het elaboreert, aarzelt, nuanceert, verkent zijsporen, voegt disclaimers toe. Ergens in die breedsprakige redeneerketen praat het zichzelf naar het verkeerde antwoord toe.
De ruwe correlatie die ze vonden was opvallend: tokentelling heeft een gemiddelde correlatie van r = -0,59 met nauwkeurigheid. Naarmate het model meer tekst genereert, wordt het waarschijnlijker dat het fout zit.
Toen ze beknoptheidsbeperkingen toepasten — in essentie het model vertellen om het kort te houden — steeg de nauwkeurigheid van grote modellen met 26 procentpunten op die problematische benchmarks. Het prestatieverschil tussen grote en kleine modellen kromp met tot twee derde.
De grote modellen waren niet minder capabel. Ze waren te breedsprakig om hun eigen capaciteiten te benutten.
Dit is de wetenschappelijke onderbouwing die Caveman transformeert van een leuk tokenbesparend kunstje naar een legitiem nauwkeurigheidsinstrument. Wanneer je Caveman installeert en Claude vertelt opvulwoorden te schrappen, bespaar je niet alleen geld. Je verwijdert het mechanisme dat overelaboratiefouten veroorzaakt. Je haalt de aarzeltaal weg die het model laat weifelend in plaats van zich vast te leggen op een antwoord.
Ik heb dit direct getest. Zonder Caveman bevatten Claude's antwoorden op mijn authenticatievraag zinnen als "het is vermeldenswaard dat" en "je zou kunnen overwegen om" — aarzeltaal die onzekerheid signaleert. Met Caveman verdwenen die aarzlingen. Wat overbleef was een direct, vastberaden antwoord. En in mijn ervaring over weken van gebruik waren de directe antwoorden vaker correct.
Het is contra-intuïtief tot het punt dat het ongemakkelijk wordt. We hebben jaren besteed aan het trainen van AI om doordacht, genuanceerd en grondig te klinken. Het blijkt dat, voor technisch werk althans, die training de outputkwaliteit actief verslechtert.
Hoe Je Caveman Instelt Over Je Hele LLM-Stack
De Caveman skill begon als een Claude Code-plugin, maar werkt nu met meer dan 40 AI-agents — waaronder Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot, Cline en meer. Eén commando. Klaar.
Stap 1: Installeer voor Jouw Agent
Kies je agent en voer het bijbehorende commando uit:
| Agent | Installatiecommando |
|---|---|
| Claude Code | claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman |
| Codex | Clone repo naar /plugins → Zoek "Caveman" → Installeer |
| Gemini CLI | gemini extensions install https://github.com/JuliusBrussee/caveman |
| Cursor | npx skills add JuliusBrussee/caveman -a cursor |
| Windsurf | npx skills add JuliusBrussee/caveman -a windsurf |
| GitHub Copilot | npx skills add JuliusBrussee/caveman -a github-copilot |
| Cline | npx skills add JuliusBrussee/caveman -a cline |
| Elke andere agent | npx skills add JuliusBrussee/caveman |
Eén keer installeren. Daarna in elke sessie gebruiken voor dat installatiedoel. One rock. That it.
Auto-activering is belangrijk. Claude Code, Codex en Gemini CLI activeren Caveman automatisch elke sessie — Claude Code gebruikt SessionStart hooks (automatisch geconfigureerd via plugin-installatie), Codex wordt geleverd met .codex/hooks.json, en Gemini CLI pikt het op via het GEMINI.md-contextbestand. Voor Cursor, Windsurf, Cline en Copilot installeert npx skills add het skillbestand maar koppelt geen auto-start hooks. Je moet ofwel elke sessie "use caveman mode" zeggen of dit altijd-aan-fragment in je systemprompt plakken:
Terse like caveman. Technical substance exact. Only fluff die. Drop: articles, filler
(just/really/basically), pleasantries, hedging. Fragments OK. Short synonyms. Code unchanged.
Pattern: [thing] [action] [reason]. [next step]. ACTIVE EVERY RESPONSE. No revert after many
turns. No filler drift. Code/commits/PRs: normal. Off: 'stop caveman' / 'normal mode'.
Standalone hooks (zonder de plugin): Als je liever niet de volledige plugin op Claude Code installeert, kun je alleen de hooks installeren:
# macOS / Linux / WSL
bash <(curl -s https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.sh)

# Windows PowerShell
irm https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.ps1 | iex
Stap 2: Activeer Je Gewenste Intensiteit
In Claude Code of Gemini CLI gebruik je /caveman gevolgd door het niveau:
/caveman lite    # Leesbare compressie, behoudt zinsstructuur
/caveman full    # Standaard — fragmenten, geen lidwoorden, maximaal signaal
/caveman ultra   # Telegraafmodus, absoluut minimum tokens
Wenyan-modi zijn ook beschikbaar — /caveman wenyan-lite, /caveman wenyan en /caveman wenyan-ultra — voor ontwikkelaars die klassiek Chinees kunnen lezen en maximale compressie willen. Modi blijven actief tot het einde van de sessie of een expliciete wijziging.
In Codex is het equivalent $caveman. Voor agents zonder ondersteuning voor slash-commando's (Cline, Copilot) werken activatiefrases gewoon in het gesprek: "talk like caveman," "use caveman mode," of "less tokens please."
Feature-ondersteuning verschilt per agent:
| Feature | Claude Code | Codex | Gemini CLI | Cursor | Windsurf | Cline | Copilot |
|---|---|---|---|---|---|---|---|
| Caveman mode | Ja | Ja | Ja | Ja | Ja | Ja | Ja |
| Auto-activeren elke sessie | Ja | Ja | Ja | Handmatig | Handmatig | Handmatig | Handmatig |
/caveman commando |
Ja | $caveman |
Ja | — | — | — | — |
| Mode wisselen (lite/full/ultra) | Ja | Ja | Ja | Ja | Ja | — | — |
| Statusbalk-badge | Ja | — | — | — | — | — | — |
Stap 3: Kies Je Intensiteit Op Basis Van De Taak
Dit is waar de meeste gebruikers het fout doen. Ze kiezen één intensiteit en houden daar voor alles aan vast. Stem de modus af op het werk:
Lite mode voor:
- Documentatie genereren die andere mensen gaan lezen
- Commitberichten schrijven die in gedeelde changelogs terechtkomen
- Elke output die je in een Slack-bericht of e-mail gaat plakken
Full mode voor:
- Actieve codeersessies (features bouwen, refactoren, debuggen)
- Code reviews waarbij jij de enige lezer bent
- Architectuurdiscussies waar je snelle antwoorden nodig hebt
- Alles waarbij de output voornamelijk code met uitleg is
Ultra mode voor:
- Repetitieve taken met voorspelbare outputformaten
- Snelle statuscontroles en opzoekingen
- Taken waar je een ja/nee- of enkelvoudig antwoord nodig hebt
- Batchbewerkingen waarbij je veel vergelijkbare verzoeken verwerkt
Stap 4: Comprimeer Je Contextbestanden
De caveman-compress-extensie herschrijft je natuurlijke taalconfiguratiebestanden — CLAUDE.md, systemprompts, skilldefinities — in gecomprimeerde caveman-stijl, waardoor ongeveer 46% van de input tokens uit je persistente context wordt gesneden. Het bewaart originelen als .original.md-back-ups zodat je nooit de menselijk leesbare versie kwijtraakt. Het model begrijpt gecomprimeerde instructies even goed als uitgebreide.
Belangrijke tip: Zelfs met de automatische back-up bewaar ik een aparte .human-kopie van elk gecomprimeerd bestand zodat ik wijzigingen kan maken in leesbaar formaat en opnieuw kan comprimeren. Beknopte caveman-stijl instructies bewerken wanneer je een nieuwe regel moet toevoegen is lastiger dan normaal proza bewerken.
Stap 5: Deactiveer Wanneer Nodig
stop caveman
Of zeg simpelweg "normal mode." De omschakeling is direct. Ik zet caveman ruwweg 3-4 keer per dag uit — altijd om dezelfde redenen: iets uitleggen aan een collega, documentatie schrijven, of een probleem over meerdere bestanden debuggen waarbij ik Claude zijn volledige redeneerketen nodig heb.
Als je liever hebt dat iemand deze hele setup bouwt — Caveman-configuratie, aangepaste CLAUDE.md-optimalisatie, modelroutering en agentkosten-management — helemaal op maat voor jouw workflow, dan neem ik precies dat soort projecten aan op fiverr.com/s/EgxYmWD.
Waar Caveman Tekortschiet — De Eerlijke Beoordeling
Ik draai Caveman nu al weken op verschillende intensiteiten, en er zijn duidelijke faalscenario's die de hype niet noemt.
De input token-valkuil bij korte gesprekken. Ik heb dit behandeld in het kostengedeelte, maar het verdient herhaling omdat het de meest voorkomende valkuil is. Als je typische interactie één prompt en één antwoord is, kan de input-overhead van Caveman (het laden van het skillbestand) ervoor zorgen dat je meer uitgeeft dan baseline. De besparingen materialiseren zich alleen in meerdere beurten tellende sessies waar prompt caching de inputkosten amortiseert. Voor geïsoleerde, eenmalige vragen krijg je met een simpele "Be concise"-instructie in je systemprompt 39% outputreductie met nul input-overhead.
Complexe problemen over meerdere bestanden debuggen. Wanneer een bug vier bestanden en drie services beslaat, heb ik nodig dat Claude door zijn redeneerketen heen loopt. Waarom keek het eerst in dit bestand? Wat elimineerde de andere mogelijkheden? Caveman schrapt het redeneerverbindingsweefsel dat die walkthrough te volgen maakt. Voor complexe debugging schakel ik elke keer over naar normale modus.
Onboarding en kennisoverdracht. Als je Claude gebruikt om uitleg te genereren voor junior ontwikkelaars of teamgenoten die niet bekend zijn met de codebase, is caveman-output te gecomprimeerd. De verbindingswoorden die caveman schrapt — "omdat," "wat betekent dat," "daarom" — zijn precies de woorden die minder ervaren lezers helpen de logische keten te volgen.
Wenyan mode is een curiositeit, geen gereedschap. Voor de overgrote meerderheid van ontwikkelaars is output in klassiek Chinees onleesbaar. Het is een indrukwekkende demonstratie van compressiepotentieel en een leuk experiment, maar tenzij je vloeiend bent in literair Chinees, blijft het in de categorie "leuk feesttrucje."
Het getal van 45% heeft context nodig. Die 45% outputreductie geldt voor proza-antwoorden — de verklarende tekst tussen codeblokken. Aangezien codeblokken en tool calls onaangetast blijven (terecht), is de werkelijke reductie over een volledige codeersessie kleiner. Afhankelijk van hoe code-intensief je workflow is, landen de real-world sessiebesparingen dichter bij 15-25% op totale output. Nog steeds significant. Gewoon niet 45% van je hele rekening.
Geen van deze punten is een dealbreaker. Het zijn grenzen. De skill is oprecht nuttig binnen die grenzen en oprecht contraproductief erbuiten. De grens kennen is belangrijker dan doen alsof die niet bestaat.
Het Cumulatieve Effect: Wat Er Verandert Over Een Maand
Laat me je de berekening geven die er echt toe doet — niet besparingen per prompt, maar hoe een maand Caveman eruitziet voor iemand die LLMs intensief gebruikt.
Mijn gebruik bedraagt ruwweg $200/maand over Claude- en Codex-sessies. Ik doe gemiddeld 30-40 taken per dag in uitgebreide codeersessies, waarbij de meeste sessies 10-20 vervolgprompts bevatten.
Directe output tokenbesparingen: Ongeveer 20-25% reductie op totale sessie-output tokens (rekening houdend met onaangetaste codeblokken). Bij mijn gebruiksniveau is dat $15-20/maand.
Indirecte besparingen door minder beurten: In mijn tests vereisten Caveman-antwoorden gemiddeld 0,6 minder vervolgbeurten per taak. Met 35 dagelijkse taken is dat ruwweg 21 minder beurten per dag. Elke beurt kost ongeveer 2.000-3.000 tokens. Over een maand is dat nog eens 1,2-1,8 miljoen tokens bespaard — waardoor de totale besparingen dichter bij $25-30/maand komen.
Tijdsbesparing door minder opvultekst te lezen: Beknopte antwoorden zijn sneller te scannen. Ik schat 15-20 minuten besparing per dag doordat ik geen opvultekst hoef te lezen. Dat is 7-10 uur per maand. Mijn uurtarief maakt die uren vele malen meer waard dan de tokenbesparingen.
Nauwkeurigheidsverbetering: In lijn met de onderzoekspatronen zag ik ruwweg 5-7% verbetering in het slagingspercentage bij de eerste poging op codeertaken met Caveman actief. Minder mislukte eerste pogingen betekent minder correctiecycli, wat minder tokens en minder tijd betekent.
Gecombineerde maandelijkse impact: Ruwweg $25-30 aan directe tokenbesparingen, 7-10 uur teruggewonnen tijd, en meetbaar minder correctiecycli. Voor een tool die één commando kost om te installeren en nul doorlopende moeite.
Die cijfers klinken op geen enkele dag dramatisch. Over een jaar is het $300+ aan tokenbesparingen en 100+ uur aan tijd. Van één npm-commando.
Voor ontwikkelaars die meerdere agents draaien of teams beheren waar meerdere mensen dagelijks LLM-tools gebruiken, vermenigvuldig die cijfers dienovereenkomstig. Een organisatie die Claude Code agent-teams draait over vijf ontwikkelaars zou $1.500+ aan jaarlijkse tokenbesparingen en 500+ uur aan teruggewonnen leestijd zien. Dat is het moment waarop een gratis GitHub-skill eruitziet als een legitieme operationele optimalisatie.
Het Principe Dat De Tool Overleeft
De Caveman skill zal uiteindelijk overbodig worden. Anthropic en OpenAI zijn zich beiden bewust van het breedsprakigheidsprobleem — Anthropic's documentatie over het beheren van Claude Code-kosten beveelt beknopt prompten al aan als primaire kostenhefboom. Vroeg of laat zullen modellen worden geleverd met standaard beknoptheid gekalibreerd voor technische contexten. Het onderzoek is te duidelijk om te negeren. Wanneer een trainingsaanpak aantoonbaar de nauwkeurigheid vermindert door breedsprakigheid aan te moedigen, wordt het op modelniveau oplossen ervan een economische noodzaak.
Maar het principe achter Caveman — dat beknoptheid de nauwkeurigheid verbetert, dat beknoptheidsbeperkingen RLHF-geïnduceerde overelaboratie bestrijden, dat minder tokens betere antwoorden kunnen betekenen — dat principe zal elke specifieke tool die erop gebouwd is overleven.
Dit is wat ik ben gaan doen, zelfs zonder Caveman geactiveerd. Ik heb veranderd hoe ik elke systemprompt schrijf, elk CLAUDE.md-bestand, elke agentinstructie. Ik val standaard terug op beknopt. Ik schrap aarzeltaal uit mijn eigen prompts. Ik specificeer outputformaatbeperkingen die voorkomen dat het model zijn antwoorden opvult. En het kwaliteitsverschil is merkbaar bij elk model dat ik gebruik.
Als je maar één ding meeneemt uit dit artikel, neem dan dit: voeg één regel toe aan welke systeemconfiguratie je ook gebruikt met je LLM.
Be concise. No filler. No hedging. State conclusions first, reasoning second.
Die enkele instructie, ondersteund door onderzoek dat een correlatie van -0,59 aantoont tussen tokentelling en nauwkeurigheid, zal je outputs verbeteren bij Claude, GPT, Codex, Gemini — elk model dat lijdt aan de universele RLHF-breedsprakigheidsbias. Je hebt de Caveman skill niet nodig om te profiteren van het Caveman-principe.
Maar als je de volledige compressie wilt, de intensiteitsmodi, de commit- en review-extensies en de inputbestand-compressietool? De skill is één commando verwijderd. En elke prompt na de eerste wordt goedkoper.
De duurste token is niet degene op je rekening. Het is degene die de fout introduceerde waar je twintig minuten naar zocht — begraven in een aarzeling, verpakt in een nuancering, verstopt in een breedsprakig antwoord dat zelfverzekerd en grondig klonk en stilletjes, kostbaar fout was.
Veelgestelde Vragen
Werkt de Caveman skill met andere LLMs dan Claude?
Ja. Hoewel Caveman begon als een Claude Code-plugin, werkt het met meer dan 40 AI-agents waaronder Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot en Cline. Claude Code, Codex en Gemini CLI krijgen volledige auto-activeringsondersteuning. Specifiek voor Claude Code: claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman. Voor andere agents: npx skills add JuliusBrussee/caveman -a [agent-name].
Hoeveel verlaagt Caveman de totale LLM-kosten daadwerkelijk?
Voor enkele prompts zijn de besparingen marginaal of licht negatief door input token-overhead van het laden van het skillbestand. Voor sessies met meerdere beurten en prompt caching bereiken de totale kostenbesparingen ongeveer 39%. Real-world codeersessies zien doorgaans 15-25% totale outputreductie aangezien codeblokken onaangetast blijven. Voor het volledige kostenoptimalisatieplaatje, zie mijn AI agent kostenoptimalisatiegids.
Kan het minder breedsprakig maken van LLMs de nauwkeurigheid daadwerkelijk verbeteren?
Een paper uit maart 2026 evalueerde 31 modellen over 1.485 problemen en ontdekte dat beknoptheidsbeperkingen de nauwkeurigheid van grote modellen met 26 procentpunten verbeterden op benchmarks waar breedsprakigheid fouten veroorzaakte. Het mechanisme — spontane schaalafhankelijke breedsprakigheid — zorgt ervoor dat grotere modellen overelaboreren en fouten introduceren door buitensporig aarzelen en tangentieel redeneren.
Wat is Wenyan mode in de Caveman skill?
Wenyan mode geeft antwoorden in klassieke Chinese karakters, de meest token-efficiënte geschreven taal die mensen hebben gecreëerd. Het dient als een maximale compressiemodus voor tweetalige ontwikkelaars die literair Chinees kunnen lezen. Voor de meeste Engelstalige ontwikkelaars is het een fascinerende demonstratie van compressiegrenzen in plaats van een praktisch dagelijks gereedschap.
Is er een eenvoudiger alternatief voor de volledige Caveman skill?
Voeg dit toe aan je systemprompt of CLAUDE.md: "Be concise. No filler. No hedging. State conclusions first, reasoning second." Dit bereikt ruwweg 39% output tokenreductie vergeleken met de 45% van Caveman, met vrijwel identieke nauwkeurigheidsvoordelen en nul input token-overhead. De volledige skill voegt gestructureerde regels, intensiteitsniveaus en begeleidende tools toe die de resterende compressie eruit persen.
Laten We Samenwerken
Op zoek naar het bouwen van AI-systemen, het automatiseren van workflows of het opschalen van je technische infrastructuur? Ik help graag.
- Fiverr (maatwerk builds & integraties): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (enterprise-oplossingen): ramlit.com
- ColorPark (design & branding): colorpark.io
- xCyberSecurity (beveiligingsdiensten): xcybersecurity.io