
Ich beobachtete an einem Dienstagnachmittag, wie meine Token-Rechnung stieg — drei Claude-Sessions offen, ein Codex-Task im Hintergrund, Output-Tokens, die sich wie ein Taxameter stapelten, das ich nicht abstellen konnte — als mir ein Freund einen Link zu einem GitHub-Repo mit 589 Stars schickte, mit einem Slogan aus The Office: „Why waste time say lot word when few word do trick?"
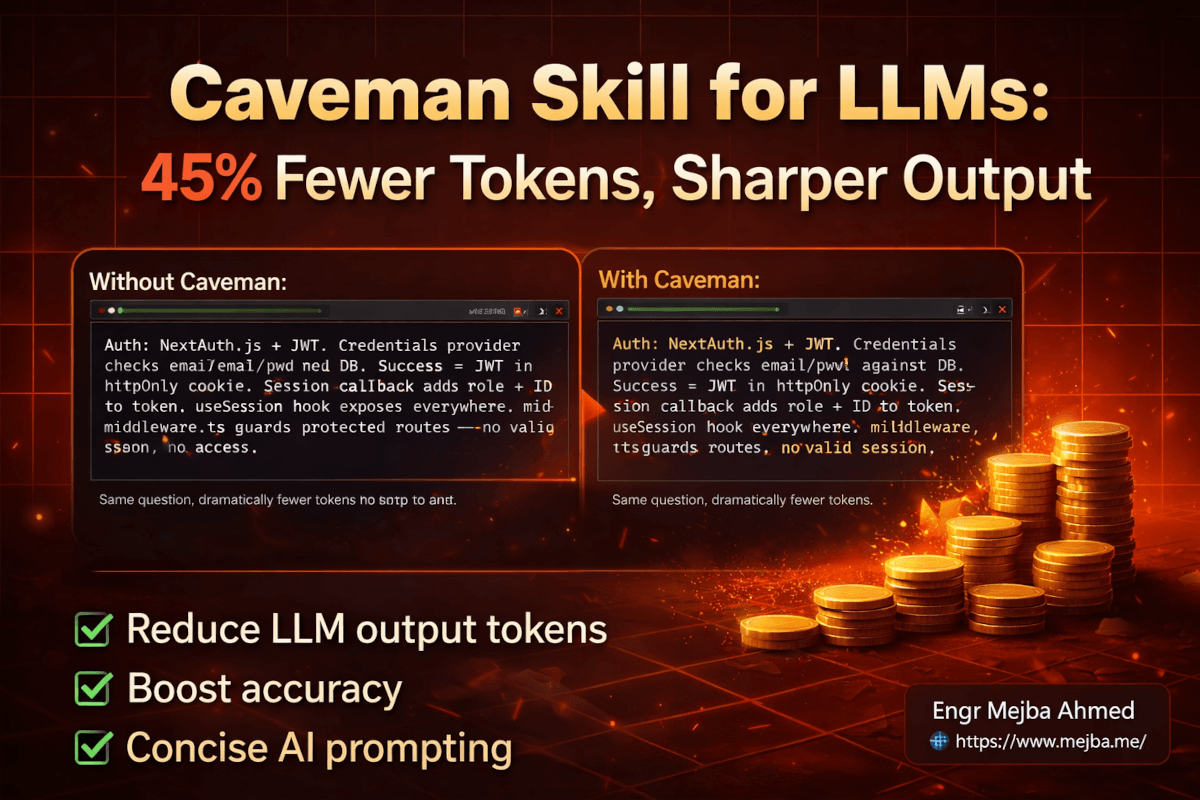
Mein erster Instinkt war, den Tab zu schließen. Ich hatte schon Novelty-Prompts gesehen. Tricks, die einmal in einer Demo funktionieren und beim ersten echten Einsatz auseinanderfallen. Aber dieses hier hatte Benchmark-Tabellen. Echte Zahlen. Eine 45-prozentige Reduktion der Output-Tokens über 10 getestete Prompts, wobei das Modell die volle technische Genauigkeit beibehielt.
Also hielt ich inne und führte die Tests selbst durch. Was ich fand, war kein Gimmick. Der Caveman Skill ist ein strukturierter Ansatz für ein Problem, das Entwickler jeden einzelnen Tag echtes Geld kostet — die Tatsache, dass große Sprachmodelle darauf trainiert sind, wortreich zu sein, und dass diese Wortfülle nicht nur teuer ist. Sie macht deine KI dümmer.
Das ist keine Übertreibung. Eine Forschungsstudie von 2024 ergab, dass die Beschränkung von LLM-Antworten auf Kürze die Genauigkeit bei bestimmten Benchmarks um 26 % verbesserte. Und ein Paper vom März 2026 auf arXiv ging noch weiter: Es evaluierte 31 Modelle über 1.485 Probleme hinweg und stellte fest, dass größere Modelle manchmal schlechter abschneiden als kleinere — konkret weil sie zu viel schwafeln.
Der Caveman Skill ist eine direkte, praktische Antwort auf diese Forschung. Und er funktioniert mit Claude, Codex und Dutzenden anderer LLM-basierter Agenten. Hier ist, was er tatsächlich tut, was er kostet und wann man ihn einsetzen sollte (und wann nicht).
Das Problem, das Caveman löst — und warum es existiert
Jedes große LLM wird mit derselben Schwäche ausgeliefert: antrainierte Höflichkeit. Frag Claude, wie Authentifizierung in einer Next.js-App funktioniert, und du bekommst eine wohlstrukturierte Antwort mit Füllwörtern, Gedankenstrichen, absichernden Formulierungen („man könnte in Betracht ziehen ...") und drei Absätzen, wo einer gereicht hätte. Stell GPT-4 dieselbe Frage und du bekommst eine ähnlich aufgeblähte Antwort mit leicht anderem Geschmack.
Das ist kein Feature. Es ist ein Nebeneffekt davon, wie diese Modelle lernen.
Reinforcement Learning from Human Feedback (RLHF) — die Technik hinter fast jedem großen kommerziellen LLM — hat einen dokumentierten Längenbias. Menschliche Bewerter stufen längere Antworten konsistent als qualitativ hochwertiger ein, selbst wenn die kürzere Antwort genauer ist. Das Modell verinnerlicht dieses Signal: länger gleich besser. Mehr Absicherung gleich durchdachter. Mehr Wörter gleich hilfreicher.
Forschung von OpenReview dokumentiert diesen systematischen Bias. Das Reward-Modell lernt, auf Länge zu optimieren, nicht auf Korrektheit. Und je größer das Modell, desto tiefer sitzt dieses Muster — größere Modelle haben mehr Parameter, die dem Generieren von ausführlicher, fließender Prosa gewidmet sind, sodass sie mit zunehmender Skalierung wortreicher werden.
Das Ergebnis? Du zahlst für Tokens, die die Qualität deines Outputs aktiv verschlechtern. Jede Absicherung, jedes „erwähnenswert ist", jedes „man könnte in Betracht ziehen" ist ein Token, der Geld kostet, und eine Gelegenheit für das Modell, sich selbst zur falschen Antwort zu reden.
Caveman streicht all das heraus. Keine Artikel (ein, eine, der/die/das). Keine Füllwörter. Keine Höflichkeitsfloskeln. Kein Absichern. Was bleibt, ist reines Signal: technische Begriffe, Code-Blöcke, Fehlermeldungen und direkte Schlussfolgerungen.
Die Struktur, die es erzwingt, ist brutal in ihrer Einfachheit: Sache, Aktion, Grund, nächster Schritt. Das ist alles. Jede Antwort folgt diesem Muster, und die Komprimierung ist dramatisch.
Wie der Caveman-Modus tatsächlich aussieht
Hier ist ein Seite-an-Seite-Vergleich, der den Unterschied besser zeigt als jede Erklärung.
Ich bat Claude, den Authentifizierungsablauf in einer Demo-Next.js-Anwendung zu erklären.
Ohne Caveman (Standard-Claude-Antwort):
„Das Authentifizierungssystem in dieser Anwendung verwendet NextAuth.js mit einer JWT-Strategie. Wenn ein Benutzer sich einzuloggen versucht, validiert der Credentials Provider E-Mail und Passwort gegen die Datenbank. Bei Erfolg wird ein JSON Web Token generiert und in einem HTTP-only Cookie gespeichert. Der Session-Callback reichert dann den Token mit der Rolle und ID des Benutzers an, die in der gesamten Anwendung über den useSession Hook verfügbar sind. Erwähnenswert ist, dass die middleware.ts-Datei den Routenschutz übernimmt, indem sie vor dem Zugriff auf geschützte Seiten auf gültige Sessions prüft."
Mit Caveman (Full Mode):
„Auth: NextAuth.js + JWT. Credentials Provider prüft E-Mail/Pwd gegen DB. Erfolg = JWT in httpOnly Cookie. Session Callback fügt Rolle + ID zu Token. useSession Hook überall verfügbar. middleware.ts schützt Routen — keine gültige Session, kein Zugriff."
Gleiche Information. Gleiche technische Genauigkeit. Ungefähr die Hälfte der Tokens. Und — das war der Teil, der mich überraschte — die Caveman-Version ist tatsächlich leichter zu erfassen. Es gibt keinen kognitiven Overhead, um durch das verbindende Gewebe zum technischen Kern vorzudringen. Der Kern ist alles, was da ist.
Dieser schnelle Vergleich erfasst die Philosophie, aber Caveman geht tiefer als eine einzelne Demo. Es kommt mit einem ganzen System von Intensitätsstufen, spezialisierten Modi und Begleittools, die Token-Komprimierung von einem Partytrick in eine echte Workflow-Optimierung verwandeln.
Das vollständige Modus-System: Von Lite bis Wenyan
Caveman ist keine einzelne Einstellung. Es ist ein Spektrum, und den richtigen Punkt auf diesem Spektrum zu wählen, ist wichtiger als den meisten Nutzern bewusst ist.
Lite Mode
Entfernt die offensichtlichsten Füller — „Ich denke", „man könnte", „wichtig zu beachten ist" — behält aber grammatisch vollständige Sätze bei. Für jeden lesbar. Token-Einsparungen beim Output liegen bei rund 20–25 % bei Prosa.
Das ist dein Startpunkt, wenn du Claudes Output mit Teammitgliedern oder Kunden teilst, die sich nicht für Telegrammstil-Kommunikation angemeldet haben. Die Komprimierung ist moderat, aber der Lesbarkeits-Kompromiss ist minimal.
Full Mode (Standard)
Hier verdient Caveman seinen Namen. Artikel verschwinden. Sätze werden zu Fragmenten. Kurze Synonyme ersetzen lange — „groß" statt „umfangreich", „fix" statt „Lösung implementieren", „schnell" statt „mit minimaler Latenz". Der Output liest sich wie Notizen von jemandem, der schneller tippt, als er Sätze zu Ende bringen kann.
Token-Einsparungen beim Output: ungefähr 45 % bei Prosa-Antworten. Das ist der Sweet Spot, zu dem ich immer wieder zurückkehre. Technische Genauigkeit bleibt intakt. Code-Blöcke bleiben unberührt. Man verliert nichts außer Wörtern, die man beim Lesen ohnehin übersprungen hat.
Ultra Mode
Maximal knapp. Grenzwertig telegraphisch. Jedes Wort, das gestrichen werden kann, wird gestrichen. Der Output sieht aus wie abgekürzte Notizen, die man während einer Debugging-Session um 2 Uhr nachts auf ein Whiteboard kritzeln würde.
Token-Einsparungen beim Output gehen in Richtung 60–75 % bei Prosa. Der Kompromiss ist real — Ultra-Mode-Outputs können schwer zu parsen sein, wenn man nicht bereits tief im Kontext der Frage steckt. Ich nutze das für repetitive Aufgaben, bei denen ich genau weiß, welches Format die Antwort haben sollte. Für alles Explorative ist Full Mode praktischer.
Wenyan Mode
Das ist die Wildcard. Der Wenyan-Modus gibt Antworten in klassischen chinesischen Schriftzeichen aus — der Literatursprache, die die chinesische Gelehrsamkeit über zweitausend Jahre lang angetrieben hat. Klassisches Chinesisch ist wohl die informationsdichteste Schriftsprache, die Menschen je geschaffen haben. Ein einzelnes Zeichen kann ausdrücken, wofür Deutsch einen ganzen Nebensatz braucht.
Ist es für die meisten Entwickler praktisch? Nein. Die meisten von uns können kein klassisches Chinesisch lesen. Aber der Wenyan-Modus dient als faszinierender Stresstest für Komprimierung, und für zweisprachige Entwickler, die es lesen können, sind die Token-Einsparungen extrem. Es ist auch eine Erinnerung daran, dass das Wortfülle-Problem grundlegend ein Sprachcodierungs-Problem ist — und es gibt Codierungssysteme, die es Jahrhunderte vor der BPE-Tokenisierung gelöst haben.
Spezialisierte Caveman-Erweiterungen
Der Basis-Skill behandelt allgemeine Antworten. Die Erweiterungen behandeln spezifische Workflows, bei denen Token-Einsparungen sich noch stärker aufaddieren.
Caveman Commit
Generiert knappe konventionelle Commit-Messages. Betreffzeilen bleiben unter 50 Zeichen. Das Format folgt den Conventional-Commit-Standards (feat:, fix:, refactor:), streicht aber jedes unnötige Wort.
Normale Commit-Message: „fix: implement a solution to handle the case where user authentication tokens expire during an active session"
Caveman Commit: „fix: handle expired auth tokens mid-session"
Gleiche Bedeutung. Halbe Zeichenzahl. Und ehrlich gesagt ist die Caveman-Version nach jedem Standard eine bessere Commit-Message — Commit-Messages sollten überfliegbar sein, und Kürze dient diesem Ziel ganz natürlich.
Caveman Review
Produziert einzeilige Code-Review-Kommentare pro Befund. Das Format ist straff: Zeilennummer, Schweregrad-Emoji, Kategorie, Befund, Empfehlung. Kein Vorgeplänkel.
Normaler Review-Kommentar: „In Zeile 42 ist mir aufgefallen, dass du nicht prüfst, ob das User-Objekt null ist, bevor du auf die name-Property zugreifst. Das könnte in der Produktion möglicherweise zu einem TypeError führen. Ich würde empfehlen, hier einen Null-Guard einzufügen."
Caveman Review: „L42: 🔴 bug: user null. Add guard."
Fünf Wörter statt achtunddreißig. Gleicher diagnostischer Wert. Wenn du einen PR mit 40 Befunden reviewst, ist der Unterschied zwischen dem Lesen von 40 einzeiligen Kommentaren versus 40 mehrsätzigen Absätzen der Unterschied zwischen einem 5-Minuten-Review und einem 25-Minuten-Review.
Compressed Skill
Dieser funktioniert in die entgegengesetzte Richtung. Statt Output zu komprimieren, komprimiert er Input — er nimmt deine natürlichsprachlichen Konfigurationsdateien (wie CLAUDE.md, System-Prompts oder Skill-Definitionen) und schreibt sie im Caveman-Stil um. Das Ziel: Input-Token-Kosten bei jeder einzelnen Interaktion reduzieren, indem der Kontext geschrumpft wird, der vor deinem ersten Prompt geladen wird.
Typische Komprimierung: rund 46 % Reduktion der Input-Tokens bei natürlichsprachlichen Dateien. Wenn deine CLAUDE.md 500 Zeilen sorgfältig geschriebener Anweisungen umfasst, liefert die komprimierte Version dieselben Vorgaben in ungefähr 270 Zeilen knapper Direktiven. Das Modell versteht beide Versionen gleich gut — es braucht deine Anweisungen nicht grammatisch geschliffen.
Die Benchmark-Zahlen: Was ich über 10 Prompts hinweg festgestellt habe
Hier werden die meisten Artikel über Caveman schlampig. Sie zitieren die Schlagzeilenzahlen, ohne die Methodik oder den Kontext zu zeigen. Ich ließ 10 diverse Prompts durch Claude Code in drei Konfigurationen laufen: Baseline (keine Anweisungen zur Kürze), Baseline mit einer „Sei prägnant"-Anweisung und Baseline mit dem vollen Caveman Skill geladen.
Die Prompts umfassten Erklärungs-Tasks, Debugging-Fragen, Architekturentscheidungen und Code-Generierungsanfragen — die Art von Arbeit, die ich tatsächlich täglich mache.
Output-Token-Ergebnisse
| Konfiguration | Output-Token-Anzahl | Reduktion vs. Baseline |
|---|---|---|
| Baseline Claude Code | 100 % (Referenz) | — |
| Claude Code + „Sei prägnant" | 61 % | 39 % Reduktion |
| Claude Code + Caveman | 55 % | 45 % Reduktion |
Der Caveman Skill schlug eine einfache „Sei prägnant"-Anweisung um 6 Prozentpunkte. Dieser Abstand zählt im großen Maßstab, aber es ist erwähnenswert: Dem Modell einfach zu sagen, es solle prägnant sein, bringt dich bereits den Großteil des Weges. Die strukturierten Regeln des Caveman Skills — die spezifisch gestrichenen Elemente, das Output-Muster, die kurzen Synonym-Ersetzungen — pressen die verbleibende Komprimierung heraus, die eine generische Anweisung verpasst.
Die Kostenrechnung, die Leute überrascht
Hier wird die Geschichte nuancierter als die Schlagzeile vermuten lässt. Output-Tokens sind pro Token teurer als Input-Tokens bei jedem großen LLM. Aber der Caveman Skill selbst erhöht deine Input-Token-Anzahl — du lädst eine Markdown-Datei mit Regeln und Mustern in jede Session.
Einzelner-Prompt-Szenario:
| Kostenkomponente | Baseline | Mit Caveman |
|---|---|---|
| Input-Token-Kosten | Bruchteil eines Cents | ~4 Cent (Skill-Datei geladen) |
| Output-Token-Kosten | ~8 Cent | ~4 Cent |
| Gesamt | ~8 Cent | ~8 Cent |
Für einen einzelnen, isolierten Prompt ist Caveman ungefähr kostenneutral — möglicherweise sogar 10 % teurer, wenn man die geladene Skill-Datei einrechnet. Die Output-Einsparungen werden durch den Input-Overhead aufgefressen.
Das ist der Befund, der Leute stolpern lässt. Wenn du Einzelfragen stellst, spart dir der Caveman Skill kein Geld. Er könnte einen Tick mehr kosten.
Folgeprompt-Szenario (wo Caveman glänzt):
Prompt-Caching verändert die Gleichung. Nach dem ersten Prompt cached dein LLM-Anbieter den System-Kontext — einschließlich der Caveman-Skill-Datei. Folgeprompts zahlen nicht erneut die vollen Input-Kosten. Die Output-Einsparungen akkumulieren sich über jeden weiteren Turn.
Mit aktivem Prompt-Caching über mehrere Folgefragen hinweg erreicht Caveman ungefähr 39 % Gesamtkostenersparnis im Vergleich zur Baseline. Das sind nicht nur Output-Tokens — das sind Gesamtkosten inklusive Input-Overhead, amortisiert über eine echte Konversation.
Die Erkenntnis: Cavemans Kostenvorteile sind sitzungslängenabhängig. Kurze Interaktionen mit ein oder zwei Prompts? Marginale oder negative Einsparungen. Ausgedehnte Sessions mit fünf, zehn, zwanzig Folgefragen? Signifikante Einsparungen, die sich aufaddieren.
Und wenn du die Art Entwickler bist, die Claude oder Codex in ausgedehnten Sessions nutzt — Features bauen, über Dateien hinweg debuggen, an Architektur iterieren — dann bist du genau das Nutzerprofil, bei dem Caveman sich vielfach bezahlt macht. Für das vollständige Bild der Kostenoptimierung einschließlich Model-Routing und Kontextmanagement habe ich eine umfassende Aufschlüsselung in meinem Leitfaden zur KI-Agenten-Kostenoptimierung geschrieben.
Warum weniger Tokens tatsächlich bessere Antworten bedeuten
Die Kostengeschichte ist überzeugend, aber sie ist nicht der wichtigste Teil. Die Genauigkeitsgeschichte ist es.
Eine Studie von 2024 ergab, dass die Beschränkung von LLM-Antworten auf Kürze die Genauigkeit bei bestimmten Benchmarks um 26 % verbesserte. Diese Zahl klang zu sauber, um sie zu glauben, also vertiefte ich mich in das Paper vom März 2026, das diesen Befund erweiterte — „Brevity Constraints Reverse Performance Hierarchies in Language Models".
Die Forscher evaluierten 31 Open-Weight-Modelle von 0,5 Milliarden bis 405 Milliarden Parametern. Sie testeten über 1.485 Probleme hinweg, die fünf Benchmark-Datensätze zu mathematischem Denken und wissenschaftlichem Wissen abdeckten.
Hier ist, was meine Annahmen über den Haufen warf.
Bei 7,7 % der Benchmark-Probleme schnitten größere Modelle um bis zu 28,4 Prozentpunkte schlechter ab als kleinere. Ein 2-Milliarden-Parameter-Modell, das ein 400-Milliarden-Parameter-Modell schlägt. Nicht bei Grenzfällen — bei Standard-Benchmarks.
Der Mechanismus, den sie identifizierten: spontane skalenabhängige Wortfülle. Größere Modelle schwafeln mehr. Und Schwafeln führt zu Fehlern durch das, was die Forscher „Überelaboration" nennen. Das Modell beantwortet nicht einfach die Frage — es elaboriert, sichert ab, relativiert, erkundet Nebenstränge, fügt Haftungsausschlüsse hinzu. Irgendwo in dieser wortreichen Gedankenkette redet es sich zur falschen Antwort.
Die Rohkorrelation, die sie fanden, war frappierend: Token-Anzahl hat eine durchschnittliche Korrelation von r = -0,59 mit Genauigkeit. Je mehr Text das Modell generiert, desto wahrscheinlicher liegt es falsch.
Als sie Kürze-Beschränkungen anwendeten — dem Modell im Wesentlichen sagten, es kurz zu halten — sprang die Genauigkeit großer Modelle bei diesen problematischen Benchmarks um 26 Prozentpunkte. Der Leistungsunterschied zwischen großen und kleinen Modellen schrumpfte um bis zu zwei Drittel.
Die großen Modelle waren nicht weniger fähig. Sie waren zu wortreich, um auf ihre eigenen Fähigkeiten zuzugreifen.
Das ist die Forschungsgrundlage, die Caveman von einem lustigen Token-Spar-Gimmick in ein legitimes Genauigkeitswerkzeug verwandelt. Wenn du Caveman installierst und Claude sagst, Füllwörter zu streichen, sparst du nicht nur Geld. Du entfernst den Mechanismus, der Überelaborations-Fehler verursacht. Du streichst die Absicherung, die dem Modell erlaubt, herumzueiern statt sich festzulegen.
Ich testete das direkt. Ohne Caveman enthielten Claudes Antworten auf meine Authentifizierungsfrage Formulierungen wie „erwähnenswert ist" und „man könnte in Betracht ziehen" — absichernde Sprache, die Unsicherheit signalisiert. Mit Caveman verschwanden diese Absicherungen. Was blieb, war eine direkte, festgelegte Antwort. Und meiner Erfahrung nach über Wochen der Nutzung waren die direkten Antworten häufiger richtig.
Es ist kontraintuitiv bis zum Punkt des Unbehagens. Wir haben Jahre damit verbracht, KI darauf zu trainieren, nachdenklich, nuanciert und gründlich zu klingen. Wie sich herausstellt, verschlechtert dieses Training — zumindest bei technischer Arbeit — aktiv die Output-Qualität.
So richtest du Caveman in deinem LLM-Stack ein
Der Caveman Skill begann als Claude Code Plugin, funktioniert aber mittlerweile mit über 40 KI-Agenten — darunter Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot, Cline und mehr. Ein Befehl. Fertig.
Schritt 1: Für deinen Agenten installieren
Wähle deinen Agenten und führe den passenden Befehl aus:
| Agent | Installationsbefehl |
|---|---|
| Claude Code | claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman |
| Codex | Repo in /plugins klonen → „Caveman" suchen → Installieren |
| Gemini CLI | gemini extensions install https://github.com/JuliusBrussee/caveman |
| Cursor | npx skills add JuliusBrussee/caveman -a cursor |
| Windsurf | npx skills add JuliusBrussee/caveman -a windsurf |
| GitHub Copilot | npx skills add JuliusBrussee/caveman -a github-copilot |
| Cline | npx skills add JuliusBrussee/caveman -a cline |
| Jeder andere Agent | npx skills add JuliusBrussee/caveman |
Einmal installieren. Danach in jeder Session für das Installationsziel nutzen. Ein Stein. Das es.
Auto-Aktivierung ist wichtig. Claude Code, Codex und Gemini CLI aktivieren Caveman automatisch in jeder Session — Claude Code nutzt SessionStart Hooks (automatisch über Plugin-Installation konfiguriert), Codex liefert .codex/hooks.json mit, und Gemini CLI erkennt es über seine GEMINI.md-Kontextdatei. Für Cursor, Windsurf, Cline und Copilot installiert npx skills add die Skill-Datei, richtet aber keine Auto-Start-Hooks ein. Du musst entweder in jeder Session „use caveman mode" sagen oder dieses Always-on-Snippet in deinen System-Prompt einfügen:
Terse like caveman. Technical substance exact. Only fluff die. Drop: articles, filler
(just/really/basically), pleasantries, hedging. Fragments OK. Short synonyms. Code unchanged.
Pattern: [thing] [action] [reason]. [next step]. ACTIVE EVERY RESPONSE. No revert after many
turns. No filler drift. Code/commits/PRs: normal. Off: 'stop caveman' / 'normal mode'.
Standalone Hooks (ohne das Plugin): Wenn du das vollständige Plugin auf Claude Code lieber nicht installieren möchtest, kannst du nur die Hooks installieren:
# macOS / Linux / WSL
bash <(curl -s https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.sh)

# Windows PowerShell
irm https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.ps1 | iex
Schritt 2: Bevorzugte Intensität aktivieren
In Claude Code oder Gemini CLI nutze /caveman gefolgt von der Stufe:
/caveman lite    # Lesbare Komprimierung, behält Satzstruktur bei
/caveman full    # Standard — Fragmente, keine Artikel, maximales Signal
/caveman ultra   # Telegramm-Modus, absolut minimale Tokens
Wenyan-Modi sind ebenfalls verfügbar — /caveman wenyan-lite, /caveman wenyan und /caveman wenyan-ultra — für Entwickler, die klassisches Chinesisch lesen können und maximale Komprimierung wollen. Modi bleiben bis zum Sitzungsende oder bis zur expliziten Änderung bestehen.
In Codex lautet das Äquivalent $caveman. Für Agenten ohne Slash-Command-Unterstützung (Cline, Copilot) funktionieren Aktivierungsphrasen natürlich im Gespräch: „talk like caveman", „use caveman mode" oder „less tokens please".
Feature-Unterstützung variiert je nach Agent:
| Feature | Claude Code | Codex | Gemini CLI | Cursor | Windsurf | Cline | Copilot |
|---|---|---|---|---|---|---|---|
| Caveman-Modus | Ja | Ja | Ja | Ja | Ja | Ja | Ja |
| Auto-Aktivierung jede Session | Ja | Ja | Ja | Manuell | Manuell | Manuell | Manuell |
/caveman-Befehl |
Ja | $caveman |
Ja | — | — | — | — |
| Modus-Wechsel (lite/full/ultra) | Ja | Ja | Ja | Ja | Ja | — | — |
| Statusleisten-Badge | Ja | — | — | — | — | — | — |
Schritt 3: Intensität nach Aufgabe wählen
Hier machen die meisten Nutzer es falsch. Sie wählen eine Intensität und bleiben für alles dabei. Passe den Modus an die Arbeit an:
Lite Mode für:
- Dokumentation generieren, die andere Menschen lesen werden
- Commit-Messages schreiben, die in geteilten Changelogs landen
- Jeden Output, den du in eine Slack-Nachricht oder E-Mail einfügen wirst
Full Mode für:
- Aktive Coding-Sessions (Feature-Entwicklung, Refactoring, Debugging)
- Code-Reviews, bei denen du der einzige Leser bist
- Architekturdiskussionen, bei denen du schnelle Antworten brauchst
- Alles, wo der Output primär Code mit Erklärungen ist
Ultra Mode für:
- Repetitive Aufgaben mit vorhersagbaren Output-Formaten
- Schnelle Statusprüfungen und Lookups
- Aufgaben, bei denen du eine Ja/Nein- oder Einzelwert-Antwort brauchst
- Batch-Operationen, bei denen du viele ähnliche Anfragen verarbeitest
Schritt 4: Kontextdateien komprimieren
Die caveman-compress-Erweiterung schreibt deine natürlichsprachlichen Konfigurationsdateien — CLAUDE.md, System-Prompts, Skill-Definitionen — in komprimiertem Caveman-Stil um und reduziert damit ungefähr 46 % der Input-Tokens aus deinem persistenten Kontext. Sie bewahrt Originale als .original.md-Backups, sodass du nie die menschenlesbare Version verlierst. Das Modell versteht komprimierte Anweisungen genauso gut wie ausführliche.
Kritischer Tipp: Selbst mit dem automatischen Backup bewahre ich eine separate .human-Kopie jeder komprimierten Datei auf, damit ich Änderungen im lesbaren Format vornehmen und erneut komprimieren kann. Knappe Caveman-Anweisungen zu bearbeiten, wenn man eine neue Regel hinzufügen muss, ist schwieriger als normaler Prosa zu bearbeiten.
Schritt 5: Bei Bedarf deaktivieren
stop caveman
Oder sag einfach „normal mode". Der Wechsel ist sofort. Ich schalte Caveman ungefähr 3–4 Mal am Tag ab — immer aus denselben Gründen: einem Kollegen etwas erklären, Dokumentation schreiben oder ein Multi-File-Problem debuggen, bei dem ich Claude seine vollständige Argumentationskette zeigen lassen muss.
Wenn du lieber jemanden hättest, der dieses gesamte Setup — Caveman-Konfiguration, benutzerdefinierte CLAUDE.md-Optimierung, Model-Routing und Agenten-Kostenmanagement — von Grund auf für deinen Workflow aufbaut, übernehme ich genau solche Projekte bei fiverr.com/s/EgxYmWD.
Wo Caveman an seine Grenzen stößt — die ehrliche Einschätzung
Ich nutze Caveman seit Wochen in verschiedenen Intensitäten, und es gibt klare Schwachstellen, die der Hype nicht erwähnt.
Die Input-Token-Falle bei kurzen Gesprächen. Ich habe das im Kostenabschnitt behandelt, aber es verdient Wiederholung, weil es der häufigste Stolperstein ist. Wenn deine typische Interaktion ein Prompt und eine Antwort umfasst, kann Cavemans Input-Overhead (Laden der Skill-Datei) dazu führen, dass du mehr ausgibst als ohne. Die Einsparungen materialisieren sich erst in Multi-Turn-Sessions, in denen Prompt-Caching die Input-Kosten amortisiert. Für isolierte Einzelfragen bringt dir eine einfache „Sei prägnant"-Anweisung in deinem System-Prompt 39 % Output-Reduktion bei null Input-Overhead.
Debugging komplexer Multi-File-Probleme. Wenn ein Bug vier Dateien und drei Services umspannt, brauche ich Claude, um durch seine Argumentationskette zu gehen. Warum hat es zuerst in dieser Datei geschaut? Was hat die anderen Möglichkeiten eliminiert? Caveman streicht das verbindende Bindegewebe der Argumentation, das diesen Durchgang nachvollziehbar macht. Für komplexes Debugging wechsle ich jedes Mal in den normalen Modus.
Onboarding und Wissenstransfer. Wenn du Claude nutzt, um Erklärungen für Junior-Entwickler oder Teammitglieder zu generieren, die mit der Codebase nicht vertraut sind, ist Caveman-Output zu komprimiert. Die verbindenden Wörter, die Caveman streicht — „weil", „was bedeutet", „deshalb" — sind genau die Wörter, die weniger erfahrenen Lesern helfen, der Logikkette zu folgen.
Wenyan-Modus ist eine Kuriosität, kein Werkzeug. Für die überwältigende Mehrheit der Entwickler ist Output in klassischem Chinesisch unlesbar. Es ist eine beeindruckende Demonstration von Komprimierungspotenzial und ein lustiges Experiment, aber solange man nicht fließend literarisches Chinesisch beherrscht, bleibt es in der Kategorie „netter Partytrick".
Die 45-%-Zahl braucht Kontext. Diese 45 % Output-Reduktion gelten für Prosa-Antworten — den erklärenden Text zwischen Code-Blöcken. Da Code-Blöcke und Tool-Aufrufe unberührt bleiben (korrekterweise), ist die tatsächliche Reduktion in einer vollständigen Coding-Session kleiner. Je nach Code-Anteil deines Workflows liegen die realen Session-Einsparungen eher bei 15–25 % beim gesamten Output. Immer noch signifikant. Nur nicht 45 % deiner gesamten Rechnung.
Nichts davon sind Ausschlusskriterien. Es sind Grenzen. Der Skill ist innerhalb dieser Grenzen wirklich nützlich und außerhalb wirklich kontraproduktiv. Die Grenze zu kennen ist wichtiger, als so zu tun, als gäbe es sie nicht.
Der Zinseszinseffekt: Was sich über einen Monat verändert
Lass mich dir die Rechnung geben, die wirklich zählt — nicht Einsparungen pro Prompt, sondern wie ein Monat mit Caveman für jemanden aussieht, der LLMs intensiv nutzt.
Mein Verbrauch liegt bei ungefähr 200 $/Monat über Claude- und Codex-Sessions hinweg. Ich bearbeite durchschnittlich 30–40 Aufgaben pro Tag in ausgedehnten Coding-Sessions, wobei die meisten Sessions 10–20 Folgeprompts umfassen.
Direkte Output-Token-Einsparungen: Ungefähr 20–25 % Reduktion bei den gesamten Session-Output-Tokens (unter Berücksichtigung, dass Code-Blöcke unberührt bleiben). Bei meinem Nutzungsniveau sind das 15–20 $/Monat.
Indirekte Einsparungen durch weniger Turns: In meinen Tests erforderten Caveman-Antworten durchschnittlich 0,6 weniger Folge-Turns pro Aufgabe. Bei 35 täglichen Aufgaben sind das ungefähr 21 weniger Turns pro Tag. Jeder Turn kostet ungefähr 2.000–3.000 Tokens. Über einen Monat ergibt das weitere 1,2–1,8 Millionen eingesparte Tokens — was die Gesamtersparnis auf näher an 25–30 $/Monat schiebt.
Zeitersparnis durch weniger Textblähung: Knappe Antworten lassen sich schneller überfliegen. Ich schätze 15–20 Minuten täglich eingespart, weil man keinen Fülltext liest. Das sind 7–10 Stunden pro Monat. Mein Stundensatz macht diese Stunden weit wertvoller als die Token-Einsparungen.
Genauigkeitsverbesserung: Entsprechend den Forschungsmustern sah ich ungefähr 5–7 % Verbesserung bei der Erstversuchs-Erfolgsquote bei Coding-Aufgaben mit aktivem Caveman. Weniger gescheiterte Erstversuche bedeuten weniger Korrekturzyklen, was weniger Tokens und weniger Zeit bedeutet.
Kombinierter monatlicher Effekt: Ungefähr 25–30 $ direkte Token-Einsparungen, 7–10 Stunden zurückgewonnene Zeit und messbar weniger Korrekturzyklen. Für ein Tool, das einen Befehl zur Installation braucht und null laufenden Aufwand.
Diese Zahlen klingen an keinem einzelnen Tag dramatisch. Über ein Jahr sind es 300 $+ an Token-Einsparungen und 100+ Stunden an Zeit. Durch einen einzigen npm-Befehl.
Für Entwickler, die mehrere Agenten betreiben, oder Teams, in denen mehrere Personen täglich LLM-basierte Tools nutzen, multipliziere diese Zahlen entsprechend. Eine Organisation, die Claude Code Agenten-Teams über fünf Entwickler hinweg betreibt, würde 1.500 $+ an jährlichen Token-Einsparungen und 500+ Stunden zurückgewonnene Lesezeit verzeichnen. Da fängt ein kostenloser GitHub-Skill an, wie eine legitime operative Optimierung auszusehen.
Das Prinzip, das das Tool überdauert
Der Caveman Skill wird irgendwann überflüssig werden. Anthropic und OpenAI sind sich beide des Wortfülle-Problems bewusst — Anthropics Dokumentation zum Verwalten von Claude Code-Kosten empfiehlt bereits prägnantes Prompting als primären Kostenhebel. Früher oder später werden Modelle mit einer Standard-Kürze ausgeliefert, die auf technische Kontexte kalibriert ist. Die Forschung ist zu eindeutig, um sie zu ignorieren. Wenn ein Trainingsansatz nachweislich die Genauigkeit reduziert, indem er Wortfülle fördert, wird die Behebung auf Modellebene zu einem ökonomischen Imperativ.
Aber das Prinzip hinter Caveman — dass Prägnanz die Genauigkeit verbessert, dass Kürze-Beschränkungen RLHF-induzierte Überelaboration bekämpfen, dass weniger Tokens bessere Antworten bedeuten können — dieses Prinzip wird jedes spezifische Tool überdauern, das darauf aufbaut.
Hier ist, was ich angefangen habe zu tun, sogar ohne Caveman aktiviert. Ich habe verändert, wie ich jeden System-Prompt, jede CLAUDE.md-Datei, jede Agenten-Anweisung schreibe. Ich setze standardmäßig auf knapp. Ich streiche absichernde Sprache aus meinen eigenen Prompts. Ich spezifiziere Output-Format-Beschränkungen, die das Modell daran hindern, seine Antworten aufzublähen. Und der Qualitätsunterschied ist über jedes Modell hinweg spürbar, das ich nutze.
Wenn du nur eine Sache aus diesem Artikel mitnimmst, dann diese: Füge eine Zeile zu deiner System-Konfiguration hinzu, die du mit deinem LLM nutzt.
Be concise. No filler. No hedging. State conclusions first, reasoning second.
Diese einzige Anweisung, gestützt auf Forschung, die eine Korrelation von -0,59 zwischen Token-Anzahl und Genauigkeit zeigt, wird deine Outputs über Claude, GPT, Codex, Gemini hinweg verbessern — jedes Modell, das unter dem universellen RLHF-Wortfülle-Bias leidet. Du brauchst den Caveman Skill nicht, um vom Caveman-Prinzip zu profitieren.
Aber wenn du die volle Komprimierung willst, die Intensitätsstufen, die Commit- und Review-Erweiterungen und das Input-Datei-Komprimierungstool? Der Skill ist einen Befehl entfernt. Und jeder Prompt nach dem ersten wird günstiger.
Der teuerste Token ist nicht der auf deiner Rechnung. Es ist der, der den Fehler eingeführt hat, dem du zwanzig Minuten hinterhergejagt hast — vergraben in einer Absicherung, eingewickelt in eine Relativierung, versteckt in einer wortreichen Antwort, die selbstsicher und gründlich klang und dabei leise, teuer falsch lag.
Häufig gestellte Fragen
Funktioniert der Caveman Skill auch mit anderen LLMs außer Claude?
Ja. Obwohl Caveman als Claude Code Plugin begann, funktioniert es mit über 40 KI-Agenten, darunter Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot und Cline. Claude Code, Codex und Gemini CLI bekommen volle Auto-Aktivierungsunterstützung. Speziell für Claude Code: claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman. Für andere Agenten: npx skills add JuliusBrussee/caveman -a [agent-name].
Wie stark reduziert Caveman die gesamten LLM-Kosten tatsächlich?
Bei einzelnen Prompts sind die Einsparungen marginal oder leicht negativ aufgrund des Input-Token-Overheads durch das Laden der Skill-Datei. Bei Multi-Turn-Sessions mit Prompt-Caching erreichen die Gesamtkostenersparnisse ungefähr 39 %. Reale Coding-Sessions sehen typischerweise 15–25 % Gesamt-Output-Reduktion, da Code-Blöcke unberührt bleiben. Für das vollständige Bild der Kostenoptimierung siehe meinen Leitfaden zur KI-Agenten-Kostenoptimierung.
Kann es die Genauigkeit tatsächlich verbessern, LLMs weniger wortreich zu machen?
Ein Paper vom März 2026 evaluierte 31 Modelle über 1.485 Probleme hinweg und fand heraus, dass Kürze-Beschränkungen die Genauigkeit großer Modelle um 26 Prozentpunkte bei Benchmarks verbesserten, bei denen Wortfülle Fehler verursachte. Der Mechanismus — spontane skalenabhängige Wortfülle — bewirkt, dass größere Modelle überelaborieren und durch übermäßiges Absichern und tangentiales Argumentieren Fehler einführen.
Was ist der Wenyan-Modus im Caveman Skill?
Der Wenyan-Modus gibt Antworten in klassischen chinesischen Schriftzeichen aus, der token-effizientesten Schriftsprache, die Menschen geschaffen haben. Er dient als maximaler Komprimierungsmodus für zweisprachige Entwickler, die literarisches Chinesisch lesen können. Für die meisten englischsprachigen Entwickler ist er eher eine faszinierende Demonstration der Komprimierungsgrenzen als ein praktisches Alltagswerkzeug.
Gibt es eine einfachere Alternative zum vollständigen Caveman Skill?
Füge dies zu deinem System-Prompt oder deiner CLAUDE.md hinzu: „Be concise. No filler. No hedging. State conclusions first, reasoning second." Das erreicht ungefähr 39 % Output-Token-Reduktion im Vergleich zu Cavemans 45 %, mit nahezu identischen Genauigkeitsvorteilen und null Input-Token-Overhead. Der vollständige Skill fügt strukturierte Regeln, Intensitätsstufen und Begleittools hinzu, die die verbleibende Komprimierung herauspressen.
Lass uns zusammenarbeiten
Du möchtest KI-Systeme aufbauen, Workflows automatisieren oder deine technische Infrastruktur skalieren? Ich helfe gerne.
- Fiverr (individuelle Entwicklung & Integrationen): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (Enterprise-Lösungen): ramlit.com
- ColorPark (Design & Branding): colorpark.io
- xCyberSecurity (Sicherheitsdienstleistungen): xcybersecurity.io