
Je regardais ma facture de tokens grimper un mardi après-midi — trois sessions Claude ouvertes, une tâche Codex tournant en arrière-plan, les output tokens s'accumulant comme un compteur de taxi que je ne pouvais pas arrêter — quand un ami m'a envoyé un lien vers un dépôt GitHub avec 589 étoiles et un slogan emprunté à The Office : "Why waste time say lot word when few word do trick?"
Mon premier réflexe a été de fermer l'onglet. J'avais déjà vu des prompts fantaisistes. Des astuces qui marchent une fois en démo et s'effondrent dès qu'on leur confie du vrai travail. Mais celui-ci avait des tableaux de benchmarks. De vrais chiffres. Une réduction de 45 % des output tokens sur 10 prompts testés, le modèle maintenant une précision technique complète.
Alors j'ai tout arrêté et j'ai lancé les tests moi-même. Ce que j'ai trouvé n'était pas un gadget. La compétence Caveman est une approche structurée d'un problème qui coûte de l'argent réel aux développeurs chaque jour — le fait que les grands modèles de langage sont entraînés à être verbeux, et que cette verbosité n'est pas seulement coûteuse. Elle rend votre IA plus bête.
Ce n'est pas de l'hyperbole. Une étude de 2024 a montré que contraindre les réponses des LLMs à être brèves améliorait la précision de 26 % sur des benchmarks spécifiques. Et un article de mars 2026 sur arXiv est allé plus loin, évaluant 31 modèles sur 1 485 problèmes et découvrant que les modèles plus grands sous-performent parfois les plus petits — précisément parce qu'ils divaguent trop.
La compétence Caveman est une réponse directe et pratique à cette recherche. Et elle fonctionne avec Claude, Codex et des dizaines d'autres agents alimentés par des LLMs. Voici ce qu'elle fait concrètement, ce qu'elle coûte, et quand vous devriez (ou ne devriez pas) l'utiliser.
Le problème que Caveman résout — et pourquoi il existe
Chaque grand LLM est livré avec la même affliction : la politesse entraînée. Demandez à Claude d'expliquer l'authentification dans une application Next.js, et vous obtiendrez une réponse bien structurée avec des mots de remplissage, des tirets cadratins, des formules hésitantes ("vous pourriez envisager de..."), et trois paragraphes là où un seul suffirait. Posez la même question à GPT-4 et vous obtiendrez une réponse tout aussi gonflée avec un assaisonnement légèrement différent.
Ce n'est pas une fonctionnalité. C'est un effet secondaire de la façon dont ces modèles apprennent.
Le Reinforcement Learning from Human Feedback (RLHF) — la technique derrière presque tous les grands LLMs commerciaux — a un biais de longueur documenté. Les annotateurs humains évaluent systématiquement les réponses plus longues comme étant de meilleure qualité, même quand la réponse courte est plus exacte. Le modèle intériorise ce signal : plus long égale mieux. Plus d'hésitation égale plus de réflexion. Plus de mots égale plus d'utilité.
La recherche publiée sur OpenReview documente ce biais systématique. Le modèle de récompense apprend à optimiser la longueur, pas l'exactitude. Et plus le modèle est grand, plus ce schéma est ancré — les modèles plus grands ont plus de paramètres dédiés à la génération de prose élaborée et fluide, ils deviennent donc plus verbeux à mesure qu'ils grandissent.
Le résultat ? Vous payez pour des tokens qui nuisent activement à la qualité de vos réponses. Chaque hésitation, chaque "il convient de noter que", chaque "vous pourriez envisager de" est un token qui coûte de l'argent et une occasion pour le modèle de se convaincre lui-même de la mauvaise réponse.
Caveman élimine tout cela. Plus d'articles (un, une, le, la). Plus de mots de remplissage. Plus de formules de politesse. Plus d'hésitations. Ce qui reste, c'est du signal pur : termes techniques, blocs de code, messages d'erreur et conclusions directes.
La structure qu'il impose est d'une simplicité brutale : chose, action, raison, prochaine étape. C'est tout. Chaque réponse suit ce schéma, et la compression est spectaculaire.
À quoi ressemble réellement le mode Caveman
Voici une comparaison côte à côte qui montre la différence mieux que n'importe quelle explication.
J'ai demandé à Claude d'expliquer le flux d'authentification dans une application Next.js de démonstration.
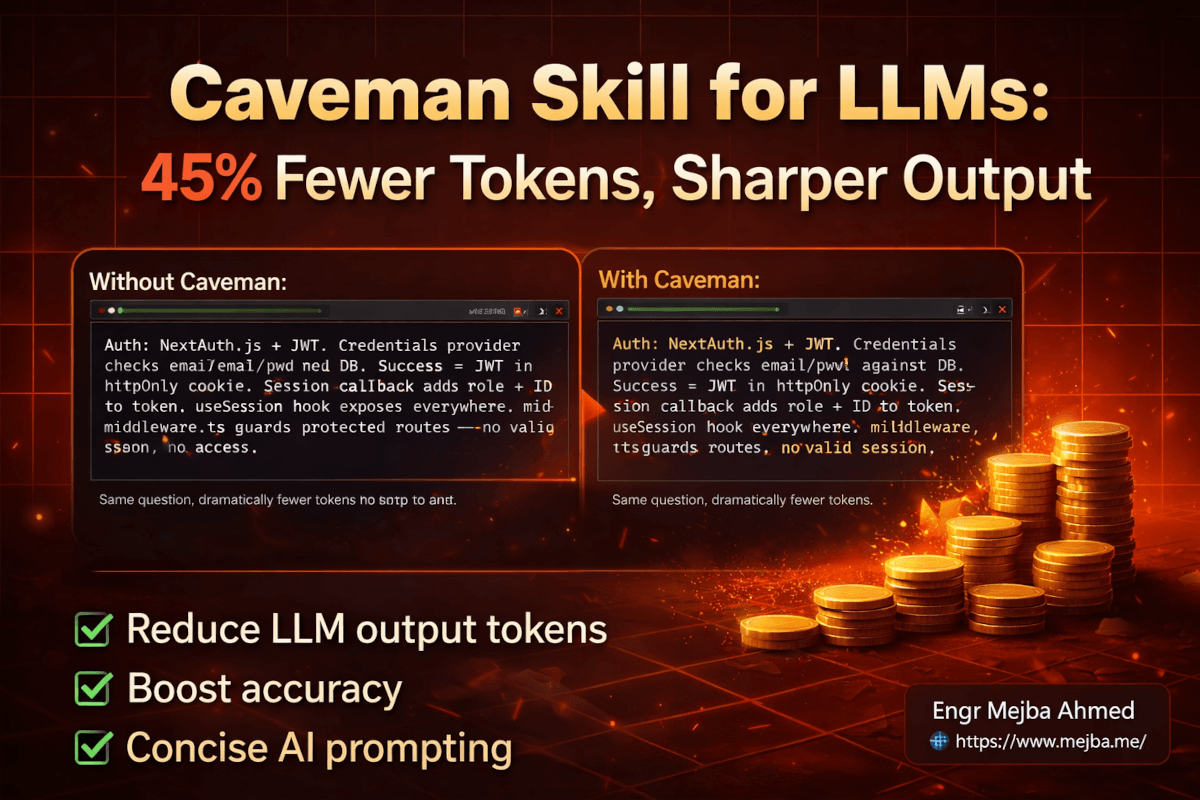
Sans Caveman (réponse standard de Claude) :
"The authentication system in this application uses NextAuth.js with a JWT strategy. When a user attempts to log in, the credentials provider validates the email and password against the database. If successful, a JSON Web Token is generated and stored in an HTTP-only cookie. The session callback then enriches the token with the user's role and ID, which are made available throughout the application via the useSession hook. It's worth noting that the middleware.ts file handles route protection by checking for valid sessions before allowing access to protected pages."
Avec Caveman (mode full) :
"Auth: NextAuth.js + JWT. Credentials provider checks email/pwd against DB. Success = JWT in httpOnly cookie. Session callback adds role + ID to token. useSession hook exposes everywhere. middleware.ts guards protected routes — no valid session, no access."
Même information. Même précision technique. Environ la moitié des tokens. Et — c'est la partie qui m'a surpris — la version Caveman est en fait plus facile à lire. Il n'y a pas de surcharge cognitive pour filtrer le tissu conjonctif et trouver la substance technique. La substance est tout ce qui reste.
Cette comparaison rapide capture la philosophie, mais Caveman va plus loin qu'une simple démo. Il est livré avec tout un système de niveaux d'intensité, de modes spécialisés et d'outils compagnons qui transforment la compression de tokens d'un tour de passe-passe en une véritable optimisation de workflow.
Le système de modes complet : de Lite à Wenyan
Caveman n'est pas un réglage unique. C'est un spectre, et choisir le bon point sur ce spectre compte plus que la plupart des utilisateurs ne le réalisent.
Mode Lite
Supprime le remplissage le plus évident — "je pense", "vous pourriez vouloir", "il est important de noter" — mais conserve des phrases grammaticalement complètes. Lisible par tout le monde. L'économie de tokens en output tourne autour de 20-25 % sur la prose.
C'est votre point de départ si vous partagez les réponses de Claude avec des coéquipiers ou des clients qui n'ont pas signé pour une communication style télégraphe. La compression est modeste mais le compromis en lisibilité est minimal.
Mode Full (par défaut)
C'est là que Caveman mérite son nom. Les articles disparaissent. Les phrases deviennent des fragments. Les synonymes courts remplacent les longs — "gros" au lieu de "considérable", "fix" au lieu de "implémenter une solution", "rapide" au lieu de "avec une latence minimale". Le résultat se lit comme les notes de quelqu'un qui tape plus vite qu'il ne peut finir ses phrases.
Économie de tokens en output : environ 45 % sur les réponses en prose. C'est le point d'équilibre auquel je reviens toujours. La précision technique reste intacte. Les blocs de code ne sont pas touchés. Vous ne perdez rien sauf des mots que vous survoliez déjà à la lecture.
Mode Ultra
Maximalement concis. Quasi télégraphique. Chaque mot qui peut être coupé est coupé. Le résultat ressemble à des notes abrégées que vous gribouilleriez sur un tableau blanc pendant une session de débogage à 2 heures du matin.
L'économie de tokens en output atteint 60-75 % sur la prose. Le compromis est réel — les réponses en mode ultra peuvent être difficiles à analyser si vous n'êtes pas déjà plongé dans le contexte de votre question. J'utilise ce mode pour les tâches répétitives où je sais exactement quel format la réponse doit prendre. Pour tout ce qui est exploratoire, le mode full est plus pratique.
Mode Wenyan
C'est le joker. Le mode Wenyan génère des réponses en caractères chinois classiques — la langue littéraire qui a porté l'érudition chinoise pendant plus de deux mille ans. Le chinois classique est sans doute la langue écrite la plus dense en information que les humains aient jamais créée. Un seul caractère peut exprimer ce qui prend une proposition entière en anglais.
Est-ce pratique pour la plupart des développeurs ? Non. La plupart d'entre nous ne savent pas lire le chinois classique. Mais le mode Wenyan sert de test de résistance fascinant pour la compression, et pour les développeurs bilingues capables de le lire, l'économie de tokens est extrême. C'est aussi un rappel que le problème de verbosité est fondamentalement un problème d'encodage de langue — et qu'il existe des systèmes d'encodage qui l'ont résolu des siècles avant que la tokenisation BPE n'existe.
Extensions Caveman spécialisées
La compétence de base gère les réponses générales. Les extensions gèrent des workflows spécifiques où les économies de tokens se composent encore davantage.
Caveman Commit
Génère des messages de commit conventionnels concis. Les lignes de sujet restent sous 50 caractères. Le format suit les standards de commit conventionnel (feat:, fix:, refactor:) mais élimine chaque mot inutile.
Message de commit normal : "fix: implement a solution to handle the case where user authentication tokens expire during an active session"
Commit Caveman : "fix: handle expired auth tokens mid-session"
Même signification. Moitié moins de caractères. Et honnêtement, la version caveman est un meilleur message de commit selon n'importe quel standard — les messages de commit doivent pouvoir être parcourus rapidement, et la brièveté sert naturellement cet objectif.
Caveman Review
Produit des commentaires de revue de code en une ligne par constat. Le format est serré : numéro de ligne, émoji de sévérité, catégorie, constat, recommandation. Pas de préambule.
Commentaire de revue normal : "On line 42, I noticed that you're not checking whether the user object is null before accessing the name property. This could potentially lead to a TypeError in production. I'd recommend adding a null guard here."
Revue Caveman : "L42: 🔴 bug: user null. Add guard."
Cinq mots au lieu de trente-huit. Même valeur diagnostique. Quand vous relisez une PR avec 40 constatations, la différence entre lire 40 commentaires d'une ligne et 40 paragraphes de plusieurs phrases, c'est la différence entre une revue de 5 minutes et une revue de 25 minutes.
Compressed Skill
Celle-ci fonctionne dans le sens inverse. Au lieu de compresser l'output, elle compresse l'input — en prenant vos fichiers de configuration en langage naturel (comme CLAUDE.md, les prompts système ou les définitions de compétences) et en les réécrivant en style caveman. L'objectif : réduire les coûts de tokens en input à chaque interaction en réduisant le contexte chargé avant votre premier prompt.
Compression typique : environ 46 % de réduction des tokens en input pour les fichiers en langage naturel. Si votre CLAUDE.md fait 500 lignes d'instructions soigneusement rédigées, la version compressée délivre les mêmes contraintes en environ 270 lignes de directives concises. Le modèle comprend les deux versions aussi bien — il n'a pas besoin que vos instructions soient grammaticalement polies.
Les chiffres des benchmarks : ce que j'ai trouvé sur 10 prompts
C'est là que la plupart des articles sur Caveman deviennent approximatifs. Ils citent les chiffres phares sans montrer la méthodologie ni le contexte. J'ai passé 10 prompts diversifiés dans Claude Code en trois configurations : baseline (aucune instruction de brièveté), baseline avec une instruction "Be concise", et baseline avec la compétence Caveman complète chargée.
Les prompts couvraient des tâches d'explication, des questions de débogage, des décisions d'architecture et des demandes de génération de code — le genre de travail que je fais réellement au quotidien.
Résultats sur les tokens en output
| Configuration | Nombre de tokens en output | Réduction vs. Baseline |
|---|---|---|
| Claude Code baseline | 100 % (référence) | — |
| Claude Code + "Be concise" | 61 % | 39 % de réduction |
| Claude Code + Caveman | 55 % | 45 % de réduction |
La compétence Caveman a battu une simple instruction "Be concise" de 6 points de pourcentage. Cet écart compte à grande échelle, mais il faut le noter : simplement dire au modèle d'être concis vous amène déjà presque au même résultat. Les règles structurées de Caveman — les éléments spécifiquement supprimés, le schéma de réponse, les remplacements par des synonymes courts — extraient la compression restante qu'une instruction générique ne capture pas.
Le calcul de coût qui surprend les gens
C'est là que l'histoire devient plus nuancée que le titre ne le suggère. Les tokens en output sont plus chers par token que les tokens en input sur tous les grands LLMs. Mais la compétence Caveman elle-même s'ajoute à votre nombre de tokens en input — vous chargez un fichier markdown avec des règles et des schémas dans chaque session.
Scénario avec un seul prompt :
| Composante de coût | Baseline | Avec Caveman |
|---|---|---|
| Coût des tokens en input | Fraction d'un centime | ~4 centimes (fichier de compétence chargé) |
| Coût des tokens en output | ~8 centimes | ~4 centimes |
| Total | ~8 centimes | ~8 centimes |
Pour un prompt unique et isolé, Caveman est à peu près neutre en coût — voire 10 % plus cher quand on prend en compte le fichier de compétence chargé. Les économies sur l'output sont absorbées par le surcoût en input.
C'est la conclusion qui déroute les gens. Si vous posez des questions ponctuelles, la compétence Caveman ne vous fait pas économiser d'argent. Elle peut même coûter un peu plus.
Scénario avec des prompts de suivi (là où Caveman brille) :
Le prompt caching change l'équation. Après le premier prompt, votre fournisseur de LLM met en cache le contexte système — y compris le fichier de compétence Caveman. Les prompts de suivi ne paient plus le coût complet en input. Les économies sur l'output se composent à chaque tour suivant.
Avec le prompt caching actif sur plusieurs questions de suivi, Caveman atteint environ 39 % d'économies sur le coût total par rapport à la baseline. Ce n'est pas seulement les tokens en output — c'est le coût total incluant le surcoût en input, amorti sur une vraie conversation.
La conclusion : les avantages de coût de Caveman dépendent de la durée de la session. Interactions courtes avec un ou deux prompts ? Économies marginales ou négatives. Sessions prolongées avec cinq, dix, vingt relances ? Économies significatives qui se composent.
Et si vous êtes le type de développeur qui utilise Claude ou Codex en sessions prolongées — construisant des fonctionnalités, déboguant à travers des fichiers, itérant sur l'architecture — vous êtes exactement le profil d'utilisateur pour lequel Caveman se rentabilise plusieurs fois. Pour le tableau complet de l'optimisation des coûts incluant le routage de modèles et la gestion du contexte, j'ai écrit une analyse détaillée dans mon guide d'optimisation des coûts des agents IA.
Pourquoi moins de tokens signifie réellement de meilleures réponses
L'argument économique est convaincant, mais ce n'est pas le plus important. L'argument de la précision l'est.
Une étude de 2024 a montré que contraindre les réponses des LLMs à être brèves améliorait la précision de 26 % sur des benchmarks spécifiques. Ce chiffre me semblait trop propre pour être vrai, alors j'ai creusé l'article de mars 2026 qui a approfondi cette découverte — "Brevity Constraints Reverse Performance Hierarchies in Language Models".
Les chercheurs ont évalué 31 modèles open-weight allant de 0,5 milliard à 405 milliards de paramètres. Ils ont testé sur 1 485 problèmes couvrant cinq jeux de données de benchmark portant sur le raisonnement mathématique et les connaissances scientifiques.
Voici ce qu'ils ont trouvé qui a brisé mes hypothèses.
Sur 7,7 % des problèmes de benchmark, les modèles plus grands ont sous-performé les plus petits de jusqu'à 28,4 points de pourcentage. Un modèle de 2 milliards de paramètres battant un modèle de 400 milliards de paramètres. Pas sur des cas marginaux — sur des benchmarks standards.
Le mécanisme qu'ils ont identifié : la verbosité spontanée dépendante de l'échelle. Les modèles plus grands divaguent davantage. Et divaguer introduit des erreurs à travers ce que les chercheurs appellent la "surélaboration". Le modèle ne se contente pas de répondre à la question — il élabore, hésite, nuance, explore des tangentes, ajoute des avertissements. Quelque part dans cette chaîne de raisonnement verbeuse, il se convainc lui-même de la mauvaise réponse.
La corrélation brute qu'ils ont trouvée est frappante : le nombre de tokens a une corrélation moyenne de r = -0,59 avec la précision. Plus le modèle génère de texte, plus il a de chances de se tromper.
Quand ils ont appliqué des contraintes de brièveté — en demandant essentiellement au modèle de faire court — la précision des grands modèles a bondi de 26 points de pourcentage sur ces benchmarks problématiques. L'écart de performance entre grands et petits modèles s'est réduit de jusqu'à deux tiers.
Les grands modèles n'étaient pas moins capables. Ils étaient trop verbeux pour accéder à leurs propres capacités.
C'est la base de recherche qui transforme Caveman d'un gadget amusant d'économie de tokens en un véritable outil de précision. Quand vous installez Caveman et dites à Claude de supprimer les mots de remplissage, vous ne faites pas qu'économiser de l'argent. Vous supprimez le mécanisme qui cause les erreurs de surélaboration. Vous éliminez les hésitations qui permettent au modèle de tergiverser au lieu de s'engager sur une réponse.
J'ai testé cela directement. Sans Caveman, les réponses de Claude à ma question sur l'authentification incluaient des phrases comme "il convient de noter" et "vous pourriez envisager" — un langage hésitant qui signale l'incertitude. Avec Caveman, ces hésitations ont disparu. Ce qui restait était une réponse directe et engagée. Et d'après mon expérience sur plusieurs semaines d'utilisation, les réponses directes étaient correctes plus souvent.
C'est contre-intuitif au point d'en être inconfortable. Nous avons passé des années à entraîner l'IA à paraître réfléchie, nuancée et approfondie. Il s'avère que, pour le travail technique du moins, cet entraînement dégrade activement la qualité des réponses.
Comment configurer Caveman dans votre stack LLM
La compétence Caveman a commencé comme un plugin Claude Code, mais elle fonctionne maintenant avec plus de 40 agents IA — dont Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot, Cline et d'autres. Une commande. C'est fait.
Étape 1 : Installer pour votre agent
Choisissez votre agent et lancez la commande correspondante :
| Agent | Commande d'installation |
|---|---|
| Claude Code | claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman |
| Codex | Clone repo to /plugins → Search "Caveman" → Install |
| Gemini CLI | gemini extensions install https://github.com/JuliusBrussee/caveman |
| Cursor | npx skills add JuliusBrussee/caveman -a cursor |
| Windsurf | npx skills add JuliusBrussee/caveman -a windsurf |
| GitHub Copilot | npx skills add JuliusBrussee/caveman -a github-copilot |
| Cline | npx skills add JuliusBrussee/caveman -a cline |
| Tout autre agent | npx skills add JuliusBrussee/caveman |
Installez une fois. Utilisez dans chaque session pour cette cible d'installation ensuite. Un caillou. C'est tout.
L'auto-activation compte. Claude Code, Codex et Gemini CLI activent tous automatiquement Caveman à chaque session — Claude Code utilise des hooks SessionStart (configurés automatiquement via l'installation du plugin), Codex est livré avec .codex/hooks.json, et Gemini CLI le détecte via son fichier de contexte GEMINI.md. Pour Cursor, Windsurf, Cline et Copilot, npx skills add installe le fichier de compétence mais ne câble pas les hooks d'auto-démarrage. Vous devrez soit dire "use caveman mode" à chaque session, soit coller ce snippet permanent dans votre prompt système :
Terse like caveman. Technical substance exact. Only fluff die. Drop: articles, filler
(just/really/basically), pleasantries, hedging. Fragments OK. Short synonyms. Code unchanged.
Pattern: [thing] [action] [reason]. [next step]. ACTIVE EVERY RESPONSE. No revert after many
turns. No filler drift. Code/commits/PRs: normal. Off: 'stop caveman' / 'normal mode'.
Hooks autonomes (sans le plugin) : Si vous préférez ne pas installer le plugin complet sur Claude Code, vous pouvez installer uniquement les hooks :
# macOS / Linux / WSL
bash <(curl -s https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.sh)

# Windows PowerShell
irm https://raw.githubusercontent.com/JuliusBrussee/caveman/main/hooks/install.ps1 | iex
Étape 2 : Activer votre intensité préférée
Dans Claude Code ou Gemini CLI, utilisez /caveman suivi du niveau :
/caveman lite    # Compression lisible, conserve la structure des phrases
/caveman full    # Par défaut — fragments, pas d'articles, signal maximal
/caveman ultra   # Mode télégraphe, minimum absolu de tokens
Les modes Wenyan sont aussi disponibles — /caveman wenyan-lite, /caveman wenyan et /caveman wenyan-ultra — pour les développeurs capables de lire le chinois classique et souhaitant une compression maximale. Les modes persistent jusqu'à la fin de la session ou un changement explicite.
Dans Codex, l'équivalent est $caveman. Pour les agents sans support de commandes slash (Cline, Copilot), les phrases d'activation fonctionnent naturellement dans la conversation : "talk like caveman", "use caveman mode" ou "less tokens please".
Le support des fonctionnalités varie selon l'agent :
| Fonctionnalité | Claude Code | Codex | Gemini CLI | Cursor | Windsurf | Cline | Copilot |
|---|---|---|---|---|---|---|---|
| Mode Caveman | Oui | Oui | Oui | Oui | Oui | Oui | Oui |
| Auto-activation chaque session | Oui | Oui | Oui | Manuel | Manuel | Manuel | Manuel |
Commande /caveman |
Oui | $caveman |
Oui | — | — | — | — |
| Changement de mode (lite/full/ultra) | Oui | Oui | Oui | Oui | Oui | — | — |
| Badge dans la barre de statut | Oui | — | — | — | — | — | — |
Étape 3 : Choisir votre intensité en fonction de la tâche
C'est là que la plupart des utilisateurs se trompent. Ils choisissent une intensité et s'y tiennent pour tout. Adaptez le mode au travail :
Mode Lite pour :
- Générer de la documentation que d'autres humains liront
- Écrire des messages de commit destinés aux changelogs partagés
- Tout output que vous collerez dans un message Slack ou un email
Mode Full pour :
- Sessions de codage actives (développement de fonctionnalités, refactoring, débogage)
- Revues de code dont vous êtes le seul lecteur
- Discussions d'architecture où vous avez besoin de réponses rapides
- Tout ce dont le résultat est principalement du code avec des explications
Mode Ultra pour :
- Tâches répétitives avec des formats de sortie prévisibles
- Vérifications rapides de statut et recherches
- Tâches nécessitant une réponse oui/non ou une valeur unique
- Opérations par lot où vous traitez de nombreuses requêtes similaires
Étape 4 : Compresser vos fichiers de contexte
L'extension caveman-compress réécrit vos fichiers de configuration en langage naturel — CLAUDE.md, prompts système, définitions de compétences — en style caveman compressé, réduisant d'environ 46 % les tokens en input de votre contexte persistant. Elle préserve les originaux sous forme de sauvegardes .original.md pour que vous ne perdiez jamais la version lisible. Le modèle comprend les instructions compressées aussi bien que les instructions verbeuses.
Conseil important : Même avec la sauvegarde automatique, je garde une copie .human séparée de chaque fichier compressé pour pouvoir faire des modifications en format lisible et recompresser. Modifier des instructions concises en style caveman quand vous devez ajouter une nouvelle règle est plus difficile que de modifier de la prose normale.
Étape 5 : Désactiver quand nécessaire
stop caveman
Ou dites simplement "normal mode". Le changement est instantané. Je désactive caveman environ 3-4 fois par jour — toujours pour les mêmes raisons : expliquer quelque chose à un collaborateur, rédiger de la documentation, ou déboguer un problème multi-fichiers où j'ai besoin que Claude montre sa chaîne de raisonnement complète.
Si vous préférez que quelqu'un construise toute cette configuration — paramétrage Caveman, optimisation du CLAUDE.md personnalisé, routage de modèles et gestion des coûts des agents — de zéro pour votre workflow, j'accepte exactement ce type de projets sur fiverr.com/s/EgxYmWD.
Là où Caveman montre ses limites — l'évaluation honnête
J'utilise Caveman à différentes intensités depuis des semaines maintenant, et il y a des modes d'échec clairs que l'engouement ne mentionne pas.
Le piège des tokens en input sur les conversations courtes. J'ai couvert ce point dans la section coûts, mais cela mérite d'être répété car c'est le piège le plus fréquent. Si votre interaction typique est un prompt et une réponse, le surcoût en input de Caveman (chargement du fichier de compétence) peut vous faire dépenser plus qu'en baseline. Les économies ne se matérialisent que dans les sessions multi-tours où le prompt caching amortit le coût en input. Pour des questions ponctuelles isolées, une simple instruction "Be concise" dans votre prompt système vous donne 39 % de réduction en output avec zéro surcoût en input.
Le débogage de problèmes complexes multi-fichiers. Quand un bug traverse quatre fichiers et trois services, j'ai besoin que Claude déroule sa chaîne de raisonnement. Pourquoi a-t-il regardé ce fichier en premier ? Qu'est-ce qui a éliminé les autres possibilités ? Caveman supprime le tissu conjonctif du raisonnement qui rend ce déroulement compréhensible. Pour le débogage complexe, je repasse en mode normal à chaque fois.
L'onboarding et le transfert de connaissances. Si vous utilisez Claude pour générer des explications destinées à des développeurs juniors ou des coéquipiers peu familiers avec la codebase, les réponses caveman sont trop compressées. Les mots de liaison que caveman supprime — "parce que", "ce qui signifie", "par conséquent" — sont exactement les mots qui aident les lecteurs moins expérimentés à suivre la chaîne logique.
Le mode Wenyan est une curiosité, pas un outil. Pour la grande majorité des développeurs, la sortie en chinois classique est illisible. C'est une démonstration impressionnante du potentiel de compression et une expérience amusante, mais à moins de maîtriser le chinois littéraire, cela reste dans la catégorie "tour de magie sympathique".
Le chiffre de 45 % nécessite du contexte. Cette réduction de 45 % des tokens en output s'applique aux réponses en prose — le texte explicatif entre les blocs de code. Comme les blocs de code et les appels d'outils ne sont pas touchés (à juste titre), la réduction réelle sur une session de codage complète est plus faible. Selon l'intensité de code dans votre workflow, les économies réelles en session se situent plutôt entre 15 et 25 % sur le total des output. C'est toujours significatif. Simplement pas 45 % de votre facture entière.
Rien de tout cela n'est rédhibitoire. Ce sont des limites. La compétence est réellement utile à l'intérieur de ces limites et réellement contre-productive en dehors. Connaître la frontière compte plus que de prétendre qu'elle n'existe pas.
L'effet composé : ce qui change sur un mois
Laissez-moi vous donner le calcul qui compte vraiment — pas les économies par prompt, mais ce à quoi ressemble un mois de Caveman pour quelqu'un qui utilise intensivement les LLMs.
Mon utilisation tourne autour de 200 $/mois entre les sessions Claude et Codex. Je fais en moyenne 30 à 40 tâches par jour sur des sessions de codage prolongées, la plupart des sessions comprenant 10 à 20 prompts de suivi.
Économies directes sur les tokens en output : Environ 20-25 % de réduction sur le total des tokens en output de session (en tenant compte du fait que les blocs de code ne sont pas touchés). À mon niveau d'utilisation, cela représente 15-20 $/mois.
Économies indirectes grâce à moins de tours : Dans mes tests, les réponses Caveman nécessitaient en moyenne 0,6 tour de suivi en moins par tâche. Avec 35 tâches quotidiennes, cela représente environ 21 tours en moins par jour. Chaque tour coûte environ 2 000 à 3 000 tokens. Sur un mois, cela fait 1,2 à 1,8 million de tokens économisés en plus — poussant les économies totales plus près de 25-30 $/mois.
Temps économisé en lisant moins de remplissage : Les réponses concises se parcourent plus vite. J'estime 15 à 20 minutes gagnées par jour en ne lisant pas de texte de remplissage. Cela fait 7 à 10 heures par mois. Mon taux horaire rend ces heures bien plus précieuses que les économies de tokens.
Amélioration de la précision : En suivant les tendances de la recherche, j'ai observé environ 5-7 % d'amélioration du taux de réussite au premier essai sur les tâches de codage avec Caveman activé. Moins de premiers essais ratés signifie moins de cycles de correction, donc moins de tokens et moins de temps.
Impact mensuel combiné : Environ 25-30 $ d'économies directes en tokens, 7 à 10 heures de temps récupéré, et significativement moins de cycles de correction. Pour un outil qui s'installe en une commande et ne nécessite aucun effort continu.
Ces chiffres ne paraissent pas spectaculaires sur une journée. Sur un an, c'est plus de 300 $ d'économies en tokens et plus de 100 heures de temps. Pour une seule commande npm.
Pour les développeurs utilisant plusieurs agents ou gérant des équipes où plusieurs personnes utilisent quotidiennement des outils alimentés par des LLMs, multipliez ces chiffres en conséquence. Une organisation faisant tourner des équipes d'agents Claude Code avec cinq développeurs verrait plus de 1 500 $ d'économies annuelles en tokens et plus de 500 heures de temps de lecture récupéré. C'est à ce moment qu'une compétence GitHub gratuite commence à ressembler à une véritable optimisation opérationnelle.
Le principe qui survivra à l'outil
La compétence Caveman deviendra éventuellement inutile. Anthropic et OpenAI sont tous deux conscients du problème de verbosité — la documentation d'Anthropic sur la gestion des coûts de Claude Code recommande déjà le prompting concis comme levier principal de réduction des coûts. Tôt ou tard, les modèles seront livrés avec une brièveté par défaut calibrée pour les contextes techniques. La recherche est trop claire pour être ignorée. Quand une approche d'entraînement dégrade de manière démontrable la précision en encourageant la verbosité, la corriger au niveau du modèle devient un impératif économique.
Mais le principe derrière Caveman — que la concision améliore la précision, que les contraintes de brièveté combattent la surélaboration induite par le RLHF, que moins de tokens peut signifier de meilleures réponses — ce principe survivra à chaque outil spécifique construit dessus.
Voici ce que j'ai commencé à faire même sans Caveman activé. J'ai changé la façon dont j'écris chaque prompt système, chaque fichier CLAUDE.md, chaque instruction d'agent. Je privilégie le concis par défaut. Je supprime le langage hésitant de mes propres prompts. Je spécifie des contraintes de format de sortie qui empêchent le modèle de rembourrer ses réponses. Et la différence de qualité est notable sur tous les modèles que j'utilise.
Si vous ne retenez qu'une chose de cet article, retenez ceci : ajoutez une ligne à la configuration système que vous utilisez avec votre LLM.
Be concise. No filler. No hedging. State conclusions first, reasoning second.
Cette unique instruction, appuyée par la recherche montrant une corrélation de -0,59 entre le nombre de tokens et la précision, améliorera vos réponses avec Claude, GPT, Codex, Gemini — tout modèle souffrant du biais de verbosité universel du RLHF. Vous n'avez pas besoin de la compétence Caveman pour bénéficier du principe Caveman.
Mais si vous voulez la compression complète, les modes d'intensité, les extensions pour les commits et les revues, et l'outil de compression des fichiers d'input ? La compétence est à une commande de distance. Et chaque prompt après le premier devient moins cher.
Le token le plus coûteux n'est pas celui sur votre facture. C'est celui qui a introduit l'erreur que vous avez passé vingt minutes à traquer — enfouie dans une hésitation, enveloppée dans une nuance, cachée dans une réponse verbeuse qui semblait confiante et approfondie et qui était discrètement, coûteusement fausse.
Questions fréquemment posées
La compétence Caveman fonctionne-t-elle avec d'autres LLMs que Claude ?
Oui. Bien que Caveman ait commencé comme plugin Claude Code, il fonctionne avec plus de 40 agents IA dont Codex, Gemini CLI, Cursor, Windsurf, GitHub Copilot et Cline. Claude Code, Codex et Gemini CLI bénéficient du support complet d'auto-activation. Pour Claude Code spécifiquement : claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman. Pour les autres agents : npx skills add JuliusBrussee/caveman -a [agent-name].
Combien Caveman réduit-il réellement les coûts totaux des LLMs ?
Pour les prompts uniques, les économies sont marginales ou légèrement négatives en raison du surcoût en tokens d'input lié au chargement du fichier de compétence. Pour les sessions multi-tours avec prompt caching, les économies totales atteignent environ 39 %. Les sessions de codage réelles voient typiquement 15-25 % de réduction totale en output puisque les blocs de code restent intacts. Pour le tableau complet de l'optimisation des coûts, consultez mon guide d'optimisation des coûts des agents IA.
Rendre les LLMs moins verbeux peut-il réellement améliorer la précision ?
Un article de mars 2026 a évalué 31 modèles sur 1 485 problèmes et a constaté que les contraintes de brièveté amélioraient la précision des grands modèles de 26 points de pourcentage sur les benchmarks où la verbosité causait des erreurs. Le mécanisme — la verbosité spontanée dépendante de l'échelle — pousse les modèles plus grands à surélaborer et à introduire des erreurs par des hésitations excessives et des raisonnements tangentiels.
Qu'est-ce que le mode Wenyan dans la compétence Caveman ?
Le mode Wenyan génère des réponses en caractères chinois classiques, la langue écrite la plus efficace en tokens que les humains aient créée. Il sert de mode de compression maximale pour les développeurs bilingues capables de lire le chinois littéraire. Pour la plupart des développeurs francophones, c'est une démonstration fascinante des limites de la compression plutôt qu'un outil pratique au quotidien.
Existe-t-il une alternative plus simple à la compétence Caveman complète ?
Ajoutez ceci à votre prompt système ou votre CLAUDE.md : "Be concise. No filler. No hedging. State conclusions first, reasoning second." Cela permet d'atteindre environ 39 % de réduction des tokens en output contre 45 % pour Caveman, avec des avantages de précision quasi identiques et zéro surcoût en tokens d'input. La compétence complète ajoute des règles structurées, des niveaux d'intensité et des outils compagnons qui extraient la compression restante.
Travaillons ensemble
Vous cherchez à construire des systèmes IA, automatiser des workflows ou faire monter en charge votre infrastructure technologique ? Ce serait un plaisir de vous aider.
- Fiverr (développements sur mesure et intégrations) : fiverr.com/s/EgxYmWD
- Portfolio : mejba.me
- Ramlit Limited (solutions entreprise) : ramlit.com
- ColorPark (design et branding) : colorpark.io
- xCyberSecurity (services de sécurité) : xcybersecurity.io