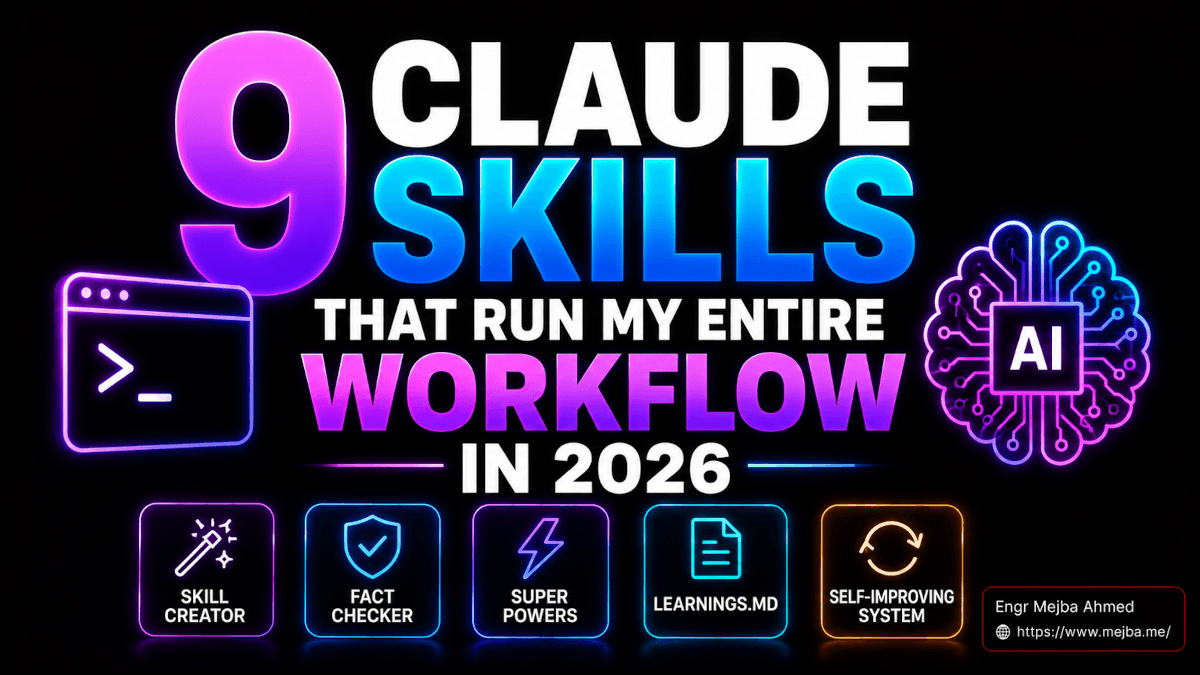
J'ai failli écrire une version différente de cet article. Le plan original était "10 compétences Claude que vous devez installer". J'avais la liste. J'avais les commandes d'installation. J'en étais à trois paragraphes lorsque j'ai réalisé que j'avais déjà écrit ce message deux fois : une fois en tant que guide d'installation des compétences et une fois en tant que répartition de l'écosystème de 33 compétences. Le monde n'a pas besoin d'une troisième liste d'installation de ma part.
Ce dont il pourrait avoir besoin, c'est de la réponse réelle à une question qu'on me pose sans cesse : quelles compétences utilisez-vous chaque jour et comment sont-elles connectées les unes aux autres ? Parce que l'installation de compétences est triviale. La partie la plus difficile – celle sur laquelle personne ne semble écrire – est de savoir comment un petit ensemble de compétences, utilisées ensemble, devient le système d’exploitation d’un ingénieur solo en activité.
C'est cette panne. Neuf compétences Claude qui ont survécu à mon filtrage, regroupées selon leur emplacement dans mon flux de travail. Certains sont évidents. L’un n’est pas évident. L’une d’elles n’est pas du tout une compétence au sens technique – c’est un modèle appelé learnings.md qui, je pense, est le plus gros déblocage de 2026, et je le garderai pour la fin car il change la façon dont vous devriez penser à toutes les autres compétences de la liste.
Avant d'aller plus loin : il y a plus de 500 000 compétences en circulation en mai 2026, et j'ai vu des développeurs en installer une trentaine en un après-midi, paniquer au bruit et tout désinstaller vendredi. Le nombre dont vous avez réellement besoin est plus proche de neuf. Peut-être moins.
Pourquoi les compétences de la plupart des gens sont brisées
Vérification rapide de la réalité avant la liste. J'ai audité les configurations Claude d'une vingtaine de personnes au cours des deux derniers mois : des amis, des clients, quelques ingénieurs de Discord qui ont demandé de l'aide. Le modèle est presque universel.
Ils disposent de dix-huit compétences installées. Ils en utilisent trois. Les quinze autres sont des poids morts qui gonflent leur fenêtre de contexte et créent une fatigue décisionnelle lorsque Claude doit choisir laquelle s'applique.
La bonne configuration semble différente. Cinq à neuf compétences, chacune avec un travail spécifique, chacune testée par rapport à un flux de travail réel dont dispose réellement l'utilisateur. Les compétences ne se font pas concurrence : elles se transmettent. Une compétence de recherche nourrit une compétence d’écriture. Une compétence rédactionnelle alimente une compétence de vérification des faits. Une compétence de vérification des faits nourrit une compétence humanisante. Il y a un flux, pas une pile.
C’est l’objectif que je veux que vous utilisiez lorsque vous lisez la liste. Don't ask "should I install this?" Demandez : « Où cela se situe-t-il par rapport aux compétences que j'utilise déjà ? »
Niveau 1 : les quatre compétences présentes dans le bureau Claude
Les quatre premiers ne nécessitent pas de code. Ils s'exécutent dans Claude Desktop, fonctionnent avec n'importe quel plan prenant en charge les compétences, et la plupart d'entre eux sont des outils à installer une fois et à utiliser pour toujours. Si vous n'êtes pas un développeur, ce niveau est votre point de départ.
1. Skill Creator – La compétence qui développe les compétences
J'avais l'habitude d'écrire des compétences à la dure. J'ouvrirais un éditeur de démarques, copierais un modèle, me battrais avec le frontmatter YAML, l'installerais, réaliserais que j'avais mal structuré les déclencheurs, modifierais, réinstallerais, répéterais. C’était le genre de friction qui m’a fait éviter de créer des compétences même lorsque j’avais un flux de travail clairement répétitif qui en avait besoin.
Ensuite, Anthropic a expédié la compétence de création de compétences. C'est exactement ce à quoi cela ressemble : une compétence dont le seul travail est de vous interviewer sur un flux de travail et de générer une compétence pratique à partir de la conversation. Aucune modification de modèle. Pas de YAML. Vous décrivez ce que vous faites à plusieurs reprises, il pose des questions de clarification et il rédige le dossier de compétences.
La partie non évidente, ce sont les tests. Avant de valider la compétence, le créateur de compétence génère des cas d'évaluation qui comparent la sortie de Claude avec la compétence par rapport à sans celle-ci. Si la compétence n’améliore pas de manière mesurable le résultat des cas de test, vous le découvrez avant d’installer. Je ne saurais trop insister sur la perte de temps que cela évite. La plupart des compétences que j'aurais enseignées il y a six mois n'auraient pas réussi leur propre évaluation.
La façon dont je l'utilise : chaque fois que je me surprends à donner à Claude les mêmes instructions de configuration pour la troisième fois en une semaine, j'ouvre le créateur de compétences et parcoure l'interview. Si les évaluations réussissent, la compétence entre en jeu. Si ce n'est pas le cas, j'ai au moins appris que le flux de travail n'était pas aussi reproductible que je le pensais.
2. Prompt Master – Nettoyer les invites désordonnées avant qu'elles n'atteignent un modèle
C’est celui sur lequel la plupart des gens dorment. Prompt Master prend une invite désordonnée et à moitié formée et la réécrit en une invite structurée optimisée pour le modèle que vous ciblez réellement. Il détecte l'intention à travers neuf dimensions : ce que vous voulez, à qui cela s'adresse, quel format, quelles contraintes, quel ton – et pose jusqu'à trois questions de clarification si quelque chose est ambigu.
La raison pour laquelle cela est important : la plupart des plaintes « AI m'a donné une mauvaise réponse » sont en fait des problèmes déguisés « J'ai donné une mauvaise invite à AI ». J'ai couvert le mécanisme sous-jacent dans pourquoi une invite précise bat une invite intelligente — Prompt Master est la version opérationnalisée de cette idée. Il refuse d’envoyer une invite vague à un modèle.
Je l’intègre dans Claude Desktop comme préprocesseur pour toute invite non triviale. Le workflow est simple : je saisis mon idée brute, Prompt Master la réécrit, je valide ou j’ajuste, puis l’invite réécrite part vers Claude. La première fois que j'ai essayé cela sur une tâche de recherche avec laquelle j'avais du mal, l'invite réécrite comptait onze lignes plus longues que la mienne - et le résultat était le genre de chose que j'aurais passé quarante-cinq minutes à affiner manuellement.
3. Fact Checker – Le non négociable pour tout ce qui est destiné au public
Voici la règle que j'ai rendue non négociable dans mon flux de travail : rien ne quitte mon bureau pour un public public tant que Fact Checker n'y a pas touché.
What it does is mechanical and unglamorous. Il extrait chaque affirmation factuelle d'un morceau de texte, croise chacune d'elles avec des sources externes via une recherche sur le Web et produit un rapport qui classe chaque affirmation en confirmé, invérifiable ou faux. Pour un article de 3 000 mots, le rapport contient généralement de dix à vingt réclamations, et le parcours typique en signale deux ou trois qui nécessitent une attention particulière.
La raison pour laquelle cette compétence compte plus en 2026 qu'il y a six mois : le contenu généré par AI est partout, les hallucinations se produisent encore et votre réputation professionnelle est en aval du fait d'avoir raison. J'ai vu deux amis – tous deux intelligents et prudents – publier des messages avec des statistiques déclarées avec assurance qui se sont avérées avoir été inventées par le modèle. The fix isn't to write more carefully. Il s'agit d'ancrer une étape de vérification sur votre pipeline afin que la partie la plus minutieuse se déroule automatiquement.
Ce que je ferais différemment si je commençais maintenant : installez Fact Checker avant d'installer quoi que ce soit d'autre sur cette liste. Non pas parce que c’est la plus excitante – ce n’est pas le cas – mais parce que c’est la seule compétence dont l’absence finira par vous coûter quelque chose que vous ne pourrez pas facilement récupérer.
4. Humanizer – La dernière étape avant que quoi que ce soit soit expédié
L’autre moitié du pipeline destiné au public. Humanizer prend le texte généré par AI et supprime les motifs qui crient « ceci a été écrit par un modèle ». Symbolisme gonflé. Tirets caoutchouteux surutilisés. Un jargon d'entreprise vague (« effet de levier », « robuste », « naviguer dans le paysage »). Phrases qui commencent toutes par la même structure.
Ce qui différencie Humanizer des invites génériques « faire en sorte que cela sonne humain » que vous avez probablement essayé : il analyse d'abord des échantillons de votre écriture, crée un profil de votre rythme de phrase et de vos choix de mots, puis réécrit l'entrée pour qu'elle corresponde. Bien fait, le résultat ressemble à une version légèrement fatiguée de vous un jeudi après-midi – c'est-à-dire que cela semble humain.
C’est ici que je veux faire une confession : je fais passer chaque écrit public – y compris cet article – par une passe humanisante avant de le publier. Pas parce que je ne l'ai pas écrit. Je l'ai fait. Mais parce que si vous écrivez suffisamment avec un AI dans la pièce, certains modèles fuient, que vous le remarquiez ou non. La passe les rattrape.
Il y a une ironie dont je suis conscient ici. Utilisation de AI pour que l'écriture assistée par AI ressemble moins à AI. Mais c'est le monde dans lequel nous vivons, et je préfère être honnête à propos du flux de travail plutôt que de prétendre que l'assistance n'est pas là.
Niveau 2 : Les quatre compétences présentes dans Claude Code
Maintenant, nous quittons Claude Desktop et allons au terminal. Ces quatre compétences sont les compétences que j'utilise lorsque je fais des travaux d'ingénierie : création de fonctionnalités, code d'expédition, révision de ce que j'ai construit avant la fusion. Si vous êtes un développeur utilisant Claude Code comme pilote quotidien, c'est à ce niveau que réside la majeure partie de l'effet de levier.
5. Compétence de dramaturge + superpouvoirs – Le combo qui capture ce que les humains manquent
Je les regroupe parce qu'il est préférable de les utiliser ensemble, mais ils font des choses très différentes.
La Compétence Dramaturge donne à Claude un contrôle direct du navigateur. Au lieu d'écrire des tests Playwright sous forme de code, vous décrivez ce que vous souhaitez tester, et Claude ouvre une fenêtre de navigateur visible et exécute l'interaction. Vous regardez cela se produire. Le modèle clique sur le bouton, remplit le formulaire, parcourt le flux et rend compte de ce qu'il a trouvé.
Le type de bug détecté est celui que les testeurs humains et les tests unitaires oublient. Le mois dernier, j'avais un bouton qui était techniquement dans le DOM, techniquement cliquable et techniquement présent dans chaque instantané de test. Il est rendu derrière un en-tête collant sur la fenêtre de l'iPad. Un humain regardant la page l’aurait remarqué. Les tests unitaires ne l'ont pas fait. Un dramaturge simulant un utilisateur réel sur iPad l'a capturé en onze secondes.
Superpowers — le plugin de Jesse Vincent qui a été accepté sur le marché officiel des plugins Anthropic en janvier 2026 — s'ajoute à cela et impose la discipline. Il pousse Claude à travers une boucle en cinq phases : clarifier, concevoir, planifier, coder, vérifier. Pas de raccourcis « commencez simplement à coder ». J'ai écrit la description complète dans mon avis sur le plugin Superpowers si vous voulez une analyse approfondie.
C'est le combo qui les rend dangereux. Les superpuissances imposent la planification et la vérification. Playwright fournit le mécanisme de vérification réel. Ensemble, ils détectent la classe de bugs qui sont discrètement envoyés en production et font surface une semaine plus tard lorsqu'un utilisateur se plaint.
6. Pack de sous-agents : dix spécialistes au lieu d'un généraliste
Le modèle ici a changé ma façon de penser les tâches complexes. Au lieu de demander à Claude de porter dix casquettes séquentiellement : planificateur, architecte, avocat, spécialiste du marketing, responsable du support – vous déployez dix sous-agents en parallèle, chacun avec un rôle et une portée définis. Ils ne rivalisent pas pour le contexte. Il n'est pas nécessaire de les réinformer. Ils effectuent leurs analyses simultanément et vous obtenez dix perspectives à la fois.
Je l'utilise le plus souvent pour les décisions de produits où je devrais normalement consulter trois ou quatre personnes. Dois-je lancer cette fonctionnalité ? Le sous-agent marketing examine le positionnement. Le sous-agent juridique signale le risque. Le sous-agent d'expérience client parcourt le parcours utilisateur. Le sous-agent d'architecture signale la dette technique que je contracte. Le sous-agent de planification séquence le travail.
Le résultat est ce qui se rapproche le plus d’une équipe senior pour une seule personne. J'ai approfondi ce modèle dans le Livre de jeu des équipes d'agents d'Anthropic — si vous avez lu celui-là, vous connaissez déjà l'architecture. Le pack n'est que la version produite.
Il existe une version payante de ce logiciel pour 49 $ et une version gratuite qui fait l'essentiel du même travail. J'utilise la version gratuite pour le travail de routine et je n'utilise le pack payant que lorsque les enjeux justifient un peaufinage supplémentaire.
7. Révision du code — /review et /security-review
C’est la compétence peu sexy qui s’amortit plus rapidement que toute autre chose sur la liste.
/review exécute une révision du code sur vos modifications en attente. Bugs, cas extrêmes, défauts de conception, problèmes de style. /security-review est la variante axée sur la sécurité : elle recherche spécifiquement les vulnérabilités, les risques d'injection, les lacunes d'authentification et les secrets divulgués dans les journaux. Les deux fonctionnent localement. Les deux sont gratuits. Les deux doivent être exécutés sur chaque changement significatif avant de pousser.
La raison pour laquelle cela fonctionne mieux qu'un examen humain dans la plupart des cas : cela ne fatigue pas. Un évaluateur humain sur le PR n°14 du jour n'est pas le même évaluateur que sur le PR n°2. Le modèle est le même critique à chaque fois. Il capte la même classe d’émissions à 17 heures qu’à 9 heures du matin.
C’est la compétence que j’ai recommandée le plus agressivement aux clients. La moitié d’entre eux m’ont ignoré. L'autre moitié m'a répondu deux semaines plus tard en me disant qu'elle avait détecté un bug d'injection SQL dans un PR qui avait trois approbations humaines. Je ne vais pas prétendre que le modèle est meilleur qu’un ingénieur senior prudent – ce n’est pas le cas. Je vais dire que le coût marginal de l'exécution de /review sur chaque PR est nul et que la valeur attendue de la détection d'un bug de production avant sa livraison est élevée.
Si vous préférez que quelqu'un audite votre base de code et configure ces flux de travail de révision pour vous, j'assume ces engagements via mon Fiverr - mais honnêtement, celui-ci, vous pouvez l'installer vous-même en cinq minutes.
8. Context Manager — La compétence qui empêche Claude d'oublier
Chaque longue session Claude Code finit par se heurter au même mur : la fenêtre contextuelle se remplit, le modèle commence à oublier les décisions que vous avez prises il y a quarante minutes et la qualité du résultat se dégrade silencieusement. Vous ne le remarquez pas jusqu'à ce que Claude se contredise ou suggère un correctif que vous avez déjà rejeté.
Le conseil conventionnel – « exécutez simplement /compact lorsque vous manquez de place » – est erroné sur un point important. Au moment où vous êtes à 90 % de contexte, vous avez déjà perdu en qualité. La meilleure pratique actuelle, confirmée dans plusieurs guides Claude Code 2026, consiste à compacter de manière proactive à environ 60 % d'utilisation. Avant que la qualité ne commence à baisser. Pas après.
Une compétence Context Manager opérationnalise cela. Il suit votre utilisation actuelle du contexte, la fait apparaître visiblement et vous invite à effectuer un compactage lorsque vous franchissez le seuil de 60 %. Il prend également en charge /compact <instructions>, ce qui signifie que vous pouvez lui dire ce qu'il faut conserver. "Compactez cette session mais conservez les décisions de schéma et le flux d'authentification que nous avons élaborés."
La règle que je vis désormais : toutes les 20-30 minutes lors d'une longue séance, je compacte. Chaque fois que je termine une sous-tâche discrète et avant de commencer la suivante, je compacte. Le coût est de vingt secondes. L'avantage est la différence entre Claude se souvenant de ce que nous avons construit et Claude inventant une nouvelle architecture à chaque fois que ma fenêtre se remplit.
La règle la plus profonde, dont j'ai parlé dans Gestion du contexte 1M de Claude Code : plus de contexte n'est pas la réponse. Le contexte mieux géré l’est. La compétence Context Manager est la discipline.
Niveau 3 : Le modèle qui rend toutes les autres compétences composées
Si vous souhaitez retenir une chose de cet article, prenez cette section.
9. Le modèle learnings.md
Ce n'est pas une compétence au sens technique du terme. Il n'y a pas de commande d'installation. Vous ne téléchargez aucun fichier SKILL.md. Il s'agit d'un modèle (un fichier de démarque unique que vous créez dans votre projet) qui transforme chaque compétence que vous avez installée en un système d'auto-amélioration.
Voici comment cela fonctionne. Vous créez un fichier appelé learnings.md à la racine de votre projet. La première fois que vous exécutez une compétence, vous lui demandez de lire learnings.md avant de faire quoi que ce soit d'autre, et de l'ajouter à learnings.md une fois qu'elle a terminé, en particulier tout ce qu'il a appris sur vos préférences, votre style, vos corrections, vos erreurs.
Exécutez-en un. La compétence lit un fichier vide, fait son travail et ajoute quelques observations. "L'utilisateur préfère les tirets cadratins aux virgules pour les parenthèses. L'utilisateur a signalé le mot "effet de levier" comme interdit. L'utilisateur veut une voix à la première personne dans les publications de mejba.me."
Exécutez-en deux. La compétence lit le fichier à partir de la première exécution, applique ces observations et en ajoute de nouvelles. "L'utilisateur préfère les en-têtes Markdown H2 et H3 uniquement, pas H4. L'utilisateur coupe les phrases de plus de 30 mots. L'utilisateur ajoute des anecdotes personnelles dans les ouvreurs de section."
À la vingtième exécution, le fichier contient 80 à 100 puces décrivant exactement votre façon de travailler, ce que vous avez corrigé, ce qui a fonctionné, ce qui n'a pas fonctionné. La compétence qui a commencé comme un modèle générique est maintenant un instrument de précision calibré pour vous. Et toutes les autres compétences qui lisent le même fichier héritent de cet étalonnage.
La citation à laquelle je reviens sans cesse, tirée de l'une des meilleures analyses de ce modèle : "C'est la différence entre une calculatrice et un ordinateur complet." Une calculatrice fait la même chose à chaque fois. Un ordinateur se souvient de ce que vous lui avez appris. Les compétences sans learnings.md sont des calculatrices. Les compétences avec ce sont les ordinateurs.
La maintenance : une fois par semaine, ou chaque fois que le fichier dépasse une centaine de puces, vous consolidez. Lisez tout, fusionnez les doublons, supprimez les entrées obsolètes et réécrivez les modèles en principes synthétisés. Sautez cette étape et le fichier devient du bruit. Faites-le chaque semaine et cela deviendra le fichier le plus précieux de votre projet.
J'exécute une version de ce modèle sur @aria, mon agent de contenu. Le premier mois, il a généré des articles qui nécessitaient de lourdes modifications. Six mois plus tard, il produit des articles qui nécessitent une édition légère, car chaque correction que j'ai apportée a été capturée. La composition n’est pas dramatique d’une semaine à l’autre. C'est dramatique quand on compare le premier mois au sixième mois.
Ce qui se trompe dans la plupart des articles sur ce sujet
Je veux être honnête sur certaines choses avant de conclure.
La première est que le cadre « installez neuf compétences et votre vie change » est trompeur. Installer des compétences ne change rien. Intégrer des compétences dans un workflow change beaucoup de choses. La plupart des gens installent des compétences de la même manière qu'ils collectent des extensions Chrome : avec empressement, puis les ignorent.
La seconde est que l’écosystème des compétences évolue plus rapidement que n’importe quel article ne peut suivre. Les neuf que j'ai décrits seront probablement différents dans trois mois. De nouvelles compétences remplaceront certaines d'entre elles. Les modèles (nettoyage préalable, vérification des faits avant la publication, spécialisation des sous-agents, gestion proactive du contexte, apprentissages persistants) ne changeront pas. Les outils changent. Composé de motifs.
La troisième est que je me trompe sur certains points. J'ai changé d'avis à propos des compétences Claude trois fois au cours de la dernière année. J'étais sceptique au début. J’étais trop enthousiaste au milieu. Je suis quelque part entre les deux maintenant. Si vous lisez cet article dans six mois et pensez que « cela a mal vieilli », vous avez probablement raison sur des outils spécifiques et probablement tort sur les modèles sous-jacents.
Questions fréquemment posées
Combien de compétences Claude dois-je réellement installer ?
Cinq à neuf, maximum. La bonne configuration comporte des compétences qui se transmettent les unes aux autres : rédaction de flux de recherche, rédaction de flux de vérification des faits, flux de vérification des faits humanisants. Plus de neuf et vous créez une fatigue décisionnelle à la fois pour vous-même et pour le modèle. Pour le raisonnement complet, voir « Pourquoi les compétences de la plupart des gens sont brisées » ci-dessus.
Quel est le modèle learnings.md dans Claude Code ?
Le modèle learnings.md est un fichier de démarque persistant que vos compétences lisent au début de chaque session et auquel elles sont ajoutées à la fin, accumulant les corrections, les préférences et les modèles au fil du temps. Il transforme des compétences génériques en compétences personnalisées sans reconversion. Voir la section « Le modèle learnings.md » ci-dessus pour la mise en œuvre complète.
Quand dois-je exécuter /compact dans Claude Code ?
À 60 % d'utilisation du contexte, et non à 90 %. Le compactage proactif préserve la qualité du résultat ; le compactage réactif une fois que la qualité s'est déjà dégradée est trop tard. Utilisez /compact <instructions> pour contrôler ce qui est conservé. Voir la section Context Manager pour le protocole complet.
Ai-je besoin de super pouvoirs si j'utilise déjà Claude Code ?
Uniquement si vous souhaitez appliquer une boucle de planification et de vérification sur chaque tâche. Superpowers ajoute une discipline en cinq phases (clarifier, concevoir, planifier, coder, vérifier) qui évite les erreurs « il suffit de commencer à coder ». C'est facultatif mais a un effet de levier important sur les travaux d'ingénierie.
La création de compétences est-elle meilleure que l'écriture manuelle des compétences ?
Pour la plupart des flux de travail, oui. Le créateur de compétences génère des cas de test d'évaluation qui prouvent qu'une compétence améliore le résultat de Claude avant que vous ne vous engagez à l'utiliser : l'écriture manuelle des compétences ignore cette étape de vérification et aboutit souvent à des compétences qui ne sont pas réellement utiles.
Travaillons ensemble
Vous cherchez à créer des systèmes AI, à automatiser les flux de travail ou à faire évoluer votre infrastructure technologique ? J'aimerais aider.
- Fiverr (versions et intégrations personnalisées) : fiverr.com/s/EgxYmWD
- Portefeuille : mejba.me
- Ramlit Limited (solutions d'entreprise) : ramlit.com
- ColorPark (conception et image de marque) : colorpark.io
- xCyberSecurity (services de sécurité) : xcybersecurity.io