A primeira vez que construí um loop sem uma condição de parada real, me custou $12 e funcionou por 28 minutos antes de eu matá-lo. O agente não estava quebrado. Ele fez exatamente o que eu disse: continuar até que a tarefa esteja "completa". O problema era que eu nunca defini "completa" de uma forma que uma máquina pudesse verificar. Então ele continuou gerando, continuou refinando, continuou queimando tokens — concordando consigo mesmo em repetição enquanto minha carteira se esvaziava silenciosamente. Aquela única execução ruim me ensinou mais sobre loop engineering do que qualquer tutorial.
Aqui está a mudança que está acontecendo agora mesmo, e a maioria dos construtores ainda não acompanhou. A habilidade que importa em 2026 não é escrever um prompt inteligente. É escrever o loop que instrui o modelo por você — e saber exatamente como esse loop decide que terminou. Boris Cherny, o criador e líder do Claude Code na Anthropic, disse sem rodeios no palco do Acquired Unplugged em 2 de junho de 2026: "Eu não faço mais prompts ao Claude. Tenho loops rodando que fazem prompts ao Claude e descobrem o que fazer. Meu trabalho é escrever loops."
Isso não é uma frase descartável. É uma descrição de cargo mudando em tempo real.
Uma nota rápida antes de aprofundarmos, porque duas coisas compartilham a mesma palavra. Se você quer a revisão prática do que-deu-errado do skill que produtiza a construção de loops, eu cobri isso separadamente na minha análise do skill Launch Your Agent da Anthropic e a execução descontrolada do agente que ele produziu. Aquele post é uma análise de ferramenta. Este é sobre a engenharia por baixo — a disciplina de projetar o loop em si, seja qual for a ferramenta em que você o despeje. Os dois são adjacentes, não iguais. Leia este para o porquê e a forma; leia aquele para o como foi executá-lo.
No final disto, você será capaz de projetar um loop com uma condição de parada real e verificável — e, igualmente importante, saberá quando um loop é a ferramenta completamente errada. Essa segunda parte é onde a maioria das pessoas se queima.
O que é loop engineering?
Loop engineering é a prática de projetar o gatilho, a ação e a condição de parada de um loop de agente autônomo para que ele possa rodar, verificar seu próprio trabalho e parar com base em critérios objetivos — em vez de depender de um único prompt escrito por humanos. Ele trata o loop, não o prompt, como a unidade de trabalho.
Pense em como você tem usado agentes de codificação com IA. Você escreve um prompt. Lê a saída. Escreve outro prompt. Você é o loop. Seus olhos são o passo de verificação, seu julgamento é a condição de parada, e seus dedos são o que re-aciona a próxima iteração. Loop engineering move os três da sua cabeça para o código.
Cherny descreveu sua própria evolução em três estágios, e mapeia perfeitamente o que a maioria dos construtores sérios está vivendo. Há cerca de um ano, ele escrevia código à mão com autocompletar ajudando nas margens. Então mudou para rodar de cinco a dez sessões do Claude em paralelo, fazendo prompts manualmente em cada uma — trocando abas como um cozinheiro de lanchonete. Agora ele escreve loops que fazem prompts ao Claude por ele; algumas centenas de agentes leem seu GitHub, seu Slack e seu Twitter, e decidem o que construir em seguida. O humano foi de digitar código, para digitar prompts, para digitar a maquinaria que digita prompts.
O termo em si cristalizou-se no início de junho de 2026 — "escreva loops, não prompts" — e uma vez que você internaliza o enquadramento, não consegue mais deixar de ver. Peter Steinberger, que construiu o OpenClaw (o novo repositório com mais estrelas na história do GitHub), postou ainda mais claramente em 7 de junho de 2026: "Você não deveria mais estar fazendo prompts a agentes de codificação."
Afirmação forte. Majoritariamente correta. Mas "majoritariamente" carrega peso, e chegaremos a onde ela quebra.
O ciclo raciocinar → agir → observar → avaliar
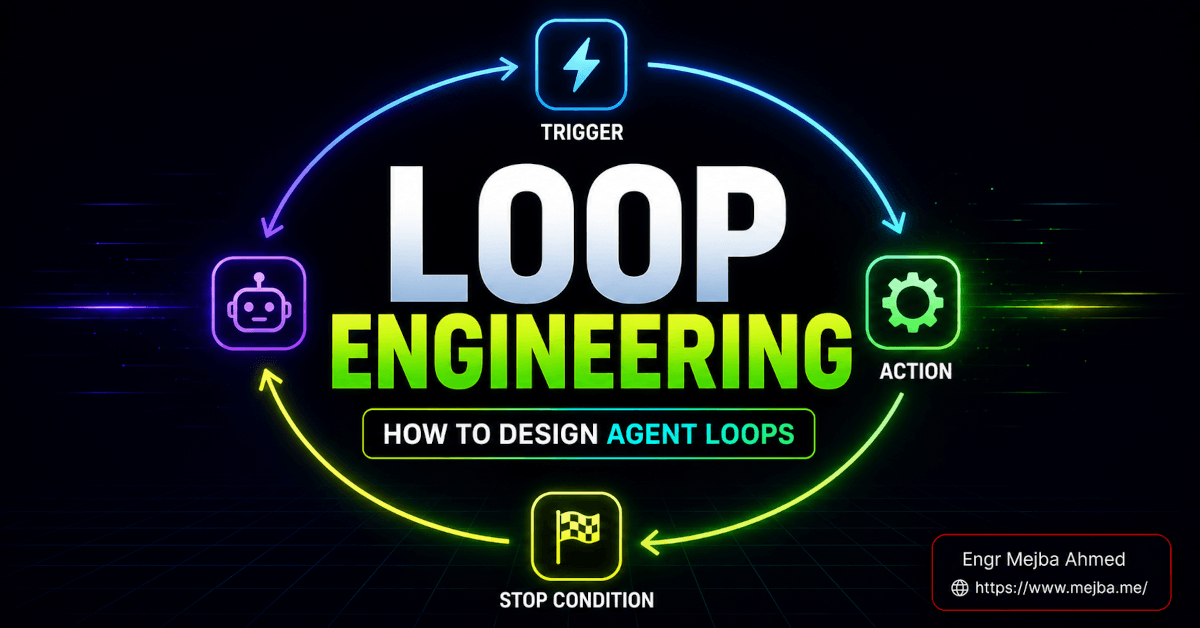
Todo loop de agente, despido até os ossos, é o mesmo ritmo de quatro tempos se repetindo. Os nomes variam — alguns dizem Perceber/Decidir/Agir/Observar, alguns dizem Observar/Pensar/Agir/Verificar — mas a música é idêntica. Eu penso nisso como: raciocinar → agir → observar → avaliar a condição de parada, e então voltar ao início.
Raciocinar: o agente olha o estado atual e decide o que fazer em seguida. Agir: ele realiza uma operação — escreve um arquivo, roda um comando, chama uma API. Observar: captura o que mudou — a saída do comando, o erro, o novo conteúdo do arquivo, a captura de tela. Avaliar: verifica essa observação contra a condição de parada. Pronto? Sair. Não pronto? Raciocinar novamente com a nova informação em mãos.
As guerras de nomenclatura não importam. O que importa é o quarto tempo. A maioria dos loops falhos que vi — incluindo meu desastre de $12 — tem um ciclo forte de raciocinar-agir-observar e um passo de avaliação falso. O agente observa sua própria saída e se pergunta: "Bom o suficiente?" E claro que diz sim, porque está corrigindo seu próprio dever de casa sem rubrica. Um loop sem nada que empurre de volta é apenas o agente concordando consigo mesmo em repetição.
O jogo inteiro é tornar o quarto tempo real.
É por isso que agora projeto loops de trás para frente. Antes de escrever o gatilho, antes de escrever uma única ação, escrevo a condição de parada e faço uma pergunta: que coisa concreta no mundo me dirá que isso está feito, que o agente não pode falsificar? Um teste que passa. Um verificador de tipos que fica verde. Um pipeline de CI que vai de vermelho para verde. Um HTTP 200 de um endpoint que era 500 há um minuto. Se não consigo nomear essa coisa, não construo o loop ainda. O loop não está pronto — a definição não está pronta.
Então vamos decompor a anatomia adequadamente, porque cada uma das três partes tem seus próprios modos de falha.
Gatilho, ação, condição de parada: a anatomia de um loop de agente
Um loop tem exatamente três partes que sustentam carga. Erre em qualquer uma e o conjunto todo oscila.
O gatilho é o que inicia o loop. Pode ser um comando humano ("refatore este módulo"), um cronograma (a cada quinze minutos), um evento (uma nova issue no GitHub, uma mensagem no Slack, um teste falhando no CI), ou outro agente passando trabalho. A configuração de Cherny com algumas centenas de agentes é acionada pela sua própria atividade — seus commits, suas mensagens, seus posts tornam-se sinais que os agentes captam e sobre os quais agem. O gatilho responde: quando este loop tem o direito de existir e começar a gastar tokens?
A ação é o conjunto de operações que o agente tem permissão para realizar dentro de cada iteração. É aqui que você desenha o raio de explosão. Uma ação pode ser "editar arquivos neste diretório e rodar a suíte de testes." Pode ser "gerar uma imagem e salvá-la." Quanto mais apertado e específico o espaço de ação, mais previsível o loop. Quanto mais vago — "faça o que for necessário" — mais criativo, e mais perigoso. A maioria dos descontroles que queimam tokens que vi vêm de um espaço de ação que era largo demais para a capacidade da condição de parada de captar uma virada errada.
A condição de parada é o portão de verificação — os critérios objetivos para "pronto." Esta é a parte que todos subconstroem. Precisa ser algo externo à opinião do próprio agente. Matthew Berman, que lançou a Loop Library em 18 de junho de 2026, enquadra a verificação claramente: pode ser "um teste unitário passando, um pipeline CI verde, ou um LLM dizendo 'sim, isso está completo.'" Note a ordem de confiança aí. Um teste unitário é um fato. Um pipeline verde é um fato. Um LLM julgando completude é uma opinião — útil, mas a mais fraca das três, e a mais propensa a carimbar mediocridade.
Aqui está a ilustração de design que mantenho na minha cabeça. Suponha que eu queira um loop que conserte testes falhando em um repositório. Gatilho: uma execução agendada, ou um push que coloca o CI em vermelho. Ação: ler o teste que falhou, editar o código-fonte, re-rodar a suíte — e apenas essas operações. Condição de parada: a suíte inteira passa, ponto final. Essa última cláusula é todo o ponto. O loop não pode declarar vitória dizendo a si mesmo que o código parece correto. Ele declara vitória quando npm test termina com código zero. O teste é a coisa no loop que pode dizer não. Sem algo que possa dizer não, você não tem um loop — você tem um bajulador caro.
Essa distinção — entre uma condição de parada que é um fato e uma que é uma opinião — acaba sendo o jogo inteiro. O que me leva à parte sobre a qual ninguém fala o suficiente.
Por que a fidelidade de verificação faz ou destrói um loop
Nem todas as condições de parada são criadas iguais, e a lacuna entre uma boa e uma ruim é o maior preditor de se um loop produz algo útil ou algo que meramente parece pronto.
Eu chamo isso de fidelidade de verificação: quão fielmente sua condição de parada mede aquilo que você realmente se importa. Alta fidelidade significa que o portão verifica o objetivo real. Baixa fidelidade significa que o portão verifica um proxy que é fácil de satisfazer e fácil de enganar.
A Loop Library do Berman é uma mina de ouro para ver isso em ação, e quero ser preciso aqui — esses são loops que ele e seus colaboradores construíram e testaram em batalha, não os que eu pessoalmente rodei. Mas eles ilustram o problema de fidelidade melhor do que qualquer coisa que eu pudesse construir.
Pegue o loop de criação de miniaturas dele. A configuração: gere dez miniaturas, pontue-as contra miniaturas de referência estilo MrBeast, itere sobre as três melhores. Aproximadamente 27 minutos por execução. O gatilho e a ação são nítidos. Mas a condição de parada? "Pontue-as contra miniaturas do MrBeast." Isso é subjetivo. Não existe npm test para "esta miniatura é convincente?" A verificação é um LLM olhando uma imagem e formando uma opinião estética, e opiniões estéticas são maleáveis. O loop roda, produz miniaturas, mas a definição de "pronto" é suave — o que significa que o loop pode convergir em algo que o modelo acha que é bom enquanto um criador humano pode discordar completamente. Baixa fidelidade não é um bug no código. É um bug no que "pronto" significa.
Agora olhe o loop de three.js dele — construir um avião 3D com three.js, cerca de 37 minutos, com verificação visual iterativa renderizando no navegador. Maior fidelidade do que miniaturas, porque o agente pode realmente renderizar a cena e olhar para ela a cada iteração. Mas ainda assim não acertou completamente a transparência de visão através. A verificação podia confirmar "um avião existe e renderiza," mas "a transparência parece correta" foi mais difícil de fixar em uma verificação objetiva. O loop chegou perto. Perto não é pronto.
Depois há a recriação de Abbey Road dos Beatles em HTML/CSS — limitada a oito tentativas, cerca de sete iterações de fato rodadas, verificada por comparação de capturas de tela. Melhorou incrementalmente a cada passagem e terminou longe de perfeito. E honestamente, esse exemplo é o mais instrutivo dos três, porque mostra o limite do loop tão claramente. Verificação por captura de tela tem fidelidade média: pode pegar "o layout está amplamente errado" mas luta com "este gradiente específico está levemente desviado." O limite rígido de oito tentativas é o herói não reconhecido aqui — é uma condição de parada secundária que previne uma perseguição infinita e insatisfatível. Quando sua verificação primária é difusa, um limite rígido de iterações é o que impede o loop de se tornar meu desastre de $12.
A lição se acumula de forma limpa. Condições de parada objetivas (um teste passando, um código de saída, um status HTTP) produzem loops nos quais você pode confiar para rodar sem supervisão. Condições de parada subjetivas (isso parece bom?, isso é convincente?) produzem loops que precisam de um humano no assento, ou no mínimo um limite rígido de tentativas para que falhem rápido em vez de falharem caro.
Se você quer uma regra de toda esta seção: ajuste a autonomia do loop à sua fidelidade de verificação. Portão de alta fidelidade? Deixe rodar. Portão de baixa fidelidade? Limite as tentativas e mantenha a mão no interruptor de emergência.
Até agora falamos de um agente em um loop. Mas os padrões mais poderosos — e os que Cherny está de fato rodando — envolvem agentes controlando uns aos outros.
Maker-checker e frotas aninhadas: escalando além de um único loop
Um único agente fazendo raciocinar-agir-observar-avaliar funciona bem para tarefas delimitadas. A arquitetura interessante começa quando você separa o fazer do verificar — e quando loops começam a gerar loops.
O padrão maker-checker é a melhoria mais limpa que você pode fazer em um loop de baixa fidelidade. Em vez de um agente que tanto produz o trabalho quanto julga se está pronto (o problema de corrigir seu próprio dever de casa), você divide os papéis. Um agente faz — escreve o código, gera o design, redige a cópia. Um segundo agente separado verifica — pontua, avalia contra critérios, caça a falha. O trabalho inteiro do verificador é encontrar razões para dizer não. Porque não produziu o trabalho, ele não tem ego investido em chamá-lo de pronto. Essa separação é o que dá ao loop um verdadeiro adversário, e um loop com um verdadeiro adversário é um loop que pode de fato convergir em qualidade.
Eu me apoio nisso constantemente agora. Quando uma condição de parada tem que ser subjetiva — digamos, "este design de API está limpo?" — não peço ao criador para se autoavaliar. Inicio um segundo agente com uma rubrica afiada e um mandato de ser duro. A qualidade da saída dispara, porque agora há algo no loop construído para empurrar de volta.
Depois existem as frotas aninhadas — gerentes dirigindo sub-agentes, loops orquestrando loops. Isso é o que o "algumas centenas de agentes lendo meu GitHub e Slack e decidindo o que construir" de Cherny realmente é. Um loop de nível superior observa sua atividade e raciocina sobre prioridades. Ele despacha sub-loops para lidar com construções específicas. Cada sub-loop tem seu próprio gatilho, espaço de ação e condição de parada, e reporta de volta. A condição de parada do loop gerente não é "eu escrevi código?" — é "minha frota entregou as coisas certas?" São loops até o fim, com portões de verificação em cada camada.
Se você está tentando arquitetar algo nessa escala, os padrões de orquestração merecem seu próprio tratamento aprofundado — eu descrevi como estruturar gerentes, sub-agentes e a passagem de mensagens entre eles na minha análise da arquitetura de enxame de agentes Claude Code. A versão curta: frotas aninhadas multiplicam tanto seu throughput quanto sua superfície de falha. Cada camada que carece de uma condição de parada real é uma camada onde a mediocridade pode entrar e propagar para cima sem ser notada.
E o arnês por baixo de tudo isso importa mais do que os agentes em si. A forma como a Anthropic projeta seu arnês de agente de longa duração — como o estado persiste entre iterações, como o contexto é gerenciado para que o loop não se afogue em sua própria história — moldou fundamentalmente como eu penso sobre durabilidade de loops; eu desempacotei isso no meu artigo sobre o design do arnês de agente da Anthropic. Um loop é tão bom quanto o arnês em que ele roda.
Se você está assentindo com a cabeça pensando "ótimo, vou colocar loops em tudo" — pare. Este é exatamente o ponto onde preciso pisar no freio, porque a habilidade mais importante de loop engineering é saber quando não construir um.
Quando NÃO escrever um loop
Aqui estão os dados desconfortáveis que a galera do "pare de fazer prompts, comece a fazer loops" tende a pular. Uma pesquisa de 2025 com 306 profissionais descobriu que 68% dos agentes em produção rodam dez passos ou menos antes de um humano intervir. Leia isso de novo. Os sistemas de agentes que realmente funcionam em produção não são enxames autônomos de duzentos. São pequenos. São supervisionados. Rodam um punhado de passos e então um humano assume o volante.
Isso não é uma falha da tecnologia. É a tecnologia sendo usada por pessoas que aprenderam da forma difícil onde os loops quebram.
O modo de falha tem um nome agora: agent slop. É o que você obtém quando automatiza além do ponto onde ainda pode responder pela saída. O loop continua produzindo, o volume continua subindo, e a qualidade degrada silenciosamente porque nada no sistema foi construído para captar a deriva. Você termina com mil commits nos quais não pode confiar e que não leu. Slop não é código ruim — é código irresponsável, gerado mais rápido do que qualquer humano pode verificar.
Então aqui está minha lista honesta de quando pular o loop completamente:
Pule se você é um construtor solo em um plano de consumidor. Loops gastam tokens a cada iteração, e um loop descontrolado em um plano medido é uma conta real. (Me pergunte como eu sei — $12 em 28 minutos, e esse foi um pequeno.) Se você é sensível a custos, a matemática dos loops autônomos fica feia rápido. Eu decompus a economia completa de tokens no meu guia de otimização de custos de agentes IA, e o título é simples: sem um portão rígido, loops falham silenciosamente e continuam gastando. Falha silenciosa mais faturamento medido é a pior combinação em todo este campo.
Pule se seu código não tem verificação automatizada. Sem testes, sem verificador de tipos, sem CI? Então sua única condição de parada possível é a opinião de um LLM — o portão de menor fidelidade que existe. Você não tem um loop; tem uma forma cara de gerar diffs que parecem plausíveis. Construa os testes primeiro. A infraestrutura de verificação é a infraestrutura do loop. Um loop sem um portão rígido para empurrar de volta é o agente concordando consigo mesmo em repetição, e isso é precisamente a máquina de slop.
Pule se seu verdadeiro gargalo é capacidade de revisão, não velocidade de digitação. Esse é sutil e pega bons engenheiros. Loops tornam a produção mais rápida. Não fazem nada pela revisão. Se você já está se afogando em PRs que não consegue revisar rápido o suficiente, adicionar um loop que gera dez vezes mais código não ajuda — te enterra. A restrição apenas se moveu. Você otimizou a parte que não era o problema. Antes de construir um loop, pergunte-se honestamente: digitar é meu gargalo, ou responder pelo código é meu gargalo? Se é responder, um loop piora as coisas.
O princípio unificador: um loop é tão confiável quanto a coisa dentro dele que pode dizer não. Sem teste, sem verificação de tipos, sem erro real para reagir — sem loop. Apenas um agente assentindo para si mesmo enquanto o medidor roda.
O que isso realmente muda no seu trabalho
Então, onde isso te deixa praticamente, esta semana?
A leitura honesta do movimento "escreva loops, não prompts" é que é direcionalmente correto e taticamente exagerado. O futuro genuinamente são loops — Cherny não está errado que seu trabalho agora é escrever a maquinaria, não os prompts. Mas o número de 68% é a verificação de realidade: os loops que sobrevivem ao contato com produção são pequenos, controlados e supervisionados. O sonho de uma frota de duzentos agentes rodando sem supervisão é real para as pessoas que construíram verificação à prova de balas ao redor de cada camada. Para todos os outros, é um gerador de slop com cartão de crédito.
O que eu realmente faria, começando hoje: pegue uma tarefa repetitiva que você faz com um agente de IA — aquela em que você continua digitando o mesmo tipo de prompt repetidamente. Escreva primeiro sua condição de parada, antes de qualquer outra coisa. Faça-a um fato, não uma opinião: um teste, um código de saída, uma verificação de status. Se você não consegue nomear esse fato, acabou de descobrir que a tarefa não está pronta para loop, e se poupou uma lição de $12. Se consegue nomeá-lo, já tem a parte mais difícil do loop construída. O gatilho e a ação são a metade fácil.
O modelo mental que quero que você leve é pequeno o suficiente para caber em um post-it: um loop é uma máquina para repetir raciocinar-agir-observar até que uma coisa que pode dizer não diga sim. Projete essa "coisa que pode dizer não" primeiro. Todo o resto é encanamento.
Aquele loop descontrolado que me custou $12 não foi uma falha do agente. Foi uma falha de definição — eu construí o encanamento antes de construir o portão. Construa o portão primeiro. Então você pode deixar o loop rodar, e realmente confiar no que ele te entrega quando para.
Perguntas frequentes
O que é loop engineering?
Loop engineering é a disciplina de projetar o gatilho, a ação e a condição de parada de um agente autônomo para que ele possa rodar, verificar sua própria saída e parar com base em critérios objetivos — em vez de depender de um único prompt escrito por humanos. A unidade de trabalho muda do prompt para o loop em si. Para a anatomia completa, veja a seção de gatilho/ação/condição de parada acima.
Loop engineering é o mesmo que prompt engineering?
Não. Prompt engineering otimiza uma única instrução que você dá ao modelo; loop engineering otimiza a maquinaria que faz prompts ao modelo repetidamente e decide quando o trabalho está feito. Como Boris Cherny colocou: "Meu trabalho é escrever loops" — o prompt se torna um detalhe interno do loop, não a coisa que você elabora à mão.
Quando você não deveria usar um loop de agente?
Pule um loop de agente se você é um construtor solo em um plano de consumidor (custos de tokens se acumulam a cada iteração), se seu código não tem verificação automatizada (testes, tipos, CI) para servir como condição de parada objetiva, ou se seu verdadeiro gargalo é capacidade de revisão em vez de velocidade de digitação. Uma pesquisa de 2025 com 306 profissionais descobriu que 68% dos agentes em produção rodam dez passos ou menos antes de um humano intervir — pequeno e supervisionado vence autônomo e irresponsável.
O que é o padrão maker-checker em agentes de IA?
O padrão maker-checker divide um loop de agente em dois papéis: um agente produz o trabalho e um agente separado o avalia contra critérios. Como o verificador não criou a saída, ele não tem incentivo para carimbá-la — dando ao loop um verdadeiro adversário que pode empurrar de volta. É a solução mais limpa para loops cuja condição de parada seria de outra forma subjetiva.
O que torna a condição de parada de um loop de agente confiável?
Fidelidade de verificação. Um portão objetivo — um teste unitário passando, um pipeline CI verde, um HTTP 200 — é um fato que o agente não pode falsificar, então o loop pode rodar sem supervisão. Um portão subjetivo, como um LLM julgando se uma imagem "parece boa," é uma opinião fácil de enganar, então precisa de um humano no assento ou um limite rígido de tentativas. Ajuste a autonomia do loop a quão fielmente seu portão mede o objetivo real.
Vamos trabalhar juntos
Deseja construir sistemas de IA, automatizar fluxos de trabalho ou escalar sua infraestrutura tecnológica? Adoraria ajudar.
- Fiverr (desenvolvimento personalizado e integrações): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io