La première fois que j'ai construit une boucle sans véritable condition d'arrêt, ça m'a coûté 12 $ et elle a tourné pendant 28 minutes avant que je ne la tue. L'agent n'était pas cassé. Il a fait exactement ce que je lui avais dit : continuer jusqu'à ce que la tâche soit "terminée". Le problème était que je n'avais jamais défini "terminée" d'une manière qu'une machine pouvait vérifier. Alors il a continué à générer, continué à affiner, continué à brûler des tokens — en accord avec lui-même en boucle pendant que mon portefeuille se vidait silencieusement. Cette seule mauvaise exécution m'a appris plus sur le loop engineering que n'importe quel tutoriel.
Voici le changement qui se produit en ce moment même, et la plupart des constructeurs n'ont pas encore rattrapé leur retard. La compétence qui compte en 2026 n'est pas d'écrire un prompt intelligent. C'est d'écrire la boucle qui instruit le modèle pour vous — et de savoir exactement comment cette boucle décide qu'elle a terminé. Boris Cherny, le créateur et responsable de Claude Code chez Anthropic, l'a dit sans détour sur scène à Acquired Unplugged le 2 juin 2026 : "Je ne fais plus de prompts à Claude. J'ai des boucles qui tournent et qui font des prompts à Claude et qui déterminent quoi faire. Mon travail est d'écrire des boucles."
Ce n'est pas une phrase anodine. C'est une fiche de poste qui change en temps réel.
Une note rapide avant d'aller en profondeur, car deux choses partagent le même mot. Si vous voulez la revue pratique, voici-ce-qui-a-cassé, du skill qui productise la construction de boucles, je l'ai couvert séparément dans mon analyse du skill Launch Your Agent d'Anthropic et l'exécution incontrôlée de l'agent qu'il a produite. Ce post est une revue d'outil. Celui-ci porte sur l'ingénierie en dessous — la discipline de concevoir la boucle elle-même, quel que soit l'outil dans lequel vous la versez. Les deux sont adjacents, pas identiques. Lisez celui-ci pour le pourquoi et la forme ; lisez celui-là pour le comment ça s'est passé en la faisant tourner.
À la fin de ceci, vous serez capable de concevoir une boucle avec une véritable condition d'arrêt vérifiable — et, tout aussi important, vous saurez quand une boucle est complètement le mauvais outil. Cette deuxième partie est là où la plupart des gens se brûlent.
Qu'est-ce que le loop engineering ?
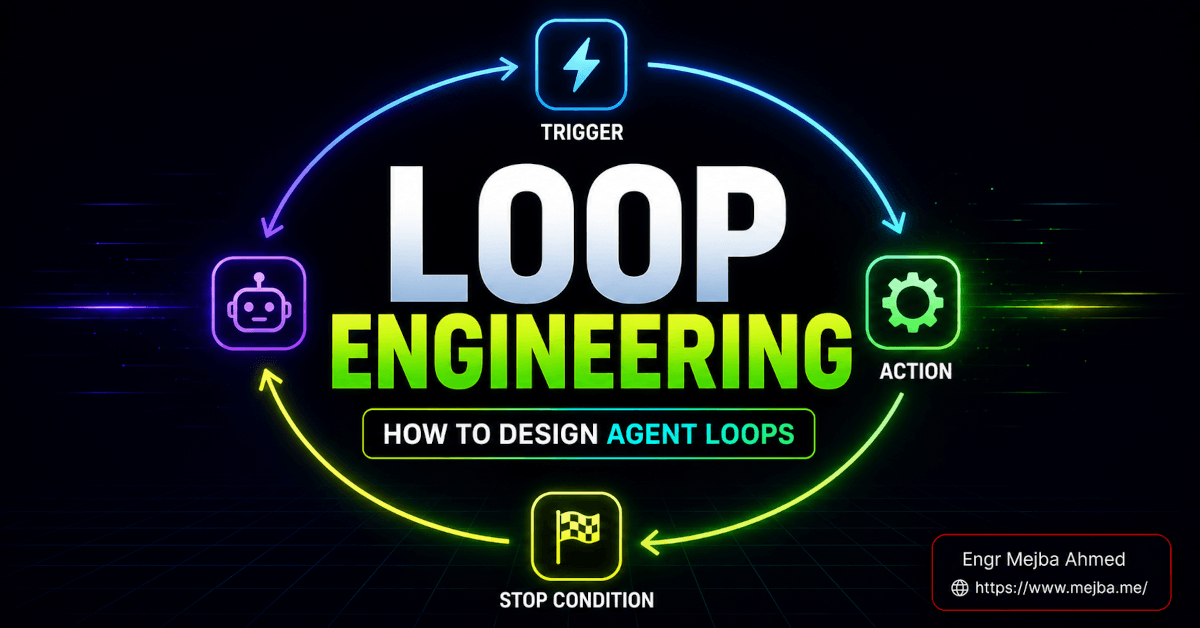
Le loop engineering est la pratique de concevoir le déclencheur, l'action et la condition d'arrêt d'une boucle d'agent autonome pour qu'elle puisse s'exécuter, vérifier son propre travail et s'arrêter selon des critères objectifs — au lieu de dépendre d'un unique prompt écrit par un humain. Il traite la boucle, pas le prompt, comme l'unité de travail.
Pensez à la façon dont vous avez utilisé les agents de codification IA. Vous écrivez un prompt. Vous lisez la sortie. Vous écrivez un autre prompt. Vous êtes la boucle. Vos yeux sont l'étape de vérification, votre jugement est la condition d'arrêt, et vos doigts sont ce qui redéclenche l'itération suivante. Le loop engineering déplace les trois de votre tête vers le code.
Cherny a décrit sa propre évolution en trois étapes, et elle correspond parfaitement à ce que vivent la plupart des constructeurs sérieux. Il y a environ un an, il écrivait du code à la main avec l'autocomplétion qui aidait en marge. Puis il est passé à l'exécution de cinq à dix sessions Claude en parallèle, faisant des prompts manuellement à chacune — changeant d'onglets comme un cuisinier de restauration rapide. Maintenant il écrit des boucles qui font des prompts à Claude pour lui ; quelques centaines d'agents lisent son GitHub, son Slack et son Twitter, et décident quoi construire ensuite. L'humain est passé de taper du code, à taper des prompts, à taper la machinerie qui tape des prompts.
Le terme lui-même s'est cristallisé début juin 2026 — "écrivez des boucles, pas des prompts" — et une fois que vous avez internalisé le cadre, vous ne pouvez plus l'ignorer. Peter Steinberger, qui a construit OpenClaw (le nouveau dépôt le plus étoilé de l'histoire de GitHub), l'a posté encore plus crûment le 7 juin 2026 : "Vous ne devriez plus faire de prompts aux agents de codification."
Affirmation forte. Majoritairement juste. Mais "majoritairement" porte du poids, et nous arriverons à là où ça casse.
Le cycle raisonner → agir → observer → évaluer
Chaque boucle d'agent, réduite à l'essentiel, est le même rythme à quatre temps qui se répète. Les noms varient — certains disent Percevoir/Décider/Agir/Observer, certains disent Observer/Penser/Agir/Vérifier — mais la musique est identique. J'y pense comme : raisonner → agir → observer → évaluer la condition d'arrêt, puis recommencer.
Raisonner : l'agent regarde l'état actuel et décide quoi faire ensuite. Agir : il effectue une opération — écrit un fichier, exécute une commande, appelle une API. Observer : il capture ce qui a changé — la sortie de la commande, l'erreur, le nouveau contenu du fichier, la capture d'écran. Évaluer : il vérifie cette observation par rapport à la condition d'arrêt. Terminé ? Sortir. Pas terminé ? Raisonner à nouveau avec les nouvelles informations en main.
Les guerres de nomenclature n'importent pas. Ce qui compte, c'est le quatrième temps. La plupart des boucles ratées que j'ai vues — y compris mon désastre à 12 $ — ont un cycle solide de raisonner-agir-observer et une étape d'évaluation fausse. L'agent observe sa propre sortie et se demande : "Assez bien ?" Et bien sûr il dit oui, parce qu'il corrige ses propres devoirs sans grille d'évaluation. Une boucle sans rien qui repousse n'est que l'agent qui se donne raison en boucle.
Tout le jeu consiste à rendre le quatrième temps réel.
C'est pourquoi je conçois maintenant les boucles à l'envers. Avant d'écrire le déclencheur, avant d'écrire une seule action, j'écris la condition d'arrêt et je pose une question : quelle chose concrète dans le monde me dira que c'est fait, que l'agent ne peut pas simuler ? Un test qui passe. Un vérificateur de types qui passe au vert. Un pipeline CI qui passe du rouge au vert. Un HTTP 200 d'un endpoint qui était en 500 il y a une minute. Si je ne peux pas nommer cette chose, je ne construis pas encore la boucle. La boucle n'est pas prête — la définition n'est pas prête.
Alors décomposons correctement l'anatomie, car chacune des trois parties a ses propres modes de défaillance.
Déclencheur, action, condition d'arrêt : l'anatomie d'une boucle d'agent
Une boucle a exactement trois parties porteuses. Ratez-en une et l'ensemble vacille.
Le déclencheur est ce qui lance la boucle. Ça peut être une commande humaine ("refactorise ce module"), un horaire (toutes les quinze minutes), un événement (une nouvelle issue GitHub, un message Slack, un test en échec dans le CI), ou un autre agent qui passe du travail. La configuration de Cherny avec quelques centaines d'agents est déclenchée par sa propre activité — ses commits, ses messages, ses posts deviennent des signaux que les agents captent et sur lesquels ils agissent. Le déclencheur répond à : quand cette boucle a-t-elle le droit d'exister et de commencer à dépenser des tokens ?
L'action est l'ensemble des opérations que l'agent est autorisé à effectuer à chaque itération. C'est là que vous dessinez le rayon d'explosion. Une action pourrait être "modifier les fichiers dans ce répertoire et exécuter la suite de tests." Ça pourrait être "générer une image et la sauvegarder." Plus l'espace d'action est serré et spécifique, plus la boucle est prévisible. Plus il est vague — "fais ce qu'il faut" — plus c'est créatif, et plus c'est dangereux. La plupart des emballements qui brûlent des tokens que j'ai vus viennent d'un espace d'action trop large pour la capacité de la condition d'arrêt à détecter un mauvais virage.
La condition d'arrêt est la porte de vérification — les critères objectifs pour "terminé." C'est la partie que tout le monde sous-construit. Elle doit être quelque chose d'externe à la propre opinion de l'agent. Matthew Berman, qui a lancé la Loop Library le 18 juin 2026, encadre la vérification clairement : ça peut être "un test unitaire qui passe, un pipeline CI au vert, ou un LLM qui dit 'oui, c'est complet.'" Notez l'ordre de confiance ici. Un test unitaire est un fait. Un pipeline vert est un fait. Un LLM qui juge la complétude est une opinion — utile, mais la plus faible des trois, et celle la plus susceptible de tamponner de la médiocrité.
Voici l'illustration de design que je garde en tête. Disons que je veux une boucle qui corrige des tests en échec dans un dépôt. Déclencheur : une exécution programmée, ou un push qui met le CI au rouge. Action : lire le test en échec, modifier le source, relancer la suite — et seulement ces opérations. Condition d'arrêt : la suite complète passe, point final. Cette dernière clause est tout le propos. La boucle ne peut pas déclarer victoire en se disant que le code a l'air correct. Elle déclare victoire quand npm test se termine avec le code zéro. Le test est la chose dans la boucle qui peut dire non. Sans quelque chose qui peut dire non, vous n'avez pas une boucle — vous avez un béni-oui-oui coûteux.
Cette distinction — entre une condition d'arrêt qui est un fait et une qui est une opinion — s'avère être tout le jeu. Ce qui m'amène à la partie dont personne ne parle assez.
Pourquoi la fidélité de vérification fait ou défait une boucle
Toutes les conditions d'arrêt ne se valent pas, et l'écart entre une bonne et une mauvaise est le meilleur prédicteur de si une boucle produit quelque chose d'utile ou quelque chose qui a simplement l'air terminé.
J'appelle ça la fidélité de vérification : à quel point votre condition d'arrêt mesure fidèlement ce qui vous importe vraiment. Haute fidélité signifie que la porte vérifie le vrai objectif. Basse fidélité signifie que la porte vérifie un proxy facile à satisfaire et facile à tromper.
La Loop Library de Berman est une mine d'or pour voir ça en action, et je veux être précis ici — ce sont des boucles que lui et ses contributeurs ont construites et testées au combat, pas des boucles que j'ai personnellement exécutées. Mais elles illustrent le problème de fidélité mieux que tout ce que je pourrais construire.
Prenez sa boucle de création de miniatures. La configuration : générer dix miniatures, les noter contre des miniatures de référence style MrBeast, itérer sur les trois meilleures. Environ 27 minutes par exécution. Le déclencheur et l'action sont nets. Mais la condition d'arrêt ? "Les noter contre les miniatures de MrBeast." C'est subjectif. Il n'y a pas de npm test pour "cette miniature est-elle convaincante ?" La vérification est un LLM qui regarde une image et forme une opinion esthétique, et les opinions esthétiques sont molles. La boucle tourne, elle produit des miniatures, mais la définition de "terminé" est molle — ce qui signifie que la boucle peut converger sur quelque chose que le modèle pense être bon alors qu'un créateur humain pourrait être en total désaccord. Une basse fidélité n'est pas un bug dans le code. C'est un bug dans ce que signifie "terminé".
Maintenant regardez sa boucle three.js — construire un avion 3D avec three.js, environ 37 minutes, avec vérification visuelle itérative par rendu dans un navigateur. Plus haute fidélité que les miniatures, parce que l'agent peut réellement rendre la scène et la regarder à chaque itération. Mais il n'a toujours pas parfaitement réussi la transparence. La vérification pouvait confirmer "un avion existe et se rend," mais "la transparence a l'air correcte" était plus difficile à ancrer à une vérification objective. La boucle s'est approchée. S'approcher n'est pas terminer.
Puis il y a la recréation de Abbey Road des Beatles en HTML/CSS — plafonnée à huit tentatives, environ sept itérations effectivement exécutées, vérifiée par comparaison de captures d'écran. Elle s'est améliorée progressivement à chaque passage et a fini loin d'être parfaite. Et honnêtement, cet exemple est le plus instructif des trois, parce qu'il montre la limite de la boucle si clairement. La vérification par capture d'écran a une fidélité moyenne : elle peut détecter "la mise en page est globalement fausse" mais peine avec "ce dégradé spécifique est légèrement décalé." Le plafond dur de huit tentatives est le héros méconnu ici — c'est une condition d'arrêt secondaire qui empêche une poursuite infinie et insatisfaisable. Quand votre vérification primaire est floue, un plafond dur d'itérations est ce qui empêche la boucle de devenir mon désastre à 12 $.
La leçon s'empile proprement. Les conditions d'arrêt objectives (un test qui passe, un code de sortie, un statut HTTP) produisent des boucles auxquelles vous pouvez faire confiance pour tourner sans surveillance. Les conditions d'arrêt subjectives (est-ce que ça a l'air bien, est-ce convaincant) produisent des boucles qui ont besoin d'un humain aux commandes, ou au minimum un plafond dur de tentatives pour qu'elles échouent vite plutôt que d'échouer cher.
Si vous voulez une règle de toute cette section : ajustez l'autonomie de la boucle à sa fidélité de vérification. Porte à haute fidélité ? Laissez tourner. Porte à basse fidélité ? Plafonnez les tentatives et gardez la main sur l'interrupteur d'urgence.
Jusqu'ici nous avons parlé d'un agent dans une boucle. Mais les patterns les plus puissants — et ceux que Cherny exécute réellement — impliquent des agents qui se contrôlent mutuellement.
Maker-checker et flottes imbriquées : passer à l'échelle au-delà d'une seule boucle
Un seul agent qui fait raisonner-agir-observer-évaluer fonctionne bien pour les tâches délimitées. L'architecture intéressante commence quand vous séparez le faire du vérifier — et quand les boucles commencent à générer des boucles.
Le pattern maker-checker est l'amélioration la plus propre que vous puissiez apporter à une boucle à basse fidélité. Au lieu d'un agent qui à la fois produit le travail et juge s'il est terminé (le problème de corriger ses propres devoirs), vous séparez les rôles. Un agent fait — écrit le code, génère le design, rédige la copie. Un second agent séparé vérifie — note, évalue selon des critères, chasse la faille. Le travail entier du vérificateur est de trouver des raisons de dire non. Parce qu'il n'a pas produit le travail, il n'a pas d'ego investi dans le fait de le déclarer terminé. Cette séparation est ce qui donne à la boucle un véritable adversaire, et une boucle avec un véritable adversaire est une boucle qui peut réellement converger vers la qualité.
Je m'appuie constamment dessus maintenant. Quand une condition d'arrêt doit être subjective — disons, "ce design d'API est-il propre ?" — je ne demande pas au créateur de s'auto-évaluer. Je lance un second agent avec une grille d'évaluation stricte et un mandat d'être dur. La qualité de sortie bondit, parce qu'il y a maintenant quelque chose dans la boucle construit pour repousser.
Puis il y a les flottes imbriquées — des managers dirigeant des sous-agents, des boucles orchestrant des boucles. C'est ce que le "quelques centaines d'agents lisant mon GitHub et Slack et décidant quoi construire" de Cherny est réellement. Une boucle de niveau supérieur observe son activité et raisonne sur les priorités. Elle dispatche des sous-boucles pour gérer des builds spécifiques. Chaque sous-boucle a son propre déclencheur, espace d'action et condition d'arrêt, et rapporte en retour. La condition d'arrêt de la boucle manager n'est pas "ai-je écrit du code ?" — c'est "ma flotte a-t-elle livré les bonnes choses ?" Ce sont des boucles jusqu'en bas, avec des portes de vérification à chaque couche.
Si vous essayez d'architecturer quelque chose à cette échelle, les patterns d'orchestration méritent leur propre traitement approfondi — j'ai décrit comment structurer les managers, les sous-agents et le passage de messages entre eux dans mon analyse de l'architecture d'essaim d'agents Claude Code. La version courte : les flottes imbriquées multiplient à la fois votre débit et votre surface de défaillance. Chaque couche qui manque d'une vraie condition d'arrêt est une couche où la médiocrité peut entrer et se propager vers le haut sans être remarquée.
Et le harnais en dessous de tout ça importe plus que les agents eux-mêmes. La façon dont Anthropic conçoit son harnais d'agent longue durée — comment l'état persiste entre les itérations, comment le contexte est géré pour que la boucle ne se noie pas dans sa propre histoire — a fondamentalement façonné ma façon de penser la durabilité des boucles ; j'ai détaillé ça dans mon article sur le design du harnais d'agent d'Anthropic. Une boucle n'est aussi bonne que le harnais dans lequel elle tourne.
Si vous hochez la tête en pensant "super, je vais tout mettre en boucle" — stop. C'est exactement là où je dois freiner, parce que la compétence la plus importante en loop engineering est de savoir quand ne pas en construire une.
Quand NE PAS écrire une boucle
Voici les données inconfortables que la foule du "arrêtez de prompter, commencez à boucler" tend à passer sous silence. Une enquête de 2025 auprès de 306 praticiens a révélé que 68 % des agents en production exécutent dix étapes ou moins avant qu'un humain n'intervienne. Relisez ça. Les systèmes d'agents qui fonctionnent réellement en production ne sont pas des essaims autonomes de deux cents. Ils sont petits. Ils sont supervisés. Ils exécutent une poignée d'étapes puis un humain prend le relais.
Ce n'est pas un échec de la technologie. C'est la technologie utilisée par des gens qui ont appris à la dure où les boucles cassent.
Le mode de défaillance a maintenant un nom : agent slop. C'est ce que vous obtenez quand vous automatisez au-delà du point où vous pouvez encore vous porter garant de la sortie. La boucle continue de produire, le volume continue de monter, et la qualité se dégrade silencieusement parce que rien dans le système n'a été construit pour détecter la dérive. Vous finissez avec mille commits auxquels vous ne pouvez pas faire confiance et que vous n'avez pas lus. Le slop n'est pas du mauvais code — c'est du code dont on ne peut pas se porter garant, généré plus vite que n'importe quel humain ne peut le vérifier.
Alors voici ma liste honnête de quand sauter complètement la boucle :
Sautez si vous êtes un constructeur solo sur un plan consommateur. Les boucles dépensent des tokens à chaque itération, et une boucle incontrôlée sur un plan mesuré est une vraie facture. (Demandez-moi comment je le sais — 12 $ en 28 minutes, et c'était un petit.) Si vous êtes sensible aux coûts, les maths des boucles autonomes deviennent moches vite. J'ai détaillé l'économie complète des tokens dans mon guide d'optimisation des coûts d'agents IA, et le titre est simple : sans une porte dure, les boucles échouent silencieusement et continuent de dépenser. Échec silencieux plus facturation mesurée est la pire combinaison dans tout ce domaine.
Sautez si votre code n'a pas de vérification automatisée. Pas de tests, pas de vérificateur de types, pas de CI ? Alors votre seule condition d'arrêt possible est l'opinion d'un LLM — la porte de plus basse fidélité qui existe. Vous n'avez pas une boucle ; vous avez une façon coûteuse de générer des diffs qui semblent plausibles. Construisez d'abord les tests. L'infrastructure de vérification est l'infrastructure de la boucle. Une boucle sans porte dure qui repousse est l'agent qui se donne raison en boucle, et c'est précisément la machine à slop.
Sautez si votre vrai goulot d'étranglement est la capacité de revue, pas la vitesse de frappe. Celui-ci est subtil et attrape les bons ingénieurs. Les boucles rendent la production plus rapide. Elles ne font rien pour la revue. Si vous êtes déjà submergé de PRs que vous ne pouvez pas revoir assez vite, ajouter une boucle qui génère dix fois plus de code n'aide pas — ça vous enterre. La contrainte s'est juste déplacée. Vous avez optimisé la partie qui n'était pas le problème. Avant de construire une boucle, demandez-vous honnêtement : est-ce que taper est mon goulot d'étranglement, ou est-ce que se porter garant est mon goulot d'étranglement ? Si c'est se porter garant, une boucle empire les choses.
Le principe unificateur : une boucle n'est aussi fiable que la chose en elle qui peut dire non. Pas de test, pas de vérification de types, pas de vraie erreur à laquelle réagir — pas de boucle. Juste un agent qui hoche la tête tout seul pendant que le compteur tourne.
Ce que ça change concrètement dans votre travail
Alors, où ça vous laisse pratiquement, cette semaine ?
La lecture honnête du mouvement "écrivez des boucles, pas des prompts" est qu'il est directionnellement correct et tactiquement exagéré. L'avenir est véritablement aux boucles — Cherny n'a pas tort que son travail est maintenant d'écrire la machinerie, pas les prompts. Mais le chiffre de 68 % est le rappel à la réalité : les boucles qui survivent au contact avec la production sont petites, gardées et supervisées. Le rêve d'une flotte de deux cents agents tournant sans surveillance est réel pour les gens qui ont construit une vérification blindée autour de chaque couche. Pour tous les autres, c'est un générateur de slop avec une carte de crédit.
Ce que je ferais réellement, en commençant aujourd'hui : prenez une tâche répétitive que vous faites avec un agent IA — celle où vous continuez à taper le même type de prompt encore et encore. Écrivez d'abord sa condition d'arrêt, avant toute autre chose. Faites-en un fait, pas une opinion : un test, un code de sortie, une vérification de statut. Si vous ne pouvez pas nommer ce fait, vous venez de découvrir que la tâche n'est pas prête pour la boucle, et vous vous êtes épargné une leçon à 12 $. Si vous pouvez le nommer, vous avez déjà construit la partie la plus difficile de la boucle. Le déclencheur et l'action sont la moitié facile.
Le modèle mental que je veux que vous emportiez est assez petit pour tenir sur un post-it : une boucle est une machine pour répéter raisonner-agir-observer jusqu'à ce qu'une chose qui peut dire non dise oui. Concevez cette "chose qui peut dire non" en premier. Tout le reste est de la tuyauterie.
Cette boucle incontrôlée qui m'a coûté 12 $ n'était pas un échec de l'agent. C'était un échec de définition — j'ai construit la tuyauterie avant de construire la porte. Construisez la porte d'abord. Ensuite vous pouvez laisser la boucle tourner, et réellement faire confiance à ce qu'elle vous remet quand elle s'arrête.
Questions fréquemment posées
Qu'est-ce que le loop engineering ?
Le loop engineering est la discipline de concevoir le déclencheur, l'action et la condition d'arrêt d'un agent autonome pour qu'il puisse s'exécuter, vérifier sa propre sortie et s'arrêter selon des critères objectifs — au lieu de dépendre d'un unique prompt écrit par un humain. L'unité de travail passe du prompt à la boucle elle-même. Pour l'anatomie complète, voir la section déclencheur/action/condition d'arrêt ci-dessus.
Le loop engineering est-il la même chose que le prompt engineering ?
Non. Le prompt engineering optimise une unique instruction que vous donnez au modèle ; le loop engineering optimise la machinerie qui fait des prompts au modèle de façon répétée et décide quand le travail est terminé. Comme Boris Cherny l'a dit : "Mon travail est d'écrire des boucles" — le prompt devient un détail interne de la boucle, pas la chose que vous élaborez à la main.
Quand ne devriez-vous pas utiliser une boucle d'agent ?
Sautez une boucle d'agent si vous êtes un constructeur solo sur un plan consommateur (les coûts de tokens s'accumulent à chaque itération), si votre code n'a pas de vérification automatisée (tests, types, CI) pour servir de condition d'arrêt objective, ou si votre vrai goulot d'étranglement est la capacité de revue plutôt que la vitesse de frappe. Une enquête de 2025 auprès de 306 praticiens a révélé que 68 % des agents en production exécutent dix étapes ou moins avant qu'un humain n'intervienne — petit et supervisé bat autonome et irresponsable.
Qu'est-ce que le pattern maker-checker dans les agents IA ?
Le pattern maker-checker divise une boucle d'agent en deux rôles : un agent produit le travail et un agent séparé l'évalue selon des critères. Parce que le vérificateur n'a pas créé la sortie, il n'a aucune incitation à la tamponner — donnant à la boucle un véritable adversaire qui peut repousser. C'est la solution la plus propre pour les boucles dont la condition d'arrêt serait autrement subjective.
Qu'est-ce qui rend la condition d'arrêt d'une boucle d'agent fiable ?
La fidélité de vérification. Une porte objective — un test unitaire qui passe, un pipeline CI au vert, un HTTP 200 — est un fait que l'agent ne peut pas simuler, donc la boucle peut tourner sans surveillance. Une porte subjective, comme un LLM qui juge si une image "a l'air bien," est une opinion facile à tromper, donc elle a besoin d'un humain aux commandes ou d'un plafond dur de tentatives. Ajustez l'autonomie de la boucle à la fidélité avec laquelle sa porte mesure le vrai objectif.
Travaillons ensemble
Vous cherchez à construire des systèmes d'IA, automatiser des workflows ou faire évoluer votre infrastructure technologique ? Je serais ravi de vous aider.
- Fiverr (développement sur mesure et intégrations) : fiverr.com/s/EgxYmWD
- Portfolio : mejba.me
- Ramlit Limited (solutions entreprise) : ramlit.com
- ColorPark (design et branding) : colorpark.io
- xCyberSecurity (services de sécurité) : xcybersecurity.io