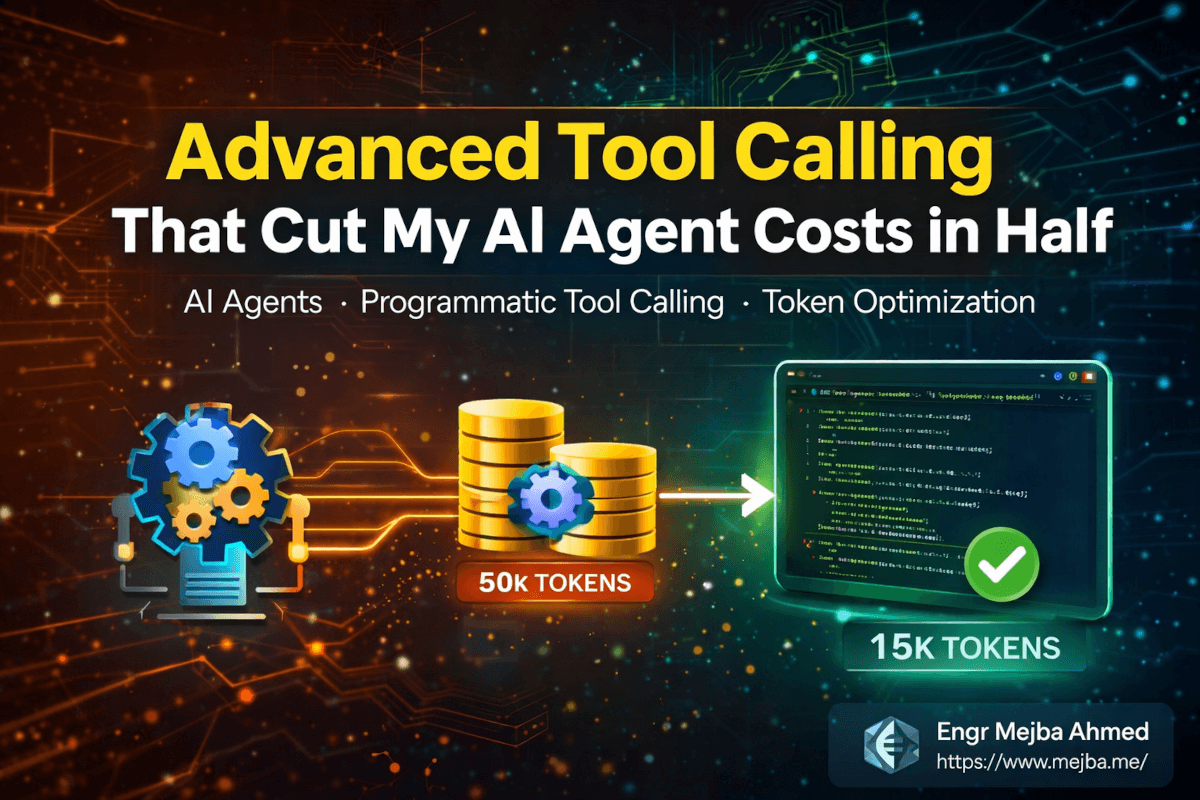
Toda conversa sobre custos de agentes de IA começa pelo preço dos modelos e termina sem mencionar o que de fato define a conta: o padrão de chamadas. Um agente com sessenta ferramentas carregadas paga por sessenta schemas de ferramentas em cada turno, usando-as ou não, e um agente que percorre um dataset com uma chamada de ferramenta por item paga para que cada resultado intermediário fique no contexto para sempre. Eu construo agentes com uso intenso de MCP e passo os meus dias de trabalho dentro exatamente desse tipo de ambiente — as minhas próprias sessões do Claude Code têm dezenas de servidores MCP conectados, expondo centenas de ferramentas —, então isso não é uma curiosidade de benchmark para mim. É a diferença entre sessões que continuam afiadas o dia todo e sessões que se afogam antes do almoço.
Dois padrões resolvem a maior parte disso: o carregamento adiado de ferramentas (tool search) e o programmatic tool calling. Ambos chegaram como recursos de primeira classe na plataforma da Anthropic no fim de 2025, e ambos são, na verdade, padrões de arquitetura que você pode aplicar em qualquer stack. Veja como eles funcionam, o que aprendi trabalhando dentro deles todos os dias e onde cada um deixa de compensar.
Por que a quantidade de ferramentas destrói agentes silenciosamente
A curva de falha é previsível. Um protótipo com 8 ferramentas funciona lindamente: contexto limpo, seleção precisa. Aí as integrações se acumulam — GitHub, Slack, calendário, um servidor de banco de dados, um servidor de automação de navegador — e, em algum ponto depois de 30 ou 40 ferramentas, o agente desenvolve um transtorno de personalidade. Ele escolhe ferramentas quase certas, alucina formatos de parâmetros e queima milhares de tokens de definições antes de ler a primeira frase do usuário.
Três custos distintos se acumulam:
- Overhead de definições. Cada schema de ferramenta carregado é token de input em todo turno. Um único servidor MCP prolixo pode enviar dezenas de milhares de tokens de definições; multiplique por alguns servidores e você terá gasto uma fatia significativa da sua janela de contexto com um cardápio.
- Precisão de seleção. Escolher entre 12 ferramentas é uma tarefa cognitiva diferente de escolher entre 60. As próprias avaliações da Anthropic sobre o recurso de tool search mostraram grandes ganhos de precisão em benchmarks com uso intenso de MCP simplesmente por não carregar de antemão todas as definições — menos ruído, sinal melhor.
- Poluição por outputs intermediários. Cadeias de chamadas em série despejam cada resposta bruta no contexto. Lá pelo item quarenta de um loop, o modelo está pagando um imposto de atenção sobre os trinta e nove primeiros.
Você não consegue sair de nenhum desses problemas na base do prompt. Eles são arquiteturais.
Padrão 1: adie as ferramentas, carregue sob demanda
O tool search inverte o padrão. Em vez de carregar todas as definições de antemão, o agente começa com um pequeno núcleo sempre carregado mais uma ferramenta especial: a própria ferramenta de busca. As ferramentas adiadas existem apenas como nomes. Quando o agente precisa de uma capacidade, ele busca — por palavra-chave, ou pelo nome exato com um prefixo select: — e apenas os schemas correspondentes são carregados no contexto, onde então permanecem pelo resto da sessão.
Eu não apenas recomendo esse padrão; eu vivo dentro dele. As minhas sessões diárias rodam com o ecossistema de conectores do Claude — Figma, Slack, Supabase, automação de navegador e mais — quase inteiramente adiado. Centenas de ferramentas existem como uma lista de nomes; as poucas de que cada tarefa precisa são carregadas quando necessário. Duas lições operacionais do lado de quem consome essa experiência, que nenhum anúncio de recurso vai contar a você:
- Carregue os schemas em lote. Carregar ferramentas uma de cada vez custa uma ida e volta completa para cada uma. A forma
select:aceita uma lista separada por vírgulas, então uma tarefa que obviamente precisa de cinco ferramentas de navegador deve carregar as cinco em uma única chamada. Servidores MCP bem-comportados agora colocam essa instrução nas notas de configuração, porque agentes que carregam preguiçosamente, uma por uma, parecem lentos mesmo quando são baratos. - Ajuste o conjunto sempre carregado com base no uso, não na intuição. Adie de forma agressiva demais e o agente começa toda conversa buscando ferramentas de que precisa 90% das vezes — latência e tokens gastos em cerimônia. A configuração com escopo de projeto que uso para este site é o contraexemplo bem feito: o servidor MCP Laravel Boost vai no
.mcp.jsondo repo, com um conjunto de ferramentas enxuto e de propósito único (schema do banco de dados, tinker, listagem de rotas, busca na documentação) que vale a pena manter residente, porque, em um codebase Laravel, essas ferramentas são acionadas o tempo todo. Ferramentas residentes devem conquistar a residência do mesmo jeito que linhas conquistam o seu lugar em um CLAUDE.md: sendo usadas nesta semana.
A economia do adiamento também muda a forma como você escolhe servidores MCP. O preço real de um servidor é o payload das suas definições, e a diferença entre um servidor enxuto e um inchado que fazem o mesmo trabalho pode ser de uma ordem de grandeza. Trate "tokens de schema por capacidade útil" como um critério primário de seleção — falo mais sobre esse cálculo no meu playbook de otimização de custos de agentes.
Padrão 2: escreva um loop, não uma cadeia de chamadas
Chamar ferramentas em série transforma a iteração em uma fogueira de tokens. O formato canônico: buscar uma lista de N itens e depois fazer mais duas chamadas por item, com cada resposta bruta se acumulando no contexto. Passando de um punhado de itens, você paga de três formas — tokens por dados de que o modelo só precisava de passagem, latência a cada ida e volta, e precisão, porque os modelos prestam pouca atenção ao meio de contextos longos e o item 14 de 15 é processado pior do que o item 1.
O programmatic tool calling substitui a cadeia por código gerado. O agente escreve um script; o script roda em um sandbox, faz todas as chamadas de ferramentas internamente, realiza as comparações e filtragens em código de verdade e devolve apenas a conclusão para a conversa. Um for-loop não sofre degradação de atenção. A décima quinta iteração é executada exatamente como a primeira.
Isso também é a minha prática do dia a dia, não apenas um recurso de plataforma sobre o qual li. Quando os meus pipelines de conteúdo precisam processar dezenas de linhas do banco de dados — os jobs em lote que reescreveram e retraduziram grandes partes deste blog —, a sessão não chama uma ferramenta de banco de dados uma vez por linha. Ela escreve um script PHP que busca tudo, transforma tudo em um loop e reporta um resumo. O contexto da conversa guarda o plano e o resultado, nunca oitenta payloads intermediários. Mesmo princípio, auto-hospedado.
Duas ressalvas honestas de quem faz isso repetidamente:
- A geração de código é iterativa. As primeiras tentativas têm bugs — uma chave errada, uma checagem de null faltando. O sandbox dá erro, o modelo lê o erro, corrige e roda de novo. Esse loop é um recurso (é assim que humanos programam também), mas reserve orçamento para várias iterações em scripts não triviais.
- Existe um piso. Para duas ou três chamadas de ferramentas, gerar e executar código custa mais do que simplesmente fazer as chamadas. Um limite razoável fica em torno de cinco chamadas sequenciais ou de qualquer iteração por item; abaixo disso, o tool calling simples é mais fácil e geralmente mais barato.
Se você roda isso em produção com código gerado pelo modelo, o isolamento é inegociável: execução em sandbox, nenhuma credencial do host dentro do sandbox, chamadas de ferramentas intermediadas por uma ponte que guarda os segredos. O script gerado nunca deve conseguir ver uma API key, mesmo que tente.
Padrão 3: faça cada definição de ferramenta merecer os tokens que custa
A terceira camada não tem glamour: as próprias definições. Depois de escrever muitas definições de ferramentas e skills — e de ver agentes interpretarem errado várias delas —, estas são as minhas regras de trabalho:
- Descrições servem para desambiguar, não para documentar. O modelo precisa do suficiente para escolher corretamente entre as suas ferramentas, não de uma man page. Leve o contexto de fundo para o output da ferramenta ou para um recurso sob demanda.
- Um exemplo de uso por formato de parâmetro não óbvio. Datas, enums, objetos aninhados. Um único exemplo como
{"date": "2026-01-15"}reduz o leque de formatos plausíveis, porém errados, que um agente exploraria à sua custa. Teste o exemplo contra a API real antes — um exemplo errado é pior do que nenhum, porque o modelo vai segui-lo fielmente. - Elimine variantes redundantes. Três ferramentas quase idênticas com descrições sobrepostas são um imposto de precisão sobre cada seleção. Consolide-as atrás de parâmetros.
É a mesma disciplina de podar skills e enxugar system prompts: tudo o que o agente carrega é uma cobrança recorrente. Já escrevi antes sobre por que contexto vence configuração — definições de ferramentas são apenas configuração que cobra de você a cada turno.
Estes são padrões, não recursos de um fornecedor
Tool search é lazy loading. Programmatic calling é geração e execução de código. Nenhum dos dois conceitos é específico do Claude, ainda que a Anthropic tenha lançado as implementações mais refinadas. No LangChain, em um framework próprio ou em qualquer outra coisa: mantenha um registro de ferramentas com metadados leves, dê ao agente uma função de busca sobre ele, carregue os schemas na seleção; e, para fluxos com muitos dados, faça o agente emitir um script que roda contra a sua camada de ferramentas em um sandbox e devolve apenas conclusões. O ecossistema MCP está indo na mesma direção — recuperação sobre ferramentas em vez de ferramentas no contexto —, algo que explorei quando analisei o que está substituindo o padrão MCP de carregar tudo.
A mudança mais profunda é mental: pare de pensar em um agente como um chatbot que usa ferramentas e comece a pensar nele como um sistema de orquestração que por acaso inclui um LLM. Aí a pergunta de design deixa de ser "quais ferramentas devo adicionar?" e passa a ser "o que deve ficar residente, o que deve ser descobrível e o que deve ser um script?". Projete agora para o futuro de 500 ferramentas — a quantidade de ferramentas só aumenta — e as sessões longas param de se degradar, o que é metade da batalha que descrevo no meu playbook sobre context rot.
Ordem de adoção
- Acima de ~15-20 ferramentas: adie. Núcleo residente pequeno, busca para o resto, carregamento em lote.
- Qualquer fluxo com 5+ chamadas sequenciais ou loops por item: vá de programmatic. Conclusões no contexto, dados no sandbox.
- Toda ferramenta com um parâmetro não óbvio: adicione um exemplo testado.
- Audite as definições a cada trimestre. Servidores são atualizados; os payloads voltam a inchar.
Eu projeto e construo sistemas de agentes com uso intenso de MCP — arquitetura de ferramentas, seleção de servidores, execução em sandbox, tudo isso — para times cujas contas ou taxas de erro de agentes deixaram de fazer sentido. Se o seu está nesse estágio, descreva o que o seu agente faz e onde dói e eu direi honestamente qual dessas camadas vai mexer nos seus números.