Ik verloor op een donderdagavond drie uur werk omdat Claude Code vergat welk bestand het aan het bewerken was.
Geen crash. Geen bug. Geen netwerkonderbreking. Claude vergat het gewoon. Ik was veertig minuten bezig met een complexe refactoring-sessie over zes bestanden, en midden in de taak begon het wijzigingen voor te stellen aan een functie-signatuur die het twintig minuten eerder al had aangepast. Toen ik dit aangaf, bood het zijn excuses aan, vroeg me de projectstructuur opnieuw uit te leggen, en maakte daarna precies dezelfde fout vanuit een iets andere hoek.
Ik zat daar te staren naar een terminal vol zelfverzekerde, welbespraakte, volkomen verkeerde suggesties, en ik voelde iets dat elke doorgewinterde Claude Code-gebruiker uiteindelijk voelt: het langzame besef dat het geheugen van je AI-partner een houdbaarheidsdatum heeft. En dat die houdbaarheidsdatum korter is dan je denkt.
Dat was drie maanden geleden. Sindsdien gebruik ik een tool genaamd Context Mode, die fundamenteel veranderd heeft hoe Claude Code zijn werkgeheugen beheert. Mijn sessies gingen van stukbreken na 30 minuten naar soepel doorlopen tot meer dan drie uur. Mijn tokenkosten daalden — in sommige gevallen met 99%. En de oplossing was geen slimme truc. Het was een architectureel inzicht dat me, zodra ik het begreep, deed afvragen waarom niet elke AI-codeertool al op deze manier werkt.
Maar voordat ik uitleg hoe Context Mode werkt, moet je begrijpen welk probleem het oplost — want de meeste ontwikkelaars beseffen niet in hoeverre context bloat hun Claude Code-sessies op dit moment stil saboteert.
Waarom vergeet Claude Code na 30 minuten?
Dit verraste me toen ik er voor het eerst in dook. Het 200K-tokencontextvenster van Claude Code klinkt enorm. En voor een taak met één bestand — los deze bug op, schrijf deze functie, leg deze fout uit — is dat ook zo. Je zult nooit tegen de muur lopen.
De muur verschijnt wanneer je Claude Code gebruikt op de manier waarop ervaren gebruikers het echt gebruiken: met MCP-tools. Playwright voor browsertesten. GitHub-integraties voor issue-tracking. Bestandssysteemtools voor het navigeren door grote codebases. Analytics-dashboards. Log-parsers. Elk van deze tools dumpt zijn uitvoer rechtstreeks in het contextvenster van Claude.
En die uitvoer is niet klein.
Een enkele Playwright-browsersnapshot — slechts één paginarender — vreet 56 KB aan context op. Geen typefout. Zesenvijftig kilobytes voor één snapshot van één pagina. Playwright drie keer uitvoeren tijdens een debugsessie, en je hebt 168 KB van je 200K-budget opgebruikt aan browser-snapshots alleen. Dat laat ruwweg 32 KB over voor al het overige: je gespreksgeschiedenis, je codebestanden, je instructies, de redenering van Claude.
Ik heb mijn eigen gebruikspatronen twee weken bijgehouden voordat ik Context Mode vond. De cijfers waren niet fraai.
Twintig GitHub-issues in de context voor een sprintplanningssessie? 59 KB weg. Een analytics-CSV via een MCP-tool? De onbewerkte uitvoer verbruikte bijna het volledige resterende venster. Een serverzugangslog van 5.000 regels die ik Claude liet analyseren? 20 KB — en dat was een relatief klein logbestand.
De wiskunde klopt niet. Je raakt niet uitgeput van intelligentie. Je raakt uitgeput van ruimte.
Als het contextvenster van Claude vol raakt, crasht het niet en geeft het geen foutmelding. Het doet iets verraderlijker: het start een proces genaamd compaction, waarbij oudere context stil wordt verwijderd om ruimte te maken voor nieuwe invoer. Je vroege gesprek — het deel waar je de projectarchitectuur, je beperkingen, je doelen uitlegde — wordt gecomprimeerd of volledig weggegooid. Claude blijft werken, blijft reageren, blijft zelfverzekerd klinken. Maar het werkt op een fractie van de informatie waarmee het begon.
Daarom voelt je 45 minuten durende sessie de eerste 25 minuten productief aan en begint het daarna mis te gaan. Claude wordt niet dommer. Het krijgt geheugenverlies.
Dit was het probleem dat ik niet uit mijn hoofd kon zetten. En het bleek dat iemand een elegante oplossing had gebouwd die ik bijna over het hoofd had gezien.
Wat Context Mode onder de motorkap doet
Toen ik voor het eerst over Context Mode hoorde, dacht ik dat het weer een prompt-engineering-wrapper was — een slimme systeemprompt die Claude vertelde voorzichtiger te zijn met geheugen. Ik had het mis. De architectuur is echt interessant, en het begrijpen ervan veranderde hoe ik over AI-toolontwerp nadenk in het algemeen.
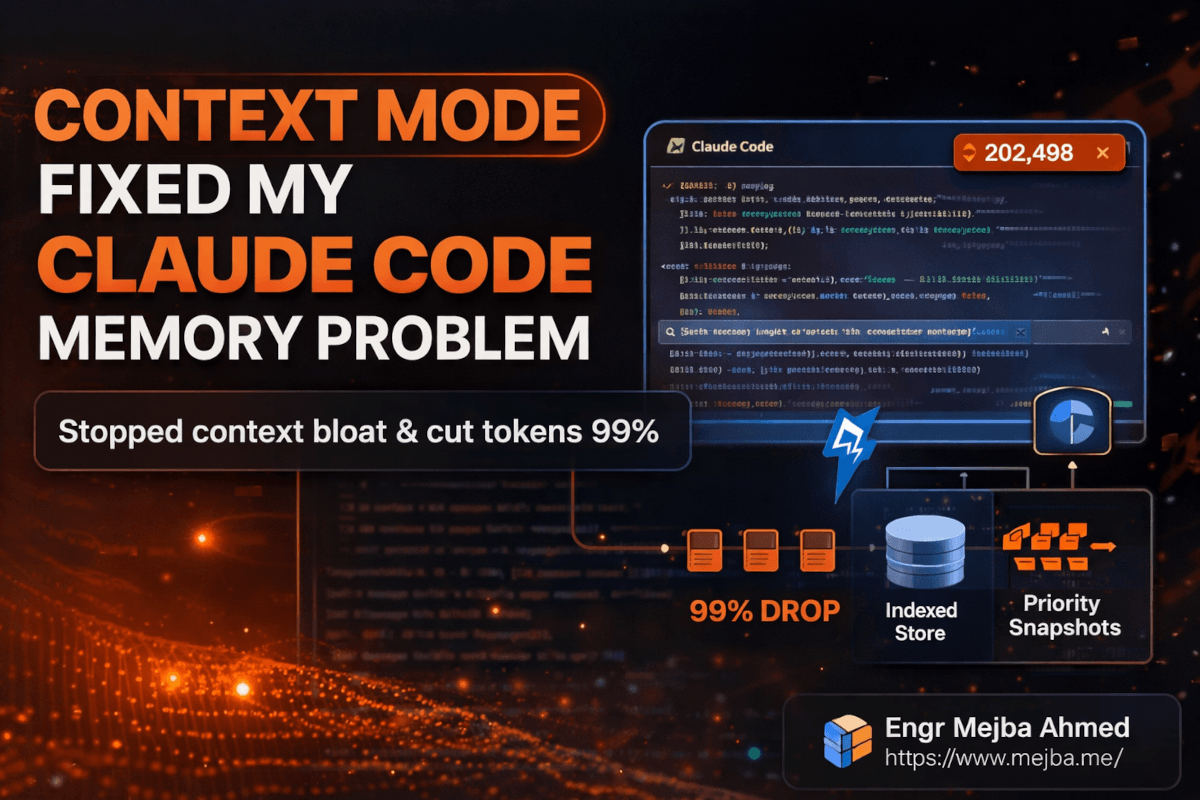
Context Mode werkt als een virtualisatielaag tussen Claude Code en het besturingssysteem. In plaats van MCP-tooluitvoer direct in het contextvenster van Claude te laten stromen, onderschept Context Mode deze, indexeert de inhoud in een lokale SQLite-database met behulp van FTS5 full-text search, en geeft Claude een lichtgewicht bevestigingsbericht terug.
Denk daar even over na. Wanneer Claude Playwright vraagt om een pagina te snapshootten, ontvangt het in plaats van 56 KB aan onbewerkte DOM iets terug als: "Snapshot geïndexeerd. Samenvatting van 299 bytes beschikbaar. Opvraagbaar wanneer nodig." Dat is een vermindering van 99% per enkele operatie.
Het sleutelinzicht is dat Claude niet alle gegevens tegelijk in zijn contextvenster nodig heeft. Het moet weten dat de gegevens bestaan, wat ze op hoog niveau bevatten, en hoe specifieke stukken op te halen wanneer relevant. Context Mode geeft het precies dat — een doorzoekbare index in plaats van een datadump.
Hier wordt de architectuur slim. Context Mode comprimeert niet alleen en vergeet dan. Het behoudt drie geheugenlagen:
De live context — wat Claude momenteel in zijn 200K-venster heeft, sober en gericht op de actieve taak gehouden.
De geïndexeerde opslag — alles wat Context Mode heeft onderschept en gecatalogiseerd in SQLite, doorzoekbaar via FTS5 full-text queries. Claude kan specifieke records op aanvraag terugzetten in de context, maar alleen de stukken die het daadwerkelijk nodig heeft.
Prioriteitsgelaagde snapshots — gecomprimeerde controlepunten van elk minder dan 2 KB, die automatisch worden geïnjecteerd in de context tijdens compaction-gebeurtenissen. Deze fungeren als broodkruimels, zodat Claude bewustzijn behoudt van belangrijke beslissingen, bestandsstatus en taakvoortgang, zelfs wanneer de hoofdcontext wordt ingekort.
Die derde laag loste mijn donderdagnachtprobleem op. Zonder Context Mode wist compaction de lei schoon. Met Context Mode krijgt Claude kleine checkpoint-samenvattingen geïnjecteerd tijdens compaction, die de essentiële draad bewaren: welke bestanden zijn gewijzigd, welke beslissingen zijn genomen, wat het huidige doel is, en wat er al geprobeerd is.
Het resultaat? Sessies die vroeger na 30 minuten instortten, lopen nu betrouwbaar door tot drie uur of meer.
Maar de tokenbesparingen zijn wat me echt deed opperken. Laat me de werkelijke cijfers laten zien.
De compressiecijfers die mijn mening veranderden
Ik ben standaard sceptisch. Wanneer een tool "99% vermindering" in iets claimt, is mijn directe reactie om aan te nemen dat het marketingteam creatief was met de benchmarks. Dus voerde ik mijn eigen tests uit.
| Gegevenstype | Onbewerkte grootte | Na Context Mode | Vermindering |
|---|---|---|---|
| Enkele Playwright-snapshot | 56 KB | 299 bytes | ~99,5% |
| 20 GitHub-issues | 59 KB | Geïndexeerde samenvatting | ~98% |
| Analytics-CSV | Volledige dataset | 222 bytes | ~99,9% |
| Toegangslog van 5.000 regels | 20 KB | 5 KB | 75% |
Het resultaat van het toegangslog is de eerlijkste in die tabel. 75% vermindering — significant, maar niet de "99% van alles"-kop. Gestructureerde logs met veel unieke foutpatronen vereisen meer samenvattingsgegevens om bruikbaar te blijven, dus is de compressieverhouding lager. Dat is fysica, geen beperking.
Het Playwright-getal echter — dat is echt en herhaalbaar. Browser-snapshots bestaan grotendeels uit DOM-structuur en styling-metadata die Claude niet in zijn context nodig heeft om over de pagina te redeneren. Context Mode reduceert het tot de semantische inhoud en lay-outsamenvatting, en in mijn tests degradeerde het vermogen van Claude om vragen over de pagina te beantwoorden niet.
Je denkt misschien: "Oké, de compressie is indrukwekkend, maar presteert Claude slechter wanneer het werkt vanuit samenvattingen in plaats van onbewerkte gegevens?" Ik heb dit ook getest.
Ik voerde dezelfde analytische taak uit — foutpatronen vinden in een serverlog — twee keer. Eén keer met onbewerkte gegevens op de traditionele manier in de context gedumpt, één keer met Context Mode-indexering. De Context Mode-run bespaarde ongeveer 1.200 tokens op een relatief klein bestand van 5.000 regels. Op die schaal voelt de besparing bescheiden aan. Maar hier verandert de wiskunde: dat was een 20 KB-bestand. Productielogs worden gemeten in megabytes. Analytics-exports kunnen tientallen megabytes zijn. Op die schaal bespaar je tienduizenden of honderdduizenden tokens per operatie.
En wat nog belangrijker is: de antwoorden waren hetzelfde. Claude identificeerde dezelfde foutpatronen, dezelfde problematische IP-adressen, dezelfde correlatie tussen tijdstempelclusters en foutpieken. De intelligentie veranderde niet. Alleen de geheugenoverhead deed dat.
Dat is wat de meeste mensen missen bij contextvensteroptimalisatie. Ze denken dat het gaat over Claude goedkoper laten draaien. Dat is het ook — maar de grotere winst is Claude langer slimmer maken. Elke kilobyte die je bespaart op gegevensopslag, is een kilobyte beschikbaar voor redeneren, gespreksgeschiedenis en het bewaren van bewustzijn van de volledige omvang van je project.
Hoe Context Mode te installeren (stap voor stap)
Dit instellen kostte me ongeveer tien minuten. Hier is het exacte proces dat ik volgde, inclusief de twee dingen die me struikelden.
Stap 1: Voeg het Context Mode-register toe
Open je terminal en voer uit:
claude mcp add-registry contextmode https://registry.contextmode.ai/mcp-registry.json
Dit registreert de Context Mode-marktplaats bij je Claude Code-installatie. Je ziet niet veel uitvoer — slechts een bevestiging dat het register is toegevoegd.
Wat mis kan gaan: Als je een oudere versie van Claude Code gebruikt die geen marktplaatsregisters ondersteunt, krijg je een foutmelding over een niet-herkend commando. Update Claude Code eerst: claude update.
Stap 2: Installeer de Context Mode-server
claude mcp install contextmode
Dit haalt de Context Mode MCP-server op en configureert deze als een middleware-laag. De server draait lokaal — je gegevens verlaten je machine nooit. Dit is belangrijk. Elk geïndexeerd bestand, elke snapshot, elke logvermelding blijft in een lokale SQLite-database op je bestandssysteem.
Pro-tip: Controleer na installatie of de server correct is geregistreerd:
claude mcp list
Je zou contextmode in de lijst van actieve MCP-servers moeten zien. Als het er niet is, herstart Claude Code en voer het lijstcommando opnieuw uit.
Stap 3: Controleer het hook-systeem
Context Mode gebruikt hooks om bestandsbewerkingen en subtaakafsluitingen te bewaken. Deze hooks zijn wat het prioriteitsgelaagde snapshot-systeem mogelijk maakt — ze letten op significante statuswijzigingen en maken automatisch checkpoint-samenvattingen aan.
Na de installatie, voer een snelle test uit:
echo "test content for context mode verification" > /tmp/context-mode-test.txt
claude mcp contextmode status
Je zou het testbestand geïndexeerd moeten zien met een tijdstempel en grootte. Als de hooks werken, wordt elk bestand dat Claude tijdens je sessie aanraakt automatisch bijgehouden.
Stap 4: Snapshotprioriteit configureren (optioneel maar aanbevolen)
Standaard behandelt Context Mode alle geïndexeerde inhoud gelijkwaardig tijdens compaction. Maar je kunt prioriteitsniveaus configureren zodat bepaalde typen gegevens — zoals architectuurbeslissingen of testresultaten — voorkeursbehandeling krijgen in de checkpoint-snapshots.
Ik heb de mijne zo ingesteld:
{
  "snapshot_priorities": {
    "high": ["*.md", "*.yaml", "*.json"],
    "medium": ["*.ts", "*.py", "*.js"],
    "low": ["*.log", "*.csv", "*.tmp"]
  },
  "max_snapshot_size": "2KB",
  "compaction_behavior": "inject_high_priority_first"
}
Dit vertelt Context Mode: wanneer compaction plaatsvindt, injecteer altijd eerst samenvattingen van configuratiebestanden en documentatie, dan broncode, dan logs. De 2 KB-limiet per snapshot houdt de injecties klein genoeg zodat ze niet bijdragen aan het probleem dat ze oplossen.
Het ding dat me struikelde: Ik stelde max_snapshot_size aanvankelijk in op 5 KB, denkend dat meer context in snapshots beter zou zijn. Het maakte de situatie eigenlijk slechter — de snapshots zelf begonnen zinvolle contextruimte te verbruiken tijdens compaction, wat het doel gedeeltelijk tenietdeed. De standaard van 2 KB bestaat om een goede reden. Ik zou het daar laten staan, tenzij je een specifieke reden hebt om het te wijzigen.
Voor Gemini CLI- of VS Code Copilot-gebruikers
Context Mode is niet exclusief voor Claude Code. Als je Gemini CLI of VS Code Copilot gebruikt met MCP-ondersteuning:
npm install -g @contextmode/mcp-server
Voeg vervolgens de serverconfiguratie toe aan je MCP-instellingenbestand. De exacte locatie hangt af van je tool:
- Gemini CLI:
~/.gemini/mcp-servers.json - VS Code Copilot:
.vscode/mcp-servers.jsonin je workspace
Het configuratieblok ziet er zo uit:
{
  "contextmode": {
    "command": "contextmode-server",
    "args": ["--port", "3100"],
    "env": {
      "CONTEXTMODE_DB_PATH": "~/.contextmode/index.db"
    }
  }
}
Als je liever iemand dit laat instellen en integreren in een groter ontwikkelworkflow — vooral als je multi-agent-architecturen of complexe MCP-toolketens gebruikt — neem ik dat soort opdrachten aan. Je kunt zien wat ik heb gebouwd op fiverr.com/s/EgxYmWD.
Dat dekt de installatie. Maar de echte test van een tool is niet of het schoon installeert — het is of het standhoudt wanneer je er echte werkdruk op gooit.
Context Mode stresstesten met een toegangslog van 5.000 regels
Ik wilde Context Mode pushen met iets realistisch, niet een speelgoedvoorbeeld. Dus schreef ik een Python-script dat een synthetisch serverzugangslog genereert — 5.000 regels, ruwweg 500 ingebedde fouten over verschillende HTTP-statuscodes, verdeeld over verschillende IP-adressen en tijdstempels.
import random
import datetime

status_codes = [200] * 70 + [301] * 5 + [404] * 10 + [500] * 8 + [502] * 4 + [503] * 3
ips = [f"192.168.1.{random.randint(1, 50)}" for _ in range(50)]
paths = ["/api/users", "/api/orders", "/login", "/dashboard", "/api/products",
         "/healthcheck", "/api/auth/token", "/webhook/stripe"]

with open("demo_access.log", "w") as f:
    base_time = datetime.datetime(2026, 3, 10, 0, 0, 0)
    for i in range(5000):
        timestamp = base_time + datetime.timedelta(seconds=i * 6)
        ip = random.choice(ips)
        path = random.choice(paths)
        status = random.choice(status_codes)
        size = random.randint(200, 15000)
        f.write(f'{ip} - - [{timestamp.strftime("%d/%Mar/%Y:%H:%M:%S")} +0000] '
                f'"GET {path} HTTP/1.1" {status} {size}\n')
Zonder Context Mode zou Claude Code dit bestand laten analyseren door alle 20 KB in het contextvenster te dumpen. Met 200K tokens totaal en andere lopende tools is dat een merkbaar groot deel — en bij een echte productielog die tien of vijftig keer zo groot is, wordt het een sessiebreker.
Met Context Mode actief, gebeurde het volgende:
Claude vroeg het bestand op. Context Mode onderschepte de leesbewerking, indexeerde alle 5.000 regels in de lokale SQLite-database, en stuurde een samenvatting van 5 KB terug naar de context van Claude. Die samenvatting bevatte: totaal aantal regels, datumbereik, uniek aantal IP-adressen, verdeling van statuscodes, en de meest foutgevoelige endpoints.
Claude ondervroeg vervolgens de index — niet het onbewerkte bestand — om mijn vragen te beantwoorden. "Welke IP-adressen genereren de meeste 500-fouten?" "Is er een patroon per tijdstip bij de 502's?" "Welke endpoints hebben de hoogste foutpercentage?"
Elk antwoord klopte. Ik verifieerde dit tegen een handmatige grep van het onbewerkte log. De resultaten kwamen overeen.
De tokenbesparingen op dit kleine testbestand waren ongeveer 1.200 tokens — ruwweg 25% van wat de onbewerkte inname zou hebben gekost. Maar hier is het getal dat er echt toe doet: gedurende de hele analysesessie bereikte Claude geen enkele compaction-gebeurtenis. Zonder Context Mode op een bestand van dit formaat zou ik compaction normaal gesproken zien intreden na de derde of vierde query, naarmate de geaccumuleerde context van vragen, antwoorden en onbewerkte gegevens het venster overschreed. Met Context Mode voerde ik twaalf queries uit op het log zonder ook maar één compaction.
Twaalf queries. Nul geheugenverval. Op een enkel bestand dat normaal gesproken al bij query vier context-verval zou hebben veroorzaakt.
Schaal dat op naar een echte productie-debugsessie — meerdere logbestanden, databasequeryresultaten, API-responsedumps, browsersnapshots — en je begrijpt waarom deze tool ertoe doet.
Wat niemand je vertelt over Context Mode
Ik gebruik Context Mode nu drie maanden, en je verdient de eerlijke versie. Niet de marketingpraatjes. De echte ervaring, inclusief de delen die niet perfect zijn.
Het koude-startprobleem is echt. Wanneer je een nieuwe Claude Code-sessie begint met Context Mode, is de SQLite-index leeg. De waarde van Context Mode is cumulatief — het wordt nuttiger naarmate het meer gegevens van je project indexeert gedurende de sessie. Voor de eerste vijf tot tien minuten zie je geen dramatische voordelen. De beloningscurve is achteroplopend. Als je sessies doorgaans minder dan vijftien minuten duren, voegt Context Mode overhead toe zonder veel rendement.
FTS5-zoekopdrachten zijn geen semantisch zoeken. Dit struikelde me vroeg. Context Mode gebruikt SQLite's FTS5 full-text search, wat op trefwoorden is gebaseerd, niet op inbeddingen. Als je Claude een vaag conceptuele vraag stelt over geïndexeerde gegevens — "wat is de algehele gezondheid van het systeem?" — kan de index de juiste records niet oppervlakken omdat er geen trefwoordovereenkomst is. Je krijgt betere resultaten wanneer je vragen specifieke termen bevatten die in de geïndexeerde inhoud voorkomen. Het is een zoekmachine, geen gedachtenlezer.
Ik dacht vroeger dat dit een dealbreaker was. Drie maanden later heb ik van mening veranderd. In de praktijk zijn de meeste vragen van ontwikkelaars tijdens een codering-sessie specifiek genoeg dat trefwoordzoeken prima werkt. "Vind de 500-fouten van dit IP-bereik." "Laat me de testfouten van de laatste run zien." "Wat zei de Playwright-snapshot over het inlogformulier?" Dit alles treft de FTS5-index goed.
Sessiecontinuïteit heeft een plafond. Context Mode verlengde mijn nuttige sessieduur van ongeveer 30 minuten naar ruwweg drie uur. Maar het is niet oneindig. Na drie uur van intensief gebruik — veel tool-aanroepen, veel bestandsbewerkingen, veel geïndexeerde gegevens — beginnen de prioriteitssnapshots met elkaar te concurreren om compactionruimte, en zie je enige degradatie. De drie-uurgrens is geen harde klif, maar het is waar ik uit vrije keuze meestal een nieuwe sessie begin.
Het lost slechte prompting niet op. Context Mode optimaliseert geheugen, niet redeneren. Als je instructies aan Claude vaag of tegenstrijdig zijn, zal Context Mode je niet redden. Je bent dan gewoon vaag en tegenstrijdig gedurende drie uur in plaats van dertig minuten. De tool lost een specifiek infrastructuurprobleem op. Het is geen vervanging voor duidelijke communicatie.
Hier is mijn eerlijke oordeel: Context Mode is de grootste verbetering van de gebruikskwaliteit die ik aan mijn Claude Code-setup heb toegevoegd sinds ik MCP-tools ben gaan gebruiken. Maar het is een infrastructuurverbetering, geen magie. Het laat het onderliggende systeem werken op de manier waarop je waarschijnlijk al dacht dat het werkte — context bewaren gedurende je volledige sessie in plaats van het stil weg te gooien. Het feit dat het überhaupt moet bestaan, zegt iets over de huidige staat van AI-codeerhulpmiddelen: het contextvenster is nog steeds de bottleneck, en we zijn nog vroeg in het goed oplossen ervan.
Hoe drie maanden Context Mode er werkelijk uitzien
Ik wil hier voorzichtig zijn, want ik heb te veel blogposts gezien die verzonnen statistieken gooien om een tool transformatief te laten klinken. Ik heb geen precieze dollarbedragen voor tokenbesparingen — mijn gebruik varieert te veel per sessie voor een nette voor/na-vergelijking. Wat ik kan delen zijn de patronen die ik consistent heb waargenomen.
Sessieduur: Voor Context Mode bereikte ik merkbare degradatie — Claude herhaalde vragen, vergat bestandswijzigingen, verloor het overzicht over de taakenstructuur — bij ruwweg de 30-minutengrens in tool-zware sessies. Met Context Mode verplaatste dat degradatiepunt naar ongeveer drie uur. Dat is ruwweg een 6x verlenging, consistent waargenomen over tientallen sessies.
Contextherstel na compaction: Dit is de verandering die ik het meest merk in dagelijks gebruik. Eerder, wanneer compaction plaatsvond, voelde het als opnieuw beginnen — ik besteedde vijf minuten aan het opnieuw uitleggen van de projectstatus. Nu injecteren de prioriteitssnapshots genoeg context dat Claude binnen één of twee uitwisselingen na compaction de draad oppakt. De continuïteit is niet perfect, maar het is het verschil tussen een reset van vijf minuten en een van dertig seconden.
Foutopsporing over lange sessies: Context Mode's hooks bewaken niet alleen bestandsbewerkingen, maar ook fout/fix-cycli. In een sessie vorige week betrapte Claude zichzelf net op het herintroduceren van een bug die het vijfenveertig minuten eerder had opgelost. Zonder Context Mode zou die fix al lang door compaction uit het geheugen zijn. Met de geïndexeerde fout/fix-geschiedenis verwees Claude naar zijn eigen eerdere correcties. Dat enkele moment bespaarde me waarschijnlijk een uur debuggen.
Tokenverbruikspatronen: Bij kleine bestanden (onder 20 KB) zijn de besparingen bescheiden — 15-25% vermindering. Bij grotere invoer — productielogs, volledige API-responsedumps, bestandsdiffs over meerdere bestanden — is de vermindering dramatisch. Ik heb individuele operaties zien dalen van het verbruiken van 40-50K tokens aan contextruimte naar minder dan 500 bytes. Volgens openbaar beschikbare benchmarks uit de documentatie van Context Mode zijn verminderingen van 95-99% op gestructureerde gegevensinvoer typisch.
De eerlijke samenvatting: Context Mode maakte Claude niet slimmer. Het maakte het geheugen van Claude betrouwbaar. En betrouwbaar geheugen, zo bleek, was het ontbrekende stuk dat alles else beter liet werken. Betere coderingssuggesties omdat Claude de volledige architectuur onthoudt. Betere foutopsporing omdat Claude onthoudt wat het al geprobeerd heeft. Betere planning omdat Claude de beperkingen onthoudt die je een uur geleden noemde.
Als je Claude Code gebruikt voor meer dan snelle eenmalige vragen — als je echte ontwikkelsessies doet, refactoring over meerdere bestanden, debug-workflows, of op agents gebaseerde architecturen — is Context Mode de eerste tool die ik aan je MCP-stack zou toevoegen.
De sessie die me overtuigde dat dit de moeite van het schrijven waard was
Drie weken geleden bouwde ik een multi-agent contentpijplijn. Vier agents, elk met verschillende verantwoordelijkheden, allemaal gecoördineerd via Claude Code. Het soort sessie dat historisch gezien binnen twintig minuten zou zijn ingestort naarmate het contextvenster vulde met inter-agent-communicatielogs.
Twee uur later hield Claude nog steeds de status van alle vier agents bij, herinnerde het welke taken waren gedelegeerd aan welke agent, en signaleerde een afhankelijkheidsconflict tussen het uitvoerformaat van Agent 2 en het verwachte invoerschema van Agent 3. Het signaleerde het conflict door te verwijzen naar een beslissing die ik negentig minuten eerder had genomen over JSON-schemaversioning.
Negentig minuten. In de oude wereld zou die beslissing vijfenveertig minuten geleden door compaction zijn uitgewist.
Ik sloot mijn laptop die avond terwijl ik nadacht over hoeveel uren ik het afgelopen jaar had verloren aan contextverval — projectstructuren opnieuw uitleggen, beperkingen opnieuw benoemen, problemen debuggen die Claude al had opgelost en vergeten. Al dat wrijving, dat stil mijn productiviteit opat elke sessie.
Context Mode bespaarde me niet alleen tokens. Het gaf me de ervaring terug die ik dacht te kopen toen ik voor het eerst AI-codeerhulpmiddelen begon te gebruiken: een partner die het hele gesprek onthoudt.
Dus hier is mijn uitdaging aan jou: als je Claude Code gebruikt met MCP-tools en je sessies langer zijn dan vijftien minuten, installeer Context Mode deze week. Voer het drie sessies uit. Let op wanneer — of dat — Claude dingen begint te vergeten. Ik denk dat je het verschil sneller merkt dan je verwacht.
Veelgestelde vragen
Werkt Context Mode met alle MCP-tools in Claude Code?
Context Mode onderschept uitvoer van elke MCP-tool die gegevens teruggeeft aan het contextvenster van Claude, inclusief Playwright, GitHub, bestandssysteem- en analysetools. Het indexeert de uitvoer ongeacht welke MCP-server deze genereerde. Sommige tools met zeer kleine uitvoer (onder 1 KB) worden doorgegeven zonder compressie, omdat de overhead van indexering groter zou zijn dan de besparingen.
Hoeveel kost het om Context Mode te draaien?
Context Mode draait volledig op je lokale machine zonder externe API-aanroepen of abonnementskosten. De SQLite-database blijft doorgaans onder de 50 MB, zelfs na weken van intensief gebruik. Je tokenbesparingen door verminderd contextverbruik variëren — ik heb 15-25% waargenomen op kleine bestanden en 95-99% op grote gestructureerde gegevens zoals logs en CSV's.
Kan Context Mode ertoe leiden dat Claude belangrijke details in gecomprimeerde gegevens mist?
Dit is de juiste vraag om te stellen. Op trefwoorddoorzoekbare inhoud zoals logs, foutmeldingen en gestructureerde gegevens heb ik in drie maanden gebruik geen nauwkeurigheidsvermindering gezien. Vage conceptuele vragen kunnen relevante records missen omdat FTS5 op trefwoorden is gebaseerd, niet semantisch. Bekijk de architectuursectie hierboven voor een diepere kijk op hoe het drielagige geheugen-systeem hiermee omgaat.
Werkt Context Mode met Cursor, Windsurf of andere AI-codeerhulpmiddelen?
Vanaf maart 2026 ondersteunt Context Mode Claude Code native, plus Gemini CLI en VS Code Copilot via npm-installatie. Cursor- en Windsurf-ondersteuning hangt af van hun MCP-servercompatibiliteit. Raadpleeg de Context Mode-documentatie voor de meest recente integratielijst. Voor de installatiestappen, zie de installatiewalkthrough hierboven.
Wat gebeurt er met mijn geïndexeerde gegevens tussen sessies?
De SQLite-database blijft bestaan tussen sessies, maar Context Mode begint elke nieuwe sessie met een nieuwe contextstate. De geïndexeerde gegevens van vorige sessies blijven doorzoekbaar als je persistentiemodus configureert, maar standaard bouwt elke sessie zijn index vanaf nul op. Dit is een ontwerpkeuze die voorkomt dat verouderde gegevens nieuwe sessies vervuilen.
Laten we samenwerken
Op zoek naar het bouwen van AI-systemen, het automatiseren van workflows, of het schalen van je technologische infrastructuur? Ik help je graag.
- Fiverr (maatwerkontwikkeling & integraties): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (zakelijke oplossingen): ramlit.com
- ColorPark (design & branding): colorpark.io
- xCyberSecurity (beveiligingsdiensten): xcybersecurity.io