Het geheim van het automatiseren van YouTube-b-roll is niet betere AI-beeldgeneratie. Het is de bestandsnaam. Zodra je audio een transcriptie met tijdstempels heeft, is een bestandsnaam als 00-14-32.png geen label meer maar een plaatsingsinstructie, want elke video-editor ter wereld sorteert geïmporteerde bestanden alfabetisch, en alfabetische volgorde op tijdstempels is chronologische volgorde. Dat ene detail laat wat vroeger mijn drie uur durende jacht op b-roll was, krimpen tot ongeveer tien minuten in elkaar zetten, en het is het volledige fundament van de workflow in deze post.
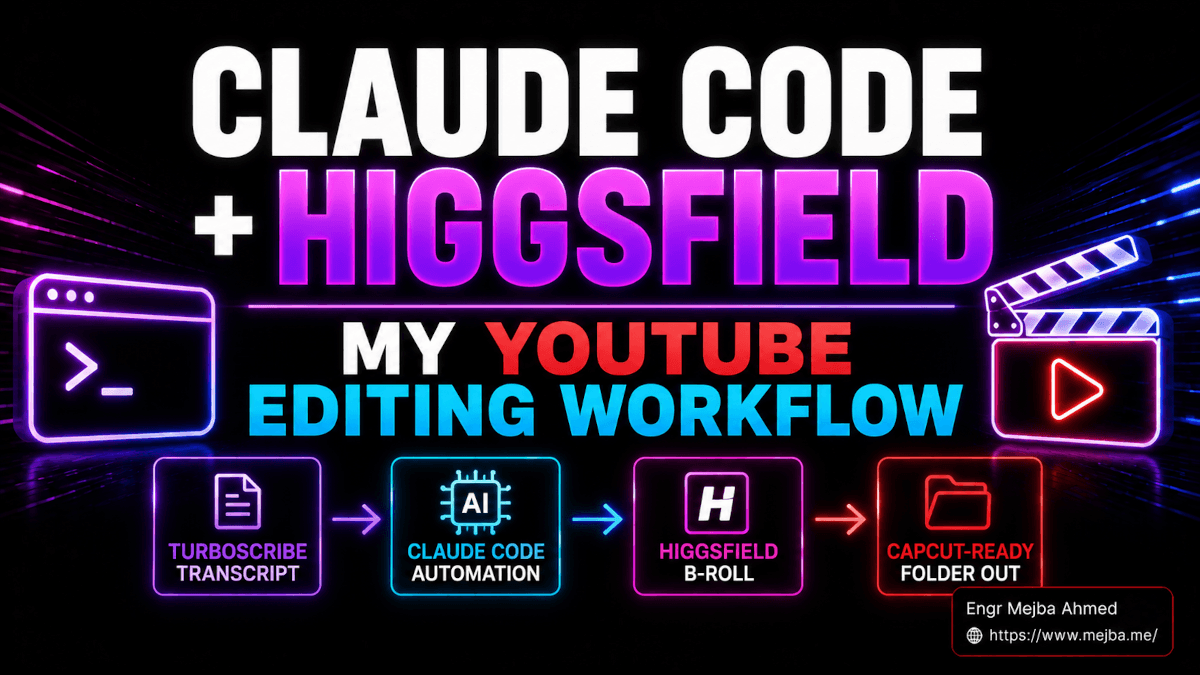
De stack is Claude Code als orchestrator, de Higgsfield-skillbundel voor generatie, TurboScribe voor de transcriptie met tijdstempels en CapCut voor de assemblage. Dit is geen workflow die ik één keer voor content heb geprobeerd: als je vandaag mijn map ~/.claude/skills opvraagt, vind je daar higgsfield-generate, higgsfield-soul-id en higgsfield-product-photoshoot in staan.
Het probleem: b-roll is een zoektaak vermomd als een creatieve
Een eerlijke tijdsaudit van mijn oude montagedag: opnemen, 40 tot 90 minuten. Het gesproken spoor knippen, een uur. Kleur en audio opschonen, nog een uur. B-roll zoeken en plaatsen, drie tot vijf uur. Het was nooit een nek-aan-nekrace. B-roll domineerde omdat het structureel ellendig is: voor elke vijftien seconden praten zoek je in een stockbibliotheek naar een shot dat bij het idee past, je laatste zes video's niet herhaalt en er niet uitziet als de beelden van iedereen. Dat is een retrievalprobleem, en mensen zijn trage retrieval-engines.
Afbeeldingen genereren met AI binnen een editorplugin loste het niet op, want de afbeeldingen kwamen nog steeds los van de transcriptie binnen, en plaatsen bleef handwerk. De oplossing moest generatie koppelen aan tijd. Vandaar de bestandsnaam.
De stack en wie wat doet
Claude Code is het brein. Het houdt de transcriptie in de context, beslist welk visueel concept bij elke tijdstempel past, schrijft de Higgsfield-prompt, roept de skill aan en geeft elk outputbestand zijn tijdstempel als naam. Het is de enige laag die alle vier in één sessie kan, en daarom vervangt geen enkele tool met één doel deze pipeline.
Higgsfield is de beeldengine, aangestuurd via de skillbundel in plaats van een browsertab. De bundel installeer je met de Vercel Labs skills CLI (npx skills add higgsfield-ai/skills -a claude-code -g); let op dat hij installeert in ~/.agents/skills/ en symlinkt vanuit ~/.claude/skills/, wat handig is om te weten op de dag dat iets niet meer triggert. Abonnementen worden maandelijks betaald, met creditpakketten voor drukke weken.
TurboScribe is de transcriptielaag. Je uploadt je daadwerkelijk opgenomen audio, niet je script, en krijgt binnen een paar minuten tijdstempels per zin terug. De gratis tier dekt drie transcripties per dag van elk dertig minuten.
CapCut is de assemblage. Het levert precies één feature: alfabetisch sorteren bij import plus snappen op de golfvorm. Meer heeft deze workflow niet nodig van een editor.
De stap waarin iedereen zijn tijdstempels kwijtraakt
De TurboScribe-fase heeft één valkuil die ik luid wil benoemen, omdat hij ongemerkt de hele pipeline om zeep helpt: exporteer de transcriptie niet als PDF. De PDF-export verwijdert of herformatteert tijdstempels, afhankelijk van de versie, en dan plak je een muur platte tekst in Claude Code zonder plaatsingsdata.
Wat je wilt is de toggle Show Timestamps in de browser: zet hem aan, selecteer alles, kopieer en plak rechtstreeks in Claude Code. Het klembord bewaart de markers [00:14:32], en die markers zijn de hele workflow. Audio, niet het script, is om dezelfde reden de bron: een script heeft een woordvolgorde maar geen echte tijd.
De masterprompt
Hier is mijn huidige basisversie, letterlijk. Plak hem in Claude Code en plak de transcriptie eronder:
You have the Higgsfield image generation skill installed. I am
going to paste a timestamped transcript of a video I recorded.
For every timestamp marker in the transcript, generate ONE 16:9
image that visually represents what I am saying at that moment.

- Style: [STYLE WORD] — apply this consistently across the batch
- Name each file with the transcript timestamp, format
  HH-MM-SS.png (hyphens, not colons — colons break filenames on
  some operating systems)
- Save everything to a folder named broll-output/
- Generate sequentially, do not skip any timestamp

Before starting, tell me how many images you are about to
generate and an estimated Higgsfield credit cost. Wait for my
go-ahead.
De bevestigingsregel is geen beleefdheid, het is kostenbeheersing: een batch van vijftig afbeeldingen is vijftig betaalde generaties, en dat getal wil je zien voordat het gebeurt, niet erna.
Het stijlwoord is de grootste hefboom
Verander één woord in de prompt en dezelfde transcriptie levert een compleet andere visuele identiteit op. Mijn rotatie van vier:
- Standard photo voor tutorials, strak en onopvallend.
- Da Vinci sketch voor video's die om ideeën draaien: verouderd papier, lijnwerk, het gevoel van een denkersnotitieboek.
- Watercolor cinematic voor storytelling en build logs; zacht zonder papperig te worden.
- 3D render voor AI- en infrastructuuronderwerpen: belichting in octane-stijl, de energie van een productonthulling.
De truc die het systeem mogelijk maakt: omdat bestandsnamen uit tijdstempels komen, regenereert het opnieuw draaien van de batch met een nieuw stijlwoord de visuals van de hele video met identieke plaatsing. Dezelfde tijdlijn, een nieuwe identiteit, nul keer opnieuw monteren. Ik gebruik dezelfde skillbundel ook voor heel andere klussen, zoals beelden voor landingspagina's, maar de truc met het wisselen van stijl is uniek voor batches met tijdstempels.
Assemblage: tien minuten in CapCut
Zet je audio op de tijdlijn. Sleep de hele map broll-output/ naar het mediapaneel. CapCut sorteert de bestanden alfabetisch, dus chronologisch; selecteer alles, voeg toe aan de tijdlijn en zet snappen aan zodat de clipranden tegen de golfvorm vallen. Loop de eerste paar overgangen na om een drift van een halve seconde te vangen, leg de talking-head-video met 40 tot 60 procent dekking op een tweede spoor, voeg een subtiele papiertextuur toe als dat jouw look is, en exporteer.
Voor een video van dertig minuten kost die assemblageronde me ongeveer tien minuten. Tegenover de drie tot vijf uur die het vervangt, is dit het getal dat het hele artikel rechtvaardigt.
Reken erop dat je eerste run twee keer zo lang duurt terwijl je het stijlwoord kalibreert en de CapCut-ronde leert; die tol verdwijnt bij video drie. Mijn uitgebreidere aantekeningen over de montagekant staan in de post over de video-editingworkflow.
Wat dit niet vervangt
Smaak. Het model kiest een visual voor elke tijdstempel; of het de juiste visual is, blijft jouw beslissing, dus reken erop dat je in elke batch een handvol afbeeldingen afkeurt en opnieuw genereert. De workflow doet ook niets voor je verhaalstructuur, je montageritme of je hook, en hij hoort niet aan talking-head-segmenten te komen waar jouw daadwerkelijke aanwezigheid de content is; die helft van het productieprobleem is een andere pipeline, mijn HeyGen- en ElevenLabs-systeem. Wat deze stack weghaalt, is het mechanische zoek-en-plaatswerk. Wat hij teruggeeft, is de aandacht die je al die tijd aan de creatieve beslissingen had moeten besteden.
De discipline die het laat beklijven is één enkele gewoonte: elke clip krijgt zijn tijdstempel als naam op het moment dat hij bestaat. Houd je dat vol, dan zet de map zichzelf in elkaar; laat je het los, dan heb je een rommella.
De masterprompt hierboven is precies het soort patroon dat ik verzamel: prompts die zijn ontworpen om opnieuw te draaien, niet om te bewonderen. Mijn promptbibliotheek heeft er nog 854 zoals deze, gratis, geordend per taak, inclusief de sets voor video- en beeldgeneratie waaruit deze workflow is gegroeid. Begin met de b-rollprompt en ga dan de rest stelen.