J'étais en pleine configuration d'une énième clé API cloud — la quatrième ce mois-ci — quand une notification est apparue sur le Discord d'OpenClaw. Ollama était maintenant un fournisseur officiel. Pas un hack communautaire. Pas un contournement impliquant trois fichiers de configuration et une prière. Une intégration officielle de premier plan soutenue par une seule commande de configuration.
J'ai tout lâché et l'ai exécutée immédiatement.
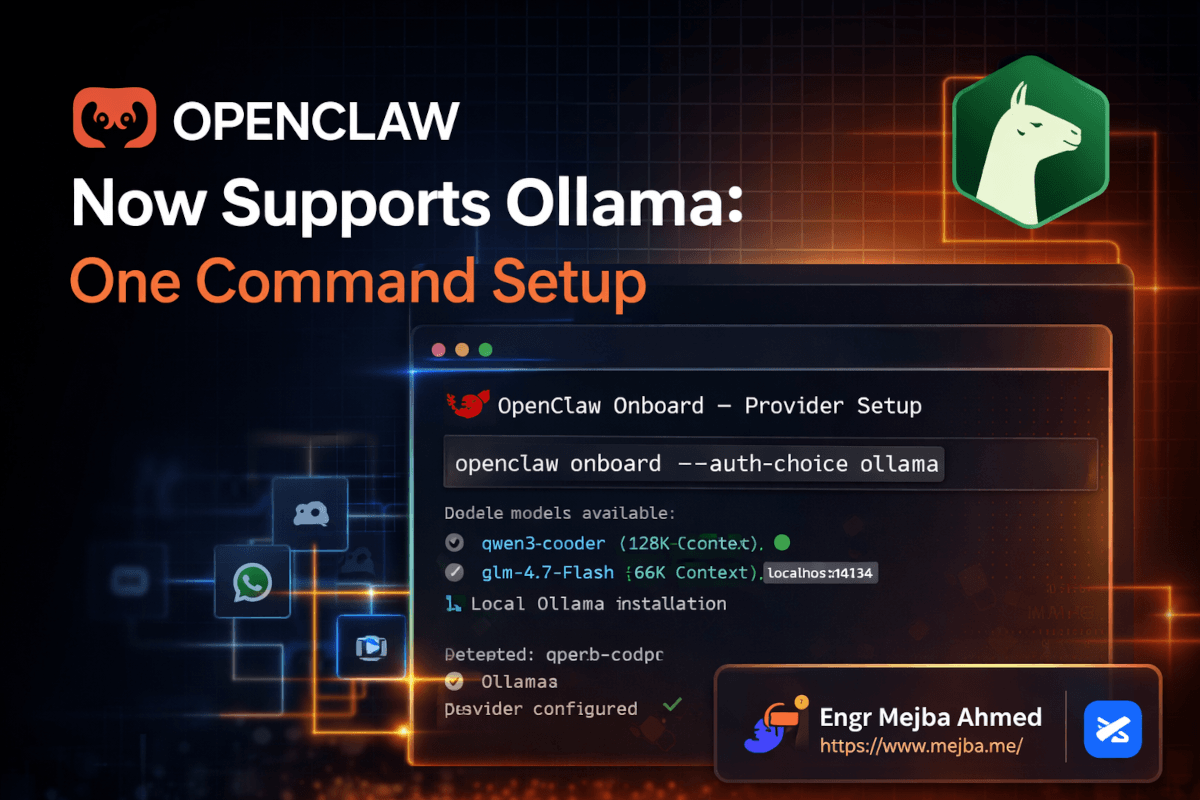
openclaw onboard --auth-choice ollama
C'est tout. Mes modèles Ollama locaux — ceux que j'utilisais pour la génération de code, l'aide à la rédaction et l'analyse de données — étaient soudainement disponibles à travers toutes les apps de messagerie que j'utilise. WhatsApp. Telegram. Discord. Pas de clés API. Pas de factures cloud. Pas de pics de latence à 14h quand la moitié de la planète décide de solliciter le même endpoint d'inférence.
Ce qui s'est passé durant la semaine suivante a fondamentalement changé ma façon de penser les assistants personnels IA. Et honnêtement, ça m'a fait me demander pourquoi je payais pour de l'inférence cloud depuis tout ce temps.
Pourquoi cette annonce compte plus que vous ne le pensez
Voici du contexte qui rend cette intégration Ollama significative au-delà de l'évidente réaction "cool, un autre fournisseur".
OpenClaw — l'assistant personnel IA open source créé par Peter Steinberger (@steipete) — a explosé en popularité depuis fin janvier 2026. Le projet a atteint 247 000 étoiles GitHub début mars. Ce n'est pas juste un chatbot dans votre terminal. OpenClaw est un système agentique complet qui tourne localement sur votre machine et se connecte à vos apps de messagerie. Il lit les e-mails, gère les calendriers, fait le check-in sur les vols, navigue sur le web, écrit et exécute du code — le tout déclenché depuis un simple message de chat.
Le problème, jusqu'à présent, c'était l'épine dorsale IA. Vous aviez besoin d'un fournisseur LLM cloud. Claude, GPT, DeepSeek — toutes des options solides, mais toutes nécessitant des clés API, un suivi d'utilisation et des factures mensuelles qui augmentent en fonction de votre utilisation réelle de l'assistant. Pour des développeurs comme moi qui utilisent des agents IA des dizaines de fois par jour, ces coûts s'accumulent vite.
Ollama change complètement cette équation. Exécutez vos modèles localement, ne payez rien pour l'inférence et gardez chaque conversation sur votre propre matériel. Les implications en matière de confidentialité méritent à elles seules qu'on s'y intéresse — mais les économies et l'exécution locale sans latence ? C'est ce qui m'a suffisamment enthousiasmé pour tester ça dans l'heure qui a suivi le lancement.
Mais avant de vous guider à travers la configuration et ce que j'ai appris en utilisant ceci pendant une semaine, il y a un aspect de cette histoire que la plupart des gens manquent — et ça concerne quels modèles fonctionnent réellement bien comme cerveau d'OpenClaw.
L'histoire des origines que vous devriez connaître
Si vous avez suivi la saga OpenClaw, vous savez que le nom a eu tout un parcours. Peter Steinberger l'a initialement lancé sous le nom de Clawdbot en novembre 2025. Le projet est devenu viral fin janvier 2026 — en partie parce que le concept de faire tourner un agent personnel IA depuis WhatsApp était véritablement novateur, et en partie parce que @steipete a le don de construire des choses que les développeurs veulent immédiatement utiliser.
Puis est venue la situation de marque déposée avec Anthropic, un rapide changement de nom vers Moltbot (qui, soyons honnêtes, n'était pas très facile à prononcer), et finalement l'atterrissage sur OpenClaw. Le branding du homard a survécu à tout ça. Si vous avez vu l'iconique emoji homard partout dans les cercles de développeurs IA dernièrement, vous savez maintenant d'où ça vient.
Le nom "OpenClaw" et la métaphore de la mue capturent en fait ce qui rend ce projet spécial. Les homards muent pour grandir. OpenClaw ne cesse de se débarrasser de ses limitations — d'abord le modèle en code fermé, puis la dépendance à un seul fournisseur, et maintenant l'exigence d'APIs cloud entièrement.
Je veux spécifiquement saluer @steipete ici. Pas seulement pour avoir construit OpenClaw en premier lieu, mais pour la façon dont le projet a été guidé à travers sa phase de croissance explosive. L'intégration Ollama ne s'est pas faite en isolation — elle a été revue, testée et affinée avec de vrais retours de la communauté. Et honnêtement, avoir quelqu'un avec le parcours en ingénierie de Steinberger (il a construit PSPDFKit, l'un des SDKs PDF les plus respectés dans le développement mobile) à la tête des décisions d'architecture me donne confiance que ce n'est pas juste un bricolage collé sur le côté. L'intégration est solide parce que le processus de revue a été rigoureux.
Un remerciement spécial à @steipete pour son aide et sa revue de l'intégration du fournisseur Ollama. La communauté IA open source se porte mieux quand des ingénieurs expérimentés investissent leur temps pour bien poser les fondations.
Alors, à quoi ressemble la configuration concrète ? C'est presque anticlimactiquement simple.
Comment configurer OpenClaw avec Ollama en moins de cinq minutes
Je vais vous guider à travers exactement ce que j'ai fait, y compris les petits pièges que j'ai rencontrés, pour que vous puissiez les éviter.
Étape 1 : Assurez-vous qu'Ollama tourne
Ça semble évident, mais j'ai vu des gens trébucher dessus. Vous avez besoin d'Ollama installé et en cours d'exécution avec au moins un modèle téléchargé.
# Check Ollama is running
ollama list

# If you don't have a model yet, grab one
# OpenClaw recommends models with 64K+ context windows
ollama pull qwen3-coder
L'exigence de fenêtre de contexte est ce que la plupart des guides passent sous silence. OpenClaw a besoin d'au moins 64 000 tokens de contexte pour gérer de manière fiable les tâches agentiques multi-étapes — le genre où il lit un fil d'e-mails, rédige une réponse, vérifie votre calendrier pour les conflits, puis envoie la réponse. Les modèles à contexte court fonctionneront pour des requêtes simples mais échoueront sur tout ce qui nécessite un raisonnement soutenu à travers de multiples appels d'outils.
Mes modèles recommandés pour OpenClaw en mars 2026 :
| Modèle | Contexte | Idéal pour |
|---|---|---|
| qwen3-coder | 128K | Génération de code, tâches techniques |
| glm-4.7 | 128K | Travail d'assistant polyvalent |
| glm-4.7-flash | 64K | Réponses plus rapides, tâches légères |
| gpt-oss:20b | 128K | Bon équilibre entre vitesse et capacité |
| kimi-k2.5 | 128K | Raisonnement solide, tâches multi-étapes |
J'utilise qwen3-coder pour la plupart des tâches et je bascule vers glm-4.7-flash quand j'ai juste besoin de réponses rapides. La beauté des modèles locaux, c'est que changer ne coûte rien — pas de clé API différente, pas de niveau de facturation différent. Changez simplement le nom du modèle.
Étape 2 : Exécutez la commande de configuration
C'est là que la magie opère :
openclaw onboard --auth-choice ollama
L'assistant fait plusieurs choses automatiquement :
- Détecte votre installation Ollama — il vérifie l'adresse par défaut (généralement
http://localhost:11434) et confirme la connexion - Liste vos modèles disponibles — chaque modèle que vous avez téléchargé apparaît pour la sélection
- Définit votre modèle par défaut — si vous n'avez qu'un seul modèle, il le sélectionne automatiquement. Sinon, vous choisissez.
- Configure le fournisseur — écrit la configuration nécessaire pour qu'OpenClaw sache router toutes les requêtes d'inférence vers votre instance Ollama locale
- Installe le daemon gateway — le processus en arrière-plan qui relie vos apps de messagerie à l'agent OpenClaw
L'ensemble du processus m'a pris environ 90 secondes. Pas de fichiers JSON à éditer manuellement. Pas de variables d'environnement à exporter. Pas de conteneurs Docker à orchestrer. Répondez aux questions et c'est fait.
🦞 OpenClaw Onboard — Provider Setup
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
Detected Ollama at localhost:11434 ✓
Available models:
  → qwen3-coder (128K context) ✓ recommended
  → glm-4.7-flash (64K context) ✓ compatible
  → llama3.3 (8K context) ⚠ low context

Selected: qwen3-coder
Gateway daemon installed ✓
Provider configured ✓

Your lobster is ready. 🦞
Cette dernière ligne m'a fait sourire. La personnalité de l'équipe OpenClaw transparaît même dans la sortie CLI.
Étape 3 : Connectez vos apps de messagerie
C'est la partie où OpenClaw devient véritablement différent de faire tourner Ollama seul. Ollama en lui-même est un serveur d'inférence local — puissant, mais vous interagissez avec lui via un terminal ou un appel API. OpenClaw le transforme en assistant qui vit dans les apps que vous avez déjà ouvertes toute la journée.
# Connect WhatsApp (uses QR code pairing)
openclaw connect whatsapp

# Connect Telegram
openclaw connect telegram --token YOUR_BOT_TOKEN

# Connect Discord
openclaw connect discord --token YOUR_BOT_TOKEN
J'ai connecté WhatsApp en premier parce que c'est là que je passe le plus de temps en messagerie. L'appairage par code QR a pris environ 10 secondes. Après ça, je pouvais envoyer un message à mon bot OpenClaw depuis WhatsApp et recevoir des réponses alimentées entièrement par mon modèle local qwen3-coder.
Aucune donnée ne quittant ma machine. Aucun coût d'API. La réponse venait du GPU à un mètre de moi.
Étape 4 : Testez avec une vraie tâche
Ne vous contentez pas de dire "bonjour" et de considérer que c'est fait. Donnez-lui quelque chose qui sollicite les capacités agentiques :
Me: Check my calendar for tomorrow and draft a summary
    of what I have scheduled. If there are any conflicts,
    flag them.

OpenClaw 🦞: Looking at your calendar for March 17...

You have 4 events tomorrow:
- 9:00 AM - Standup (30 min)
- 10:30 AM - Client call with Ramlit team (1 hr)
- 11:00 AM - Code review session (1 hr) ⚠️ CONFLICT
- 2:00 PM - Deploy planning (45 min)

⚠️ Conflict detected: "Client call" (10:30-11:30)
overlaps with "Code review" (11:00-12:00) by 30 minutes.

Suggestion: Move code review to 1:00 PM? That gives you
a 1-hour buffer before deploy planning. Want me to
reschedule it?
Toute cette interaction — accès au calendrier, détection de conflits, génération de suggestions — a tourné sur mon modèle Ollama local. La réponse est arrivée en environ 4 secondes. Avec une API cloud, j'aurais la latence réseau en plus du temps d'inférence, plus le fait de payer pour le privilège.
Ce qui m'a le plus surpris : la différence de qualité entre faire tourner qwen3-coder localement via OpenClaw et utiliser un modèle cloud était plus petite que ce à quoi je m'attendais. Pour les tâches d'assistant routinières — rédaction d'e-mails, gestion de calendrier, questions rapides de code, organisation de fichiers — le modèle local s'en est sorti parfaitement. Je n'ai remarqué l'écart qu'en faisant des chaînes de raisonnement complexes multi-étapes nécessitant de maintenir de grandes quantités de contexte simultanément.
Si vous préférez que quelqu'un construise ce type de configuration d'assistant personnel IA de A à Z, adapté à votre workflow, j'accepte des missions de personnalisation en automatisation IA. Vous pouvez voir ce que j'ai construit sur fiverr.com/s/EgxYmWD.
Que se passe-t-il quand tous vos modèles Ollama fonctionnent avec OpenClaw ?
C'est la partie que je n'ai pas pleinement appréciée avant d'avoir utilisé la configuration pendant quelques jours. Quand Ollama est votre fournisseur OpenClaw, vous n'obtenez pas accès à un seul modèle. Vous obtenez accès à chaque modèle que vous avez téléchargé. Et vous pouvez basculer entre eux à la volée.
Me: /model glm-4.7-flash
OpenClaw 🦞: Switched to glm-4.7-flash ✓

Me: Quick — what's the CORS header syntax for allowing
    specific origins?

OpenClaw 🦞: Access-Control-Allow-Origin: https://yourdomain.com

For multiple origins, you'll need server-side logic —
the header only accepts one origin or *. In Express:

app.use(cors({
  origin: ['https://a.com', 'https://b.com']
}));
La réponse de glm-4.7-flash est arrivée en moins d'une seconde. Pour les recherches rapides et les rappels de syntaxe, le modèle plus petit est parfait. Je n'ai pas besoin d'un modèle de 120 milliards de paramètres pour me rappeler un en-tête CORS.
Mais pour les tâches en profondeur — déboguer une condition de course complexe, analyser une base de code ou rédiger un document technique détaillé — je bascule vers qwen3-coder et le laisse prendre son temps. La capacité d'adapter la puissance du modèle à la complexité de la tâche est quelque chose qu'on ne peut tout simplement pas faire aussi fluidement avec les fournisseurs cloud. Avec Ollama, le coût du changement est littéralement zéro.
Le schéma de routage de modèles que j'ai adopté
Après une semaine d'expérimentation, voici comment j'utilise les différents modèles :
Questions rapides et recherches — glm-4.7-flash. Rapide, économique (gratuit), précis pour le contenu factuel. Je l'utilise pour probablement 60% de mes interactions quotidiennes.
Génération et revue de code — qwen3-coder. Meilleur pour maintenir le contexte à travers de longs fichiers de code, comprend les patterns spécifiques aux frameworks et génère du code plus prêt pour la production.
Rédaction longue et analyse — glm-4.7 ou kimi-k2.5. Quand j'ai besoin que le modèle maintienne beaucoup de contexte et produise des résultats nuancés, ce sont mes choix privilégiés.
Demandes expérimentales et inhabituelles — n'importe quel nouveau modèle que j'ai téléchargé cette semaine-là. L'un des plaisirs d'Ollama est de tester les nouveaux modèles dès leur sortie. La semaine dernière j'ai testé gpt-oss:20b pour la première fois et j'ai été impressionné par son raisonnement sur les tâches à forte composante mathématique.
Le point essentiel : OpenClaw se moque de quel modèle vous faites tourner. L'intégration traite Ollama comme un fournisseur unifié. Vos apps de messagerie ne savent pas et ne se soucient pas de savoir si la réponse vient d'un modèle de 7 milliards ou de 120 milliards de paramètres. Cette couche d'abstraction est propre, et c'est l'une des raisons pour lesquelles cette intégration a l'air d'une fonctionnalité de premier plan plutôt que d'un ajout bricolé après coup.
Faire tourner OpenClaw localement : ce que personne ne vous prévient
Je vous rendrais un mauvais service si je faisais passer ça pour de la pure magie sans compromis. J'ai rencontré des limitations réelles durant ma semaine de tests, et vous devriez les connaître avant de miser entièrement sur l'inférence locale.
La mémoire GPU est votre goulot d'étranglement
Les modèles plus gros — gpt-oss:120b, kimi-k2.5, tout ce qui dépasse 30 milliards de paramètres — nécessitent beaucoup de VRAM. Je fais tourner une machine avec un GPU capable, et j'ai quand même dû être réfléchi sur quel modèle garder chargé. Ollama peut décharger vers le CPU, mais la différence de vitesse est brutale. Une requête qui prend 3 secondes sur GPU prend 40 secondes sur CPU pour un gros modèle.
Mon conseil : Commencez avec un modèle qui tient confortablement dans la mémoire de votre GPU. qwen3-coder à sa quantification par défaut tourne parfaitement avec 16 Go de VRAM. Ne cherchez pas le plus gros modèle parce qu'il semble impressionnant — cherchez celui qui répond assez vite pour ne pas casser votre flux.
La fenêtre de contexte n'est pas qu'un chiffre
La documentation d'OpenClaw dit 64K de contexte minimum, et c'est sérieux. J'ai essayé de faire tourner un modèle à 32K de contexte et j'ai eu des problèmes dès la troisième tâche multi-étapes. L'agent a perdu le fil de l'historique de conversation en pleine tâche et a commencé à répéter des actions qu'il avait déjà complétées. Passer à un modèle 64K+ a résolu le problème instantanément.
C'est logique quand on pense à ce qu'OpenClaw fait. Il ne se contente pas d'avoir une conversation — il maintient l'historique des appels d'outils, les résultats de fonctions, les prompts système et tout votre fil de messages. Cette surcharge consomme du contexte rapidement. Un modèle avec 8K de contexte peut répondre à une seule question correctement, mais s'effondre dès qu'OpenClaw a besoin d'enchaîner trois ou quatre actions.
La première réponse est lente (ensuite c'est rapide)
Ollama charge les modèles en mémoire au premier usage. Si le modèle n'est pas chargé quand vous envoyez votre premier message de la journée, attendez-vous à un délai de 10-30 secondes pendant le chargement. Après ça, les réponses sont rapides — souvent plus rapides que les APIs cloud parce que vous avez éliminé les allers-retours réseau entièrement.
J'ai résolu le problème de démarrage à froid en ajoutant un simple cron job qui envoie une requête fictive à Ollama chaque matin à 8h :
# Add to crontab: keep model warm
0 8 * * * curl -s http://localhost:11434/api/generate \
  -d '{"model":"qwen3-coder","prompt":"ping","stream":false}' \
  > /dev/null 2>&1
Petit hack, grosse amélioration du confort d'utilisation.
Toutes les tâches n'appartiennent pas à un modèle local
Je vais être honnête à ce sujet : pour les workflows agentiques complexes multi-étapes qui nécessitent un raisonnement solide sur des contextes très longs — pensez "analyse toute cette base de code et génère un plan de migration" — les modèles cloud comme Claude ont encore l'avantage. L'écart se réduit chaque mois à mesure que les modèles open source s'améliorent, mais il existe aujourd'hui.
Mon approche est pragmatique. J'utilise les modèles Ollama locaux via OpenClaw pour 80% de mes tâches quotidiennes — les choses routinières qui se produisent des dizaines de fois par jour. Pour les 20% restants qui demandent un raisonnement de pointe, je garde un fournisseur cloud configuré en secours. OpenClaw supporte plusieurs fournisseurs simultanément, donc le basculement est fluide.
Les économies réalisées en déplaçant 80% des requêtes vers l'inférence locale ont été significatives. Ma facture mensuelle d'API cloud est passée d'environ 45 $/mois à moins de 10 $.
Au-delà du chat : les tâches qui m'ont surpris
Je m'attendais à ce qu'OpenClaw + Ollama gère bien le chat. Ce à quoi je ne m'attendais pas, c'est à quel point il serait capable sur des tâches que je n'avais jamais pris la peine d'essayer avec un modèle local auparavant.
Tri des e-mails depuis WhatsApp
Chaque matin, j'envoie un message à mon bot OpenClaw :
Me: Morning brief — check email, flag anything urgent,
    summarize the rest
Deux minutes plus tard (l'analyse des e-mails prend un moment), je reçois un résumé priorisé. Les éléments urgents en tête avec les actions recommandées. Les non-urgents groupés par catégorie. Le spam des newsletters identifié et prêt pour l'archivage. Le tout traité par qwen3-coder posé sur mon bureau.
Le fait que ça se passe depuis WhatsApp — la même app que je consulte de toute façon — fait que je l'utilise vraiment tous les jours. Quand ça nécessitait d'ouvrir un terminal séparé et de lancer un script Python, je sautais cette étape la moitié du temps.
Demandes de revue de code via Telegram
J'ai connecté OpenClaw au groupe Telegram que j'utilise pour la collaboration sur des projets perso. Maintenant je peux coller un extrait de code ou un lien de PR et obtenir un retour instantané :
Me: Review this function — anything wrong?

[pastes function]

OpenClaw 🦞: Two issues:

1. Line 12: You're not awaiting the async call inside
   the loop. This will fire all requests simultaneously
   instead of sequentially. If the API has rate limits,
   you'll hit them.

2. Line 23: The error catch swallows the exception
   silently. At minimum, log it. Better: propagate it
   with context about which iteration failed.

Want me to rewrite it with both fixes?
Cette revue venait d'un modèle local. Aucun code n'a quitté ma machine. Pour quelqu'un travaillant sur des projets clients avec des NDAs, l'aspect confidentialité n'est pas un bonus — c'est une exigence.
Gestion et organisation de fichiers
Celle-ci m'a pris par surprise. J'ai demandé à OpenClaw de m'aider à organiser un dossier de téléchargements en désordre :
Me: Organize my ~/Downloads folder — group files by type,
    move anything older than 30 days to archive, and list
    what you did

OpenClaw 🦞: Done. Here's what I moved:

📁 Documents (14 files) → ~/Downloads/docs/
📁 Images (43 files) → ~/Downloads/images/
📁 Code (8 files) → ~/Downloads/code/
📁 Archives (6 files) → ~/Downloads/archives/
📁 Misc (3 files) → ~/Downloads/other/

Archived (>30 days): 23 files → ~/Archive/2026-02/

Total: 97 files organized. 23 archived.
Exécuter ça via une API cloud signifierait envoyer mon listing de fichiers sur le serveur de quelqu'un d'autre. Avec Ollama en local, le répertoire ne quitte jamais ma machine.
Comment OpenClaw + Ollama se compare aux configurations cloud uniquement ?
J'ai fait tourner les deux configurations côte à côte pendant cinq jours. Voici ce que j'ai trouvé — pas de benchmarks fabriqués, juste mon expérience honnête à travers une utilisation quotidienne réelle.
Vitesse de réponse pour les tâches simples : Ollama local était systématiquement plus rapide. Pas de latence réseau signifie des réponses en moins d'une seconde pour les requêtes rapides. Les fournisseurs cloud ajoutaient typiquement 1-3 secondes de surcharge même pour des réponses simples.
Qualité de réponse pour le raisonnement complexe : Les modèles cloud (particulièrement Claude) géraient encore le raisonnement multi-étapes de manière plus fiable. Quand j'ai demandé à OpenClaw de planifier un workflow de déploiement complexe impliquant huit étapes séquentielles avec des branchements conditionnels, le modèle cloud l'a parfaitement réussi. Le modèle local a obtenu environ 80% de bonnes réponses et a nécessité une correction.
Coût sur cinq jours : La configuration cloud uniquement m'a coûté approximativement 8 $ en appels API. La configuration Ollama a coûté 0 $. Ma facture d'électricité n'a pas changé notablement — le GPU tournait déjà pour d'autres tâches.
Confidentialité : Pas de compétition. Le local gagne de manière absolue. Chaque requête, chaque référence de fichier, chaque extrait d'e-mail est resté sur mon matériel.
Fiabilité : Le cloud dépend de la connectivité internet et de la disponibilité du fournisseur. Durant une brève coupure internet le troisième jour, ma configuration locale OpenClaw a continué à fonctionner sans broncher. La configuration cloud était complètement morte.
L'approche hybride — Ollama pour les tâches quotidiennes, cloud pour le raisonnement complexe — m'a donné le meilleur des deux mondes. Et OpenClaw rend le basculement trivialement facile.
Configuration de l'approche hybride : local + secours cloud
Si le modèle hybride vous séduit, voici comment je l'ai configuré :
# Primary: Ollama (local, free, private)
openclaw onboard --auth-choice ollama

# Secondary: Cloud provider as fallback
openclaw provider add --name claude --type anthropic \
  --api-key $ANTHROPIC_API_KEY

# Set routing rules
openclaw config set routing.default ollama
openclaw config set routing.complex claude
Avec cette configuration, OpenClaw route la plupart des requêtes vers Ollama par défaut. Quand je demande explicitement le modèle cloud (en utilisant /model claude dans le chat) ou quand une tâche dépasse un seuil de complexité, il route vers le fournisseur cloud.
La configuration me donne une facture IA mensuelle en dessous de 10 $ tout en gardant accès aux modèles de pointe quand j'en ai véritablement besoin. Avant ça, je dépensais 40-50 $/mois. Sur un an, c'est presque 500 $ d'économies — et mon expérience quotidienne avec l'assistant est en fait meilleure parce que l'inférence locale est plus rapide pour les tâches routinières.
Ce que ça signifie pour l'avenir de l'IA personnelle
Je veux prendre du recul un instant parce que cette intégration Ollama représente quelque chose de plus grand qu'une simple annonce de fonctionnalité.
Quand OpenClaw a été lancé, l'hypothèse était que les assistants personnels IA avaient besoin de LLMs cloud. Le paysage des modèles locaux fin 2025 n'était tout simplement pas assez bon pour un travail agentique fiable. Les modèles ne pouvaient pas maintenir assez de contexte. Ils n'étaient pas assez rapides. Ils faisaient trop d'erreurs sur les tâches multi-étapes.
Ça a changé rapidement. Début 2026, des modèles comme qwen3-coder et glm-4.7 sont devenus suffisamment capables pour gérer de vraies charges de travail d'assistant. Ollama a rendu leur exécution locale extrêmement simple. Et maintenant OpenClaw a fait de leur connexion à votre workflow quotidien une seule commande.
La trajectoire est claire : l'IA personnelle va vers le local d'abord. Le cloud devient l'exception pour les tâches de pointe, pas le choix par défaut pour tout. Et la stack OpenClaw + Ollama est la façon la plus accessible de faire cette transition dès maintenant.
@steipete a pris la décision tôt de garder OpenClaw agnostique vis-à-vis du modèle. Pas de dépendance à un fournisseur. Pas de traitement préférentiel pour le cloud par rapport au local. Cette décision architecturale porte ses fruits maintenant. Quand Ollama est devenu viable comme fournisseur sérieux, l'intégration a été propre parce que la couche d'abstraction était déjà en place. Les bonnes décisions d'ingénierie se composent avec le temps — et c'est un exemple typique.
Le défi d'une heure : essayez aujourd'hui
Je ne veux pas que ce soit un article de plus que vous lisez, acquiescez et oubliez ensuite. Alors voici un défi concret.
Mettez un minuteur d'une heure. Pendant cette heure :
- Installez Ollama si ce n'est pas déjà fait (5 minutes)
- Téléchargez qwen3-coder —
ollama pull qwen3-coder(dépend de votre vitesse internet, mais le téléchargement se fait en arrière-plan) - Installez OpenClaw depuis le dépôt GitHub (10 minutes compilation incluse)
- Lancez la commande de configuration —
openclaw onboard --auth-choice ollama(2 minutes) - Connectez une app de messagerie — celle que vous utilisez le plus (5 minutes)
- Donnez-lui trois vraies tâches — pas "bonjour," pas des exemples jouets. Demandez-lui de faire quelque chose pour lequel vous ouvreriez normalement un navigateur ou un terminal.
Si votre expérience ressemble à la mienne, vous serez accroché dès la deuxième tâche. Il y a quelque chose de véritablement plaisant à envoyer un message WhatsApp et recevoir en retour une réponse utile alimentée entièrement par du matériel que vous possédez.
Le homard est arrivé sur votre machine locale. Et il est prêt à travailler.
Foire aux questions
Est-ce qu'OpenClaw fonctionne avec tous les modèles Ollama ?
Oui — chaque modèle disponible dans votre installation Ollama locale fonctionne avec OpenClaw après avoir exécuté openclaw onboard --auth-choice ollama. L'assistant de configuration détecte automatiquement tous les modèles téléchargés. Pour des tâches agentiques fiables multi-étapes, choisissez des modèles avec des fenêtres de contexte d'au moins 64K. Pour la liste complète des modèles recommandés, consultez la section de configuration ci-dessus.
De combien de VRAM ai-je besoin pour faire tourner OpenClaw avec Ollama ?
Prévoyez un minimum de 8-16 Go de VRAM. Des modèles comme qwen3-coder tournent confortablement avec 16 Go de VRAM à la quantification par défaut. Des modèles plus petits comme glm-4.7-flash fonctionnent avec 8 Go. Vous pouvez décharger vers le CPU, mais les temps de réponse augmentent significativement — de 3 secondes à plus de 30 secondes pour les modèles plus gros.
Puis-je utiliser OpenClaw avec Ollama et un fournisseur cloud ?
Absolument. OpenClaw supporte plusieurs fournisseurs simultanément. Configurez Ollama comme votre choix par défaut pour les tâches quotidiennes et ajoutez un fournisseur cloud (Claude, GPT, DeepSeek) en secours pour le raisonnement complexe. Consultez le guide de configuration hybride ci-dessus pour les commandes exactes.
Mes données sont-elles privées quand j'utilise OpenClaw avec Ollama ?
Totalement. Avec Ollama comme fournisseur, toute l'inférence tourne sur votre machine locale. Aucune requête, aucun contenu de fichier ni donnée de conversation ne quitte votre matériel. Cela rend la configuration idéale pour les développeurs travaillant sous NDAs ou manipulant des données clients sensibles.
Quelles apps de messagerie OpenClaw supporte-t-il ?
OpenClaw se connecte à WhatsApp, Telegram, Discord, Signal, Slack et iMessage. Chaque app a sa propre commande de connexion — openclaw connect [app] — et la configuration prend typiquement moins de cinq minutes par plateforme.
Let's Work Together
Looking to build AI systems, automate workflows, or scale your tech infrastructure? I'd love to help.
- Fiverr (custom builds & integrations): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (enterprise solutions): ramlit.com
- ColorPark (design & branding): colorpark.io
- xCyberSecurity (security services): xcybersecurity.io