Eu estava no meio de um prompt em um projeto Claude Code — refatorando uma pipeline de agentes que continuava alucinando chamadas de ferramentas — quando o Google lançou algo que eu não esperava. Não mais uma atualização incremental do Gemini. Não um artigo de pesquisa que ninguém fora do DeepMind leria. Quatro modelos de pesos abertos, construídos sobre a mesma pesquisa por trás do Gemini 3, lançados sob Apache 2.0 em 2 de abril de 2026.
A afirmação que me chamou atenção? Um modelo de 26 bilhões de parâmetros que ativa apenas 3,8 bilhões de parâmetros durante a inferência e supostamente roda a aproximadamente 300 tokens por segundo em um Mac Studio M2 Ultra. Um modelo tão pequeno, tão rápido, classificado em sexto lugar entre todos os modelos abertos no leaderboard do Arena AI.
Já me decepcionei com os esforços de IA de código aberto do Google antes. Gemma 1 foi decepcionante. Gemma 2 foi decente mas esquecível. Gemma 3 mostrou melhoria genuína mas ainda não conseguia competir com o que Qwen e Meta estavam entregando. Então, quando o Google afirmou que o Gemma 4 representa "a maior melhoria em uma única geração vista no espaço de modelos abertos", meu ceticismo estava totalmente ativado.
Mas então comecei a testar. E dentro da primeira hora, percebi que este lançamento é diferente de maneiras que importam — não apenas para leaderboards de benchmarks, mas para qualquer pessoa que rode IA localmente ou construa fluxos de trabalho agênticos que precisam ser rápidos, baratos e realmente confiáveis.
Aqui está tudo que encontrei ao longo de vários dias de testes práticos com todos os quatro modelos. As partes boas são genuinamente impressionantes. As lacunas valem a pena conhecer antes de se comprometer.
O Que o Google Realmente Entregou — E Por Que a Arquitetura Importa
Gemma 4 não é um modelo. São quatro modelos abrangendo uma faixa que vai de rodar no seu celular até competir com modelos frontier hospedados na nuvem. Entender a linha de produtos importa porque escolher o tamanho errado para seu caso de uso desperdiça dinheiro ou capacidade.
| Modelo | Parâmetros | Ativos na Inferência | Janela de Contexto | Hardware Alvo |
|---|---|---|---|---|
| E2B (Efetivo 2B) | 2B | 2B | 128K tokens | Smartphones, Raspberry Pi |
| E4B (Efetivo 4B) | 4B | 4B | 128K tokens | Tablets, dispositivos edge |
| 26B MoE | 26B total | ~3,8B | 256K tokens | Laptops, Mac Mini/Studio |
| 31B Dense | 31B | 31B | 256K tokens | Desktop, cloud, GPU de ponta |
A história arquitetural aqui é a abordagem Mixture of Experts (MoE) no modelo de 26B. Já escrevi sobre MoE ao cobrir o GLM5 — a ideia básica é que o modelo contém muitas redes "especialistas" especializadas, mas ativa apenas um subconjunto pequeno para qualquer entrada dada. Pense nisso como ter um prédio cheio de especialistas em vez de um generalista sobrecarregado.
O que torna a implementação do Gemma 4 26B interessante é a proporção. Ativar 3,8 bilhões de parâmetros de um total de 26 bilhões significa que aproximadamente 85% do modelo está dormindo a qualquer momento. Isso é agressivo. Para comparação, o GLM5 ativa cerca de 44 bilhões de 745 bilhões — um modelo muito maior, mas uma abordagem filosófica semelhante para eficiência.
O resultado prático? Um modelo que cabe em hardware de consumo enquanto pontua bem acima de sua classe de peso em parâmetros. A janela de contexto de 256K tokens nos modelos maiores significa que você pode alimentar codebases inteiros, documentos longos ou projetos multi-arquivo sem fragmentar. E todos os quatro modelos suportam nativamente mais de 140 idiomas — o que, se você está construindo algo para uma audiência global, elimina toda uma categoria de dores de cabeça.
Cada modelo na linha suporta raciocínio multi-etapa, saídas JSON estruturadas, uso de ferramentas e programação. Esses não são recursos adicionados após o treinamento. O Google treinou essas capacidades nativamente, o que — com base nos meus testes — faz uma diferença real em quão confiavelmente os modelos lidam com fluxos de trabalho agênticos.
Mas aqui está a parte que eu quero aprofundar: como tudo isso realmente performa quando você lança trabalho real nele.
Os Benchmarks — Números Impressionantes Com Um Asterisco Importante
Antes de compartilhar meus resultados práticos, os números oficiais merecem exame. Não porque eu leve benchmarks pelo valor de face — não levo, e você também não deveria — mas porque algumas dessas pontuações contam uma história específica sobre onde o Google focou seu esforço de treinamento.
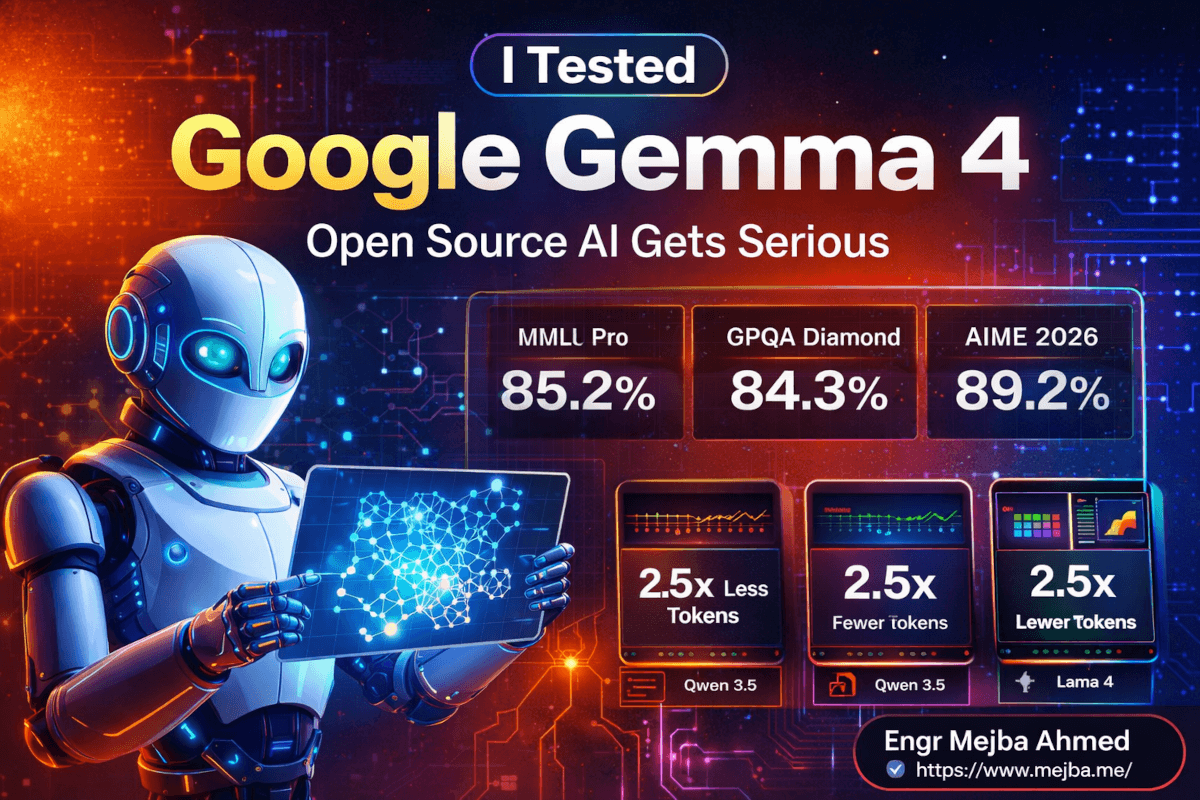
O modelo 31B dense pontua 85,2 no MMLU Pro, que mede conhecimento amplo e raciocínio em dezenas de domínios acadêmicos. Para um modelo de 31 bilhões de parâmetros, isso é excepcional. Ele atinge 89,2% no AIME 2026 — o benchmark de competição matemática que separa modelos com raciocínio matemático genuíno daqueles que fazem pattern-matching através da aritmética. GPQA Diamond, o benchmark de ciências em nível de pós-graduação, chega a 84,3%. E LiveCodeBench v6, que testa habilidade de programação prática em problemas recentes nos quais o modelo não poderia ter sido treinado, mostra 80%.
| Benchmark | Gemma 4 31B | O Que Mede |
|---|---|---|
| MMLU Pro | 85,2% | Conhecimento amplo e raciocínio |
| AIME 2026 | 89,2% | Raciocínio matemático |
| GPQA Diamond | 84,3% | Ciências em nível de pós-graduação |
| LiveCodeBench v6 | 80,0% | Habilidade de programação real |
| Arena AI (texto) | #3 modelo aberto (1452) | Ranking de preferência humana |
O modelo 31B atualmente está em terceiro lugar entre todos os modelos abertos no leaderboard de texto do Arena AI com uma pontuação de 1452. O 26B MoE está em sexto com 1441 — lembre-se, isso usando apenas 3,8 bilhões de parâmetros ativos para quase igualar seu irmão muito maior.
Agora, o asterisco. De acordo com o índice de inteligência que tenho acompanhado entre modelos, o Gemma 4 31B pontua 31, enquanto o modelo Qwen 3.5 27B pontua 42. Essa é uma diferença significativa em uma métrica projetada para medir capacidade de raciocínio geral. Os números de benchmark acima pintam o Gemma 4 como competitivo em domínios específicos, mas em inteligência holística — o tipo de capacidade "consegue descobrir algo para o qual não foi especificamente treinado" — o Qwen ainda mantém vantagem em contagens de parâmetros similares.
Isso importa para fluxos de trabalho de programação agêntica onde o modelo precisa fazer julgamentos, não apenas executar padrões. Vou te mostrar exatamente onde isso apareceu nos meus testes.
Uma área onde o Gemma 4 genuinamente supera é a eficiência de tokens. Nos meus testes, os modelos Gemma 4 usaram aproximadamente 2,5 vezes menos tokens de saída para tarefas similares comparado com Qwen 3.5 e Llama 4. Menos tokens significa custo menor, geração mais rápida e menos janela de contexto consumida pela própria saída do modelo. Para fluxos de trabalho agênticos onde você encadeia múltiplas chamadas, essa eficiência se acumula rapidamente.
Rodando Gemma 4 Localmente — Onde a Verdadeira História Mora
Aqui é onde minha opinião sobre o Gemma 4 mudou de "interessante" para "isso muda as coisas."
Baixei o modelo 26B MoE através do Ollama no primeiro dia — o Gemma 4 teve suporte desde o primeiro dia no Ollama, Hugging Face, LM Studio e Kaggle. A configuração foi trivial: ollama pull gemma4:26b, configurar OLLAMA_NUM_GPU=99 para maximizar o offloading de camadas para GPU, e começar a fazer prompts.
Na minha configuração Mac, o modelo 26B com quantização Q4_K_M era responsivo o suficiente para trabalho de desenvolvimento real. Não "espere quinze segundos por resposta" responsivo. Realmente utilizável. O tipo de velocidade onde você pode ter uma conversa com o modelo e não perder o raciocínio entre respostas.
O Google afirma aproximadamente 300 tokens por segundo em um Mac Studio M2 Ultra para o modelo 26B. Meus próprios testes não atingiram esse número exato — configurações de quantização, complexidade do prompt e comprimento do contexto afetam o throughput — mas o modelo foi consistentemente mais rápido que qualquer outro modelo de capacidade comparável que já rodei localmente. Essa arquitetura de 3,8 bilhões de parâmetros ativos faz o que promete.
O modelo 31B dense é mais pesado. Precisa de hardware mais sério — uma GPU de desktop com VRAM suficiente, ou uma máquina Apple Silicon bem especificada. Mas para qualquer pessoa que já tenha esse hardware debaixo da mesa, está rodando um modelo top três aberto sem pagar por chamadas de API. Sem enviar seu código para o servidor de ninguém. Sem se preocupar com rate limits às 2 da manhã quando você está na zona e queimando prompts.
Para os modelos edge — o E2B e E4B — o Google está empurrando forte a inferência no dispositivo. A Android AICore Developer Preview dá aos desenvolvedores um caminho para rodar esses modelos diretamente em telefones. Não testei o caminho de deploy móvel eu mesmo, mas a implicação é significativa: raciocínio de IA multimodal — texto, imagens, áudio — rodando inteiramente em um dispositivo no seu bolso. Sem viagem de ida e volta à nuvem. Sem dados saindo do dispositivo. Para aplicações sensíveis à privacidade, isso não é um nice-to-have. É um requisito.
A licença Apache 2.0 remove outra barreira que encontrei com outros modelos abertos. O Llama 4 usa a licença comunitária da Meta com um limiar de 700 milhões de usuários ativos mensais — tudo bem para a maioria dos desenvolvedores, mas uma restrição genuína para empresas que escalam rapidamente. O Qwen 3.5 também usa Apache 2.0, então há paridade aí. Mas comparado com os termos mais restritivos do Gemma 3, esta é uma mudança significativa na estratégia de código aberto do Google. Liberdade comercial total. Sem imposição de política de uso aceitável. Sem limites de usuários ativos mensais.
Se você preferir ter alguém que configure uma pipeline de inferência de IA local do zero — configurando quantização, otimização de hardware e cadeias de ferramentas agênticas — eu aceito exatamente esse tipo de projeto. Você pode ver o que já fiz em fiverr.com/s/EgxYmWD.
O Teste de Geração de UI — Meu Desafio Padrão
Toda vez que um modelo alega fortes capacidades de programação, eu rodo a mesma bateria de testes que uso em cada análise. O primeiro é sempre geração frontend — construir uma UI complexa a partir de um único prompt. Testa senso de design, estrutura de código, gerenciamento de estado e atenção aos detalhes simultaneamente.
Pedi ao modelo Gemma 4 31B para construir uma interface de desktop estilo macOS no navegador. Apps funcionais. Janelas arrastáveis. Um dock funcional. O mesmo prompt que lancei para Qwen 3.6 Plus, Claude Opus e GLM5.
O que voltou foi genuinamente bom. Uma barra de ferramentas que parecia pertencer a um Mac real. Uma calculadora que funcionava. Um emulador de terminal. Painéis de configurações. O layout era limpo — não o tipo de saída "funciona mas parece um protótipo" que já recebi de modelos menores. A qualidade ficou em torno de 7,5 a 8 de 10 pela minha avaliação subjetiva.
Onde falhou: a navegação de pastas no clone do Finder estava incompleta. Algumas interações de apps que deveriam ter disparado mudanças de estado não dispararam. Esses são o tipo de problemas de polimento que separam um forte primeiro rascunho de código pronto para produção — e são consistentes com o que vejo de modelos nessa faixa de parâmetros. Claude Opus e Qwen 3.6 Plus lidam com esses casos limite melhor, mas também são maiores, mais caros, ou ambos.
O modelo 26B MoE lidou com uma tarefa de UI similar com falhas menores — algumas animações não dispararam corretamente, e algumas transições CSS estavam desajustadas. Mas a relação velocidade-qualidade foi notável. Chegar a 80% do caminho até uma UI polida em uma fração do tempo e custo? Para prototipagem, para ferramentas internas, para provas de conceito — esse é o ponto ideal.
Também testei um prompt mais restrito: gerar um layout de UI específico com requisitos estritos de design tokens, espaçamento definido e um sistema de cores particular. Isso testa o seguimento de instruções mais do que criatividade bruta. Tanto o modelo 31B quanto o 26B lidaram bem — código de nível de produção que respeitava as restrições. Qualidade comparável ao que obtive do Qwen 3.6 e Opus 4.5 em tarefas similares.
O Teste de Simulação de Física — Onde as Lacunas Aparecem
Meu segundo teste padrão empurra modelos para território onde raciocínio bruto importa mais que reconhecimento de padrões: simulações de física. Pedi ao Gemma 4 31B para construir um simulador de donuts de F1 — um carro girando em círculos apertados com física de pneus realista, efeitos de fumaça e renderização 3D.
O modelo mostrou criatividade genuína aqui. Tentou interações físicas complexas, renderização de perspectiva 3D e efeitos de partículas para fumaça de pneus. A ambição técnica foi impressionante para um modelo de 31 bilhões de parâmetros. Entendeu como uma manobra de donut parece fisicamente e tomou decisões de engenharia razoáveis sobre como simulá-la.
Mas a execução ficou aquém do que o Qwen 3.6 entregou no mesmo prompt. A física parecia ligeiramente errada — cálculos de aderência de pneus produziram comportamento irrealista em certas velocidades. A renderização 3D tinha problemas de ordenação por profundidade. As partículas de fumaça não tinham a aleatoriedade orgânica que faz simulações parecerem reais.
É aqui que a diferença do índice de inteligência entre Gemma 4 (pontuação 31) e Qwen 3.5 (pontuação 42) aparece na prática. Tarefas que exigem que o modelo raciocine através de interações físicas novas — situações onde não pode depender de padrões memorizados de dados de treinamento — expõem o teto. O Gemma 4 te leva solidamente 70-75% do caminho. O Qwen te leva a 85-90%. Para muitas aplicações, essa diferença não importa. Para simulações complexas e jogos, importa.
Os Testes de Batalha na Arena — Desempenho Agêntico no Mundo Real
Passei uma tarde sólida rodando o modelo 31B através do modo batalha do LM Arena — comparações cara a cara contra oponentes anônimos em uma variedade de tarefas. É aqui que você vê como um modelo performa quando não pode depender de treinamento otimizado para benchmarks.
Gerenciamento de estado interativo: Pedi para construir um dashboard multi-abas com estado compartilhado entre componentes. O Gemma 4 lidou com isso de forma limpa — state lifting correto, gerenciamento de contexto, atualizações reativas. O código era bem estruturado e manutenível.
Visualizador de produto 360 graus: Uma exibição de produto com zoom, anotações de hotspot e rotação suave. O modelo gerou isso a partir de um único prompt com interações funcionais de mouse/toque. O posicionamento dos hotspots era preciso, e o comportamento do zoom parecia natural.
Geração de SVG animado: Pedi uma borboleta animada — o mesmo teste que rodo em cada modelo. Resultados mistos. A geometria das asas foi criativa, mas o timing da animação parecia mecânico. O Qwen 3.6 produziu movimento mais orgânico no mesmo prompt. A versão do GLM5 foi melhor ainda. Animação SVG parece ser uma fraqueza persistente na linhagem Gemma.
Clone de site: Pedi uma página de listagens estilo Airbnb com conteúdo de aparência real, ícones SVG, formatação adequada e layout responsivo. Isso foi surpreendentemente forte. O modelo gerou ícones SVG personalizados que pareciam intencionalmente projetados, não aleatórios. A tipografia e o espaçamento mostraram consciência de design genuína. O layout era responsivo. Estimaria que isso foi 85% do que um desenvolvedor frontend de nível médio produziria em algumas horas de trabalho focado.
Lógica de jogo: Um jogo de cartas com lançamento de cartas baseado em física, aplicação de regras e pontuação. O modelo lidou com a lógica do jogo corretamente — gerenciamento de turnos adequado, cálculo de pontuação, validação de regras. A física dos lançamentos de cartas era simplificada mas funcional. Onde teve dificuldades foi no polimento visual das animações de cartas.
Em todos esses testes de batalha, um padrão emergiu consistentemente: Gemma 4 31B é uma excelente máquina de primeiro rascunho. As decisões estruturais são sólidas. A arquitetura de código é limpa. A saída inicial te leva 75-85% do caminho até um produto finalizado. Mas a última milha — o polimento de animações, o tratamento de casos limite, as interações sutis que fazem algo parecer profissional — frequentemente precisa de refinamento manual ou uma segunda passada com um modelo mais capaz.
Capacidades Agênticas — O Recurso Que o Google Quer Que Você Note
O Google está fazendo uma aposta deliberada com o Gemma 4: eles querem que esses modelos sejam a base de fluxos de trabalho de IA agênticos. Não apenas chatbots. Não apenas geradores de código. Agentes autônomos que encadeiam ferramentas, executam planos multi-etapa e sintetizam resultados através de diferentes modalidades.
A implementação prática disso aparece de algumas formas.
Primeiro, o uso de ferramentas é treinado nativamente — não ajustado sobre um modelo base. Quando configurei um loop de agente simples com o modelo 31B — pesquisar na web, extrair dados, formatar como JSON, passar para o próximo passo — o modelo lidou com as transições de forma limpa. Sabia quando chamar uma ferramenta, como formatar a entrada e como interpretar a saída sem engenharia de prompts extensiva. Este é o tipo de comportamento que separa modelos sobre os quais você pode realmente construir agentes de modelos que precisam de dez páginas de prompts de sistema para usar uma calculadora.
Segundo, a saída JSON estruturada é confiável. Rodei cinquenta solicitações consecutivas pedindo esquemas JSON específicos — objetos aninhados, arrays, campos opcionais, restrições de tipo — e o modelo 31B acertou o formato correto em 47 de 50 tentativas. As três falhas foram problemas menores de formatação, não erros estruturais. Para pipelines de agentes em produção onde uma resposta JSON malformada quebra o próximo passo, essa confiabilidade importa mais que qualquer número de benchmark.
Terceiro, a capacidade de raciocínio multi-etapa lida bem com tarefas compostas. Dei ao modelo 26B um prompt que exigia: analisar uma captura de tela de um dashboard, identificar três problemas de UX, propor soluções específicas para cada um e gerar o código corrigido. Executou todas as quatro etapas de forma coerente em uma única resposta. As críticas de UX eram específicas e acionáveis. As correções de código abordaram os problemas realmente identificados. A cadeia de raciocínio não derivou nem perdeu contexto entre os passos.
O Google também introduziu o que eles chamam de "agent skills" dentro do ecossistema do app Gemini — essencialmente comportamentos agênticos empacotados que os modelos Gemma menores podem executar no dispositivo. Os modelos menores E2B e E4B podem rodar essas agent skills inteiramente em um telefone sem computação em nuvem. Encadear múltiplas ferramentas. Realizar tarefas multi-etapa. Combinar saídas. Tudo localmente.
Essa visão de IA agêntica no dispositivo é onde as coisas ficam genuinamente interessantes. Imagine um telefone que pode analisar suas fotos, extrair texto de documentos, cruzar informações e tomar ações — tudo sem enviar um único byte para um servidor. Ainda não estamos completamente lá com as capacidades do modelo E2B, mas a base arquitetural está no lugar. E o modelo 26B rodando em um Mac Studio prova que o conceito funciona em níveis de capacidade mais altos.
Como o Gemma 4 Se Compara ao Qwen 3.5 e Llama 4
Não posso escrever esta análise sem abordar o cenário competitivo diretamente. O espaço de IA de código aberto em abril de 2026 tem três grandes concorrentes, e escolher entre eles depende inteiramente do que você está construindo.
| Dimensão | Gemma 4 (31B/26B) | Qwen 3.5 (27B) | Llama 4 Scout |
|---|---|---|---|
| Licença | Apache 2.0 | Apache 2.0 | Meta Community (teto 700M MAU) |
| Janela de Contexto | 256K tokens | 131K tokens | 10M tokens |
| Eficiência de Tokens | ~2,5x menos tokens de saída | Linha base | Varia |
| Matemática (AIME) | 89,2% | Maior | Menor |
| Ranking Arena | #3 modelo aberto | #1 modelo aberto | Varia por tarefa |
| Multilíngue | 140+ idiomas | 201 idiomas | Menos |
| Modelos no Dispositivo | Sim (E2B, E4B) | Limitado | Não |
| Velocidade de Inferência Local | Excelente (MoE) | Boa | Depende do contexto |
Escolha Gemma 4 quando: Você precisa de velocidade de inferência local, deploy no dispositivo ou máxima eficiência de tokens. A relação velocidade-qualidade do modelo 26B MoE é incomparável. Se sua pipeline agêntica encadeia muitas chamadas e você paga por token, a vantagem de eficiência de 2,5x se acumula em dinheiro real economizado.
Escolha Qwen 3.5 quando: Inteligência bruta por parâmetro é sua prioridade. O Qwen vence em raciocínio geral, tarefas multilíngues e no índice de inteligência geral. Se você precisa de um modelo que lide com problemas novos e imprevisíveis — o tipo de tarefas que não mapeiam de forma limpa para dados de treinamento — o Qwen atualmente tem a vantagem.
Escolha Llama 4 Scout quando: Comprimento de contexto não é negociável. Essa janela de contexto de 10 milhões de tokens está em um universo diferente dos 256K do Gemma 4. Se você está processando codebases inteiros, documentos do tamanho de livros ou conjuntos de dados massivos em uma única passada, o Llama 4 é a única opção.
A diferença de licença também importa. Tanto o Gemma 4 quanto o Qwen 3.5 usam Apache 2.0 — liberdade comercial total sem restrições. A licença comunitária do Llama 4 introduz um limiar de 700 milhões de usuários ativos mensais que não afetará 99% dos desenvolvedores, mas se torna uma restrição real se você está construindo algo que escala viralmente.
Minha opinião honesta: o Gemma 4 não destrona o Qwen 3.5 como o melhor modelo aberto no geral. Mas não precisa. Sua força é a história de eficiência — fazer 80-90% do que o Qwen faz enquanto usa 2,5x menos tokens e roda mais rápido em hardware de consumo. Para casos de uso específicos, essa compensação é a correta.
Acessando o Gemma 4 — Todas as Opções Disponíveis Agora
Colocar as mãos nesses modelos é mais fácil do que qualquer lançamento anterior do Gemma. O Google claramente priorizou a acessibilidade desta vez.
Google AI Studio — Gratuito. Sem cartão de crédito necessário. Você pode testar todos os quatro modelos diretamente no navegador com entradas multimodais. Esta é a forma mais rápida de experimentar. O Google fornece $25 em créditos de API gratuitos para desenvolvedores que querem ir além do playground.
Ollama — Suporte desde o primeiro dia. Rode ollama pull gemma4:26b ou ollama pull gemma4:31b e você está rodando localmente em menos de um minuto (após o download). Para os modelos edge: ollama pull gemma4:e2b e ollama pull gemma4:e4b.
Hugging Face — Pesos completos do modelo disponíveis para download. Todas as variantes de quantização. Fine-tunes da comunidade já estão aparecendo.
LM Studio — Deploy local point-and-click para qualquer pessoa que não queira mexer em um terminal.
Kaggle — Notebooks e cartões de modelo com implementações de exemplo.
API via API Gemini do Google — Para deploys em produção. O preço fica em aproximadamente $0,14 por milhão de tokens de entrada e $0,40 por milhão de tokens de saída ao rotear através do Gemma 4 no Vertex AI. Isso é absurdamente barato comparado com modelos fechados frontier.
OpenRouter — Acesso API de terceiros com endpoints padronizados. Bom se você já está usando OpenRouter para outros modelos e quer uma configuração de faturamento unificada.
Kilo CLI — Vale mencionar especificamente para fluxos de trabalho agênticos. O harness do Kilo é otimizado para uso de ferramentas e loops de agentes, e múltiplos desenvolvedores na comunidade o marcaram como a melhor experiência para as capacidades agênticas do Gemma 4 especificamente.
Para deploy local, o ponto ideal de quantização parece ser Q4_K_M para o modelo 26B — preserva a maior parte da qualidade enquanto cabe confortavelmente em máquinas com 16GB+ de memória unificada. O modelo 31B dense precisa de mais espaço — 24GB mínimo para inferência confortável, e você vai querer 32GB+ se estiver enviando prompts de contexto longo.
O Que Ninguém Está Falando — A Mudança de IA no Dispositivo
A maioria da cobertura do Gemma 4 foca nas pontuações de benchmark do modelo 31B. Justo — esses números são bons, e benchmarks geram manchetes. Mas eu acho que a parte mais consequente deste lançamento é o que está acontecendo na parte inferior da linha de modelos.
Os modelos E2B e E4B representam algo que venho observando há meses: o momento em que IA genuinamente útil para de exigir uma conexão com a internet.
A Android AICore Developer Preview do Google permite que desenvolvedores de apps rodem os modelos edge do Gemma 4 diretamente em dispositivos suportados. Não através de uma API na nuvem fingindo ser no dispositivo. Realmente no silício dentro do telefone. Os modelos suportam raciocínio multimodal — podem analisar imagens, processar áudio e combinar insights entre modalidades. Em um telefone.
As implicações de privacidade são imediatas e óbvias. Apps médicos que analisam imagens sem carregá-las. Processamento de documentos que nunca sai do dispositivo. Assistentes pessoais que entendem seu contexto sem enviar seus dados para um datacenter. Para mercados com requisitos estritos de residência de dados — saúde, finanças, governo — isso não é uma conveniência. É um requisito de conformidade sendo resolvido no nível do modelo.
As implicações de desempenho são igualmente interessantes. Sem latência de rede. Sem rate limits de API. Sem interrupções de serviço. O modelo está lá quando você precisa, rodando em hardware que você já possui. Para fluxos de trabalho agênticos que precisam encadear múltiplas chamadas de inferência rápidas, eliminar a viagem de ida e volta de rede para cada chamada transforma o que é arquiteturalmente possível.
Tenho construído principalmente com modelos hospedados na nuvem — Claude, GPT, Gemini através de APIs. E continuarei fazendo isso, porque modelos frontier ainda lidam com tarefas complexas melhor do que qualquer coisa rodando localmente. Mas os modelos edge do Gemma 4 representam o início de uma alternativa credível para uma categoria significativa de tarefas. Uso simples de ferramentas. Extração de dados estruturados. Análise de imagens. Raciocínio multi-etapa em problemas restritos. Esses não precisam de um modelo na nuvem de um trilhão de parâmetros. Precisam de algo rápido, privado e bom o suficiente.
O futuro não é nuvem OU local. É uma camada de roteamento que envia tarefas simples para sua instância local do Gemma 4 e tarefas complexas para Claude ou GPT através da API. O Gemma 4 torna essa arquitetura viável pela primeira vez com modelos que são realmente bons o suficiente para confiar com trabalho real.
A Avaliação Honesta — Onde o Gemma 4 Fica Aquém
Passei a maior parte deste artigo destacando pontos fortes genuínos, então deixe-me ser direto sobre as fraquezas. Você merece conhecê-las antes de se comprometer com o Gemma 4 para qualquer projeto sério.
Teto de geração criativa. Em tarefas que exigem novidade genuína — simulações de física, mecânicas de jogo complexas, animações SVG criativas — o Gemma 4 consistentemente fica abaixo do Qwen 3.5 e 3.6. A diferença não é enorme, mas é consistente. Se seu trabalho exige empurrar modelos para território desconhecido, você alcançará esse teto.
A lacuna do índice de inteligência. Uma pontuação de 31 versus os 42 do Qwen no índice de inteligência holístico se traduz em diferenças perceptíveis em tarefas de raciocínio composto. Quando uma tarefa exige que o modelo encadeie cinco ou seis passos de raciocínio onde cada passo depende de acertar o anterior, o Gemma 4 erra mais frequentemente. Não frequentemente — mas o suficiente para você notar em pipelines agênticas rodando centenas de tarefas.
Capacidades multimodais são fortes mas não as melhores da classe. As capacidades de visão lidam bem com tarefas padrão — analisar capturas de tela, extrair texto de imagens, descrever conteúdo visual. Mas em tarefas que exigem raciocínio visual profundo — entender diagramas complexos, interpretar layouts visuais ambíguos, sintetizar insights através de múltiplas imagens — achei a saída menos confiável do que o que recebo do Gemini 3 Pro ou Claude Opus através de suas APIs de visão nativas.
Os modelos edge são limitados. Os modelos E2B e E4B são impressionantes para seu tamanho, mas ainda são modelos pequenos. Esperar que lidem com fluxos de trabalho agênticos complexos da mesma forma que o modelo 31B leva à frustração. São mais adequados para tarefas específicas e bem restritas — não para raciocínio aberto.
Documentação e maturidade do ecossistema. É 3 de abril de 2026 — o Gemma 4 está público há um dia. As ferramentas da comunidade, fine-tunes e melhores práticas não tiveram tempo de se desenvolver. Se você está procurando receitas prontas para produção e configurações testadas em batalha, vai precisar ser paciente ou construir as suas próprias.
Nenhuma dessas é motivo para descartar. Todo modelo tem fraquezas. A questão é se as fraquezas se sobrepõem ao seu caso de uso específico — e para muitos desenvolvedores, não vão.
O Que Eu Realmente Vou Fazer Com o Gemma 4
Não escrevo essas análises para classificar modelos em um leaderboard. Escrevo para descobrir quais ferramentas merecem um lugar permanente no meu fluxo de trabalho e quais são interessantes-mas-não-para-mim.
Aqui é onde o Gemma 4 pousa para mim:
O modelo 26B MoE vai para minha configuração de inferência local imediatamente. A relação velocidade-qualidade para prototipagem, geração rápida de código e extração de dados estruturados é a melhor que já vi de um modelo rodável localmente. Quando preciso de uma resposta rápida e não quero queimar créditos de API, este é meu padrão.
O modelo 31B dense se torna minha opção secundária para tarefas que precisam de mais profundidade de raciocínio mas onde ainda quero ficar local. Code reviews complexos. Sugestões de refatoração multi-arquivo. Análise de contexto longo de repositórios inteiros. Qualquer coisa onde quero qualidade mas também privacidade.
O modelo E4B vai para minha lista de testes para um projeto móvel que tenho planejado — uma ferramenta de análise de documentos no dispositivo. Se pode extrair e raciocinar sobre conteúdo de documentos de forma confiável sem conectividade na nuvem, isso resolve um requisito de produto genuíno com o qual tenho lutado.
Para meus fluxos de trabalho de programação agêntica primários — as pipelines de agentes complexas e multi-etapa que precisam fazer julgamentos e lidar com situações inesperadas — fico com Claude Opus e Qwen 3.6 Plus. Esses modelos ainda lidam melhor com as coisas difíceis. Mas o Gemma 4 acabou de reduzir com que frequência preciso recorrer a eles.
A história de eficiência é real. A história de deploy local é real. As capacidades agênticas são genuinamente boas, não afirmações de marketing esticadas além da realidade. O esforço de IA de código aberto do Google finalmente produziu algo que muda como eu trabalho, não apenas como penso sobre benchmarks.
Um ano atrás, eu teria dito para ignorar o Gemma e focar no Llama ou Qwen para trabalho de IA de código aberto. Hoje, diria para testar o modelo 26B no seu próprio hardware antes de tomar essa decisão. Você pode se surpreender com o que 3,8 bilhões de parâmetros ativos podem fazer quando são os 3,8 bilhões certos.
Perguntas Frequentes
O Gemma 4 pode rodar em um Mac Mini ou MacBook Pro?
O modelo 26B MoE roda bem em máquinas Apple Silicon com 16GB+ de memória unificada usando quantização Q4_K_M através do Ollama ou LM Studio. O modelo 31B dense precisa de 24GB mínimo. Modelos edge (E2B, E4B) rodam em praticamente qualquer hardware moderno.
O Gemma 4 é realmente gratuito para uso comercial?
Sim. Todos os quatro modelos são entregues sob Apache 2.0 — a licença de código aberto mais permissiva disponível. Sem limites de usuários ativos mensais, sem restrições de uso aceitável, liberdade total para deploys comerciais e soberanos. Para a comparação completa de licenças, veja a seção de análise competitiva acima.
Como o Gemma 4 se compara ao Qwen 3.5 para programação?
O Gemma 4 31B pontua 80% no LiveCodeBench v6 e gera código limpo e bem estruturado. O Qwen 3.5 pontua mais alto em métricas de inteligência geral e lida melhor com resolução criativa de problemas. A vantagem do Gemma 4 é a eficiência de tokens — usa aproximadamente 2,5x menos tokens para tarefas similares, tornando-o significativamente mais barato para fluxos de trabalho de programação de alto volume.
Qual é a melhor forma de acessar o Gemma 4 agora?
O Google AI Studio oferece testes gratuitos baseados em navegador com $25 em créditos de API. Para uso local, o Ollama fornece suporte desde o primeiro dia — apenas rode ollama pull gemma4:26b. Acesso à API de produção através do Vertex AI custa aproximadamente $0,14 por milhão de tokens de entrada. Veja o guia de acesso completo acima para cada opção disponível.
Devo trocar do Llama 4 para o Gemma 4?
Depende das suas necessidades de janela de contexto. O Llama 4 Scout oferece 10 milhões de tokens de contexto — aproximadamente 40x mais que os 256K do Gemma 4. Se você está processando documentos massivos ou codebases inteiros em uma única passada, o Llama 4 continua sendo a melhor escolha. Para todo o resto — velocidade, eficiência, liberdade de licença, deploy no dispositivo — o Gemma 4 é a opção mais forte.
Vamos Trabalhar Juntos
Procurando construir sistemas de IA, automatizar fluxos de trabalho ou escalar sua infraestrutura tech? Adoraria ajudar.
- Fiverr (builds customizados e integrações): fiverr.com/s/EgxYmWD
- Portfólio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io