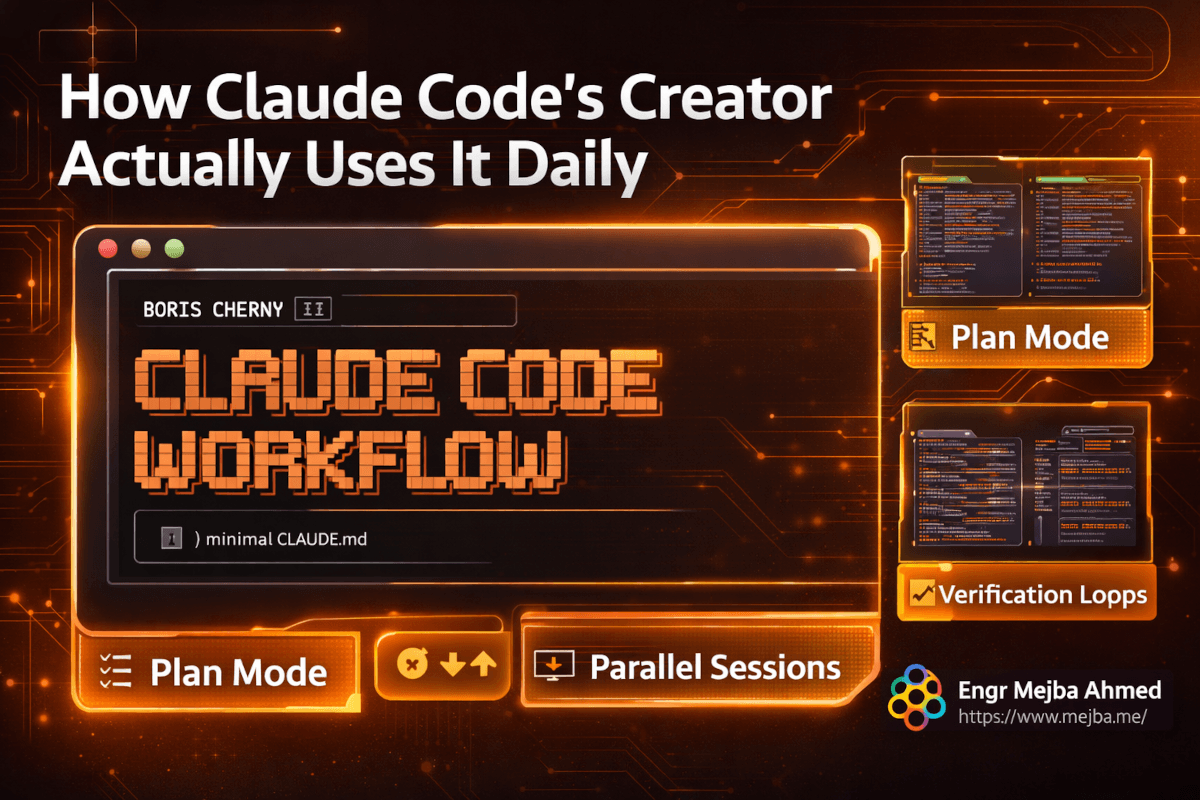
Boris Cherny não escreveu manualmente uma única linha de código desde novembro de 2025.
Deixe isso assentar por um momento. A pessoa que construiu o Claude Code — que projetou a ferramenta que centenas de milhares de desenvolvedores agora usam diariamente — parou de digitar código manualmente há mais de quatro meses. E sua produção não caiu. Acelerou. Ele envia entre 10 e 30 pull requests todos os dias, executa até 15 sessões do Claude Code em paralelo entre seu terminal e navegador, e ocasionalmente inicia sessões de programação pelo celular antes de dormir para revisar o trabalho finalizado com o café da manhã.
Quando ouvi isso pela primeira vez em sua participação no podcast do Lenny, minha reação foi de ceticismo. Trinta PRs por dia? De alguém que não escreve código? Isso parece ostentação de LinkedIn disfarçada de guru de produtividade.
Então estudei seu fluxo de trabalho real. E o que me surpreendeu não foi o volume — foi a simplicidade. O sistema do Boris é quase agressivamente mínimo. Sem bibliotecas de prompts complexas. Sem scaffolding elaborado. Sem arquivos de instruções de vinte páginas. Toda a sua configuração do CLAUDE.md tem aproximadamente 100 linhas. Cerca de 2.500 tokens. É isso.
A diferença entre minha produtividade com o Claude Code e a dele não era sobre alguma técnica secreta que eu não tinha descoberto. Era sobre seis princípios que eu vinha ignorando, complicando demais ou fazendo ao contrário. Depois de passar as últimas duas semanas reestruturando meu próprio fluxo de trabalho seguindo sua abordagem, posso dizer — os resultados são reais. Meu tempo de depuração caiu aproximadamente pela metade. Minhas sessões produzem resultados utilizáveis na primeira tentativa cerca de 3x mais frequentemente. E finalmente parei aquele ciclo enlouquecedor onde o Claude constrói confiantemente a coisa errada enquanto eu assisto, mergulhado demais em custos irrecuperáveis para interromper.
Aqui está a análise completa do que Boris Cherny realmente faz — e mais importante, por que cada peça importa mais do que parece.
"Vá devagar para ir rápido" — Por que 80% das sessões começam no plan mode
Isso foi a primeira coisa que mudou minha forma de trabalhar, e honestamente, é o princípio ao qual resisti por mais tempo.
Eu costumava abrir o Claude Code e começar a fazer prompts imediatamente. Descrever a funcionalidade. Ver o código aparecer. Me sentir produtivo. Exceto que eu não era produtivo — estava ocupado. Há uma diferença crítica, e Boris acerta em cheio com uma única observação: a IA resolve problemas rápido, mas não necessariamente os problemas certos. Sem planejamento claro, o Claude vai correr confiante na direção errada e construir algo tecnicamente impressionante que erra completamente o objetivo real.
Boris começa aproximadamente 80% de suas sessões no plan mode. Se você não está familiarizado, o plan mode (ativado pressionando Shift+Tab duas vezes no Claude Code) diz à IA para pensar e analisar sem escrever código ou executar comandos. Ele lê arquivos, faz perguntas, propõe abordagens — mas não toca em nada até que você aprove explicitamente o plano.
A técnica específica que Boris usa é o que ele chama de "prompt de entrevista". Antes de qualquer código ser gerado, ele pergunta ao Claude algo assim:
Interview me about this. What core problems does this solve?
Who is this for? What does success look like? What should this
NOT do? Summarize it back to me before writing any code.
Esse prompt mudou todo o meu fluxo de trabalho. Eis por que ele é mais poderoso do que parece.
Quando tentei pela primeira vez, o Claude me fez cinco perguntas de esclarecimento sobre uma funcionalidade que eu pensava ter descrito com clareza. Duas dessas perguntas revelaram suposições que eu havia feito e que estavam simplesmente erradas. Uma delas — "Isso deve modificar o registro de usuário existente ou criar uma nova entrada no log de atividades?" — teria levado a um erro de arquitetura de banco de dados que poderia ter custado horas para desenrolar se o Claude tivesse simplesmente começado a construir.
Boris compartilhou um exemplo específico que ficou gravado na minha memória: uma correção de bug para um cliente onde o Claude, sem planejamento, foi direto modificar valores do banco de dados em vez de corrigir a lógica de exibição da UI. A "correção" tecnicamente resolveu o sintoma reportado, mas quebrou três outras funcionalidades que dependiam daqueles valores do banco de dados. O tipo de bug que passa num teste manual rápido e depois explode em produção dois dias depois.
O plan mode teria detectado isso em sessenta segundos. A entrevista teria revelado que o problema era apenas de exibição. O Claude teria proposto uma correção na camada de UI. Sem alterações no banco de dados. Sem cascata de quebras.
Estou usando essa abordagem de entrevista primeiro há duas semanas, e o padrão é consistente: aproximadamente 4-5 minutos de planejamento economizam 20-40 minutos de retrabalho. A matemática nem se compara.
Um detalhe fácil de perder — o plan mode também é significativamente mais rápido e econômico por interação. Como o Claude não executa ferramentas, não escreve arquivos e não roda comandos durante o planejamento, as respostas voltam na velocidade da luz e consomem menos tokens. Você está essencialmente obtendo o melhor raciocínio da IA com desconto antes de se comprometer com a cara fase de execução.
Depois que o Claude apresenta seu plano, Boris o revisa, às vezes o edita diretamente usando Ctrl+G (que abre o plano no seu editor de texto), e só então muda para o modo de aceitação automática para deixar o Claude executar. Na maioria dos casos, ele diz, o Claude acerta a implementação de primeira após uma boa sessão de planejamento. Uma tentativa. Sem iterações. Sem correções de "isso está perto, mas na verdade eu quis dizer...".
Só isso já vale o esforço do planejamento. Mas o próximo princípio é o que faz o planejamento perdurar entre sessões.
O CLAUDE.md de 100 linhas — Por que menos contexto supera mais
Aqui é onde a abordagem do Boris contradisse diretamente o que eu vinha fazendo por meses.
Eu tinha um arquivo CLAUDE.md que se aproximava de 500 linhas. Documentação arquitetural detalhada. Padrões de codificação com exemplos. Contexto histórico sobre por que certas decisões foram tomadas. Bibliotecas de padrões. Parecia completo. Profissional. Como um documento de engenharia adequado.
Também estava silenciosamente consumindo 30% da minha janela de contexto disponível a cada solicitação. Toda vez que eu fazia uma pergunta ao Claude — mesmo uma simples — essas 500 linhas eram carregadas primeiro. Tokens gastos antes do trabalho real sequer começar.
O CLAUDE.md do Boris tem aproximadamente 100 linhas. Cerca de 2.500 tokens. E supera qualquer arquivo de instruções inchado que eu já construí.
Sua filosofia é quase zen em sua contenção: o arquivo deve conter apenas regras que corrigem erros recorrentes. Sem documentação. Sem explicações de arquitetura. Sem padrões de codificação que o Claude já conhece dos seus dados de treinamento. Apenas correções. Proteções. As coisas específicas que o Claude erra no seu projeto que ele não saberia sem ser informado.
O processo é reativo, não proativo. Boris e sua equipe na Anthropic seguem uma regra simples: "Toda vez que vemos o Claude fazer algo incorretamente, adicionamos ao CLAUDE.md para que não se repita na próxima vez." O arquivo é registrado no git, compartilhado com toda a equipe, e atualizado várias vezes por semana. Mas coisas também são removidas. À medida que os modelos melhoram, regras que eram necessárias há seis meses se tornam redundantes. O Claude as aprendeu por conta própria.
Isso se conecta com algo que cobri no meu guia de 50 dicas do Claude Code — seu CLAUDE.md é seu superpoder ou seu gargalo, e a linha divisória é o tamanho. Mas Boris vai além do que eu fui. Ele não apenas recomenda mantê-lo curto. Ele recomenda apagá-lo e recriá-lo do zero quando ficar inchado ou contraditório, em vez de tentar limpá-lo cirurgicamente.
O raciocínio: instruções acumuladas desenvolvem contradições internas ao longo do tempo. A Regra 7 diz "sempre use async/await" mas a Regra 43 diz "use callbacks para operações de banco de dados." Um humano lendo o arquivo poderia detectar o conflito. O Claude pode não detectar — ou pior, pode tentar satisfazer ambos simultaneamente, produzindo código híbrido bizarro.
Começar do zero elimina as contradições, as instruções duplicadas e as regras escritas para capacidades do modelo que não se aplicam mais. É a abordagem Marie Kondo da configuração de IA: se uma regra não corrige um problema atualmente ativo, não deveria estar no arquivo.
Tentei isso na semana passada. Apaguei meu CLAUDE.md de 500 linhas e o reconstruí do zero com apenas as regras que eu podia justificar das últimas duas semanas de uso. Terminei com 87 linhas. Meu consumo de tokens caiu notavelmente, e — aqui está a parte que eu não esperava — a qualidade do código do Claude realmente melhorou. Menos contexto contraditório significou output mais coerente.
Há um detalhe estrutural que vale mencionar. Boris aproveita a hierarquia do CLAUDE.md: um arquivo no nível raiz para regras de todo o projeto e arquivos no nível de diretório para contexto específico de subsistemas. Seu diretório /api ganha suas próprias regras focadas sem inflar o arquivo raiz. Isso é algo que eu também uso intensivamente, e escala maravilhosamente em monorepos.
Se você está sentado aí com um CLAUDE.md que cresceu para além de 200 linhas, recomendo fortemente a opção nuclear do Boris. Apague. Reconstrua apenas a partir de pontos de dor recentes. O arquivo com que você ficará será menor e melhor.
Loops de verificação — O multiplicador de qualidade 2-3x que ninguém usa
Este é o princípio que, honestamente, me fez sentir um pouco tolo por não ter implementado antes.
A afirmação do Boris é específica: dar ao Claude a capacidade de verificar seu próprio trabalho melhora a qualidade do output em 2-3x. Não "um pouco melhor." Não "um pouco mais confiável." Duas a três vezes melhor. E depois de implementar sua abordagem, acredito que o número é preciso.
O conceito é direto. A maioria das pessoas usa o Claude Code num ciclo de gerar-e-revisar: o Claude escreve código, você lê, identifica problemas, pede correções. Isso funciona, mas coloca toda a carga de qualidade em você. Você é a camada de verificação. E você é humano, o que significa que deixa coisas passarem — especialmente durante sessões longas quando a atenção diminui.
A abordagem do Boris inverte isso. Ele dá ao Claude as ferramentas e instruções para verificar seu próprio output antes de apresentá-lo como pronto. Dois passos:
- Dê ao Claude um método para verificar seu trabalho (uma suite de testes, uma visualização no navegador, um comando de linting, um verificador de tipos)
- Informe o Claude explicitamente sobre esse método (no CLAUDE.md ou no prompt)
A implementação prática varia dependendo do que você está construindo. Para uma aplicação web, pode significar dizer ao Claude: "Após fazer alterações, execute a suite de testes e abra o navegador para confirmar visualmente que a UI corresponde ao requisito." Para um endpoint de API: "Após implementar, execute o teste de integração e confirme que a estrutura da resposta corresponde ao schema." Para geração de conteúdo: "Após escrever, revise contra o documento de diretrizes da marca em /docs/style-guide.md."
Boris vai um passo além — ele adiciona prompts de verificação diretamente ao seu arquivo CLAUDE.md. Algo como:
Before marking any task as complete, propose a verification plan.
Describe what you'll check and how you'll confirm correctness.
Then execute that plan.
Essa única regra, adicionada ao seu arquivo de instruções, força o Claude a pensar sobre verificação antes de começar a construir. E muda o output dramaticamente. O Claude começa a sugerir casos de teste nos quais você não havia pensado. Ele detecta casos extremos durante a implementação em vez de depois. Executa verificações de tipo e linters proativamente em vez de esperar você pedir.
Adicionei essa regra ao meu próprio CLAUDE.md há oito dias. Nesse período, tive exatamente duas instâncias onde o Claude submeteu código com um bug que eu não detectei durante a revisão. Nos oito dias antes de adicionar a regra, o número estava mais próximo de nove ou dez. Amostra pequena, com certeza. Mas a mudança direcional é inconfundível.
O insight principal aqui é que o Claude não carece da capacidade de verificar — carece da instrução de verificar. Deixado em seus padrões, o Claude otimiza para velocidade e conclusão. Ele quer te dar uma resposta. A verificação atrasa isso, então ele a pula a menos que você a construa explicitamente no fluxo de trabalho. A genialidade do Boris é reconhecer que uma linha no CLAUDE.md desbloqueia uma capacidade que sempre esteve lá, mas inativa.
Isso se conecta com algo mais amplo sobre como penso sobre as skills de agente do Claude Code — as melhores configurações não adicionam novas capacidades à IA. Elas ativam capacidades que a IA já tem mas não usa por padrão. A verificação é o exemplo mais impactante desse padrão.
Multiplique-se — Sessões paralelas que realmente funcionam
Boris executa 5 instâncias do Claude Code localmente em seu terminal e outras 5-10 no site da Anthropic. Simultaneamente. Em tarefas diferentes.
Quando ouvi isso pela primeira vez, minha reação foi "isso parece caótico." Múltiplas sessões de IA trabalhando na mesma base de código? Isso é uma receita para conflitos de merge, alterações contraditórias e código que não se integra.
Exceto que Boris não as executa na mesma tarefa. Cada sessão recebe um pedaço de trabalho distinto e independente. Uma pode estar construindo um novo endpoint de API. Outra está escrevendo testes para uma funcionalidade existente. Uma terceira está refatorando um módulo de utilitários. Uma quarta está investigando um relatório de bug. Nunca se sobrepõem. Nunca tocam os mesmos arquivos. Rodam em paralelo porque podem — o trabalho é naturalmente particionado.
O truque que faz isso funcionar no nível prático: cada sessão local usa seu próprio git checkout em vez de branches ou worktrees dentro do mesmo repositório. Isso elimina conflitos do sistema de arquivos completamente. Cada instância do Claude pensa que está trabalhando num projeto independente. Sem arquivos de lock brigando entre si. Sem alterações meio escritas em diretórios compartilhados.
Para sessões remotas, Boris as inicia com & pela CLI e às vezes usa --teleport para mover sessões entre seu terminal e a interface do navegador. Ele inicia uma sessão antes de dormir, e ela estará esperando com um pull request completo quando ele verificar pela manhã.
Escalei para rodar três sessões paralelas — meu hardware e capacidade de atenção ainda não estão no nível do Boris — e mesmo nessa escala modesta, a diferença de produtividade é significativa. Três tarefas independentes que me custariam 45 minutos cada em série são completadas em aproximadamente 50-55 minutos no total. Não é paralelismo perfeito, mas é próximo o suficiente para mudar fundamentalmente como planejo meu dia de trabalho.
Há um benefício mais sutil que Boris menciona e que confirmei por experiência: sessões novas trazem perspectivas novas. Quando você está imerso numa sessão que vem trabalhando num problema por 30 minutos, a janela de contexto está cheia das suposições e abordagens falhas anteriores daquele problema. Iniciar uma segunda sessão para olhar o mesmo problema — mas do zero — às vezes produz uma solução melhor em menos de cinco minutos porque não carrega a bagagem de tentativas anteriores.
Agora faço isso rotineiramente para bugs difíceis. Se minha primeira sessão não resolveu em 15 minutos, abro uma sessão nova com uma descrição limpa do problema. A sessão nova resolve aproximadamente metade das vezes. Não porque é mais inteligente — porque não tem peso.
Para quem se interessa pela abordagem de git worktree para sessões paralelas do Claude, escrevi sobre isso com mais detalhes no meu guia de Claude Code git worktrees agentes paralelos. A versão curta: worktrees te dão diretórios de trabalho isolados a partir de um único repositório, o que é levemente mais eficiente que clones completos mas atinge o mesmo objetivo que Boris descreve.
Sistematize loops internos — Slash commands como memória muscular
Aqui é onde o fluxo de trabalho do Boris muda de "indivíduo produtivo" para "sistema de produção."
Todo desenvolvedor tem loops internos — as tarefas que você repete várias vezes por dia. Rodar testes. Gerar boilerplate. Criar pull requests. Formatar revisões de código. Escrever mensagens de commit. Atualizar documentação. Essas tarefas não são complexas individualmente, mas se acumulam. Se você gasta 3 minutos em cada uma e faz vinte por dia, isso é uma hora de trabalho repetitivo.
Boris automatiza esses com slash commands e skills do Claude Code. Não ocasionalmente. Obsessivamente. Cada fluxo de trabalho que ele faz mais de duas vezes se torna um comando.
A analogia que ele usa é perfeita: prompts regulares são como dizer a um jogador de basquete "drible a bola pela quadra, procure um companheiro livre e passe se vir um." Slash commands são jogadas específicas — sequências precisas executadas da mesma forma toda vez. "Pick and roll pela ala esquerda." Sem ambiguidade. Sem variação. Apenas execução.
No Claude Code, slash commands ficam em .claude/commands/ como arquivos markdown. Cada arquivo descreve um fluxo de trabalho específico. Quando você digita /meu-comando, o Claude lê o arquivo e executa aquele fluxo de trabalho. Sem re-explicar. Sem preâmbulo de "aqui está o que preciso que você faça...". Apenas o gatilho e o resultado.
O verdadeiro golpe de mestre do Boris é pedir ao próprio Claude que sugira quais comandos ele deveria criar:
Based on this project, what Claude skills should I create?
Look at my recent git history, my CLAUDE.md, and the types
of changes I make most frequently. Suggest 5-7 slash commands
that would automate my most common workflows.
Rodei esse prompt num dos meus projetos e o Claude sugeriu sete comandos. Cinco deles eram fluxos de trabalho que eu fazia manualmente todos os dias. Dois eram fluxos de trabalho nos quais eu nem tinha pensado em automatizar porque envolviam múltiplos passos em diferentes ferramentas. Construí todos os sete, e a economia de tempo se acumula diariamente.
A diferença chave entre um slash command e um prompt salvo é a durabilidade. Prompts vivem na sua área de transferência ou num arquivo de notas. Se perdem, são editados inconsistentemente e esquecidos. Slash commands vivem no seu repositório. São versionados. São compartilhados com sua equipe via git. Quando você melhora um fluxo de trabalho, todos recebem a melhoria no próximo git pull.
Skills vão um passo além — não são apenas comandos que você dispara, mas capacidades que o Claude pode invocar autonomamente durante o raciocínio. Uma skill com o frontmatter YAML correto ativa automaticamente quando o Claude encontra uma situação relevante. "Quando o usuário pedir um relatório de status, use este fluxo de trabalho." "Quando gerar um endpoint de API, siga este template." É a diferença entre ter um livro de receitas e ter um chef que já conhece todas as receitas.
Para um mergulho mais profundo na criação de Claude Skills eficazes, meu guia de Claude Skills cobre a estrutura YAML, os cinco padrões que realmente importam, e os erros que cometi durante minha primeira semana construindo-as. A abordagem do Boris confirma o que descobri independentemente: comece com os fluxos de trabalho que mais repete, automatize esses primeiro, e deixe a complexidade crescer organicamente.
Construa para o futuro — A lição amarga aplicada ao seu fluxo de trabalho
Este é o princípio que une tudo, e é o mais filosófico das seis estratégias do Boris. Mas não pule — é o que vai te salvar de uma armadilha na qual vi dezenas de desenvolvedores caírem.
Boris referencia o famoso ensaio de Rich Sutton de 2019, "The Bitter Lesson", que argumenta que na história da pesquisa em IA, métodos gerais que aproveitam computação sempre acabaram superando abordagens baseadas em conhecimento específico de domínio projetado por humanos. Toda vez que pesquisadores tentaram codificar inteligência manualmente — livros de aberturas de xadrez, regras de reconhecimento de fala, gramáticas de tradução — foram eventualmente vencidos por sistemas que simplesmente aprenderam de quantidades massivas de dados.
Boris aplica isso aos fluxos de trabalho do Claude Code: não sobre-engenhare seus prompts ou scaffolding. O modelo está melhorando rápido. Aquela cadeia de prompts elaborada na qual você gastou três dias aperfeiçoando? Em seis meses, uma simples instrução de uma frase produzirá melhores resultados porque o modelo melhorou tanto.
Eu vi isso em primeira mão. Técnicas que documentei no início de 2025 para fazer o Claude produzir TypeScript limpo — instruções de formatação específicas, padrões de exemplo, anotações de tipo explícitas no prompt — agora são desnecessárias. O Claude gera TypeScript limpo por padrão. As horas que gastei nesses prompts foram esforço desperdiçado, investido em infraestrutura que as melhorias do modelo tornaram obsoleta.
O conselho prático do Boris: foque em alimentar o modelo com dados e contexto de qualidade em vez de otimizar engenharia de prompts. Seu tempo é melhor investido numa base de código bem estruturada com convenções de nomenclatura claras, testes abrangentes e boa documentação do que em aperfeiçoar o mega-prompt de dezessete passos que força o Claude a escrever código do jeito que você quer. Porque o Claude vai aprender a escrever código do jeito que você quer. Seu trabalho é garantir que ele tenha o contexto certo — não as restrições certas.
Isso conecta de volta com a filosofia do CLAUDE.md mínimo. Um arquivo de instruções de 500 linhas é sobre-engenharia para as limitações do modelo atual. Um arquivo de 100 linhas focado em correções específicas do projeto continuará relevante mesmo quando o modelo melhorar, porque ensina ao Claude coisas que ele genuinamente não pode saber sem ser informado — as convenções da sua equipe, as peculiaridades do seu projeto, os requisitos específicos do seu domínio de negócio.
Boris enquadra como uma pergunta de onde investir sua hora marginal. Você poderia gastá-la em:
- Opção A: Refinar um prompt até que o Claude gere código levemente melhor agora
- Opção B: Melhorar sua base de código, sua cobertura de testes ou seu CLAUDE.md com uma correção que renderá por meses
A Opção B vence sempre. E vence por uma margem maior a cada atualização do modelo, porque quanto melhor o modelo fica, menos a engenharia de prompts importa e mais a qualidade do contexto importa.
Reestruturei minha própria abordagem de acordo. Quando me pego ajustando um prompt pela terceira vez, paro e pergunto: "Isso é um problema de prompt ou um problema de contexto?" Quase sempre é contexto. A base de código é ambígua. A suite de testes não cobre o caso extremo. O CLAUDE.md está faltando uma convenção crítica do projeto. Corrija o contexto, e o prompt pode permanecer simples.
O que mudou no meu próprio fluxo de trabalho
Depois de duas semanas implementando os seis princípios do Boris, aqui está o que mudou.
Minhas sessões são mais curtas. Não porque faço menos — porque a fase de planejamento elimina os falsos começos que costumavam consumir 30-40% do meu tempo de sessão. Eu costumava gastar 90 minutos numa funcionalidade com 30 minutos sendo "não, não é isso que eu quis dizer, deixa eu re-explicar." Agora o prompt de entrevista detecta o desalinhamento nos primeiros cinco minutos.
Meu CLAUDE.md tem 87 linhas. Caiu de quase 500. E minha qualidade de output foi para cima, não para baixo. Menos instruções, menos confusão, código mais coerente. Eu o reviso semanalmente e me faço duas perguntas: "O Claude cometeu esse erro recentemente?" e "O Claude cometeria esse erro sem esta regra?" Se a resposta para qualquer uma é não, a regra é removida.
Rodo três sessões paralelas diariamente. Uma para a funcionalidade principal que estou construindo. Uma para testes e documentação. Uma para investigação de bugs ou refatoração. Não interferem entre si. Não compartilham contexto. E o throughput combinado é aproximadamente 2,5x o que eu fazia em série.
Cada fluxo de trabalho que repeti três vezes agora é um slash command. Tenho catorze distribuídos pelos meus projetos principais. A economia de tempo parece pequena individualmente — talvez 2-3 minutos cada — mas com vinte invocações por dia, isso é quase uma hora recuperada. Uma hora que gasto no trabalho que realmente requer julgamento, não execução.
E parei de otimizar prompts. Quando o Claude produz output ruim, corrijo o contexto: atualizo o CLAUDE.md, melhoro a base de código, adiciono um teste faltante. Não escrevi um "prompt melhor" em dez dias. Escrevi código melhor. E o output da IA melhorou como resultado.
A implicação desconfortável
Há algo na abordagem do Boris que vale a pena refletir — algo que a maioria dos criadores de conteúdo sobre Claude Code (eu incluído) tende a contornar.
Os seis princípios acima não são complexos. Planeje antes de construir. Mantenha instruções mínimas. Deixe a IA verificar seu próprio trabalho. Execute tarefas em paralelo. Automatize fluxos de trabalho repetitivos. Aposte que o modelo vai melhorar.
Nada disso requer sofisticação técnica. Um desenvolvedor júnior pode implementar todos os seis no primeiro dia. A barreira não é conhecimento — é ego. Planejar parece lento quando você quer começar a construir. Apagar seu CLAUDE.md de 500 linhas cuidadosamente elaborado parece jogar trabalho fora. Confiar no Claude para verificar seu próprio output parece abrir mão do controle. Rodar sessões paralelas parece perder o fio da meada.
Os resultados do Boris sugerem que os desenvolvedores que prosperarão com programação assistida por IA não são os com os prompts mais engenhosos. São os dispostos a mudar como pensam sobre o trabalho em si. A tratar a IA não como uma máquina de escrever mais rápida, mas como um colaborador que precisa de direção clara, contexto limpo e autonomia para verificar seu próprio trabalho.
A pessoa que construiu a ferramenta está nos dizendo exatamente como usá-la. E seu conselho não é "use mais recursos" ou "escreva prompts melhores." Seu conselho é: planeje mais, configure menos, verifique tudo, e confie que a ferramenta vai continuar melhorando.
Estou há duas semanas com essa abordagem. Meu output subiu. Minha frustração caiu. E pela primeira vez desde que comecei a usar o Claude Code, sinto que estou trabalhando com a ferramenta em vez de lutando para controlá-la.
Se você tentar uma coisa deste artigo hoje, que seja o prompt de entrevista. Abra sua próxima sessão do Claude Code no plan mode e cole isso antes de qualquer outra coisa:
Interview me about this. What core problems does this solve?
Who is this for? What does success look like? What should this
NOT do? Summarize it back to me before writing any code.
Responda as perguntas do Claude honestamente. Observe como ele resume sua intenção de volta para você. Detecte o desalinhamento antes de uma única linha de código existir. E então me diga que cinco minutos não valeram a pena.
Perguntas frequentes
Quem é Boris Cherny e qual é seu papel na Anthropic?
Boris Cherny é o criador e chefe do Claude Code na Anthropic. Ele construiu o protótipo original baseado em terminal e agora lidera a equipe que o desenvolve. Ele envia 10-30 pull requests diários sem escrever código manualmente, usando sua própria ferramenta para todo o trabalho de desenvolvimento. Para contexto sobre a ferramenta em si, veja meu tutorial do Claude Code para iniciantes.
Como ativo o plan mode no Claude Code?
Pressione Shift+Tab duas vezes no terminal do Claude Code para ativar o plan mode. O Claude então analisará arquivos e proporá abordagens sem escrever código ou executar comandos. Você também pode usar o comando /plan no Claude Code v2.1.0 ou posterior. Veja "Vá devagar para ir rápido" acima para o fluxo de trabalho completo.
Qual deve ser o tamanho do meu arquivo CLAUDE.md?
Boris Cherny mantém o dele em aproximadamente 100 linhas (cerca de 2.500 tokens). O arquivo deve conter apenas regras que corrigem erros recorrentes — sem documentação, explicações de arquitetura ou padrões de codificação que o Claude já conhece. Remova regras que não foram relevantes nas últimas duas semanas. Para uma análise completa, veja meu guia de 50 dicas do Claude Code.
Posso rodar múltiplas sessões do Claude Code ao mesmo tempo?
Sim. Boris roda 5 sessões localmente e 5-10 no navegador simultaneamente. A chave é dar a cada sessão trabalho independente em checkouts de git separados para evitar conflitos de arquivo. Inicie sessões remotas com & pela CLI e use --teleport para mover sessões entre terminal e navegador.
O que são slash commands do Claude Code e como os crio?
Slash commands são templates de fluxo de trabalho reutilizáveis armazenados como arquivos markdown em .claude/commands/. Digite /nome-do-comando para ativá-los. Crie um escrevendo um arquivo markdown que descreva os passos do fluxo de trabalho e salve-o no diretório de commands. Pergunte ao Claude: "Quais slash commands eu deveria criar para este projeto?" para começar.
Vamos trabalhar juntos
Quer construir sistemas de IA, automatizar fluxos de trabalho ou escalar sua infraestrutura tecnológica? Adoraria ajudar.
- Fiverr (desenvolvimento personalizado e integrações): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (soluções empresariais): ramlit.com
- ColorPark (design e branding): colorpark.io
- xCyberSecurity (serviços de segurança): xcybersecurity.io