Un modelo de 295 mil millones de parámetros acaba de plantarle cara a gigantes open-weight de tres a cinco veces su tamaño — y venció a la mayoría en todas partes salvo en un sitio. Esa es la frase a la que no dejaba de volver mientras desmenuzaba el lanzamiento de Tencent Hy3, y replantea por completo la suposición de "cuanto más grande, mejor" sobre la que ha corrido la carrera open-weight desde que DeepSeek V4 Pro lanzó sus 1,6 billones de parámetros.
Este es el número que importa. Hy3 activa solo 21 mil millones de esos 295 mil millones de parámetros en cada token. GLM 5.2 — el modelo que la mayoría de la gente que sigo trata actualmente como el techo del open source — carga con unos 744B totales y quema alrededor de 40B activos por token. Así que Tencent entró en la arena de los modelos de código con un modelo de menos de la mitad del tamaño y aproximadamente la mitad del cómputo por token que el campeón reinante, y el veredicto honesto de los benchmarks es: pierde la corona del código por unos pocos puntos y gana casi todo lo demás. El titular de VentureBeat lo dijo mejor que yo — Hy3 "se enfrenta a GLM-5.2 con la mitad del tamaño, y gana en todas partes excepto en código".
Esta reseña de Tencent Hy3 es mi intento de responder a la única pregunta que importa si eres builder: ¿deberías realmente meter esto en tu caja de herramientas antes de que se cierre la ventana gratuita el 21 de julio y, de ser así, para qué? Porque la historia del leaderboard y la historia de usarlo un martes cualquiera son dos cosas muy distintas, y la mayor parte de la cobertura que leí esta semana solo contó la primera.
Lo que verifiqué, y lo que transmito de segunda mano
Antes de la parte divertida, una línea sobre cómo leer este artículo, porque cambia cuánto peso darle a cada afirmación.
Los datos duros los contrasté con fuentes primarias. La arquitectura 295B/21B y la licencia Apache-2.0 los saqué de la model card tencent/Hy3 de Tencent; la ventana gratuita y los precios post-promoción, del listado de OpenRouter; las cifras de benchmarks, de las propias tablas de Tencent y de los análisis de terceros que cito sobre la marcha. Esos los afirmaré sin rodeos — señalando a la vez que los benchmarks de Tencent son autorreportados y aún esperan una replicación independiente amplia.
Las pruebas prácticas de construcción son otro animal. El clon de macOS en el navegador, las demos de física, la ciudad 3D — estoy resumiendo y analizando una batería de pruebas documentada que circuló tras el lanzamiento, no afirmando que me senté personalmente a teclear cada prompt. Cuando una cifra depende del proveedor o proviene de ese recorrido en lugar de una tabla primaria, diré "reportado" en vez de disfrazarla de hecho establecido. Exígeme esa distinción; es toda la razón para confiar en una reseña de modelo por encima de otra.
El modelo en sí es real, no vaporware. Tencent liberó Hy3 como open source el 6 de julio de 2026 — el sucesor de producción del preview de Hy3 que dejó caer en abril. Los pesos viven en Tencent-Hunyuan/Hy3 en GitHub y tencent/Hy3 en Hugging Face (con una build Hy3-FP8 al lado), está en OpenRouter ahora mismo, y es Apache-2.0. Esto no es una captura de pantalla filtrada de un benchmark — es un modelo publicado y descargable al que puedes hacerle una llamada de API hoy mismo.
La arquitectura de Hy3, y el truco MoE que lo hace barato
Déjame quitarme de encima el volcado de especificaciones, porque probablemente ya has visto estos números repartidos por una docena de posts de noticias, la mitad de los cuales llamaron al laboratorio "Tenset" o algo igual de enrevesado. Es Tencent — el gigante chino detrás de WeChat — y Hy3 es el miembro más nuevo de su familia de modelos Hunyuan.
Aquí está la arquitectura, verificada contra la propia model card de Tencent:
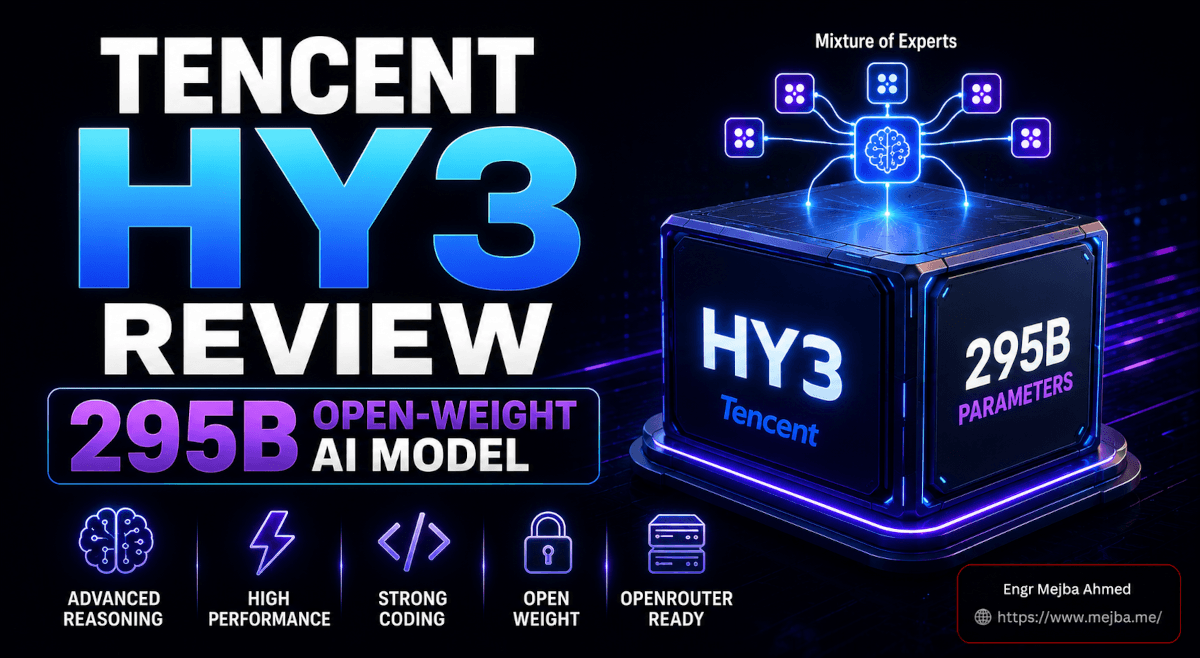
- 295 mil millones de parámetros totales, con 21 mil millones activos por token
- 192 expertos enrutados por capa MoE, más un experto compartido siempre activo, usando enrutamiento top-8 — es decir, solo 8 de esos 192 expertos se disparan en cada token
- Una capa separada de predicción multi-token (MTP) de 3.8B que permite al modelo predecir más de un token por paso de decodificación, lo cual es una palanca real de velocidad, no un adorno de ficha técnica
- Ventana de contexto de 256K tokens (262.144 tokens, para ser exactos)
- Licencia Apache 2.0 — uso comercial completo, y Tencent levantó explícitamente las restricciones geográficas que habían limitado el preview de abril
Esa estructura MoE es todo el truco. Cuando la gente oye "295 mil millones de parámetros" se imagina un modelo que cuesta el cómputo de 295 mil millones de parámetros para ejecutarse. No es así. El router despierta una franja estrecha — 8 expertos, ~21B parámetros — para tu token específico, y los otros 171 expertos siguen dormidos. Pagas por la franja, no por el cerebro entero. Por eso un modelo tan capaz puede tener el precio de uno mucho más pequeño, y es la misma apuesta arquitectónica que DeepSeek, GLM, MiniMax y Kimi llevan tiempo haciendo. Si quieres la mecánica más profunda de cómo el enrutamiento disperso colapsa el coste de inferencia, la desarrollé en detalle en mi reseña de DeepSeek V4 Pro — la historia del enrutamiento allí aplica casi uno a uno aquí, solo que a una fracción del tamaño total.
Tencent también incorporó algo que ojalá más laboratorios incluyeran: esfuerzo de razonamiento configurable. Hy3 arranca por defecto en un modo rápido "sin pensar", y luego ofrece modos de razonamiento bajo y alto que activas para lo difícil — un refactor enrevesado, una demostración matemática, una cadena de agentes de varios pasos. No estás pagando la sobrecarga de tokens de razonamiento en un prompt que solo necesita una respuesta rápida. Anthropic, OpenAI y Google han convergido todos en alguna versión de esto, y verlo en un modelo open-weight a este precio es una auténtica mejora de calidad de vida.
Los objetivos de diseño declarados son razonamiento, flujos de trabajo agénticos y de varios pasos, código y — la frase que Tencent no deja de repetir — "despliegue en producción en el mundo real". Tencent también afirma mejoras medibles en anti-alucinación, tool-calling más fiable, datos de post-entrenamiento de mayor calidad y más pasos de RL que la generación anterior. Esas últimas cuatro son el tipo de afirmaciones que no puedes verificar desde una ficha técnica; aparecen (o no) en cómo se comporta el modelo en el trabajo real. Que es donde entran las pruebas.
Pero primero, el número por el que la gente realmente abre estos artículos.
¿Cuánto cuesta ejecutar Tencent Hy3?
Gratis. Hasta el 21 de julio de 2026, Hy3 corre a $0 en la ruta tencent/hy3:free de OpenRouter, y Nous Research abrió acceso gratuito en su portal a las pocas horas del lanzamiento. Esa es la respuesta corta, digna de snippet.
Cuando se cierre la ventana promocional, sigue siendo barato — y aquí quiero corregir un número que vi repetido por la web. Parte de la cobertura temprana lanzó una cifra independiente más alta, pero el propio listado de OpenRouter fija el precio de Hy3 en aproximadamente $0.14 por millón de tokens de entrada y $0.58 por millón de tokens de salida, con los distintos proveedores de inferencia del marketplace llegando hasta alrededor de $0.20 en entrada. OpenRouter es un marketplace: el número exacto que pagas depende de qué proveedor atienda tu petición y qué modo de enrutamiento elijas. Pero cada ruta que pude comprobar realmente se situaba en ese mismo vecindario barato, así que toma $0.14/$0.58 como la tarifa vigente y no te alejarás mucho.
Pon eso frente a la tarifa actual de Claude Opus 4.8 — $5 por millón de entrada, $25 por millón de salida — y la diferencia es abismal. Los tokens de salida de Hy3 quedan en torno a 40 veces más baratos que Opus. La brecha de calidad en la cima absoluta es real y no voy a fingir que no lo es. Pero "40 veces más barato y casi igual de bueno" cambia las cuentas para un montón de cargas de trabajo, especialmente las de alto volumen y bajo riesgo donde de todos modos nunca ibas a pagar precios de frontera.
También hay una vía gratuita fuera de OpenRouter — Hy3 ha estado disponible para probar a través del portal de benchmarks de Nous con cuentas gratuitas, una forma de baja fricción de darle una vuelta antes de conectar una API key. Si ya ejecutas modelos a través de OpenRouter, mi guía para ejecutar modelos gratis en Claude Code vía OpenRouter cubre la configuración exacta — Hy3 encaja en ese mismo flujo de trabajo mientras la ventana gratuita esté abierta.
Ahora bien, ¿el rendimiento justifica la expectación? En parte. Déjame mostrarte el reparto honesto.
Los benchmarks: dónde gana Hy3, y el único sitio donde no
Quiero ser cuidadoso aquí porque las tablas de benchmarks son exactamente donde estos lanzamientos se sobrevenden. Así que separaré lo que Tencent y terceros reportaron, y señalaré la única comparación que realmente decide si este modelo pertenece a tu stack de código. Primero una advertencia general: todo lo que sigue es reportado por Tencent o por cobertura temprana de terceros, y la replicación independiente todavía está poniéndose al día.
En ciencia y razonamiento, Hy3 es genuinamente fuerte. Reporta 90.4 en GPQA Diamond y 72.0 en USAMO 2026, con IMOAnswerBench en 90.0 y HLE-con-herramientas en 53.2. La cobertura de Gigazine recogió la afirmación de Tencent de que Hy3 es comparable a GLM-5.2 y DeepSeek-V4 en su clase de tamaño y supera a GPT-5.5 en tareas científicas. En una evaluación ciega reportada con 270 expertos humanos, Hy3 obtuvo 2.67 sobre 4, superando por poco a GLM-5.1 con 2.51. Para un modelo de la mitad del tamaño del líder open-weight, esos no son números modestos.
En búsqueda agéntica, va por delante de toda su categoría de peso. Las cifras reportadas sitúan a Hy3 en 84.2 en BrowseComp y 91.0 en DeepSearchQA — por delante de cualquier otro modelo abierto en la propia tabla de Tencent, y competitivo con Claude Opus 4.8 y GPT-5.5. Si tu carga de trabajo son agentes de investigación, navegación intensiva en herramientas o recuperación de largo horizonte, esta es la parte de la historia que debería hacerte prestar atención.
Y luego está el código — el único sitio donde pierde. Aquí está el cara a cara contra GLM 5.2, que la mayoría trata como el SOTA de código en open source:
| Benchmark | Hy3 (reportado) | GLM 5.2 (reportado) |
|---|---|---|
| SWE-bench Verified | 78.0 | 84.2 |
| SWE-bench Multilingual | 75.8 | 83.0 |
| Terminal-Bench 2.1 | 71.7 | 81.0 |
| DeepSWE | 28.0 | 46.2 |
GLM 5.2 gana la suite de código, limpiamente, y por un margen amplio específicamente en DeepSWE. El vídeo fuente que analicé citaba un panorama algo más halagüeño — Hy3 superando por poco a DeepSeek V4 Pro en una métrica "Swaybench Pro" con 57.9 frente a 55.4, y casi paridad en multilingüe con 75.8 frente a 76.2. Interpreto "Swaybench" como SWE-bench mal oído, y trataría esas cifras específicas del cara a cara contra DeepSeek como reportadas-desde-la-fuente en lugar de confirmadas de forma independiente. Lo que sí puedo alinear con las tablas primarias es la forma del asunto: Hy3 compite respetablemente con DeepSeek V4 en código, y va por detrás de GLM 5.2. Ese 75.8 multilingüe aparece tanto en el vídeo como en los datos publicados, así que al menos ese ancla se sostiene.
Este es el replanteamiento que hizo que me encajara. Que Hy3 vaya por detrás de GLM 5.2 en código mientras lo supera en razonamiento, ciencia y búsqueda agéntica — con el 40% de los parámetros — no es una derrota. Es un modelo haciendo una apuesta distinta. GLM 5.2 es el especialista puro en código. Hy3 es el generalista eficiente que además resulta ser muy bueno en código. Si ese intercambio te conviene depende por completo de lo que estés construyendo. Si quieres el desglose completo de cómo se compara GLM 5.2 con la frontera, lo sometí a cinco builds one-shot en mi prueba de GLM 5.2 vs Qwen 3.7 Max vs Claude Opus 4.8 — vale la pena leerla junto a esta si el código es tu caso de uso principal.
Pero los benchmarks son el mapa, no el territorio. El territorio es lo que pasa cuando apuntas un modelo a un build real y pulsas enter.
La fortaleza real con la que nadie abre: front-end y SVG
Aquí es donde la batería de pruebas reportada se puso genuinamente interesante, y donde creo que la mayor parte de la cobertura del lanzamiento enterró el titular. Lo destacado de Hy3 no es su puntuación en GPQA. Es el scaffolding de front-end.
A lo largo de las pruebas documentadas, Hy3 produjo UI de front-end bien estructurada y visualmente atractiva de una forma que sigue siendo poco común en modelos open-weight. No "funcional pero feo", que es el resultado habitual del front-end open-weight. Realmente bonito — echó mano de paquetes de animación reales, interacciones activadas por scroll, efectos de fondo, diseños de cursor personalizados, tipografía cuidada. El tipo de pulido al que normalmente tienes que empujar a un modelo tres o cuatro veces, y que a menudo tienes que delegar a Claude o a un modelo de frontera para que salga bien.
Eso importa porque el front-end es donde vive gran parte del trabajo pesado diario de shippear, e históricamente es donde los modelos open-weight hacen el ridículo. Un modelo que puede montar de una sola vez una landing page o una librería de componentes con un aspecto genuinamente bueno te ahorra la parte más tediosa del build. En este eje, las pruebas reportadas ponen a Hy3 en la misma conversación que GLM 5.2 como herramienta de scaffolding de front-end — lo cual, dado el diferencial de tamaño y coste, es una afirmación seria.
El clon de macOS. La demo insignia fue un clon de macOS en el navegador con apps de aspecto nativo — Finder, Safari, Terminal, Notas, Ajustes, App Store, Mapas — iconos SVG animados, e incluso un minijuego FPS 3D incrustado dentro. La lectura honesta: disparar y moverse funcionaba, los controles eran toscos, algunas de las barras de sistema superior e inferior no estaban del todo conectadas, y el panel de Ajustes podía cambiar visualmente el fondo de pantalla y la posición del dock pero en realidad no persistía el cambio. Así que — scaffolding impresionante, ejecución imperfecta. Es una demo de "mira lo que produjo un solo prompt", no un producto listo para shippear. Pero como prueba de estrés de cuánta estructura coherente puede mantener el modelo en la cabeza a lo largo de todo un sistema operativo falso, es una actuación sólida.
El trabajo con SVG es donde sobresale en silencio. En las pruebas documentadas, Hy3 generó una escena pictórica realista con luciérnagas y profundidad atmosférica, y un SVG de mariposa animado y simétrico con degradados correctos — animación que el prompt ni siquiera pedía explícitamente. La generación limpia de código SVG con animación de buen gusto es una habilidad específica y difícil de fingir, y es uno de los hilos más fiables de toda la batería. Si generas mucha iconografía, ilustraciones o motion ligero, esta es una razón real para probar el modelo.
Si estás evaluando modelos open-weight exactamente para este tipo de trabajo de front-end y con carga de diseño, vale la pena poner a Hy3 junto a los otros contendientes recientes — hice un primer vistazo a MiniMax M3 como modelo open-weight que sirve como punto de comparación útil para el mismo trabajo.
Las pruebas 3D y de juegos: rápido, limpio, no del todo frontera
La batería reportada empujó más hacia el 3D y la simulación, y aquí es donde la imagen honesta del techo de Hy3 se enfoca. Es rápido y limpio. No es de primer nivel en calidad de generación bruta. Ambas cosas son ciertas.
Los visualizadores 3D aguantaron bien. Un visualizador HTML de la Tierra girando se comparó contra Opus 4.8 y Fable 5. Fable 5 salió el más fotorrealista — sin sorpresas, es su especialidad — pero Hy3 según lo reportado superó visualmente a Opus 4.8 en atractivo, que no es una frase que esperaba escribir sobre un modelo tan barato. Un explorador 3D del sistema solar logró un campo de estrellas real, sombreado y sombras de planetas creíbles, una cámara funcional y planetas reconocibles — Neptuno, Júpiter, Saturno, todos identificables. El enfoque sobre un planeta necesitaba clics repetidos para activarse, así que la interacción era tosca, pero el renderizado en sí era sólido.
Las demos de física son la historia de eficiencia en miniatura. En una comparación de tres demos de física en canvas HTML5 — bolos, air hockey y una apertura de billar — Hy3 se midió contra Gemini 3.5 Flash, GLM 5.2 y DeepSeek V4. El resultado reportado: Hy3 usó unos 30k tokens por una fracción de céntimo e igualó la calidad de Gemini 3.5 a una pequeña fracción del coste. Gemini alcanzó calidad similar con ~23k tokens pero mucho más caro; GLM 5.2 (~25k tokens) produjo la lógica y código puros más fuertes; DeepSeek V4 usó ~50k tokens y salió el más débil de los cuatro. Las colisiones de Hy3 eran limpias, su efecto y momento creíbles, la simulación pulida. Esa línea de "calidad comparable por una esquirla del coste" es toda la propuesta de valor comprimida en una sola prueba.
En las tareas 3D pesadas, el techo se hizo visible. Una ronda final enfrentó a Hy3 con Fable 5, Opus 4.8 y Sonnet 5 en tres builds exigentes: una ola oceánica derrumbando un castillo de arena, una línea de montaje de fábrica y una ciudad 3D interactiva sobre un setup moderno de Three.js. Hy3 según lo reportado terminó el más rápido con salida limpia y pulida — Fable 5 fue el más fotorrealista, Sonnet 5 de alta calidad pero más lento, y Opus 4.8 quedó último y, notablemente, menos atractivo visualmente que Hy3. Pero la velocidad vino con compromisos: Hy3 usó física aproximada en lugar de una simulación completa, la lógica de la fábrica tenía bugs menores, y la ciudad 3D parecía convincente pero no estaba muy optimizada. Competitivo en velocidad y eficiencia; un paso por detrás de la cima en calidad bruta.
Esa es la forma honesta del asunto. Hy3 te lleva la mayor parte del camino, más rápido y más barato que casi cualquier otra cosa, y luego te pide que cierres tú el último tramo. Para una enorme cantidad de cargas de trabajo reales, es un intercambio fantástico.
Si prefieres no armar tú mismo esta evaluación y configuración — elegir el modelo open-weight adecuado para cada carga de trabajo, conectarlo a un arnés de agentes y saber dónde se rompe cada uno — no tienes por qué. Ese tipo de trabajo de construcción e integración de IA es lo que hago con clientes habitualmente.
Hablando claro: los límites, y para quién es esto realmente
Toda reseña de modelo que se salta las limitaciones es marketing. Aquí es donde yo le pararía los pies al hype.
La ventana de contexto de 256K es la restricción real. En un mundo donde GLM 5.2 y DeepSeek V4 anuncian un millón de tokens, 256K es genuinamente limitante para ciertos trabajos. Si le estás dando a un modelo una base de código grande entera, un documento del tamaño de un libro o una tarea agéntica extensa de múltiples archivos, chocarás con el techo de Hy3 antes que con el de sus rivales más grandes. Para la mayoría del prompting del día a día — una feature, un componente, un refactor acotado, una tarea de investigación — 256K sobra. Pero conoce tu carga de trabajo. Si el contexto largo es tu cuello de botella, este no es tu modelo, y ningún ahorro de costes cambia eso.
El código es una debilidad real y medida frente a GLM 5.2. Lo dije en los benchmarks y lo diré sin rodeos aquí: si tu máxima prioridad es el código agéntico puro y quieres la mejor opción open-weight, GLM 5.2 sigue ganando esa pelea específica. Hy3 es competitivo — intercambia golpes con DeepSeek V4 en código — pero "competitivo" no es "el mejor". Elige Hy3 para código cuando el ahorro de costes y la velocidad te importen más que exprimir los últimos puntos de corrección. Elige GLM 5.2 cuando la corrección lo sea todo.
Las demos son demos. El clon de macOS, los juegos, la ciudad 3D — son escaparates de scaffolding, y cada uno de ellos tenía asperezas cuando realmente lo tocabas. Controles que funcionaban a medias, ajustes que no persistían, física aproximada. Esto es normal para la generación one-shot y no es una crítica exclusiva de Hy3. Solo no confundas una captura impresionante con un producto terminado. Vas a tener que limpiar.
Entonces, ¿para quién es Hy3 realmente? Si tuviera que escribir la recomendación en un post-it: es para trabajo de front-end y con carga de diseño, búsqueda agéntica, tareas de razonamiento y ciencia, y cargas de trabajo de alto volumen donde el coste y la velocidad pesan más que exprimir los últimos puntos de precisión en código. Es un segundo modelo soberbio en un setup multi-modelo — el generalista barato y rápido al que enrutas la mayor parte del trabajo, mientras mantienes un modelo de frontera en reserva para los trabajos que genuinamente lo necesitan. Ejecutar modelos exactamente de esa forma híbrida es algo sobre lo que ya he escrito, en mi flujo de trabajo híbrido de programación con IA con DeepSeek V4 y Claude Code — Hy3 encaja en ese mismo patrón como el caballo de batalla de bajo coste.
Qué esperar realmente si lo pruebas
Déjame fijar expectativas realistas, porque prefiero que entres calibrado a que salgas decepcionado.
Apunta Hy3 a un scaffold de front-end, una ilustración SVG, una landing page, una tarea intensiva en razonamiento o investigación, o una demo 3D o de física de complejidad media, y deberías esperar una salida limpia, rápida y genuinamente atractiva — a menudo al primer intento, ocasionalmente necesitando un empujón. Espera que el coste sea tan bajo que deje de contar en tus decisiones. Espera que la velocidad supere directamente a la mayoría de los modelos de frontera.
Apúntalo a una base de código gigante, un refactor agéntico sutil de múltiples archivos, o una tarea donde la corrección tiene que ser perfecta, y espera o bien chocar con el techo de 256K o encontrarte deseando haber usado GLM 5.2 o un modelo de frontera. Espera que las demos que construyas necesiten limpieza antes de que las toque alguien que no seas tú.
El patrón en todo lo que revisé es consistente: Hy3 golpea dramáticamente por encima de su cuenta de parámetros, entrega código usable y razonamiento fiable, y solo muestra su tamaño en el extremo más alto de dificultad. Para un modelo de 295B con precio de juguete, eso no es solo impresionante — es una señal de hacia dónde va la carrera open-weight. Tencent no lanzó el modelo más grande. Lanzó uno de los más eficientes, y la eficiencia es el eje que de verdad llega a tu bolsillo.
La ventana se cierra el 21 de julio
De vuelta a esa frase inicial — un modelo de menos de la mitad del tamaño del líder open-weight, ganando casi en todas partes excepto en código. Hace un mes eso habría sonado a fantasía de nota de prensa. Esta semana es una realidad descargable, Apache-2.0 y gratuita para probar, con los benchmarks y los repos para respaldar la mayor parte.
La única cosa concreta que haría en los próximos días: levanta Hy3 mientras es gratis — a través de la ruta gratuita de OpenRouter o el portal de Nous — y lánzale tu trabajo real. No las demos. Tu scaffold de front-end real, tu agente de investigación real, tu lote de SVG real. Veinte minutos de pruebas en tareas que ya entiendes te dirán más que todas las tablas de benchmarks de este post, la mía incluida. El periodo gratuito promocional termina el 21 de julio, y después pagas — casi nada todavía, pero pagas.
Porque toda la oleada open-weight sigue demostrando lo mismo, un lanzamiento tras otro: el modelo que cambia tu flujo de trabajo normalmente no es el más grande ni el más alto en un leaderboard. Es el que es lo bastante bueno, lo bastante rápido y lo bastante barato como para que dejes de pensar en el coste y simplemente construyas. Hy3 tiene una posibilidad real de ser ese modelo para ti. Tienes unas dos semanas para averiguarlo gratis.
Preguntas frecuentes
¿Qué es Tencent Hy3?
Tencent Hy3 es un modelo de IA open-weight de Mixture-of-Experts con 295 mil millones de parámetros, lanzado el 6 de julio de 2026 bajo licencia Apache 2.0. Activa 21B de parámetros por token usando 192 expertos con enrutamiento top-8, soporta una ventana de contexto de 256K y apunta a cargas de trabajo de razonamiento, agénticas y de código. Consulta el desglose de especificaciones más arriba para todos los detalles.
¿Tencent Hy3 es gratis?
Tencent Hy3 es gratuito hasta el 21 de julio de 2026, a través de la ruta tencent/hy3:free de OpenRouter y el portal de Nous Research. Cuando termine la promoción, el listado de OpenRouter cuesta aproximadamente $0.14 por millón de tokens de entrada y $0.58 por millón de tokens de salida, con algunos proveedores del marketplace cobrando hasta unos $0.20 en entrada.
¿Es Hy3 mejor que GLM 5.2?
Depende de la tarea. En los benchmarks reportados GLM 5.2 gana en código — SWE-bench Verified 84.2 frente al 78.0 de Hy3 — pero Hy3 lidera en razonamiento, ciencia y búsqueda agéntica usando menos de la mitad de los parámetros. Para código puro, GLM 5.2 es más fuerte; para uso general eficiente, Hy3 compite duro. Mira la tabla de benchmarks más arriba.
¿En qué es mejor Tencent Hy3?
Los casos de uso más fuertes reportados de Hy3 son el scaffolding de front-end, la generación y animación de SVG, la búsqueda agéntica y las tareas de razonamiento o ciencia — además de demos 3D y de física de complejidad media, donde según lo reportado igualó a modelos más caros a una pequeña fracción del coste. Es más débil en contexto muy largo y en código agéntico de primer nivel.
¿Qué tamaño tiene Hy3 comparado con DeepSeek V4 Pro?
Hy3 es mucho más pequeño — 295B de parámetros totales frente a los 1,6 billones de DeepSeek V4 Pro. En benchmarks de código los dos intercambian golpes a pesar de esa brecha de tamaño, lo cual explica en gran parte por qué la eficiencia de parámetros de Hy3 atrajo tanta atención. Mi reseña completa de DeepSeek V4 Pro cubre ese modelo en profundidad.
Trabaja conmigo en esto
Si prefieres no hacer benchmarks, conectar y cuidar tú mismo un elenco rotatorio de modelos open-weight, esa es una buena parte de lo que hago — ayudar a equipos a elegir el modelo adecuado para cada carga de trabajo (Hy3 incluido), integrarlo en un arnés de agentes que aguante en producción y encontrar las aristas afiladas antes de que ellas te encuentren a ti. Si ese es el tipo de ayuda que necesitas, aquí es donde puedes contactarme.