J’ai failli fermer l’onglet.
J’étais au troisième paragraphe d’un fil Hacker News sur les « orchestrateurs de codage agentiques » quand mon cerveau a fait ce truc de fatigue oculaire — celui où tu as lu « fin du vibe coding » tellement de fois que tous les nouveaux outils qui s’autoproclament ainsi te déclenchent le même réflexe qu’un email de phishing. J’étais prêt à passer à autre chose. Puis mon regard est tombé sur le nom en haut du fil : Traycer. Pas Tracer. Pas TracerAI. Traycer, écrit exprès de façon étrange, avec un article de blog intitulé « Ralph Loops. Bart Orchestrates. »
Ce titre m’a arrêté. Parce que la boucle Ralph est une vraie chose que j’ai déjà lancée. Plus d’une fois. Et « réessayer à l’aveugle jusqu’à ce que ça marche » décrit exactement ce que je ressens quand je regarde une boucle de Claude Code tourner en rond sur le même test qui échoue à 2 h du matin, alors que je bois un café froid et que je remets mes choix de vie en question.
Alors j’ai donné à Traycer ses 90 minutes. J’ai testé le mode Bart sur un vrai projet — un petit dashboard de gestion d’agents avec authentification et intégration d’API — et je l’ai lancé en parallèle d’un workflow manuel orienté plan sur Claude Code, qui est la méthode avec laquelle je livre la plupart de mes side projects depuis six mois.
Ce que j’ai trouvé n’était ni à la hauteur de la hype, ni conforme à mon scepticisme. Le mode Bart de Traycer fait réellement quelque chose que la boucle Ralph ne sait pas faire — mais il le fait aussi d’une manière qui change le sens de « codage autonome par IA », et ce n’est pas un avantage pour tous les projets. Voici le walkthrough complet, ce qui fonctionne, ce qui casse, et pour qui c’est réellement pertinent.
Le problème du Ralph Loop dont personne ne parle
Avant de comprendre pourquoi le mode Bart compte, il faut intégrer le modèle mental de ce qu’il est censé remplacer. Et cela commence par saisir ce que la plupart des gens entendent par « codage autonome par IA » en 2026.
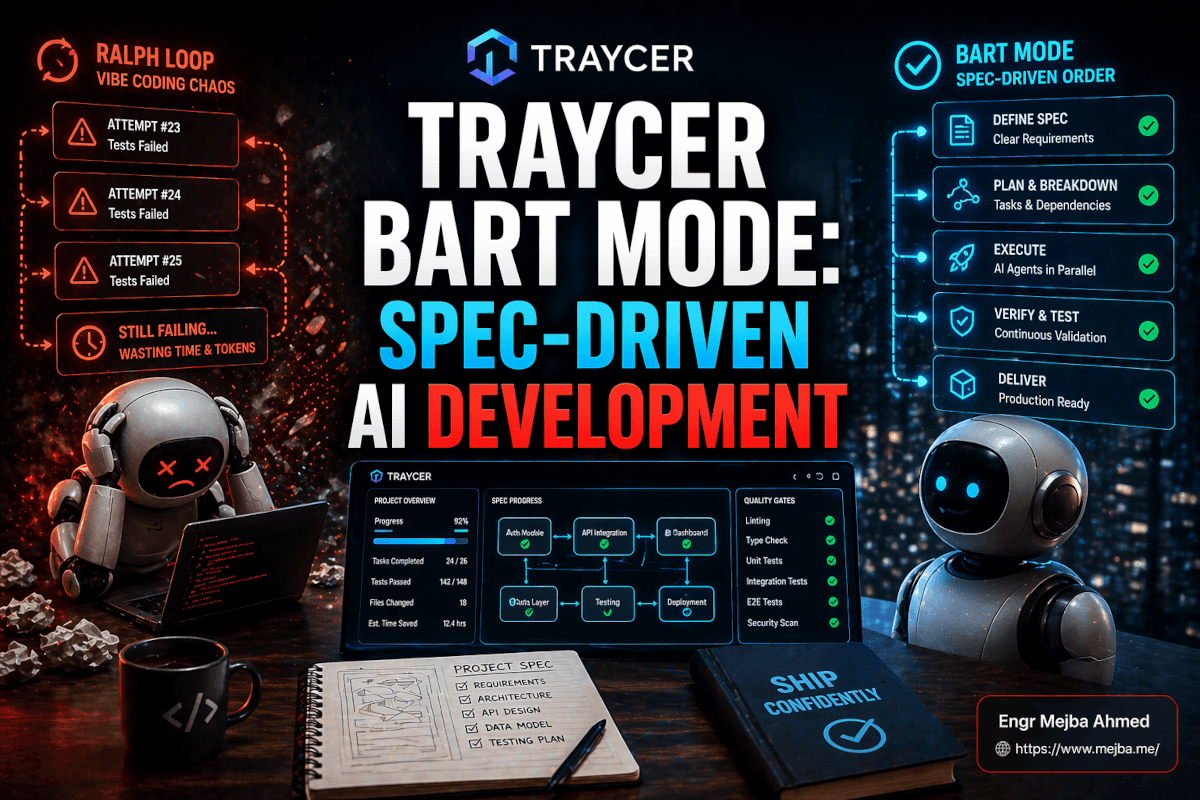
Le schéma dominant aujourd’hui est la boucle Ralph. Nommée d’après Ralph Wiggum des Simpson (le gamin qui persévère sans toujours réussir), la boucle Ralph est d’une brutalité simple : vous confiez une tâche à un agent de codage IA, vous l’encapsulez dans une boucle while not done et vous le laissez tourner. À chaque itération, le contexte est réinitialisé, l’agent lit le fichier de plan sur le disque, tente d’exécuter une partie du travail, vérifie, puis repart pour une nouvelle boucle. C’est la philosophie de la persévérance pure — si une tentative échoue, on recommence avec un contexte légèrement différent.
J’ai déjà exécuté la boucle Ralph en production. Ça fonctionne. Parfois de manière impressionnante. Une fonctionnalité bien délimitée, avec des tests solides et un unique dépôt, peut réellement passer en production du jour au lendemain, l’agent itérant encore et encore. Vercel Labs propose une implémentation appelée ralph-loop-agent. Le dépôt GitHub snarktank/ralph fait partie des référentiels de codage autonome les plus étoilés cette année. Le schéma est bien réel et il s’impose comme colonne vertébrale de nombre de workflows d’indépendants qui livrent en continu.
Mais voici ce que personne n’indique sur les pages commerciales. La boucle Ralph possède deux faiblesses structurelles, qui m'ont toutes deux coûté de nombreuses heures :
Premier problème : le retry à l’aveugle. Quand la boucle échoue, elle ne sait pas pourquoi elle a échoué de façon exploitable à l’itération suivante. Elle relit le plan, constate « tâche 4 incomplète » et relance la tâche 4. Si la tâche 4 échoue car le plan était mauvais — et non parce que l’exécution était mauvaise — la boucle va régénérer le même code défaillant pendant six heures sans sourciller. J’ai vu une boucle Ralph sur le projet d’un ami brûler 400 000 tokens en tentant d’implémenter un endpoint Stripe webhook qui n’aurait jamais dû exister, car la spécification avait dérivé de la réalité deux tickets auparavant.
Deuxième problème : absence de couche d’orchestration. La boucle Ralph se résume à un agent réalisant une action, enfermé dans son cercle. Elle ne peut pas paralléliser, ni escalader vers un humain au bon moment, et surtout, elle est incapable d’adapter le plan lorsque la mise en œuvre révèle un imprévu. Elle ne sait qu’exécuter.
C’est ce deuxième problème qui m’a vraiment poussé à cliquer sur le bouton d’inscription à Traycer. Parce que le mode Bart — selon le propre positionnement de Traycer — n’est pas juste une boucle Ralph avec de meilleurs prompts. C’est une autre catégorie. Un orchestrateur de boucle externe qui observe les boucles internes, ajuste le plan au fil de son évolution, et sait s’arrêter pour poser une question plutôt que d’halluciner une réponse.
Ce positionnement relève peut-être du marketing. Ou alors, c’est exactement ce que j’attends depuis longtemps. Une seule façon de le vérifier.
Ce qu’est vraiment le mode Bart de Traycer
Avant d’entrer dans le test, il est important de poser le contexte produit, car "Traycer" est un espace de nom encombré et les spécificités déterminent si cela s’applique à votre workflow.
Traycer est une plateforme de développement pilotée par les spécifications — elle s’intercale entre vous et votre agent de codage (Claude Code, Cursor, Windsurf, ou tout autre) et transforme des intentions de haut niveau en spécifications structurées et exécutables. La plateforme propose quatre modes de tâches, et le mode Bart est une stratégie d’exécution spécifique au sein du mode Epic — le mode le plus large et le plus autonome du système.
Voici comment les modes s’articulent, du plus restreint au plus large :
- Mode Plan — pour les tâches à périmètre bien défini. Décrivez un changement, obtenez un plan d’implémentation fichier par fichier, confiez-le à votre agent de codage. C’est le mode qui concurrence le plus directement le
/plande Claude Code. - Mode Phases — pour les fonctionnalités complexes. Traycer clarifie l’intention, segmente le travail en phases guidées façon Kanban, planifie chaque phase, délègue à votre agent et vérifie les résultats à chaque point de contrôle. C’est le tableau de phases façon Kanban sorti plus tôt en 2026.
- Mode Review — un workflow de relecture agentique de code. Analyse approfondie sur les bugs, la performance, la sécurité, la clarté. Vous l’orientez vers un diff ou l’état d’un dépôt et il vous fait un rapport.
- Mode Epic — pour gérer des projets complets. Maintient des spécifications vivantes et un backlog de tickets, permet d’exécuter par phases contrôlées ou de déléguer tout l’Epic à Bart.
Le mode Bart, c’est l’option « déléguer tout l’Epic ». La documentation de Traycer le nomme en interne Smart YOLO, et le blog public le décrit comme un orchestrateur de boucle externe. La distinction avec Ralph est explicitement posée : Bart n’est pas un simple agent exécutant en boucle serrée. Bart orchestre un système de feedback sur les specs, les tickets, les diffs, les résultats de vérification et les décisions humaines — et adapte le plan au fur et à mesure que le code évolue.
En pratique, cela signifie : vous décrivez un projet, Traycer génère les specs, Bart les découpe en tickets, Bart exécute des lots de tickets en parallèle en utilisant votre agent de codage choisi, Bart vérifie chaque lot après exécution en fonction des specs, et Bart continue, ajuste le plan ou fait remonter à l’humain s’il trouve un blocage qu’il ne peut pas résoudre.
La phrase clé dans la présentation de Traycer, celle à laquelle je reviens sans cesse, c’est : « Lorsque l’implémentation contredit les specs, Bart n’hallucine pas une nouvelle vérité. Il s’arrête et dit : voici l’écart. Voici les options. Choisissez la contrainte. »
Cette phrase — si elle se vérifie — marque la différence entre livrer du concret et déboguer de la bouillie IA pendant six heures. Voyons ce qu’il en est.
La mise en place : projet réel, enjeux réels
Je ne voulais pas d’un test factice. Les tests factices flattent tous les outils. J’ai donc choisi un projet que j’allais de toute façon construire ce mois-ci — un petit tableau de bord interne pour gérer l’agent manager que j’administre pour un client — et je l’ai plutôt soumis au mode Bart de Traycer, au lieu de mon workflow habituel Claude Code axé sur une planification soignée.
Voici le brief du projet, rédigé comme je le ferais pour un véritable ingénieur :
Construire un tableau de bord interne. Next.js 15, TypeScript, Tailwind, shadcn/ui. Authentification Supabase (email + magic link). Route protégée sur
/agentsqui récupère via une API externe (POST avec clé API depuis l’env), affiche les agents dans un tableau avec filtres (statut, last-run, type d’agent), permet à l’utilisateur de déclencher un run manuel. Graphiques pour l’historique des runs (recharts). Pas de multi-tenant. Tableau de bord pour opérateur solo.
Environ une semaine de travail si j’écrivais tout moi-même. Peut-être trois jours via Claude Code avec un plan propre. La question : que fera le mode Bart avec ce brief ?
Je me suis inscrit sur l’offre gratuite : le plan Free de Traycer est à 0 $/mois avec une capacité de slot et un crédit illimité pour tâches open source, plus un essai Pro de 7 jours si l’on veut tester la capacité payante. Pour ce test, l’offre gratuite suffisait pour passer l’étape d’Epic setup et les deux premiers lots d’exécution avant de souhaiter plus de parallélisme. Les forfaits payants sont à 10 $/mois pour Lite, 25 $/mois pour Pro et 40 $/mois pour Pro+ au moment de la rédaction, avec 20% de remise annuelle.
Le choix du modèle compte réellement ici. Traycer est agent-agnostique — il n’exécute pas sa propre inférence mais orchestre les agents de code auxquels vous vous êtes authentifié. J’ai lancé le test avec Claude Opus 4.7 comme modèle d’exécution, déployé par Anthropic le 16 avril 2026, validé SWE-bench à 87,6% (contre 80,8% pour Opus 4.6) et CursorBench à 70%. Si vous voulez le vrai plafond du coding autonome spéc-dirigé en avril 2026, c’est l’association à viser.
Phase Un : Du brief à la spec
La première chose qui m’a surpris, c’est la manière dont Traycer a géré le brief. Je l’ai collé dans une nouvelle Epic, ajouté deux fichiers de contexte (la spec API client existante et une capture d’écran filaire grossière), et je m’attendais à ce qu’il commence immédiatement à générer des tickets. Ce ne fut pas le cas. À la place, il m’a posé sept questions — et chacune d’elles portait sur un point où je me serais trompé si je l’avais ignorée.
Les questions, dans l’ordre d’arrivée :
- La table des agents doit-elle paginer côté serveur ou côté client ?
- Quel est le compte de lignes attendu — moins de 100, des centaines, ou des milliers ?
- Lorsqu’un lancement manuel est déclenché, le comportement attendu est-il fire-and-forget ou l’UI doit-elle afficher un statut en direct ?
- Les clés API sont-elles par utilisateur ou globales à l’espace de travail ?
- Le graphique d’historique d’exécution doit-il afficher les N dernières exécutions, une fenêtre temporelle, ou les deux via un toggle ?
- Quel est le comportement souhaité si l’API externe est indisponible — dernier état connu mis en cache, état vide, ou une bannière ?
- Le “type d’agent” est-il un enum fixe ou provient-il de la réponse API ?
Chacune de ces questions se serait transformée en bug deux jours après le début du build. La question “Le type d’agent est-il un enum fixé ou issu de l’API” en particulier — j’avais supposé que c’était un enum. Ça ne l’est pas. Cette seule hypothèse aurait fait exploser un composant de filtre et obligé à un refactor.
C’est ce que Traycer appelle la clarification du mode Phases, qui s’exécute durant la configuration de l’Epic. Ce n’est pas de l’ingénierie révolutionnaire. Ce que c’est vraiment, c’est un modèle qui agit comme un ingénieur senior déjà brûlé et qui sait quelles hypothèses peuvent tout faire capoter. La plupart des outils de code IA ignorent cette étape, car les questions de clarification semblent ajouter des frictions. Traycer en fait le coup d’ouverture.
Après avoir répondu aux questions, Traycer a généré les specs. Pluriel. Pas une PRD monolithique, mais un arbre de specs :
tech-stack.md— Next.js 15 App Router, TypeScript mode strict, Tailwind v4, liste des composants shadcn/ui, configuration du client Supabasedata-models.md— types Agent, Run, RunHistory avec schémas Zodauth-flow.md— flow magic link, middleware de routes protégées, gestion de sessionapi-integration.md— contrats d’endpoint, gestion des variables d’environnement, stratégie retry/erreurui-layout.md— structure des routes, hiérarchie des composants, breakpoints responsivesticket-backlog.md— 14 tickets avec critères d’acceptation, mappés aux fichiers
C’est à ce stade que les workflows Ralph-loop remettent habituellement à l’agent un simple fichier de plan et s’arrêtent là. Traycer a fait autre chose : il m’a montré les tickets et m’a demandé quel chemin d’exécution je voulais. Exécuter par Phases (checkpoints contrôlés entre chaque phase) ou passer la main à Bart (autonome de bout en bout).
J’ai choisi Bart.
Phase Deux : Bart prend le volant
Dès que vous confiez un Epic à Bart, l’interface utilisateur change. Le tableau de tickets devient une vue d’orchestration. Vous voyez Bart regrouper les tickets en lots — organisés par dépendance, et non par ordre de liste — puis les distribuer en parallèle.
Pour mon projet, le premier lot comprenait quatre tickets lancés simultanément :
- T-01 — Structure du projet + configuration Tailwind + shadcn
- T-02 — Client Supabase + gestion des variables d’environnement
- T-03 — Définition des types + schémas Zod
- T-04 — Module client API avec logique de nouvelle tentative
Ces quatre tickets sont indépendants — ils peuvent donc être déroulés en parallèle. Une boucle Ralph aurait traité ces étapes de façon séquentielle, ce qui m’aurait coûté près de quatre fois le temps mur réel. Bart les a exécutés en parallèle, avec quatre sessions Claude Opus 4.7 indépendantes sur quatre branches isolées. Temps total pour le premier lot : onze minutes.
C’est alors que le déclic s’est produit et que je me suis réellement penché vers mon écran.
Après la fin du premier lot, Bart n’a pas lancé tout de suite le second. Il a exécuté une vérification. Pas juste “est-ce que le code compile” — une vraie vérification du cahier des charges. Il a lu les fichiers générés, les a comparés à l’arborescence des spécifications et a signalé deux incohérences :
- Le module client API utilisait trois tentatives avec backoff exponentiel. La spécification
api-integration.mdexigeait cinq tentatives avec un intervalle fixe de deux secondes. Bart l’a repérée. - Le schéma Zod pour
Agent.statusutilisait une union de chaînes. La spécification dérivée d’une de mes clarifications exigeait que ce statut provienne de la réponse API, et non d’une union fixe. Bart l’a repérée.
Ensuite — et c’est là que ça change tout — Bart a mis à jour les tickets du second lot pour inclure les corrections de ces écarts, au lieu de lancer la suite du développement sur des bases erronées. Il a ajouté deux sous-tickets au backlog : T-04b (corriger la configuration du retry) et T-03b (rendre agent.status dynamique), les a intégrés au second lot, et a poursuivi.
Voilà ce que signifie réellement “orchestrateur” dans la pratique. Pas le parallélisme pour lui-même. Du parallélisme combiné à une vérification en boucle fermée face à une spécification vivante, avec la capacité d’adapter le plan en temps réel. La boucle Ralph ne peut pas faire cela. Non pas parce que ses concepteurs n’y ont pas pensé — mais parce que son architecture l’en empêche. La boucle Ralph n’a pas de vue spec-vs-implementation. Bart, si.
Le moment où Bart s'est arrêté pour poser une question
Le troisième lot est l'endroit où j'ai compris ce que le blog de Traycer veut dire par « Bart ne hallucine pas une nouvelle vérité ».
Ce lot comprenait T-09 (graphe de l’historique d’exécution) et T-10 (bouton de déclenchement manuel). Les deux ont été complétés. La vérification de Bart a signalé un conflit : le ticket du graphe supposait que l’historique d’exécution provenait d’un cache de base de données locale (dérivé de la stratégie de cache décrite dans api-integration.md), alors que le ticket relatif au déclenchement manuel supposait que cela invalidait le cache et récupérait à nouveau depuis l’API externe (basé sur ma réponse de clarification à propos de l’état en temps réel).
Les deux interprétations étaient cohérentes avec différentes parties du cahier des charges. Toutes deux étaient plausibles. Mais elles ne pouvaient coexister — il fallait trancher.
Une boucle Ralph aurait fait un choix. En silence. Et j’aurais découvert l’incohérence deux semaines plus tard, lorsque l’historique d’exécution aurait cessé de se mettre à jour après un déclenchement manuel.
Bart a interrompu l’Epic et affiché une carte de décision dans l’interface. La carte présentait la divergence, les deux interprétations, et trois solutions proposées (invalider le cache lors du déclenchement, ne pas invalider mais afficher une mise à jour optimiste, toujours récupérer en direct pour le graphe). J’en ai choisi une. Bart a mis à jour le cahier des charges, régénéré le ticket concerné, et repris.
Temps humain total pour cette décision : environ 90 secondes. Temps probablement économisé : une session complète de débogage deux semaines plus tard.
Si vous préférez confier ce genre de workflow de bout en bout à une équipe plutôt que de maîtriser un nouvel outil, je prends en charge des missions orchestration Claude Code et agents via Fiverr — installer ce type de workflow spécification-first pour les clients, c’est l’essentiel de mes livraisons en ce moment.
Phase trois : la ligne d’arrivée et ce que Bart a manqué
Quatre-vingt-treize minutes après avoir confié l’Epic à Bart, le tableau de bord était fonctionnellement complet. Auth opérationnelle. Tableau des agents affiché. Filtres fonctionnels. Graphique visible. Déclencheur manuel actif. Le npm run dev local démarrait proprement.
Ça ressemble à un tour de victoire. Ça n’en est pas vraiment un.
Voici ce que j’ai dû corriger manuellement après que Bart a annoncé « Epic complete » :
Une régression de style. Le composant Select shadcn/ui dans la barre de filtre utilisait un style par défaut qui ne correspondait pas au reste du dashboard. La spec ne précisait rien — Bart a déduit le comportement par défaut — mais cette déduction était incorrecte. 4 minutes pour corriger.
Un arbitrage UX. L’état vide pour le tableau des agents — lorsque l’API externe renvoyait zéro agent — affichait un simple message générique « No results ». Un vrai humain aurait écrit quelque chose de plus précis (« Aucune agent trouvé. Ajoutez votre premier agent depuis le panneau de configuration. »). Bart a rédigé littéralement ce que la spec suggérait, sans plus. 3 minutes pour adapter.
Un détail de sécurité. La clé API était correctement récupérée depuis les variables d’environnement dans le code côté serveur, mais le composant client qui déclenchait les exécutions manuelles faisait un fetch vers /api/agents/run sans protection CSRF. La spec ne l’exigeait pas. Bart n’en a pas ajouté. Pour un dashboard interne géré en solo, ça passe. Pour une équipe, ce serait non. 8 minutes pour ajouter le middleware.
Aucun test. Bart ne génère pas de tests si la spec ne l’exige pas. La mienne ne le faisait pas. J’ai ajouté manuellement les tests critiques (redirection auth, gestion des erreurs API). 22 minutes.
Temps total de retouche manuelle : environ 40 minutes. Ce n’est pas rien. Ce n’est pas négligeable. Mais le projet est passé du brief à « prêt à montrer au client » en à peine plus de deux heures et demie, et j’ai pu faire d’autres tâches la plupart du temps.
À titre de comparaison, mon workflow Claude Code manuel, planifié à partir d’une spec sur un projet de complexité similaire le mois dernier, m’a pris environ quatre heures consécutives de code, plus deux heures supplémentaires le lendemain matin pour nettoyer. Le mode Bart a tout compressé en une seule session où j’ai surtout observé.
Bart Mode vs Claude Code : Quand utiliser l’un ou l’autre
Je ne pense pas que Bart mode remplace Claude Code. J’utilise désormais les deux, et la question que je me pose avant chaque projet est : est-ce que ce projet a suffisamment de surface pour que le développement guidé par spécifications soit rentable ?
Voici l’arbre de décision que j’utilise après trois semaines avec Traycer :
Utilisez Bart mode lorsque :
- Le projet comporte 5 composants ou tickets distincts ou plus
- Plusieurs parties peuvent être parallélisées sans croiser les états
- La spécification peut être rédigée proprement (nouvelles fonctionnalités, applications greenfield, migrations bien définies)
- Vous souhaitez quitter le projet et y revenir avec quelque chose qui fonctionne
- Vous disposez d’un abonnement Traycer payant avec la capacité de paralléliser
Utilisez Claude Code manuellement lorsque :
- La tâche concerne un seul fichier ou un seul enjeu
- Vous êtes en mode exploration ou recherche et l’état final n’est pas encore défini
- La base de code existante contient suffisamment de conventions implicites pour que des spécifications les manquent
- Vous voulez piloter chaque décision en temps réel (mode pair-programmation)
- La tâche nécessite des réponses aux erreurs dans un contexte que les spécifications ne peuvent pas saisir
Utilisez les deux dans le même workflow lorsque :
- Bart gère l’échafaudage et les tickets structurels
- Vous reprenez dans Claude Code pour la finition UX, les tests et les éléments impossibles à spécifier
- C’est d’ailleurs la combinaison que j’utilise à ce jour
Ce qui est intéressant avec cette répartition, c’est que Bart mode ne dévalorise pas Claude Code — cela rend plus évident ce pour quoi Claude Code est réellement fait. Claude Code est un instrument chirurgical. Bart mode construit l’échafaudage des structures plus larges. J’utilisais l’instrument chirurgical pour bâtir l’échafaudage, d’où la sensation laborieuse de ces sessions de six heures, même lorsqu’elles aboutissaient.
Ce que personne d'autre n'écrit sur le développement piloté par les specs
Trois semaines plus tard, voici les éléments sur le développement IA piloté par les specs que je ne retrouve ni sur les pages produit ni dans les démos YouTube.
Écrire des specs est plus difficile qu’écrire du code. Je sais. C’est l’inverse du pitch. Mais rédiger une bonne spec — sans ambiguïté, complète et cohérente — exige une clarté produit que la plupart des développeurs solo n’ont pas le premier jour d’un projet. Les questions de clarification de Traycer aident, sans remplacer la compétence. Si en 2026, vous n’êtes pas capable de répondre à « doit-on paginer côté serveur ou côté client ? », Traycer ne vous apprendra pas à raisonner produit. Il se contentera d’interrompre le flux plus souvent pour vous poser la question.
Le plafond de parallélisme est plus bas que le marketing ne le laisse entendre. Les graphes de dépendances entre tickets s’aplanissent vite. Sur mon projet de dashboard, le premier lot comptait quatre tickets en parallèle. Le deuxième, deux. Le troisième, un seul. À mi-chemin d’un Epic, la plupart des tickets restants dépendent des travaux précédents et s’exécutent de façon séquentielle. La promesse des « agents parallèles » est réelle au début, puis s’estompe rapidement.
La dérive de spec est la nouvelle dérive de code. Lorsque Bart met à jour la spec en cours d’exécution pour résoudre un décalage, ce changement se répercute sur les tickets restants. Ce qui est génial — jusqu’au moment où vous vous rendez compte que votre spec vivante a évolué bien plus loin que celle que vous aviez approuvée. Sur mon projet, api-integration.md a connu trois révisions pendant l’exécution. La spec finale était meilleure que la première, mais ce n’était plus celle sur laquelle j’avais donné mon aval. Il faut toujours revoir l’état final de la spec, pas seulement la version d’origine. Traycer facilite cela. Mais c’est quand même du boulot.
Bart continue de bénéficier des moments “canard en plastique” humains. Deux fois pendant l’Epic, j’ai mis Bart en pause — non pas parce qu’il échouait, mais parce que le flux des tickets a déclenché une prise de conscience produit à intégrer dans la spec. La capacité de Bart à s’arrêter et à s’adapter en plein Epic est exactement ce qui rend ces pauses si peu coûteuses. Dans une boucle Ralph, mettre en pause implique de tout relancer. En mode Bart, la pause est gérée en première classe.
Le modèle compte autant que l’orchestrateur. J’ai exécuté le même Epic deux fois — une fois avec Claude Opus 4.7 comme agent d’exécution, une fois avec GPT-5.4. Même spec, même logique Bart, résultats différents. Opus 4.7 a généré des structures de composants plus propres et a mieux capté les conventions implicites de la spec. GPT-5.4 était plus rapide et un peu plus littéral. L’orchestrateur n’est aussi bon que l’agent qu’il pilote. Choisissez d’abord le modèle, puis laissez Bart faire son travail.
Où cela s’inscrit-il dans le paysage du spec-driven
Traycer n’est pas seul dans cet espace. En 2026, le spec-driven development est devenu une véritable catégorie. Les outils que j’ai testés cette année :
- Kiro — IDE proche d’AWS avec un workflow orienté spécification. Performant pour les projets greenfield disposant de specs définies. Forte intégration AWS. Parfait si vous baignez dans cet écosystème.
- GitHub Spec Kit — CLI ajoutant des slash commands spec-driven à Claude Code, Gemini CLI, Cursor, Windsurf. Portabilité inter-agents, pas d’enfermement propriétaire, mais c’est à vous de composer le workflow.
- BMAD-METHOD — méthodologie open source + CLI. Rigoureux. À l’esprit académique. Nécessite une période d’adaptation.
- Traycer — celui que j’utilise pour la plupart de mes projets aujourd’hui. La couche d’orchestration la plus aboutie de tous ceux que j’ai testés. Agnostique aux agents. Séparation très nette entre la rédaction de la spec et son exécution.
L’avantage de Traycer ne tient pas au format de la spec, mais à ce qui se passe après. L’association du mode Epic et de l’orchestrateur Bart constitue la boucle end-to-end la plus resserrée que j’aie utilisée. La rédaction de spec de Kiro est peut-être plus propre. La portabilité de Spec Kit est sans doute meilleure. Aucun n’offre la conciliation live spec-vs-implementation de Bart.
Si vous souhaitez approfondir la théorie générale derrière ce pattern, mon précédent article sur l’approche skills install de claude.md par Karpathy détaille en quoi des fichiers de contexte proches des spécifications modifient la qualité des réponses de n’importe quel agent, pas seulement Traycer. Et la comparaison que j’ai menée entre l’Ultra Plan de Claude Code et le mode plan local constitue une bonne base pour comprendre en quoi les workflows orientés plan diffèrent, face aux workflows orientés spec, spécifiquement dans l’écosystème Anthropic.
Comment j'utilise le mode Bart ce mois-ci
Workflow concret, si vous voulez le copier :
Lundi matin. Rédigez une Épopée dans Traycer pour la fonctionnalité principale de la semaine. Répondez aux questions de clarification. Passez en revue l’arbre des spécifications généré. Modifiez les spécifications là où Traycer s'est trompé sur mes préférences. Déléguez à Bart.
Lundi après-midi. Travaillez sur d’autres sujets. Bart exécute des lots. Je reçois des notifications dans l’interface utilisateur lorsque Bart escalade une décision. Je passe peut-être 15 minutes en tout à répondre aux cartes de décision dans l’après-midi.
Mardi matin. Bart signale que l’Épopée est terminée. Je récupère la branche, je la lance en local, je contrôle par rapport à la spécification, je corrige les détails à la main, j’écris les tests, je fais le commit.
Le reste de la semaine. J’utilise Claude Code pour un travail chirurgical : le polissage, les tests, la rédaction UX, les bugs ponctuels. Tout ce que Bart ne peut pas spécifier assez clairement pour l’exécuter.
Ce n’est pas « l’IA autonome remplace l’ingénierie ». C’est « l’IA autonome gère l’ossature, moi je gère le savoir-faire ». Cette répartition me semble durable, là où la boucle Ralph pure n’a jamais fonctionné pour moi. La boucle Ralph a toujours été un pari tout ou rien. Le mode Bart rend l’autonomie partielle, structurée et — point crucial — réversible. Chaque lot peut être relu avant le prochain envoi. Chaque modification de spécification est tracée. Chaque ticket est reproductible.
Foire aux questions
Qu’est-ce que le mode Bart de Traycer ?
Le mode Bart de Traycer est un orchestrateur autonome de type outer-loop qui exécute de bout en bout des Épics projet en les découpant en tickets, puis en traitant ces tickets par lots parallèles avec des agents de codage IA, en vérifiant la conformité aux spécifications après chaque lot et en adaptant le plan à la volée dès qu’une divergence apparaît lors de l’implémentation. Il fonctionne au sein du mode Epic de Traycer et reste indépendant des agents — vous choisissez le modèle d’exécution (Opus 4.7, GPT-5.4, etc).
En quoi le mode Bart diffère-t-il de la boucle Ralph ?
La boucle Ralph relance aveuglément une tâche jusqu’à la validation, sans analyser l’origine des échecs. Le mode Bart, lui, raisonne : il maintient une spécification vivante, confronte l’implémentation à cette spec après chaque lot, adapte les tickets si la réalité diverge, et escalade vers l’humain dès qu’il rencontre une impasse insoluble. Ralph est une boucle while not done. Bart est un orchestrateur doté de mémoire.
Quels modèles d’IA sont compatibles avec Traycer ?
Traycer est agent-agnostique — il n’exécute pas sa propre inférence, il orchestre tout agent de codage que vous authentifiez. Cela inclut aujourd’hui Claude Code (avec les variantes Opus 4.7 et Sonnet), GPT-5.4, Cursor et des intégrations Windsurf. Vous choisissez le modèle par Épic, selon vos critères de rapidité, coût et qualité.
Traycer est-il gratuit ?
Oui. Traycer propose une offre gratuite à 0 $/mois, avec une capacité d’un slot et un essai Pro de 7 jours. Les offres payantes démarrent à 10 $/mois (Lite), 25 $/mois (Pro) et 40 $/mois (Pro+) à la date de rédaction, avec une réduction de 20 % sur les abonnements annuels. Le forfait gratuit suffit pour tester le mode Bart sur un petit Épic.
Quand ne pas utiliser le mode Bart ?
Évitez le mode Bart pour des modifications mono-fichier, des recherches exploratoires où la cible n’est pas définie, ou des bases de code régies par de nombreuses conventions implicites non capturées par une spec. Claude Code en mode manuel reste préférable pour des interventions précises ou du pair programming en temps réel. Le mode Bart révèle tout son potentiel dès qu’un projet comporte 5+ tickets à dépendances claires et formalisables en spécification.
Travaillons Ensemble
Vous cherchez à développer des systèmes d’IA, automatiser des workflows ou faire évoluer votre infrastructure technique ? Je serais ravi de vous accompagner.
- Fiverr (créations sur-mesure & intégrations) : fiverr.com/s/EgxYmWD
- Portfolio : mejba.me
- Ramlit Limited (solutions entreprises) : ramlit.com
- ColorPark (design & branding) : colorpark.io
- xCyberSecurity (services de cybersécurité) : xcybersecurity.io