El bug me tomó noventa minutos encontrarlo, y vivía en código que nunca había leído.
Claude Code lo había escrito tres semanas antes — un componente duplicado de manejo de errores, el cuarto en el mismo proyecto, cada uno ligeramente diferente, cada uno pretendiendo ser el canónico. Desarrollé a velocidad de IA durante todo el segundo trimestre de 2026, y en algún lugar de esa velocidad perdí el hilo de cómo encajaba mi propia aplicación. Podía generar nuevas funcionalidades con prompts en minutos. Pero cuando algo se rompía, no podía señalar una pizarra y decir "el problema está aquí." Esa brecha — entre generar código y comprenderlo — es lo más peligroso del desarrollo de aplicaciones con IA ahora mismo, y casi nadie habla de ello.
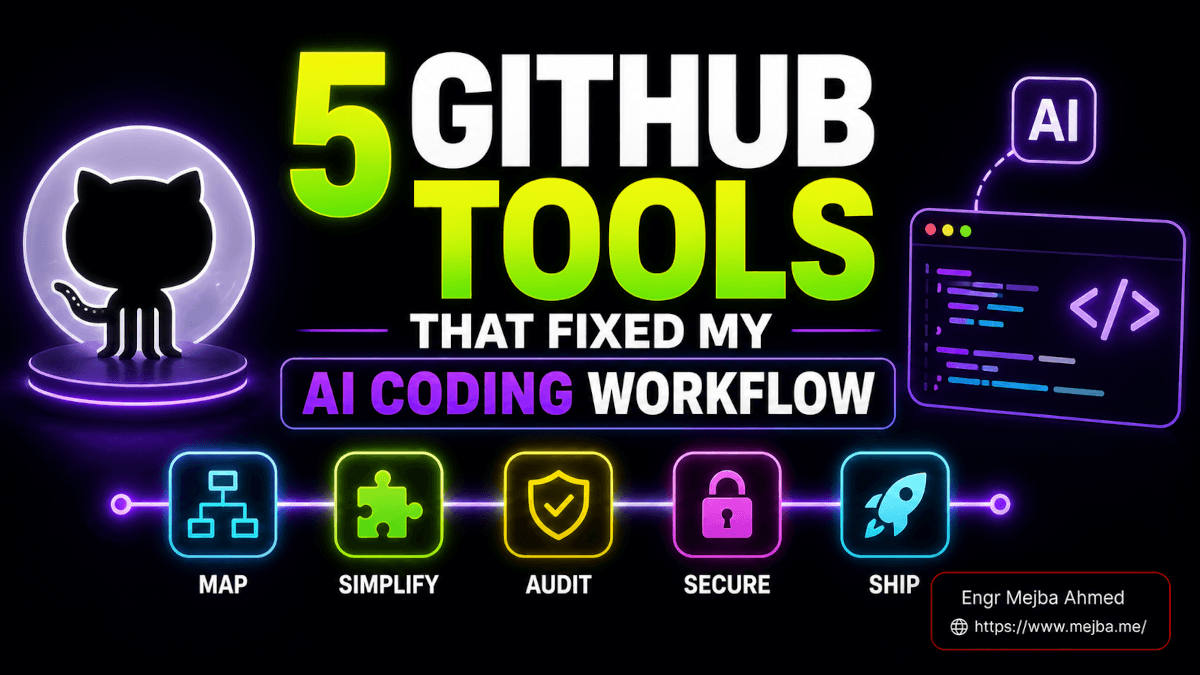
Así que pasé el último mes probando cinco herramientas de GitHub que atacan exactamente esa brecha. No son juguetes de productividad. No son otro framework de agentes más. Cinco herramientas que hacen algo más específico y más importante: te ayudan a comprender, simplificar, optimizar y asegurar el código que una IA escribe por ti, en lugar de simplemente acumular más. Una mapea tu arquitectura. Una elimina tu sobreingeniería. Una captura tus pensamientos más rápido de lo que puedes teclear. Una audita tu codebase y te entrega un backlog. Y una — la que casi me salté — escanea skills de terceros en busca del tipo de vulnerabilidad que silenciosamente roba tus cookies de sesión.
Aquí está el hilo conductor que quiero que mantengas a lo largo de todo el artículo: cada una de estas herramientas hace al humano más inteligente sobre la codebase, no solo a la máquina más rápida escribiendo. Esa distinción es la diferencia entre hacer vibe-coding hacia un producto mantenible y hacer vibe-coding hacia una caja negra que tienes miedo de tocar. Al final, tendrás un ciclo de retroalimentación — mapear, simplificar, auditar, asegurar — que puedes ejecutar en cualquier proyecto este fin de semana.
Déjame mostrarte lo que cada herramienta realmente hizo cuando la ejecuté.
Por qué el desarrollo de aplicaciones con IA se desmorona en el mes cuatro
La versión honesta de la historia del coding con IA tiene dos actos.
El acto uno es magia. Describes una aplicación, un agente la construye, y las primeras semanas sientes que tienes superpoderes. Funcionalidades que antes tomaban un sprint ahora toman una tarde. Yo viví esto. Es real.
El acto dos es la parte que las demos de lanzamiento nunca te muestran. Alrededor del mes tres o cuatro, la codebase comienza a sentirse más pesada de lo que debería. Archivos que nunca abriste. Tres componentes que hacen lo mismo. Una estructura de carpetas que tenía sentido para el modelo a las 2 de la madrugada pero que no tiene sentido para ti a la luz del día. El modelo no empeoró — tu comprensión sí, porque el código creció de cinco a diez veces más rápido de lo que tu cerebro puede modelar.
Hay dos modos de fallo específicos debajo de esa pesadez, y ambos están bien documentados a estas alturas.
El primero es sobreingeniería. Los modelos de lenguaje grandes están entrenados con un planeta entero de código de "mejores prácticas", y recurren a él de forma reflexiva. Pide un botón, obtén un factory pattern. Pide manejo de errores, obtén cuatro componentes casi idénticos en lugar de uno parametrizado. El modelo hace coincidencia de patrones hacia la complejidad porque la complejidad es lo que la mayoría de sus datos de entrenamiento parece. No pediste la abstracción. La obtuviste de todas formas.
El segundo es ineficiencia de tokens, que en realidad es el mismo problema con un estado de facturación. Cada abstracción extra, cada componente duplicado, cada ruta de código sin usar es más contexto que el modelo tiene que leer en el siguiente prompt. Una codebase inflada te cuesta dinero en cada llamada al agente, para siempre, porque el agente relee el desorden cada vez que trabaja.
Ambos problemas comparten una causa raíz: la IA genera más rápido de lo que puedes comprender, y la comprensión es lo único que mantiene vivo un proyecto. Las cinco herramientas a continuación son el antídoto — no porque hagan que la IA escriba más, sino porque te devuelven el control de la codebase. La primera comienza donde todo proyecto debería: un mapa.
draw.io CLI Skill — Ver tu arquitectura por primera vez
Seré honesto sobre dónde empecé. En mis propios proyectos construidos con IA, mi modelo mental de la arquitectura vivía completamente en mi cabeza, y estaba equivocado. Creía que sabía cómo se conectaban las piezas. No lo sabía.
El skill de draw.io solucionó eso en unos cuatro minutos. Es un skill de Claude Code — compatible con el formato Agent Skills — que convierte una codebase existente en un diagrama de arquitectura con layout automático usando la interfaz de línea de comandos de draw.io. Lo apuntas a un repositorio en Python, JavaScript/TypeScript, Go o Rust, y extrae la estructura, ejecuta un pase de layout con Graphviz con reducción transitiva para desenredar el espagueti de dependencias, y escribe XML .drawio editable que puedes abrir y reorganizar.
Lo que lo convierte en más que un juguete es el ciclo de auto-refinamiento incorporado. Tras bambalinas, verifica dependencias, planifica el layout, genera el XML, exporta un PNG borrador, luego se verifica contra la imagen y se auto-corrige hasta dos rondas antes de mostrarte nada. Después ejecuta un ciclo de retroalimentación de hasta cinco rondas contigo hasta que apruebes, y luego exporta el resultado final a PNG, SVG, PDF o JPG. Viene con seis presets de diagrama — ERD, clase UML, secuencia, arquitectura, ML/deep-learning y flowchart — más de 10,000 formas oficiales y 321 logos de marcas de IA/LLM para cuando estés documentando un stack de agentes.
Aquí está la parte que me sorprendió. Cuando lo ejecuté en una de mis propias aplicaciones, el diagrama mostró que mi capa de presentación hablaba directamente con la base de datos en dos lugares, saltándose completamente la capa de servicio. Yo había escrito — bueno, prompteado — ese código, y no tenía ningún recuerdo de ello. El diagrama lo detectó en segundos.
Ese es el caso de uso de "vibe engineering", y es el que quiero señalar para cualquiera que construya sin un trasfondo formal de ingeniería. Cuando puedes ver las capas — presentación, servicio, base de datos, el frontend móvil hablando con la API — el debugging deja de ser un juego de adivinanzas. Dejas de pedirle al agente que "arregle el bug de login en algún lugar" y empiezas a decir "la verificación de auth en la capa de servicio no está siendo llamada por el cliente móvil." Esa precisión también ahorra dinero real: darle a Claude Code un modelo mental claro de cómo se interconectan los componentes significa que lee menos de tu codebase para orientarse, lo que son menos tokens en cada prompt.
También hay una ruta oficial, si prefieres usar MCP en lugar de un skill. El 3 de febrero de 2026, jgraph publicó el servidor oficial @drawio/mcp, que conecta agentes de IA y draw.io directamente. Probé la versión skill porque se ejecuta completamente dentro de Claude Code sin ningún servidor extra que gestionar, pero si ya estás en un setup pesado de MCP, el servidor oficial vale la pena echarle un vistazo.
Un mapa te dice lo que construiste. No te dice que la mitad no debería existir. Para eso, necesitas la siguiente herramienta.
Ponytail — Eliminando el código que nunca necesitaste
Ponytail es la herramienta con más estrellas en este artículo, y la historia de lo rápido que llegó ahí te dice todo sobre lo desesperadamente que los desarrolladores la querían.
Un desarrollador en solitario que firma como DietrichGebert publicó Ponytail el 12 de junio de 2026. Para el 21 de junio — nueve días después — tenía más de 44,000 estrellas y más de 2,100 forks. El eslogan es perfecto: hace que tu agente de IA "piense como el senior dev más perezoso de la sala. El mejor código es el código que nunca escribiste."
Mecánicamente, Ponytail es un skill — un conjunto de reglas inyectadas en el agente — que obliga a la IA a escribir el código mínimo necesario y nada más. Su corazón es una escalera de decisión de seis peldaños que el agente escala antes de escribir algo:
- ¿Esta tarea siquiera necesita existir? Si no, sáltala. (Esto es YAGNI — You Aren't Gonna Need It — aplicado como una puerta dura.)
- ¿Ya existe en la codebase? Reutilízalo, no lo reescribas.
- ¿La biblioteca estándar lo hace? Usa la stdlib.
- ¿Función nativa de la plataforma? Úsala.
- ¿Dependencia ya instalada? Úsala.
- ¿Una línea? Escribe una línea. Solo entonces, el mínimo que funcione.
Viene en tres niveles de intensidad. Lite construye lo que pediste pero marca la alternativa más perezosa y te deja decidir. Full aplica la escalera. Y ultra — en palabras del mantenedor — "existe para cuando la codebase te ha ofendido personalmente." Me reí, luego ejecuté ultra en un proyecto lateral, luego dejé de reírme.
Pero la escalera de peldaños es solo la mitad de la herramienta. La mitad que me importa más es el modo auditoría. Apunta Ponytail a una codebase existente y marca código muerto, abstracciones innecesarias y dependencias que la biblioteca estándar podría reemplazar. Encontró mis cuatro componentes de manejo de errores y recomendó consolidarlos en uno solo parametrizado — exactamente la duplicación que me costó esa búsqueda de bugs de noventa minutos. Mantiene un "libro de deudas" para los atajos que tomas a propósito, y un marcador mostrando el impacto en tamaño de código y costos.
Ahora los números, porque aquí es donde Ponytail se gana las estrellas. El benchmark publicado del mantenedor, ejecutado el 18 de junio de 2026, midió el skill contra el mismo agente sin skill, editando un repositorio real de código abierto (FastAPI más React). El resultado: aproximadamente 54% menos código (hasta 94% en los archivos más sobreingenieriados), alrededor de 20% más barato por sesión, cerca de 27% más rápido, y — crucialmente — el 100% de las suites de tests seguían pasando. Menos código, menor costo, ejecuciones más rápidas, nada roto.
Añadiré la advertencia honesta que siempre añado. Ponytail es obstinado, y "el senior dev más perezoso de la sala" a veces se equivoca. Dos veces sugirió colapsar una abstracción que había construido deliberadamente porque sabía que vendría un segundo consumidor en el próximo sprint. Para eso están el modo lite y el libro de deudas — tú te mantienes en el loop, tú tomas la decisión. Pero para el caso por defecto, donde la IA construye de más reflexivamente y solo quieres código limpio y entregable, Ponytail es la primera herramienta que he instalado permanentemente en cada proyecto nuevo.
Eso cubre mapear y simplificar. El siguiente problema está antes de ambos: lograr que tus propios pensamientos entren en la máquina lo suficientemente rápido como para mantener el ritmo.
Handy — Dictado por voz gratuito que sigue el ritmo de tu cerebro
Aquí hay un cuello de botella que nadie admite. La IA puede escribir una funcionalidad en treinta segundos. Especificar esa funcionalidad claramente — teclear el contexto completo, los casos límite, las restricciones — te toma cinco minutos de tecleo. Tu ancho de banda de entrada es el límite ahora, no la salida del modelo.
La voz soluciona eso, y Handy es la forma gratuita y de código abierto. Es una herramienta de dictado con un flujo de trabajo simple: presiona un atajo, habla, y el texto aparece donde esté tu cursor. Funciona en Linux, macOS y Windows, y es una alternativa genuinamente gratuita a herramientas de pago como Wispr Flow.
Bajo el capó te da una selección de modelos de reconocimiento de voz. Puedes ejecutar la familia Whisper de OpenAI (Small, Medium, Turbo, Large) con aceleración GPU para precisión, o Parakeet V3 de NVIDIA, un modelo optimizado para CPU con detección automática de idioma que es lo suficientemente rápido para sentirse instantáneo incluso sin una GPU potente. Todo se ejecuta localmente — el audio nunca sale de tu máquina — lo cual importa cuando estás dictando especificaciones propietarias o datos de clientes.
Usé Handy durante dos semanas seguidas para capturar especificaciones antes de alimentarlas a Claude Code. El cambio fue mayor de lo que esperaba. Cuando describir una funcionalidad cuesta diez segundos de hablar en lugar de cinco minutos de teclear, describes más. Añades los casos límite que normalmente omitirías. Piensas en voz alta sobre los modos de fallo. Cuanto más rico tu contexto verbal, mejor el código que el agente escribe — y Handy expande la cantidad de contexto que puedes alimentar de forma realista a una herramienta de IA antes de que tus manos se rindan.
La limitación honesta: Handy es dictado, no reescritura. Las herramientas de pago como Wispr Flow añaden limpieza con IA encima — eliminando tus "ehs", reestructurando frases divagantes, formateando al vuelo. Handy no hace eso. Lo que dices es lo que obtienes, muletillas incluidas. Para mí, es un intercambio justo por gratuito, local y privado — estoy pegando pensamientos crudos en un prompt donde un poco de desorden no importa. Si necesitas prosa pulida dictada directamente en un documento, sentirás la brecha. Para capturar pensamiento de desarrollo a la velocidad a la que realmente ocurre, es más que suficiente.
Si los agentes de voz te interesan más ampliamente, profundicé en el lado conversacional en mi análisis sobre construir un agente de voz con Claude Code y ElevenLabs — diferente caso de uso, la misma verdad subyacente de que la voz es una interfaz subestimada para el desarrollo con IA.
Ahora puedes ver tu arquitectura, simplificarla y alimentarla más rápido. La siguiente herramienta convierte todo eso en un plan real que puedes ejecutar.
Improve de shadcn — Convirtiendo una auditoría en un backlog
Esta es la que cambió cómo pienso sobre todo el ciclo, así que quédate conmigo.
Improve es un skill de agente de shadcn — sí, la persona de shadcn/ui — y se lanzó el 10 de junio de 2026, el día después de que salió Fable 5. La propuesta es inusual: "Usa tu modelo más capaz para auditar tu codebase y escribir planes para que modelos más baratos los ejecuten." Divide el coding con IA en dos trabajos económicamente diferentes — pensamiento caro y ejecución barata — y solo maneja el pensamiento.
La característica definitoria es lo que no hace. Improve es estrictamente solo lectura en tu código fuente. Nunca implementa, repara ni refactoriza nada por sí mismo. Lee tu codebase, encuentra las ineficiencias y los problemas sistémicos, los prioriza y escribe un plan de implementación detallado. El plan es el producto. Eso suena como una limitación hasta que entiendes la economía detrás.
La lógica es esta. La comprensión profunda de la codebase — mapear cómo todo se conecta, juzgar qué realmente vale la pena arreglar, escribir una especificación precisa — es donde la inteligencia se compone. Eso vale la pena ejecutarlo en tu modelo más inteligente y caro. Ejecutar esa especificación, una vez que está escrita con suficiente claridad, es mecánico. Eso puede correr en un modelo más barato, una y otra vez, durante semanas. Una sesión de auditoría con un modelo top — digamos 400K tokens de entrada para mapear una codebase mediana, aproximadamente $4 en el lado de entrada — produce un plan que los modelos baratos luego ejecutan a lo largo de docenas de sesiones. Un pensamiento caro, muchas ejecuciones baratas. Esa es la estrategia de optimización de tokens, y es genuinamente inteligente.
Pero la función que me hizo prestar atención es la integración con gestión de proyectos. Añade el flag --issues e Improve publica su plan directamente como issues de GitHub. No un archivo markdown que olvidarás en una carpeta /docs. Issues reales y rastreables que tu equipo — o tus otros agentes — pueden tomar en cualquier flujo de trabajo que ya usen.
Piensa en lo que eso desbloquea. Tu deuda técnica deja de ser una sensación vaga y se convierte en un backlog. Cada issue es una unidad de trabajo discreta y acotada con una especificación clara. Puedes priorizarlos, asignarlos, y — esta es la parte que me encanta — conectarlos a un loop de agente donde un modelo más barato toma un issue, abre un PR, y tú lo revisas. La auditoría alimenta el backlog, el backlog alimenta la automatización, la automatización alimenta la revisión del PR. Eso es un motor de refactorización sostenible, no una limpieza única.
Si prefieres que alguien arquitecte todo ese loop de auditoría-a-backlog para tu equipo y lo conecte a tu CI, ese es exactamente el tipo de encargo que acepto — puedes ver lo que he construido en fiverr.com/s/EgxYmWD.
Había estado haciendo versiones manuales de esto durante meses y escribí la filosofía de arquitectura más profunda en mi artículo sobre el skill de deep-modules de Claude Code — Improve es la herramienta que finalmente automatizó la mitad del backlog de ese flujo de trabajo para mí.
Así que ahora estoy mapeando, simplificando, dictando y auditando — todo instalando skills de GitHub. Lo que plantea una pregunta que había ignorado durante demasiado tiempo: ¿cómo sé que esos skills son seguros?
Skill Spector de NVIDIA — Escanear antes de confiar
Casi no incluyo esta herramienta, y esa reluctancia es exactamente el problema que resuelve. Había estado instalando skills de GitHub todo el mes — draw.io, Ponytail, Improve — pegando comandos de instalación de dos líneas en mi terminal sin leer ni una sola línea de lo que realmente hacían. Todos los desarrolladores que conozco hacen lo mismo. El ecosistema de skills de IA funciona con confianza implícita, y esa confianza no está ganada.
Skill Spector — el escáner de seguridad de código abierto de NVIDIA para skills de agentes de IA, con alrededor de 5,500 estrellas a mediados de junio de 2026 — está construido para romper ese hábito. Escanea un repositorio de skill antes de que lo instales y marca vulnerabilidades, patrones maliciosos y riesgos de seguridad. Los números detrás son alarmantes: la investigación de NVIDIA encontró que el 26.1% de los skills contienen vulnerabilidades y el 5.2% muestran intención probablemente maliciosa. Aproximadamente uno de cada cuatro skills que podrías instalar tiene un problema, y uno de cada veinte está activamente tratando de hacerte daño.
Funciona en dos etapas. Por defecto ejecuta verificaciones estáticas rápidas — coincidencia de patrones a través de 65 firmas de vulnerabilidad en 16 categorías, incluyendo inyección de prompts, exfiltración de datos, escalación de privilegios, ataques a la cadena de suministro, ejecución peligrosa de código y envenenamiento de herramientas MCP. Luego, opcionalmente, añade un pase de análisis semántico con LLM para los casos que necesitan comparación de intención — los casos donde el código se ve bien estáticamente pero está haciendo algo sospechoso. Esa segunda etapa necesita una clave API de OpenAI, y de ahí vienen los costos. Un escaneo cuesta aproximadamente $0.20 a $5 dependiendo del tamaño del repositorio. Más barato que una sola hora de respuesta a incidentes.
Cuando lo ejecuté contra un skill de terceros desconocido, reveló dos cosas que genuinamente me inquietaron. Primero, el skill solicitaba acceso a cookies del navegador — lo cual, en plataformas como Twitter o Reddit, es un camino directo al secuestro de sesión: roba la cookie, conviértete en el usuario, sin contraseña necesaria. Segundo, los scripts de instalación y actualización descargaban y ejecutaban código remoto no verificado. Ese es un vector clásico de ataque a la cadena de suministro — el script se ve inofensivo hoy, el endpoint remoto sirve algo malicioso mañana, y tú lo ejecutaste con tus propios permisos.
Ninguno de los dos era visible en el README. Ambos estaban enterrados en código que habría ejecutado ciegamente. Ese es el punto completo.
El caso de uso que señalaría con más énfasis: cualquier skill de un autor desconocido, y especialmente repositorios con documentación en un idioma que no lees. Si no puedes auditar el script de instalación tú mismo porque no puedes leer los comentarios, un escaneo de $2 no es opcional — es el seguro más barato en toda tu infraestructura. Cubro el patrón más amplio de auditar código escrito e instalado por IA en mi guía sobre construir un agente escáner de seguridad con Claude Code, pero para skills de terceros específicamente, Skill Spector está construido a propósito y ahora lo ejecuto en todo antes de instalar.
Eso completa el ciclo. Cinco herramientas, un ciclo de retroalimentación. Déjame mostrarte cómo encajan juntas.
El ciclo de retroalimentación — Cómo estas cinco herramientas se potencian mutuamente
Individualmente, cada herramienta es útil. Juntas forman algo mejor: un ciclo de retroalimentación de desarrollo que mantiene al humano en control mientras la IA hace el trabajo pesado.
Aquí está el ciclo que ahora ejecuto en proyectos reales:
- Mapéalo con el skill de draw.io, para que yo — y Claude Code — compartamos una imagen precisa de cómo se conecta la aplicación. Menos tokens desperdiciados en que el agente se reoriente, menos adivinanzas de debugging para mí.
- Simplifícalo con Ponytail, eliminando la sobreingeniería que la IA añadió reflexivamente y consolidando componentes duplicados antes de que se pudran. Aproximadamente 54% menos código que mantener, según los benchmarks.
- Captúralo con Handy, para que las especificaciones que retroalimento sean ricas y rápidas — voz adentro, contexto afuera, sin cuello de botella de tecleo.
- Planifícalo con Improve, convirtiendo la auditoría en issues de GitHub que un modelo más barato puede ejecutar dentro de un loop de agente. Pensamiento caro una vez, ejecución barata para siempre.
- Asegúralo con Skill Spector, para que cada nueva herramienta que añada al ciclo sea escaneada antes de tocar mi entorno.
Observa lo que cada paso tiene en común. Ninguno le pide a la IA que genere más. Cada uno me hace a mí — el humano — más inteligente sobre el código que existe. Mapear construye comprensión. Simplificar reduce lo que tengo que comprender. El dictado amplía mi entrada. Auditar externaliza el backlog. Escanear protege la frontera. La salida del ciclo no es volumen. Es comprensión, y la comprensión es lo único que evita que un proyecto de IA en movimiento rápido colapse en una caja negra.
Ese es el argumento real aquí, y va contra la corriente de la mayoría del bombo del coding con IA. El objetivo nunca fue dejar que la IA construya algo que no entiendes. El objetivo es usar la IA para comprender, optimizar y asegurar tu proyecto mejor de lo que podrías solo — una base para el aprendizaje continuo, no un parche rápido que convierte tu propia codebase en una caja negra. Profundicé en el toolkit más amplio en mi resumen de repos de GitHub que hicieron a Claude Code más rápido, pero estas cinco son las que apuntan directamente a la comprensión en lugar de la velocidad.
Cómo se ve esto en tres meses
Ejecuta este ciclo durante un trimestre y las matemáticas se acumulan a tu favor de maneras que son fáciles de predecir a partir de los mecanismos.
Tus codebases se hacen más pequeñas, no más grandes, porque Ponytail elimina más rápido de lo que la IA sobreconstruye. Codebases más pequeñas significan costos de tokens más bajos en cada llamada al agente — el impuesto de la inflación se reduce cada semana. Tu debugging se vuelve más rápido porque tienes un diagrama de arquitectura preciso en lugar de una suposición. Tu deuda técnica deja de esconderse porque vive en un backlog de GitHub que puedes ver y priorizar. Y tu superficie de ataque se mantiene controlada porque nada entra a tu entorno sin ser escaneado.
No te voy a dar porcentajes inventados para tu proyecto — no los tengo, y nadie que te venda una herramienta los tiene tampoco. Lo que puedo decirte es la dirección, porque sigue directamente de los mecanismos: menos código que leer, menos tokens que gastar, menos sorpresas que debuggear, menos trampas en las que caer. El benchmark publicado de Ponytail — 54% menos código, 20% más barato, 27% más rápido, en un repo real de FastAPI/React — es la señal más concreta que tenemos, y apunta en la misma dirección que todo lo demás aquí.
Los equipos que ganen el próximo año de desarrollo con IA no serán los que generen más código. Serán los que comprendan el código que generan, lo mantengan delgado, planifiquen su deuda deliberadamente y se nieguen a instalar cualquier cosa que no hayan escaneado. Estas cinco herramientas son cómo te conviertes en ese tipo de constructor sin un título en ciencias de la computación o un equipo de ingeniería de veinte personas detrás de ti.
Preguntas frecuentes
¿Cuáles son las mejores herramientas gratuitas para desarrollo de apps asistido por IA en 2026?
Las herramientas gratuitas y de código abierto más fuertes ahora mismo son el skill de draw.io (diagramas de arquitectura de tu codebase), Ponytail (elimina la sobreingeniería de la IA), Handy (dictado por voz local) y Skill Spector de NVIDIA (escaneo de seguridad para skills). Solo Improve de shadcn y el pase LLM de Skill Spector generan costos de API; todo lo demás es gratuito. Consulta las secciones anteriores para ver cómo funciona cada uno.
¿Cómo evito que la IA sobreingeniería mi código?
Usa Ponytail, un skill de Claude Code que obliga al agente a subir una escalera de decisión de seis peldaños comenzando con YAGNI — no lo construyas a menos que sea necesario. Sus benchmarks muestran aproximadamente 54% menos código con todas las pruebas aún pasando. Ejecútalo en modo auditoría en un proyecto existente para marcar y consolidar la sobreingeniería ya presente.
¿Es seguro instalar skills de GitHub para Claude Code?
No a ciegas — la investigación de NVIDIA encontró que el 26.1% de los skills de agentes contienen vulnerabilidades y el 5.2% muestran intención probablemente maliciosa. Escanea cualquier skill de terceros con Skill Spector antes de instalar; un escaneo cuesta aproximadamente $0.20 a $5 y detecta riesgos como robo de cookies y ejecución de código remoto no verificado en scripts de instalación.
¿Cuál es la diferencia entre Improve de shadcn y una herramienta normal de refactorización de código?
Improve es estrictamente solo lectura — audita tu codebase y escribe un plan de implementación detallado pero nunca cambia código por sí mismo. Con el flag --issues publica ese plan directamente como issues de GitHub, para que un modelo más barato pueda ejecutar el trabajo después. Una auditoría cara alimenta muchos pases de ejecución baratos.
¿Necesito una GPU potente para usar Handy para dictado por voz?
No. Handy ejecuta Parakeet V3 de NVIDIA, un modelo de voz optimizado para CPU con detección automática de idioma que es rápido sin una GPU dedicada. Si tienes una GPU, puedes cambiar a modelos Whisper de OpenAI (Small hasta Large) para mayor precisión. Todo se transcribe localmente, así que tu audio nunca sale de tu máquina.
Trabajemos juntos
¿Buscas construir sistemas de IA, automatizar flujos de trabajo o escalar tu infraestructura tecnológica? Me encantaría ayudar.
- Fiverr (construcciones personalizadas e integraciones): fiverr.com/s/EgxYmWD
- Portfolio: mejba.me
- Ramlit Limited (soluciones empresariales): ramlit.com
- ColorPark (diseño y branding): colorpark.io
- xCyberSecurity (servicios de seguridad): xcybersecurity.io