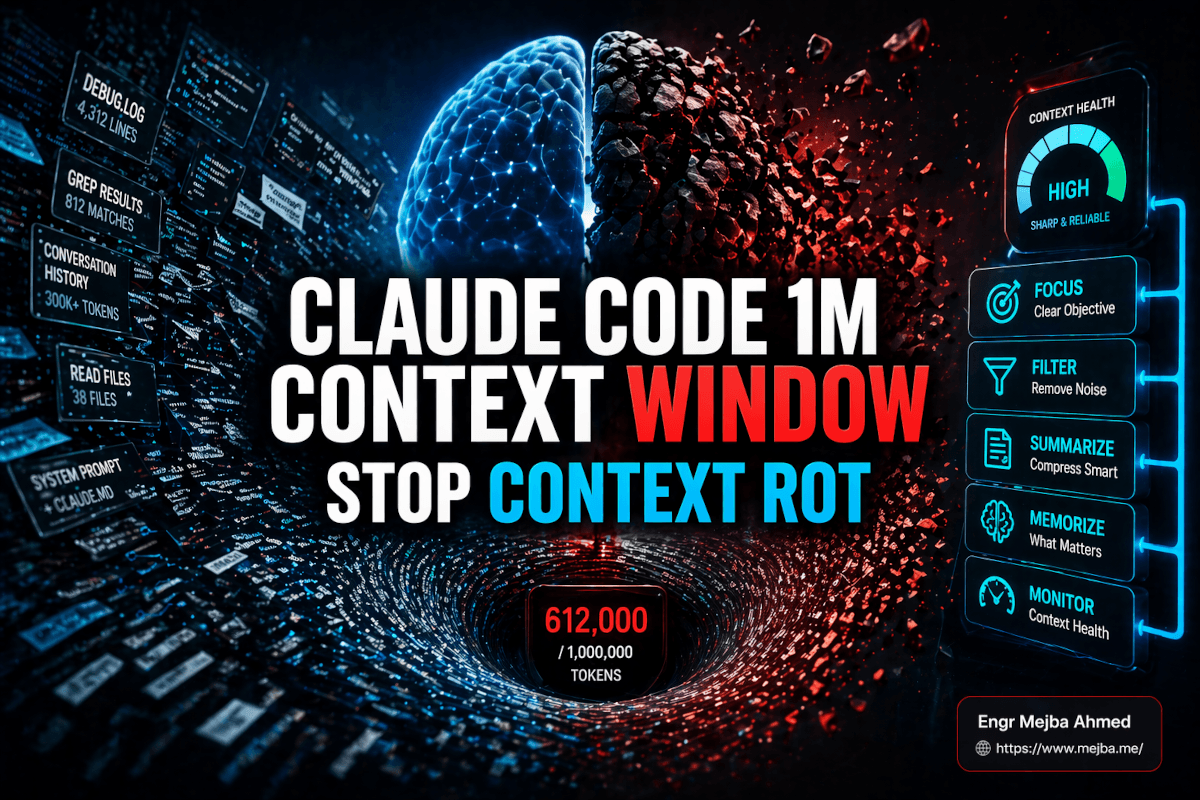
El contador de la sesión marcaba 612,000 tokens. Opus 4.7 había estado trabajando durante casi cuatro horas. Había leído 38 archivos, refactorizado una capa de servicio en Laravel, escrito pruebas y, ahora, estaba diciéndome con confianza que actualizara un método en una clase que yo mismo había eliminado hacía noventa minutos.
No fue una alucinación. Eliminada. Por Claude mismo. Con una llamada de herramienta a la que podía retroceder y ver en esa misma sesión.
Me quedé sentado mirando el terminal —el café ya frío, el cursor parpadeando debajo de una solución que habría desplegado una regresión— y sentí el mismo pavor que todo usuario avanzado de Claude Code conoce. El modelo no se estaba volviendo más “tonto”. El modelo se estaba ahogando. En algún punto entre el token 300k y el token 600k, el contexto pasó silenciosamente de ser un activo a convertirse en una carga.
Esta es la parte que nadie pone en el texto de marketing de la ventana de contexto de 1M de Claude Code. La ventana es real. Funciona. Tengo pruebas. Pero “1 millón de tokens” no es igual a “1 millón de tokens de razonamiento claro, enfocado y confiable”. La distancia entre esas dos cosas es donde ha vivido la mayoría de mis últimas sesiones de depuración.
Durante los últimos 30 días he agotado suficientes sesiones de Opus 4.7 en Max 20x como para mapear exactamente dónde aparece el context rot, qué lo desencadena y los cinco movimientos específicos que mantienen las sesiones largas de Claude Code precisas en vez de difusas. Nada de esto es teórico. Todo surgió tras romper builds reales primero.
Si alguna vez has visto a Claude olvidar una restricción que definiste en el mensaje tres, esto es para ti.
Qué Significa Realmente “1M Context” en Claude Code Actualmente
Pongamos un poco de orden, porque los números de versión importan y la mayoría de los artículos los citan mal.
La ventana de 1 millón de tokens en Claude Code no llegó con Opus 4.5. Opus 4.5 (noviembre de 2025) alcanzó un máximo de aproximadamente 250k. La ventana de 1M se lanzó con Claude Opus 4.6 el 5 de febrero de 2026 — y luego estuvo disponible de manera general en Claude Code el 13 de marzo de 2026 tanto para Opus 4.6 como para Sonnet 4.6. El modelo actual al momento de escribir esto es Opus 4.7, lanzado el 16 de abril de 2026, que mantiene el mismo techo de 1M.
El acceso sigue dependiendo de tu plan:
- Max, Team, Enterprise — 1M es automático con Opus 4.6/4.7, sin costo extra ni necesidad de activar nada
- Pro ($20/mes) — tienes que optar manualmente escribiendo
/extra-usagedentro de Claude Code, y los tokens que superen la ventana estándar se cobran contra créditos de uso adicional - API — el precio para contexto superior a 200k utiliza la tarifa de long-context; consulta la página de precios actual de Anthropic antes de construir un flujo de trabajo que dependa de la tarifa económica
La ventana de contexto incluye todo lo que el modelo puede ver a la vez: el prompt del sistema, tu CLAUDE.md, el historial de conversación, cada archivo que Claude ha leído con la herramienta Read, cada salida que haya producido alguna herramienta, cada resultado de Glob/Grep y el mensaje actual que acabas de escribir. Todo cuenta. Todo compite por atención.
Ese último punto lo es todo. Quédate con eso.
El número que nadie cita: la degradación del contexto empieza en 300k, no en 1M
El discurso de marketing de cualquier modelo de gran contexto implica una curva de rendimiento plana: que el token 999,000 es tan útil como el token 9,000. No es así. Existe un término publicado para lo que realmente sucede, y merece estar en el vocabulario de todo usuario de Claude Code.
Degradación del contexto (context rot) es la disminución medible en el rendimiento del modelo a medida que crece el contexto de entrada. No es un error específico de Anthropic. El estudio de Chroma de 2025 probó 18 modelos de frontera — GPT-4.1, Claude Opus 4, Gemini 2.5, todos ellos — y encontró degradación del contexto en cada incremento de longitud de entrada que midieron. El propio equipo de ingeniería de Anthropic lo ha comentado abiertamente, describiendo el contexto como un "presupuesto de atención finito" que se agota con cada nuevo token, exactamente como sucede con la memoria operativa humana.
Aquí está el número práctico que importa para Claude Code: la degradación empieza a notarse alrededor de los 300,000 a 400,000 tokens. Eso es aproximadamente el 30–40% del límite de 1M, mucho antes de lo que sugiere el número destacado. En el benchmark MRCR multi-needle retrieval, Opus 4.6 aún alcanza un 76% de precisión a nivel del millón de tokens, lo cual es excelente para un modelo de frontera. Pero una “recuperación precisa al 76%” es una pesadilla cuando dejas que un agente edite código de producción sin supervisión. El otro 24% lleva tu nombre.
En la práctica, la degradación rara vez se nota por una alucinación suficientemente dramática como para detectarla de inmediato. Es más silenciosa. Más sutil. Son los cuatro modos de fallo que describo abajo — y una vez que eres capaz de nombrarlos, puedes empezar a cazarlos.
Las cuatro formas de fallo que ahora nombro abiertamente
Antes de tener vocabulario para esto, cada vez que “Claude se comporta raro” parecía el mismo problema difuso. Ahora los diagnostico en segundos. Cada uno requiere una solución distinta.
1. Contaminación de contexto
La contaminación es información irrelevante que desplaza la señal. Ejecutaste un Grep que devolvió 800 coincidencias. Le diste a Claude un archivo de registro de 4,000 líneas "por si acaso". Adjuntaste todo el directorio de tipos de node_modules porque no estabas seguro de en qué archivo estaba el tipo. Nada de eso está mal por sí solo. Todo junto convierte la atención de Claude en sopa.
El modelo no sabe qué considerarías relevante. Trata cada token como si pudiera ser esencial. Cuanto más ruido coloques, más capacidad cognitiva se gasta re-evaluando el ruido.
Señal de advertencia: Claude comienza a referenciar archivos que olvidaste que habías incluido.
2. Desviación de objetivo
La desviación de objetivo es la erosión lenta de la intención original. Comenzaste la sesión con “reescribe el middleware de autenticación para soportar OAuth 2.1, mantén todos los flujos existentes de JWT funcionando, no toques el modelo de usuario.” Tres horas después, tras haber hecho que Claude lea 22 archivos, corrija ocho errores de linting no relacionados y refactorice un helper de logs, le pides que añada un nuevo claim al payload de JWT y termina modificando el modelo de usuario.
No es que haya ignorado tu restricción. Simplemente, la restricción decayó. Con 400k tokens entre la instrucción original y el turno actual, la relación señal-ruido del system prompt colapsó.
Señal de advertencia: Claude cumple la solicitud inmediata pero viola una regla del brief original.
3. Corrupción de memoria
Esta es la que me motivó a escribir este post. La corrupción de memoria ocurre cuando el modelo interno del agente sobre el mundo se aleja de la realidad. El archivo que Claude cree que existe en app/Services/UserService.php fue eliminado en el turno 47. Claude sigue usando la versión que guardó en memoria de trabajo. Lees su plan, parece coherente, lo apruebas — y el parche se aplica en un archivo que ya no existe, o peor, en una versión obsoleta de uno que sí.
Detecté el peor caso durante un refactor en Multica: Opus había parcheado un servicio tres veces durante la sesión, y en el cuarto parche generó un diff respecto a la primera versión del archivo. Los parches intermedios estaban en el historial de la conversación. Simplemente no estaban siendo ponderados.
Señal de advertencia: Las llamadas a herramientas hacen referencia a un estado que no coincide con el sistema de archivos actual.
4. Inexactitud en la toma de decisiones
La inexactitud en la toma de decisiones es el coste de la inconsistencia. Al inicio de la sesión decidiste “todos los errores en este servicio lanzan DomainException y se propagan; el handler los registra en Sentry.” Más adelante, con el contexto cargado, Claude escribe un nuevo método que captura todo como \Exception, registra en Log::error y devuelve un 500.
No es código incorrecto. Simplemente no es tu código. Decisiones diferentes, patrones contradictorios, sin lenguaje de diseño consistente.
Señal de advertencia: El estilo de código y las decisiones arquitectónicas dejan de coincidir con el resto de la base aunque Claude haya leído el resto del código.
Cada una de estas formas de fallo tiene solución. Ninguna es “usa un modelo más pequeño”. Todas se relacionan con la gestión de la ventana de contexto.
Los cinco movimientos que uso todos los días
Cuando una sesión de Claude Code supera los 300k tokens —o cuando detecto uno de los cuatro modos de fallo descritos antes— tengo cinco opciones. El truco está en saber cuál elegir. No son intercambiables.
Opción 1: Continuar (y por qué casi nunca lo hago)
La opción por defecto. Simplemente seguir adelante. La tentación es real porque “estás en la zona” y el coste de cambiar de contexto parece alto.
Ya casi nunca escojo esta opción a menos que esté por debajo de los 300k tokens Y el trabajo sea superficial (un solo archivo, una sola preocupación). Más allá de ese punto, continuar es un riesgo: cada nueva iteración agrava la descomposición del contexto. El coste de que un error llegue a producción supera con creces el de pausar y reiniciar el contexto.
Opción 2: Compactar, pero hacerlo manualmente
/compact resume la conversación existente en un resumen más breve y sigue adelante. En teoría, es el borrador mágico para el exceso de contexto. En la práctica, el autocompact —la versión que se activa automáticamente al llegar al límite de la ventana— no es fiable. La lógica de compactación de Claude prioriza los mensajes recientes y puede descartar silenciosamente contexto crítico más antiguo: el encargo original, las decisiones arquitectónicas, las restricciones del mensaje tres.
Así que nunca dejo que autocompact se active solo. Ejecuto /compact manualmente, de forma proactiva, alrededor del umbral de los 300k, y le doy instrucciones explícitas sobre qué conservar:
/compact Preserve: (1) el encargo original al inicio de la sesión,
(2) todas las decisiones arquitectónicas tomadas en los turnos 1–15,
(3) la lista de archivos que ya hemos modificado y por qué,
(4) cualquier restricción que empiece por "NO" o "DEBE".
Descartar: cuerpos de salida de herramientas, resultados intermedios de Grep, lecturas de archivos que no volveremos a necesitar.
Esa sola instrucción cambia radicalmente la calidad de la compactación. Pasas de “resumir el chat” a “producir un documento estructurado de traspaso”. Mucha diferencia.
Opción 3: Limpiar y reiniciar
/clear borra completamente el contexto. Es la opción nuclear. Y también es la opción correcta más veces de las que solía pensar.
Utilizo /clear siempre que cambio a un trabajo realmente no relacionado —terminar la refactorización de auth y pasar a arreglar el webhook de billing. No hay ningún beneficio en arrastrar el contexto de auth a la sesión de billing, y sí un gran riesgo (contaminación, deriva, todos los problemas ya enumerados).
El error común con /clear es tratarlo como un fracaso. No lo es. Una sesión nueva de 12k tokens de trabajo enfocado supera siempre a una sesión obsoleta de 600k tokens llena de razonamientos confusos.
Opción 4: Limpiar + guardar en JSON (mi opción por defecto para trabajos complejos)
Esta es la opción en la que más confío. Antes de limpiar, hago que Claude escriba un archivo JSON estructurado que capture el estado del trabajo en una forma que pueda volver a usar al iniciar una nueva sesión. Algo así:
{
  "objective": "Migrar el middleware de auth a OAuth 2.1 preservando los flujos JWT",
  "constraints": [
    "No modificar app/Models/User.php",
    "Todos los nuevos endpoints deben mantener el prefijo /api/v1",
    "Los consumidores actuales de JWT deben seguir funcionando"
  ],
  "files_modified": [
    {"path": "app/Http/Middleware/Authenticate.php", "status": "complete"},
    {"path": "app/Services/Auth/OAuthHandler.php", "status": "in-progress"}
  ],
  "open_decisions": [
    "La estrategia de rotación de refresh tokens sigue pendiente",
    "Hay que confirmar si el antiguo formato JWT lleva cabecera de deprecación"
  ],
  "next_step": "Implementar la rotación de refresh tokens en OAuthHandler::refresh()"
}
Luego ejecuto /clear, inicio una sesión nueva, y el primer mensaje es: "Lee .claude/state.json, confirma que entiendes el objetivo y las restricciones actuales, y continúa desde next_step."
Ese traspaso es mucho más fiable que cualquier /compact que haya hecho. La nueva sesión arranca con unos 15k tokens y señal perfecta. Sin deriva. Sin memoria corrupta. Sin restricciones a medio recordar.
Opción 5: Subagentes para cualquier tarea que inunde el contexto
Los subagentes son la vía de escape de Claude Code para tareas que normalmente volcarían salidas masivas de herramientas en tu contexto principal. El agente se ejecuta en su propia ventana de contexto aislada, realiza el trabajo y solo devuelve el resultado final a tu sesión principal.
El test mental que uso —y que recomienda el propio equipo de Anthropic— es: “¿Voy a necesitar la salida de esta herramienta de nuevo, o solo la conclusión?”
¿Solo necesitas la conclusión? Subagente. Ejemplos:
- "Busca en todo el código cada lugar donde llamamos al gateway de pagos legacy y devuelve la lista de archivos y líneas" — tarea perfecta para subagente. Los resultados de Grep consumirían 40k tokens del contexto principal. La lista final suma 200 tokens.
- "Lee estas 12 páginas de documentación y dime cuál tiene la información de rate limit" — subagente. Las 12 páginas contaminarían el contexto. La respuesta es una frase.
- "Ejecuta el test suite y reporta solo los fallos con trace completo" — subagente. No necesitas las 8.000 líneas de salidas exitosas.
Configuro estas tareas como subagentes de Claude Code, definidos correctamente en .claude/agents/ para que la orquestación sea repetible. La primera vez que adapté una sesión de 90 minutos para usar subagentes en los pasos de búsquedas masivas, el contexto principal pasó de 400k a 90k y Opus se mantuvo preciso todo el trabajo.
Las tres prácticas que importan más que cualquier comando
Más allá de las cinco opciones, hay tres hábitos que marcan la mayor diferencia en el día a día. Ninguno de ellos llama la atención.
Rebobina en lugar de repreguntar
Cuando Claude toma una decisión incorrecta y la corriges, esa decisión equivocada permanece en el contexto para siempre. Tres turnos después corriges otro error relacionado. Para el décimo turno, la conversación es mitad trabajo real y mitad "no, eso no, haz esto en su lugar". El deterioro del contexto se acelera.
La mejor jugada es rebobinar: retrocede la conversación hasta antes del turno fallido y vuelve a dar una mejor instrucción inicial que incorpore lo aprendido. Claude Code te permite editar mensajes anteriores. Úsalo. La sesión rebobinada es mucho más limpia, se compacta mejor y propaga menos errores aguas abajo.
Ahora trato el tercer "no, eso sigue sin estar bien" como un disparador automático para rebobinar, en vez de seguir corrigiendo.
Los resúmenes periódicos no son opcionales
Cada 50–75 mil tokens de trabajo sustantivo, pregunto: "Resume el objetivo actual, las restricciones acordadas y el trabajo realizado hasta ahora". Dos párrafos como máximo.
Esto suena derrochador. Es lo contrario. El resumen fuerza a Claude a volver a anclarse en el objetivo, lo que reduce drásticamente la deriva en las siguientes interacciones. También me permite detectar rápidamente si la comprensión de Claude ya se desvió: si el resumen está errado, sé que el deterioro ha comenzado y es momento de /compact o /clear.
Piensa en los resúmenes como la versión económica de la compactación. La compactación reestructura la memoria. Los resúmenes la refuerzan.
Instrucciones explícitas de compactación superan siempre al comportamiento por defecto
Ya traté esto en la Opción 2, pero vale la pena destacarlo como regla individual. Si usas /compact sin dar instrucciones, estás confiando en los valores predeterminados de Claude para decidir qué es esencial en tu trabajo. Muchas veces, no lo son. La restricción que escribiste en el mensaje tres es solo texto para el resumidor.
Indícale siempre a /compact qué preservar, qué descartar y cómo estructurar el resultado. Trátalo como si estuvieras redactando un documento de entrega para un colega, no como si activaras un comando mágico.
Cómo se Ve Esto de Principio a Fin: Una Sesión Real
Aquí tienes una versión simplificada de cómo fluye en la práctica una sesión larga con Claude Code para mí ahora, después de un mes afinando este ciclo:
- Inicio de la sesión —
CLAUDE.mdestá bien ajustado, el briefing va en el primer mensaje, las restricciones son explícitas. Conteo de tokens: ~5k. - Primeros 200k tokens — trabajo directo. No optimizo nada. Leo archivos, escribo código, ejecuto tests. El contexto está sano.
- Punto de los 300k — primer punto de control. Solicito un resumen. Se confirma la dirección. Nada de
/compactaún si el trabajo sigue enfocado. - Punto de los 400k — segundo punto de control. Si aún estoy a mitad de tarea, ejecuto un
/compactmanual con instrucciones explícitas de qué preservar y qué descartar. El conteo de tokens baja a ~80k. Continúo. - Cualquier cosa que genere >20k de salida de herramienta — subagente. Siempre.
- Al finalizar un bloque discreto de trabajo — escribo un archivo JSON de estado, uso
/clear, inicio una sesión fresca, recargo el contexto desde el JSON. La transición me cuesta 3 minutos y me ahorra rotaciones acumuladas. - Primer bucle de “no, eso todavía no está bien” — pausa. Diagnóstico cuál de los cuatro modos de fallo está ocurriendo. Elijo la solución correcta. Nada de seguir repitiendo el prompt a ciegas.
Eso es todo. Sin magia. Sin herramientas nuevas. Solo uso disciplinado de lo que ya trae Claude Code.
El resultado: ahora llevo sesiones productivas de Claude Code que abarcan toda una jornada laboral sobre el mismo proyecto sin que el modelo se desvíe. Hace un mes no podía pasar de la tarde del martes sin que apareciera una cascada de alucinaciones.
Lo que hice mal durante las tres primeras semanas
Te debo la versión honesta de cómo llegué a esto, porque desperdicié mucho dinero en el camino.
Supuse que un contexto más grande era estrictamente mejor. Deliberadamente agregaba más archivos al contexto “para que Claude tenga total visibilidad”. Error. Cada archivo irrelevante es un pequeño impuesto en cada turno posterior. Menos es más. Lee solo lo que necesitas, no lo que tal vez podría ser útil.
Confié en el autocompact. Durante tres semanas dejé que se ejecutara cada vez que quisiera. La degradación era tan gradual que me culpaba a mí mismo, a mis prompts, a la estructura de mi proyecto, a cualquier cosa menos al verdadero culpable. La primera vez que desactivé el autocompact y realicé compactaciones manuales con instrucciones explícitas, la diferencia fue abismal.
Evadí los subagentes porque la orquestación me parecía un sobrecoste. También me equivoqué en eso. Configurar un subagente de búsqueda o un subagente para ejecutar tests lleva diez minutos una sola vez. Luego te ahorra hacer volcados de herramientas de 50k tokens en cada sesión.
Y traté /clear como una derrota. No lo es. Una sesión limpia no es una sesión fallida. Una sesión limpia es una herramienta. Úsala.
Preguntas Frecuentes
¿Cuándo empieza el context rot en Claude Code?
El context rot en Claude Code se vuelve medible alrededor de los 300,000 a 400,000 tokens — aproximadamente el 30–40% de la ventana de 1M. El rendimiento no colapsa en ese punto, pero el desvío de objetivos, la corrupción de memoria y la inconsistencia en las decisiones se vuelven notablemente más probables. Considera los 300k como tu primer punto de control, no 1M como tu límite.
¿Debo usar /compact o /clear en Claude Code?
Utiliza /compact cuando la tarea actual sigue activa y el contexto reciente realmente es necesario; usa /clear al cambiar a trabajos no relacionados o cuando el contexto está tan contaminado que, incluso resumiéndolo, quedaría ruido. Para trabajos complejos en curso, el patrón más sólido es escribir un archivo de estado en JSON, hacer /clear y preparar una sesión nueva a partir del JSON.
¿La ventana de contexto de 1M cuesta extra en Claude Code?
En los planes Max, Team y Enterprise, la ventana de contexto de 1M está incluida sin costo extra para Opus 4.6 y Opus 4.7. En el plan Pro ($20/mes), debes activar la opción con /extra-usage y los tokens por encima de la ventana estándar se contabilizan en créditos de uso extra. La API utiliza el nivel de contexto largo a partir de 200k tokens — verifica las tarifas actuales antes de construir tu flujo de trabajo sobre ese supuesto.
¿Cuál es la diferencia entre /compact y los sub agents?
/compact resume la conversación existente en tu sesión actual para liberar tokens; los sub agents evitan que ocurra el bloat en primer lugar, ejecutando tareas auxiliares en sus propias ventanas de contexto aisladas y devolviendo sólo el resultado final. Utiliza sub agents para cualquier tarea cuyo output de herramientas no necesites consultar repetidamente — búsquedas, análisis de logs, ejecuciones de tests.
¿Por qué Claude Code comienza a alucinar en sesiones largas?
Las sesiones largas de Claude Code presentan alucinaciones a causa del context rot — a medida que crece el input, el presupuesto de atención del modelo se diluye y las restricciones, archivos y decisiones antiguas quedan subvaloradas. La solución no es una ventana más grande, sino una gestión activa: aplicar /compact manual con instrucciones explícitas, hacer recapitulaciones periódicas, emplear sub agents en tareas de alto output, y realizar handoffs entre grandes bloques de trabajo mediante /clear+JSON.
Así que: tienes el terminal abierto. La sesión está en 280k tokens. Opus 4.7 acaba de sugerir editar un archivo que tienes un 80% de seguridad de haber eliminado hace una hora.
¿Qué haces en los próximos 60 segundos?
Si tu respuesta es “pedirle a Claude que verifique dos veces”, sigues gestionando el contexto a la antigua. Si es “retroceder hasta el último turno limpio, escribir un archivo de estado en JSON, /clear y volver a iniciar sesión”, bienvenido a la versión de Claude Code que realmente escala a una jornada laboral completa. La ventana de 1M es real. La fiabilidad dentro de ella es algo que tienes que diseñar.
Prefiero diseñarla que culpar al modelo.
Trabajemos Juntos
¿Quieres crear sistemas de IA, automatizar flujos de trabajo o escalar tu infraestructura tecnológica? Me encantaría ayudarte.
- Fiverr (desarrollos e integraciones a medida): fiverr.com/s/EgxYmWD
- Portafolio: mejba.me
- Ramlit Limited (soluciones empresariales): ramlit.com
- ColorPark (diseño y branding): colorpark.io
- xCyberSecurity (servicios de seguridad): xcybersecurity.io